Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Importante
Esse recurso está em Beta.
As sessões de agentes gerenciados fornecem aos seus agentes um armazenamento durável e independente de framework para o estado da sessão: o estado que um agente ou framework mantém para uma interação. Na maioria das vezes, trata-se do histórico da conversa, a transcrição ordenada de mensagens, chamadas de ferramentas e resultados que um agente lê no início de uma interação e adiciona ao longo da execução. Também pode ser qualquer outro estado que um framework persista para a interação, como um grafo LangGraph. O Azure Databricks armazena no Lakebase e gerencia o armazenamento para você, então você não constrói nem opera o banco de dados.
Note
Durante a prévia, você é cobrado pela instância subjacente do Lakebase que armazena suas sessões. Não se aplicam cobranças adicionais pelas sessões de agentes gerenciados em si. Os preços podem variar conforme a prévia avança.
Use sessões gerenciadas quando quiser:
- Armazene o histórico da conversa do agente para que seja preservado após reinícios e possa ser retomado posteriormente.
- Reconstrua todo o contexto (incluindo chamadas de ferramentas e raciocínio) em uma mensagem subsequente.
- Liste, retome e crie ramificações de conversas anteriores na sua própria interface.
Sessões gerenciadas mantêm o estado de uma única interação (estado de curto prazo em uma sessão). Para uma memória durável e de longo prazo que persiste entre conversas, use memória gerenciada do agente.
Requisitos
- Instale o Python 3.10 ou superior para usar o SDK AgentKit. AgentKit SDK é o cliente Python do Databricks para APIs de agentes, que os exemplos abaixo utilizam. Você também pode chamar a API REST diretamente de qualquer linguagem, sem necessidade de Python.
Como funcionam as sessões gerenciadas
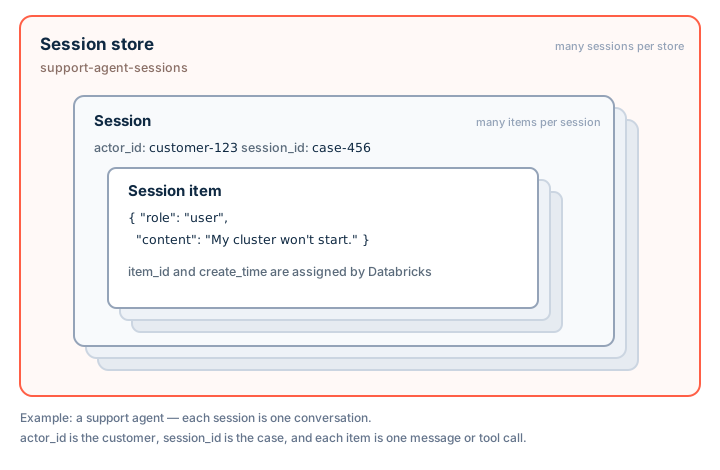
Sessões gerenciadas possuem três níveis:
- Um armazenamento de sessão é o contêiner com escopo de workspace para as sessões de um agente. Criar um repositório provisiona automaticamente o armazenamento subjacente do Lakebase. Você escolhe um
session_store_nameexclusivo para o workspace. - Uma sessão é uma interação duradoura (normalmente um tópico de conversa) dentro de uma loja. Uma sessão é identificada por:
-
actor_id(obrigatório): a quem pertence a sessão, como um usuário final ou outro agente. Ele agrupa todas as sessões de uma disciplina para que você possa listá-las e filtrá-las juntas. Quando você cria um app por usuário, definaactor_idpara o ID do usuário (por exemplo, a identidade verificada do usuário final pela autenticação do seu app) para que as sessões de cada usuário permaneçam agrupadas. Defina a partir do contexto de aplicação confiável, nunca de um valor fornecido pelo modelo ou pelo usuário. -
session_id(opcional): um ID escolhido pelo chamador para a interação. O serviço gera um deles se você o omitir. -
parent_session_id(opcional): vincula uma sessão àquela da qual foi ramificada, para representar conversas ramificadas.
-
- Um item de sessão é uma entrada no histórico ordenado de uma sessão. Cada item contém um valor opaco compatível
datacom JSON, como uma mensagem, chamada de ferramenta, resultado de ferramenta ou bloco de raciocínio. O Azure Databricks atribui a cada item umitem_ide umcreate_timee não inspeciona nem valida seu conteúdo. Os itens ficam imutáveis após serem anexados.
O serviço mantém uma ordem determinística para os itens de uma sessão e autoriza cada operação no armazenamento de sessão.
Introdução
Esses exemplos configuram sessões gerenciadas para um agente de suporte: eles criam um armazenamento de sessões, iniciam uma sessão para uma conversa, adicionam os turnos da conversa e leem o histórico em uma solicitação posterior. Escolha o cliente que se encaixe no seu projeto.
AgentKit SDK
O SDK AgentKit é o cliente Python do Databricks para APIs de agentes, distribuído no databricks-agentbricks pacote. Ele se autentica com o WorkspaceClient do SDK do Databricks.
Instale o SDK do AgentKit:
pip install databricks-agentbricksCrie um armazenamento de sessões e depois inicie uma sessão para uma conversa.
actor_idé a quem a conversa pertence; o opcionalsession_ididentifica unicamente essa conversa:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) session_store = client.session_stores.create("support-agent-sessions") session = session_store.add(actor_id="customer-123", session_id="case-456")Adicione as interações da conversa à medida que o agente executa. Cada item é qualquer valor compatível com JSON:
session.append_items(
    [
        {"type": "message", "role": "user", "content": "I need help with my cluster."},
        {"type": "message", "role": "assistant", "content": "Let's take a look."},
    ]
)
Em um pedido de acompanhamento, recarregue a sessão e leia seu histórico completo para reconstruir o contexto:
session = session_store.get("case-456")
# Request chronological order; list_items defaults to newest-first and auto-pages.
history = [item.data for item in session.list_items(order_by="create_time asc")]
API REST
Os clientes acessam a API REST em /api/2.0/agents/session-stores. Chame-o diretamente em linguagens que não sejam Python.
Gerar um token OAuth com a CLI do Databricks:
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
Crie um armazenamento de sessão para o seu agente:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores?session_store_name=support-agent-sessions" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"description": "Support agent conversation history"}'
Inicie uma sessão para uma única conversa.
actor_idindica a quem pertence;session_ididentifica exclusivamente esta conversa:curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions?session_id=case-456" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "customer-123"}'Adicione um turno de conversa enquanto o agente corre:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions/case-456/items:append" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"items": [{"data": {"type": "message", "role": "user", "content": "I need help with my cluster."}}]}'
Leia a história em ordem cronológica para reconstruir o contexto:
curl -G "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions/case-456/items" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" --data-urlencode "order_by=create_time asc"
Os clientes também permitem remover o item mais recente, limpar os itens de uma sessão e bifurcar uma conversa em uma cópia independente (opcionalmente, até um item específico). Excluir uma sessão que tenha sessões filhas requer a opção force para aplicar a exclusão em cascata a elas (por exemplo, session.delete(force=True)).
Ofereça suporte à sessão de um framework de agentes com sessões gerenciadas
Frameworks de agentes como o OpenAI Agents SDK e o Claude Agent SDK leem o histórico de conversas no início de uma execução e adicionam novos itens ao final. O armazenamento de sessão se encaixa diretamente nesse padrão:
| Operação do framework | Chamada de armazenamento de sessão |
|---|---|
| Leia a história |
list_items em ordem cronológica (order_by="create_time asc") |
| Adicionar itens de turno |
append Os novos itens |
| Desfazer o último item |
pop O item mais recente |
| Limpe o tópico |
clear Os itens da sessão |
Escopo e acesso
Sessões gerenciadas armazenam os itens de uma sessão como valores opacos e compatíveis com JSON: o serviço persiste e retorna o que seu agente ou framework adicionar, sem interpretar isso. Ele não adiciona recursos de controle de execução, como execuções, checkpoints ou aprovações, como conceitos de primeira classe, embora uma estrutura que serialize esse estado possa persisti-lo como itens.
Os armazenamentos de sessão são delimitados por espaço de trabalho, e o acesso é autorizado no nível do armazenamento. Os actor_id campos and metadata suportam apenas agrupamento e filtragem; eles não concedem nem restringem acesso. Defina o actor_id com base no contexto confiável do aplicativo, em vez de usar um valor fornecido pelo modelo ou pelo usuário.
Para permitir que outro principal, como o principal de serviço do seu agente, use uma loja, conceda acesso a ela com a operação de concessão de permissão da loja (session_store.grant_permission(principal_id) no SDK AgentKit).
Sessões gerenciadas e memória gerenciada são independentes. Excluir uma sessão ou um armazenamento de sessão não exclui a memória mantida em um armazenamento de memória.