Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Migre suas cargas de trabalho da computação clássica para a computação sem servidor. A computação sem servidor lida com provisionamento, dimensionamento, atualizações de runtime e otimização automaticamente.
A maioria das cargas de trabalho clássicas pode migrar com alterações mínimas ou sem código. Por exemplo, cargas de trabalho que usamdf.cache() e df.persist() migram principalmente sem alterações no código. Esta página se concentra nessas cargas de trabalho. Certas cargas de trabalho que dependem de notebooks R ou Scala exigem computação clássica e não podem migrar para serverless. Para obter uma lista completa das limitações atuais, consulte limitações de computação sem servidor.
Migrar com Genie Migrate para Serverless
Importante
Esse recurso está em Beta. Administradores do espaço de trabalho podem habilitá-lo na página Pré-visualizações ao aderir à versão prévia do Compute Agent. Consulte Gerenciar visualizações do Azure Databricks.
O Genie Migrate for Serverless é um agente que migra um único notebook ou tarefa para computação serverless. O agente revisa o ambiente da carga de trabalho, bibliotecas, configurações do Spark, tags e código, e então propõe cada alteração como uma sugestão individual para você aceitar ou rejeitar. As mudanças aceitas são aplicadas no local e podem ser revertidas.
Use o Genie Code para migrar um notebook ou tarefa de forma interativa, ou use a CLI do Databricks para migrar tarefas em segundo plano, incluindo muitas tarefas de um script. Veja Migrar jobs com a CLI do Databricks.
O que o agente revisa e altera
| Area | O que o agente faz |
|---|---|
| Ambiente e bibliotecas | Traduz instalações de bibliotecas em uma especificação de ambiente serverless, incluindo instalações com %pip, scripts de inicialização do cluster, bibliotecas de cluster em trabalhos e referências a um índice de pacotes privado. |
| Variáveis de ambiente | Traduz variáveis do ambiente do cluster para seus equivalentes serverless, preservando referências secretas de workspace e omitindo valores gerenciados pela plataforma. |
| Acesso a dados e armazenamento | Reescreve caminhos incompatíveis com serverless, como disco local, dbfs:/, e caminhos de montagem, para volumes do Catálogo Unity. O agente aplica reescritas inequívocas automaticamente e pede que você escolha um volume quando o destino for ambíguo. |
| Configurações do Spark | Classifica cada configuração do Spark, comenta configurações que são seguras para descartar e sinaliza e remove configurações que serverless não suporta. Abrange tanto configurações conectadas ao cluster quanto configurações no notebook. |
| Código da carga de trabalho | Reescreve código que o serverless não suporta em equivalentes compatíveis, como operações RDD reescritas para operações DataFrame, e ajusta o código para o comportamento do SQL em modo ANSI em serverless. |
| Tags | Traduz tags personalizadas do cluster, como uma tag de centro de custo, para seus equivalentes serverless. |
| Modo Performance | Sugere um modo de desempenho baseado na configuração do cluster. Consulte Escolher um modo de desempenho. |
Requirements
O acesso de administrador do espaço de trabalho é recomendado para garantir uma migração completa. Isso porque o agente também inspeciona scripts globais de inicialização no nível do espaço de trabalho, além da carga de trabalho de destino. Talvez seja possível migrar se você tiver
CAN MANAGEpermissão na carga de trabalho, mas, sem permissões de administrador, isso pode resultar na ausência de bibliotecas, configurações de ambiente ou tags.Confirme que você tem acesso ao agente. Digite
/computeo Código Gênio./computeDeve aparecer no menu de Autocompletar. Se não aparecer, um administrador do espaço de trabalho deve ativar a pré-visualização no seu espaço de trabalho.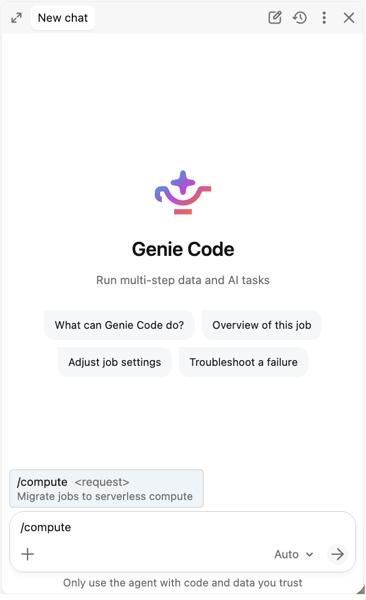
Migrar um notebook
- Abra o caderno que você quer migrar.
- Abra o Código Genie e execute
/compute migrate to serverlessa partir da/paleta de comandos. - Revise as conclusões do agente. O agente escaneia o ambiente, bibliotecas e código do notebook, e propõe uma alteração para cada item que precise, como mover uma instalação de biblioteca para uma especificação de ambiente ou reescrever uma célula de código para rodar em serverless.
- Aceite ou rejeite cada mudança proposta.
- Aplique as mudanças que você aceitou. Elas são gravadas no notebook no mesmo local.
- Conecte o notebook ao serverless e rode para confirmar se ele se comporta como você espera. Consulte "Verificar uma carga de trabalho migrada".
Migrar um job
- Abra o trabalho que deseja migrar.
- Abra o Código Genie e execute
/compute migrate to serverlessa partir da/paleta de comandos. - O agente clona seu trabalho e tenta migrar o trabalho clonado para serverless.
- Revise as conclusões do agente. Para um trabalho multitarefa, o agente enumera todas as tarefas e sua configuração de cluster por tarefa, e propõe mudanças para cada uma enquanto preserva o cronograma do trabalho.
- Aceite ou rejeite cada alteração proposta na superfície de migração: ambiente e bibliotecas, configurações do Spark e qualquer código de carga de trabalho que precise mudar.
- Aplique as mudanças que você aceitou. O poder computacional do trabalho é alterado para serverless.
- Execute o trabalho no serverless e confirme os resultados. Consulte Verificar uma carga de trabalho migrada.
- Opcionalmente, como etapa final, o agente promove o clone migrado. Ele copia a configuração e os notebooks do clone de volta para o seu trabalho original no lugar (mantendo o mesmo ID do trabalho, cronograma e permissões), e depois deleta o clone. Se você pular a promoção, seu job original mantém seu cronograma e continua rodando em computação clássica. O clone não tem agenda nem gatilhos, então ele roda apenas quando você o inicia.
Migrar jobs com a CLI do Databricks
Use o grupo de comandos compute-migrations na Databricks CLI para executar o Genie Migrate for Serverless em um trabalho em segundo plano, sem uma sessão aberta do Genie Code. Você pode iniciar migrações para muitos jobs a partir de um script e revisar cada um quando estiver pronto.
O caminho da CLI do Databricks possui os seguintes requisitos:
- Um administrador do espaço de trabalho habilitou a prévia do Compute Agent . Sem ele, todo
compute-migrationscomando falha comPERMISSION_DENIED. - CLI do Databricks versão 1.24.0 ou superior. Consulte Instalar ou atualizar a CLI do Databricks.
-
CAN MANAGEem cada job que você migrar.
O agente faz backup do job e depois cria uma cópia de trabalho serverless. A cópia funcional é uma nova tarefa chamada [Serverless Migration - <timestamp>] <job name> que executa cópias dos notebooks e arquivos da tarefa. Ele não tem agendamento nem gatilhos, então roda apenas quando você o inicia ou quando o Azure Databricks o executa para validação. Seu trabalho original não é alterado até que você aprove a migração.
Aviso
Uma execução de validação não é isolada. A cópia de trabalho é executada com as mesmas tabelas, volumes, checkpoints e sistemas externos que o job original. Se o trabalho grava em tabelas de produção, envia notificações, chama APIs externas ou avança checkpoints de streaming, a execução de validação também o faz. Configure run_validation apenas para jobs em que uma corrida extra seja segura. Você não pode alterar essa configuração após criar a migração.
Não edite o trabalho original nem a cópia de trabalho enquanto a migração estiver em andamento. Aprovar a migração substitui as configurações e arquivos do trabalho original pelos da cópia de trabalho.
Inicie uma migração para o job:
databricks compute-migrations create -o json --request-id "<uuid>" --json '{
  "asset_type": "JOB",
  "asset_uri": "jobs/<job-id>",
  "auto_approve": false,
  "run_validation": false
}'
A resposta inclui o ID da migração. Use um novo
request-idpara cada tarefa e reutilize-o se tentar novamente após um timeout para não criar uma migração duplicada. Você não pode alterarauto_approveourun_validationdepois de criar a migração.Verifique o estado da migração com
databricks compute-migrations get <migration-id> -o json. Planejar e montar a cópia de trabalho geralmente leva vários minutos. Para verificar muitas migrações, uselist, depois confirme cada uma delas comgetantes de agir.Quando a migração chegar a
TRANSLATION_READY, revise a cópia de trabalho.migration_report.primary_asset.idé o ID do trabalho da cópia de trabalho. Compare suas configurações e código com o job original e, em seguida, executeapprove-migration-translationoureject-migration-translationcom o--etagdo seugetmais recente.Se você definir
run_validation, o Azure Databricks executa a cópia de trabalho uma vez e registra o resultado emvalidation_report. A migração passa paraMIGRATION_REVIEWindependentemente de a execução ser bem-sucedida ou falhar, então verifiquevalidation_report.passedantes de aprovar.Quando a migração chegar
MIGRATION_REVIEWa , revise a cópia de trabalho e o resultado da validação, então executeapprove-migration-executionoureject-migration-executioncom o--etaga partir do seu arquivo mais recenteget. Aprovar aplica as configurações e arquivos da cópia de trabalho ao trabalho original, mantendo seu ID do trabalho, agendamento e permissões.Quando a migração chega a
MIGRATION_COMPLETE, o trabalho original foi alterado. Verifique imediatamente. Consulte Verificar uma carga de trabalho migrada.Depois de verificar a tarefa original, exclua a tarefa de cópia de trabalho.
migration_report.secondary_assetsLista notebooks que a cópia de trabalho executa. Exclua-os somente depois de confirmar que o trabalho original não os referencia.
Cada comando reject requer um motivo de rejeição, que você passa após o ID da migração. Por exemplo:
databricks compute-migrations reject-migration-translation <migration-id> "Keep the existing output table names." --etag <etag>
Dê um motivo específico. O agente revisa a cópia de trabalho e a devolve para revisão. Se você rejeitar uma migração repetidamente, ela falha.
A tabela a seguir lista os compute-migrations comandos:
| Command | Description |
|---|---|
create |
Inicia uma migração para um job. Falha com ALREADY_EXISTS se o job tiver uma migração em andamento ou uma migração que já foi bem-sucedida. |
get, list |
Retorna o estado, os relatórios e etag de uma migração ou de todas as migrações. |
approve-migration-translation, reject-migration-translation |
Aprova ou rejeita a cópia de trabalho no TRANSLATION_READY estado. A configuração auto_approve na criação pula esta revisão. |
approve-migration-execution, reject-migration-execution |
Aprova ou rejeita a migração no MIGRATION_REVIEW estado. Aprovar muda o trabalho original. |
cancel-migration |
Interrompe uma migração. O cancelamento não desfaz as alterações já aplicadas ao trabalho original nem os efeitos colaterais de uma execução de validação. |
delete |
Remove o registro de migração. Não reverte alterações nem remove a cópia de trabalho ou backup. Uma migração que falhou ou foi cancelada já libera o trabalho, então você não precisa excluí-lo antes de iniciar uma nova migração. |
Passe --etag do seu mais recente get com cada comando de aprovar, rejeitar ou cancelar. Se a migração mudou desde que você a leu, o comando falha com ABORTED , em vez de agir, sobre um estado que você não revisou. Se o agente não puder migrar o trabalho, a migração passa para NOT_SUPPORTED ou FAILED, e state_history explica o motivo.
Verifique uma carga de trabalho migrada
O agente propõe e aplica alterações, mas não verifica a saída da sua carga de trabalho. Uma execução de validação com a CLI Databricks verifica apenas se a execução é bem-sucedida. Sempre execute uma carga de trabalho migrada em serverless e confirme os resultados antes de confiar nela, especialmente para cargas que gravam em tabelas de produção. Se o agente propor uma mudança que pareça errada, rejeite-a e nos envie feedback para que possamos melhorar o agente. Consulte Enviar comentários sobre o produto.
Dica
Enquanto você valida uma carga de trabalho migrada, execute-a em modo otimizado para desempenho. Ele começa mais rápido que o modo padrão, então você recebe um feedback mais rápido ao confirmar os resultados. Mude para o modo que melhor se encaixa na carga de trabalho antes de rodar em produção. Consulte Escolher um modo de desempenho.
Quando o agente encontra algo que não pode migrar com segurança, ele sinaliza um bloqueio e interrompe o processo por padrão. Você pode instruí-lo explicitamente a ignorar alguns bloqueios de compatibilidade ou dependência, mas, ao fazer isso, você aceita o risco de que essas dependências, a atribuição de custos ou o comportamento em tempo de execução não sejam preservados, e a carga de trabalho possa falhar no ambiente serverless.
Reverter alterações de migração
As mudanças que o agente aplica são reversíveis.
Para um notebook, abra-o e restaure a revisão imediatamente anterior à migração. Consulte o histórico de versões nos notebooks do Databricks.
Para um trabalho, se você não promoveu o clone migrado no Genie Code ou não aprovou a migração com a CLI do Databricks, seu trabalho original nunca foi alterado. Execute-o como antes e exclua o clone ou a cópia de trabalho. Caso contrário, restaure a partir do backup que o agente criou antes de fazer qualquer alteração:
- Abra a pasta de backup:
/Workspace/Users/<username>/serverless-migration/backups/job-<job-id>/<timestamp>/. O backup fica na pasta pessoal do usuário que executou a migração, que para a CLI do Databricks é o usuário que a criou. No Código Genie, o agente também mostra esse caminho durante a migração. Se houver várias marcas de tempo, escolha a que está imediatamente antes da migração. - Abra
job.yaml, que contém as configurações da tarefa anteriores à migração, e aplique essas configurações novamente à mesma tarefa por meio de uma solicitaçãoPOST /api/2.2/jobs/reset, que sobrescreve as configurações da tarefa pelas que você fornecer. Você também pode colá-los na definição JSON do trabalho na interface. Isso retorna o trabalho para a computação clássica. - Abra
mapping.yaml, que lista cada arquivo com backup e o caminho original de onde veio. Copie cada arquivo de backup de volta para seu caminho original para desfazer as reescritas no código. - Execute a tarefa para confirmar se ela se comporta da mesma forma que antes da migração.
A migração nunca apaga esse backup. Tarefas que o agente não modificou, como tarefas provenientes do Git, SQL ou dbt, são registradas em job.yaml, mas seus arquivos não são copiados para o backup; portanto, restaure-os da sua fonte confiável, se necessário.
Limitações conhecidas
- Os seguintes são considerados bloqueadores: imagens personalizadas, variantes do ML Runtime, versões do Databricks Runtime anteriores à 13, configurações do Spark que não podem ser ignoradas com segurança no ambiente serverless e dependências como eggs, JARs e bibliotecas Maven. Um bloqueador significa que o agente para em vez de migrar aquele item. Você pode resolver você mesmo e rodar a migração novamente, ou pedir para o agente migrar mesmo assim, o que deixa esse item sem solução e pode causar falha na carga de trabalho no serverless.
- O agente lê scripts de init armazenados em arquivos de workspace ou volumes do Unity Catalog. Scripts de init armazenados em ABFSS ou DBFS não podem ser lidos e são reportados como bloqueadores.
- O agente não inspeciona todos os atributos clássicos de computação. A entrega de logs do cluster e as chaves SSH não são representadas e, embora detecte muitas dependências relacionadas a montagens do DBFS no código da carga de trabalho, ele não enumera nem resolve todas as montagens.
- APIs de cache e checkpoint, visualizações temporárias globais, chamadas de gerenciamento de montagens do DBFS e código em Scala ou R são impedimentos absolutos por padrão. Você pode instruir o agente a prosseguir, mas a funcionalidade não resolvida permanece inalterada e pode falhar no serverless.
- Jobs com mais de 10 tarefas migráveis não podem ser migrados.
- O agente no Genie Code migra uma carga de trabalho por vez. Para migrar múltiplos jobs, crie uma migração por job com a CLI do Databricks. Não existe um fluxo de descoberta ou aprovação administrativa em toda a frota.
- Com a CLI do Databricks, o agente migra apenas os trabalhos. Um job que tenha um notebook ou tarefa Python obtida de um repositório Git remoto falha na migração.
- O agente propõe alterações e aplica as que você aceita, mas não verifica a correção da saída. Verifique uma carga de trabalho migrada antes de depender dela para dados de produção.
- Se a fonte de verdade da sua carga de trabalho for um Databricks Asset Bundle ou uma pasta Git, o agente aplica alterações ao objeto de workspace já existente. Reconcilie essas mudanças com seu bundle ou repositório para que uma implantação posterior não sobrescrita a migração.
Migre para serverless manualmente
Para migrar suas cargas de trabalho da computação clássica para a computação sem servidor, siga estas etapas:
- Verifique os pré-requisitos: verifique se seu espaço de trabalho, rede e acesso ao armazenamento em nuvem atendam aos requisitos. Consulte Pré-requisitos.
- Atualizar código: Faça quaisquer alterações necessárias no código e na configuração. Consulte Atualizar seu código.
- Teste suas cargas de trabalho: Valide a compatibilidade e correção antes da transição. Veja Teste suas cargas de trabalho.
- Escolha um modo de desempenho: Selecione o modo de desempenho que melhor atenda às suas necessidades de carga de trabalho. Consulte Escolher um modo de desempenho.
- Migre em fases: Implemente o serverless de forma incremental, começando com cargas de trabalho novas e de baixo risco. Consulte Migrar em fases.
- Monitore custos: Monitore o consumo de DBU sem servidor e configure alertas. Consulte os custos do Monitor.
Prerequisites
Antes de começar a migrar, talvez seja necessário atualizar algumas configurações herdadas em seu workspace.
| Pré-requisito | Ação | Detalhes |
|---|---|---|
| O workspace está habilitado para o Unity Catalog | Migrar do Metastore do Hive, se necessário | Atualize um workspace Azure Databricks para o Catálogo Unity |
| Rede configurada | Substituir o emparelhamento VPC por NCCs, Link Privado ou regras de firewall | Rede de camada de computação sem servidor |
| Acesso ao armazenamento em nuvem | Substitua os padrões de acesso a dados herdados por localizações externas do Unity Catalog. | Conecte-se ao armazenamento de objetos na nuvem usando o Catálogo Unity |
Confirme se o workspace está em uma região com suporte.
Atualizar o código
As seções a seguir listam o código e as alterações de configuração necessárias para tornar suas cargas de trabalho compatíveis com sem servidor.
Acesso a dados
Não há suporte para padrões de acesso a dados herdados em computação sem servidor. Atualize seu código para usar o Catálogo do Unity.
| Padrão clássico | Substituição sem servidor | Detalhes |
|---|---|---|
Caminhos DBFS (dbfs:/...) |
Volumes do Catálogo do Unity | O que são os volumes do Catálogo do Unity? |
| Tabelas do Metastore do Hive | Tabelas Unity Catalog (ou Federação HMS) | Atualize um workspace do Azure Databricks para o Unity Catalog |
| Credenciais da conta de armazenamento | Locais externos do Unity Catalog | Conecte-se ao armazenamento de objetos na nuvem usando o Catálogo Unity |
| JDBC JARs personalizados | Federação do Lakehouse | O que é federação de consultas? |
Aviso
O acesso ao DBFS é limitado no modo sem servidor. Atualize todos os caminhos dbfs:/ para volumes do Catálogo do Unity antes de migrar. Para obter mais informações, consulte Migrar arquivos armazenados no DBFS.
Exemplo: Substituir caminhos DBFS e referências de Metastore Hive
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
APIs e código
Determinadas APIs e padrões de código não são suportados em ambientes serverless. Faça referência a esta tabela para ver se o código precisa ser atualizado.
| Padrão clássico | Substituição sem servidor | Detalhes |
|---|---|---|
APIs RDD (sc.parallelize, rdd.map) |
DataFrame APIs | Compare o Spark Connect com o Spark Classic |
spark.sparkContext, sqlContext |
Usar spark (SparkSession) diretamente |
Compare o Spark Connect com o Spark Classic |
Variáveis do Hive (${var}) |
SQL DECLARE VARIABLE ou f-strings do Python |
DECLARE VARIABLE |
| Configurações do Spark sem suporte | Remova configurações sem suporte. A maioria das configurações é ajustada automaticamente sem servidor. | Configurar propriedades do Spark para notebooks e tarefas serverless |
Exemplo: Substituir operações RDD por DataFrames
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
Exemplo: Substituir APIs do SparkContext
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")
Diferenças de comportamento SQL
Computação serverless ativa o modo ANSI por padrão. O Databricks Runtime ativa o modo ANSI por padrão na versão 17.0 e superior. Se seu classic compute roda uma versão anterior, algumas consultas que têm sucesso ali geram erros de runtime no serverless.
O Genie Migrate for Serverless ajusta automaticamente o código para o comportamento do modo ANSI. Se você migrar manualmente, revise as seguintes operações, que geralmente mudam o comportamento:
| Operação | Computação clássica com modo ANSI desativado | Computação sem servidor |
|---|---|---|
Conversão inválida, como CAST('abc' AS INT) |
Retorna NULL |
Gera CAST_INVALID_INPUT |
| Estouro aritmético de inteiros | Contorna. Por exemplo, 2147483647 + 1 retorna -2147483648. |
Gera ARITHMETIC_OVERFLOW |
| Transbordamento aritmético decimal | Retorna NULL |
Gera NUMERIC_VALUE_OUT_OF_RANGE |
| Divisão por zero | Retorna NULL |
Gera DIVIDE_BY_ZERO |
| URL malformada em parse_url | Retorna NULL |
Gera INVALID_URL |
Para retornar NULL em vez de gerar uma exceção, substitua a operação pela operação try_* equivalente, como try_cast, try_add, try_divide ou try_parse_url. O Databricks recomenda esta abordagem em vez de desativar o modo ANSI, porque o modo ANSI expõe problemas de qualidade de dados que um NULL silencioso oculta.
Para optar por sair do modo ANSI para casts, aritmética e análise sintática, defina spark.sql.ansi.enabled para false. A computação serverless aplica regras ANSI a casts implícitos em inserts de tabela independentemente dessa configuração, pois spark.sql.storeAssignmentPolicy não pode ser alterado em computação serverless. Para uma descrição completa do comportamento ANSI, veja conformidade ANSI em Databricks Runtime.
Bibliotecas e ambientes
Você pode gerenciar bibliotecas e ambientes no nível do workspace usando ambientes base e no nível do notebook usando o ambiente sem servidor do notebook.
| Padrão clássico | Substituição sem servidor | Detalhes |
|---|---|---|
| Scripts de inicialização | Ambientes sem servidor | Configurar o ambiente sem servidor |
| Bibliotecas com escopo de cluster | Bibliotecas de ambiente ou com escopo de bloco de anotações | Configurar o ambiente sem servidor |
| Bibliotecas Maven/JAR | Suporte para tarefas JAR em trabalhos; PyPI para notebooks | Tarefa JAR para jobs |
| Contêineres do Docker | Ambientes sem servidor para necessidades de biblioteca | Configurar o ambiente sem servidor |
Fixe pacotes Python em requirements.txt para criar ambientes reproduzíveis. Consulte Especificar versões de pacotes do Python.
Transmissão ao vivo
Há suporte para cargas de trabalho de streaming sem servidor, mas não há suporte para determinados gatilhos. Atualize seu código para usar os gatilhos com suporte.
| Acionador do Spark | Supported | Observações |
|---|---|---|
Trigger.AvailableNow() |
Sim | Recomendado |
Trigger.Once() |
Sim | Isto está obsoleto. Use Trigger.AvailableNow() em seu lugar. |
Trigger.ProcessingTime(interval) |
No | Retorna INFINITE_STREAMING_TRIGGER_NOT_SUPPORTED |
Trigger.Continuous(interval) |
No | Em vez disso, use o modo contínuo dos pipelines do Lakeflow |
Padrão (sem definir .trigger()) |
No | Omitindo .trigger() define por padrão o ProcessingTime("0 seconds"), que não é suportado em ambientes sem servidor. Sempre defina .trigger(availableNow=True) explicitamente. |
Para streaming contínuo, migre para Pipelines Declarativos do Spark em modo contínuo ou use tarefas agendadas continuamente com AvailableNow. Para fontes grandes, defina maxFilesPerTrigger ou maxBytesPerTrigger e evite erros fora de memória.
Exemplo: Corrigir gatilhos de streaming
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
Teste as suas cargas de trabalho
- Teste rápido de compatibilidade: Execute a carga de trabalho na computação clássica com modo de acesso Standard e Databricks Runtime 14.3 ou superior. Se a execução for bem-sucedida, a carga de trabalho poderá migrar para sem servidor sem nenhuma alteração de código.
- Comparação A/B (recomendada para produção): Execute a mesma carga de trabalho na versão classic (controle) e serverless (experimento). Comparar tabelas de saída e verificar a exatidão. Iterar até que os resultados correspondam.
- Configurações temporárias: Você pode definir temporariamente as configurações Spark suportadas durante os testes. Remova-os quando estiverem estáveis.
Escolher um modo de desempenho
Os pipelines e trabalhos sem servidor dão suporte a dois modos de desempenho: padrão e otimizado para desempenho. O modo de desempenho escolhido depende dos requisitos de carga de trabalho.
| Modo | Disponibilidade | Inicialização | Mais adequado para |
|---|---|---|---|
| Standard | Trabalhos, pipelines do Lakeflow | Normalmente 4-6 minutos | Lote sensível ao custo |
| Otimizado para desempenho | Trabalhos, pipelines do Lakeflow | Normalmente menos de um minuto | Interativo, sensível à latência |
O modo padrão consome menos DBUs do que o modo otimizado para desempenho, então custa menos. Para comparar os modos e definir o modo para um trabalho ou pipeline migrado, consulte Escolher um modo de desempenho para tarefas e pipelines serverless.
Migrar em fases
- Novas cargas de trabalho: Inicie todos os novos notebooks e tarefas em serverless.
- Cargas de trabalho de baixo risco: migre cargas de trabalho PySpark/SQL já no modo de acesso padrão e Databricks Runtime 14.3 ou superior.
- Cargas de trabalho complexas: migre cargas de trabalho que necessitem de alterações no código (reescritas RDD, atualizações de DBFS, correções de gatilhos).
- Cargas de trabalho restantes: Revise periodicamente conforme as capacidades se expandem.
Monitorar custos
A cobrança sem servidor é baseada no consumo de DBU, não no tempo de atividade do cluster. Valide as expectativas de custo com cargas de trabalho representativas antes de migrar em escala. Para ferramentas e estratégias para monitorar custos sem servidor, consulte Monitorar o custo da computação sem servidor.
Recursos adicionais
- Boas práticas para computação serverless: dicas de otimização para cargas de trabalho serverless
- Limitações de computação sem servidor: Lista completa de limitações atuais e recursos não suportados
- Configurar o ambiente serverless: gerenciar bibliotecas e dependências
- Configurações Spark suportadas: Configurações Spark disponíveis em serverless
- Spark Connect vs. Spark clássico: Diferenças comportamentais na arquitetura serverless
-
Armazene DataFrames em computação serverless: Armazene DataFrames em cache com
df.cache()edf.persist() - Segurança de rede sem servidor: NCCs, Link Privado e configuração de firewall
- Notas de lançamento para computação serverless: acompanhe novas capacidades à medida que são disponibilizadas
- Guia de atualização do Unity Catalog: migrar do Hive Metastore para o Unity Catalog
Você também pode consultar as seguintes postagens no blog para obter mais informações:
- O que é computação serverless?: Visão geral das capacidades serverless e dos resultados para clientes
- Evolução da engenharia de dados: Como a computação serverless está transformando notebooks e jobs Lakeflow: Como serverless alimenta Lakeflow Jobs e Pipelines