Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
O sdp-meta projeto do Databricks Labs fornece ferramentas para gerar pipelines de metadados que você mantém.
Note
O projeto de código aberto sdp-meta, como todos os projetos na conta do GitHub databrickslabs, destina-se apenas à exploração. O Azure Databricks não dá suporte a ele nem fornece SLAs (contratos de nível de serviço) para ele. Não abra chamados de suporte do Azure Databricks sobre problemas relacionados a este projeto. Em vez disso, registre um problema de GitHub, que é revisado conforme o tempo permite.
O que é sdp-meta?
Os pipelines do Lakeflow permitem especificar declarativamente uma tabela e gerar um fluxo em um pipeline que cria a tabela e a mantém atualizada à medida que os dados de origem são alterados. No entanto, se sua organização tiver centenas de tabelas, gerar e gerenciar esses pipelines pode consumir muito tempo e levar a práticas inconsistentes.
O projeto sdp-meta é uma estrutura de metaprogramação orientada a metadados, projetada para trabalhar com pipelines Lakeflow. Essa estrutura permite a automação de pipelines de dados bronze e silver aproveitando metadados registrados em um conjunto de arquivos JSON e YAML. Em tempo de execução, pipelines genéricos leem seus metadados e constroem dinamicamente os fluxos descritos neles. O processamento de bronze e prata pode ser executado em pipelines separados ou em conjunto em um pipeline combinado. Você gera os metadados dos seus pipelines, e o sdp-meta gera os seus pipelines.
Com sua lógica centralizada em um só lugar (os metadados), seu sistema é mais rápido, reutilizável e mais fácil de manter.
Note
O projeto sdp-meta foi anteriormente nomeado dlt-meta, em referência ao recurso mais antigo Delta Live Tables no Azure Databricks.
Delta Live Tables foi substituído pelo Lakeflow pipelines, e o sdp-meta é compatível com o Lakeflow pipelines. Se você está atualizando uma instalação existente dlt-meta , veja o guia de migração na documentação do sdp-meta.
Benefícios do sdp-meta
Existem dois principais casos de uso para o sdp-meta:
- Ingira e limpe um grande número de tabelas com facilidade.
- Aplicar padrões de engenharia de dados em vários pipelines e para vários usuários.
Os benefícios de usar uma abordagem orientada por metadados incluem:
- A manutenção de metadados pode ser feita sem conhecimento do código Python ou SQL.
- Manter metadados, em vez do código, requer menos sobrecarga e reduz erros.
- O código é gerado por sdp-meta, então permanece consistente e tem menos código personalizado entre pipelines e tabelas publicadas.
- Você pode agrupar facilmente tabelas em pipelines dentro dos metadados, gerando o número de pipelines necessários para atualizar seus dados com mais eficiência.
Como funciona o sdp-meta
A imagem a seguir mostra uma visão geral do sistema sdp-meta:
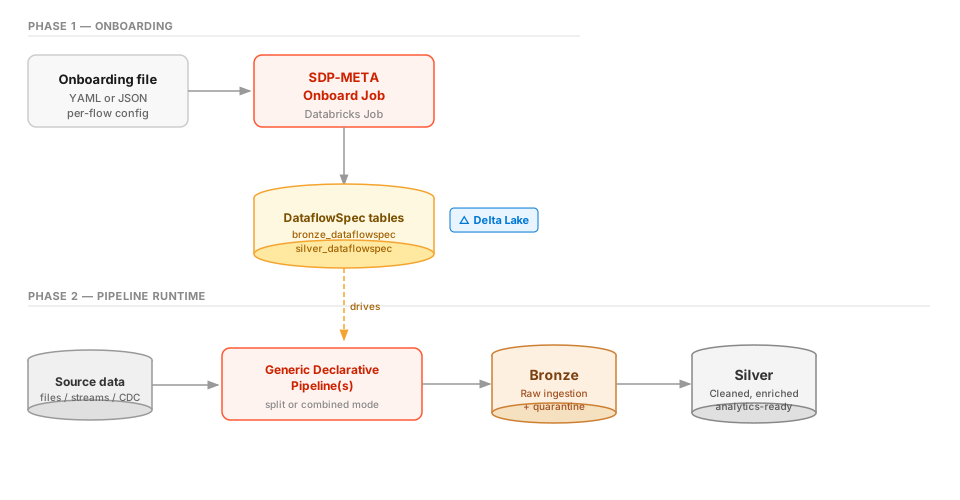
- Você cria os arquivos de metadados como entrada para o sdp-meta, para especificar seus arquivos de origem e saídas, regras de qualidade e processamento necessário. Esses arquivos de onboarding podem ser escritos em JSON ou YAML.
- Você administra o trabalho de integração do SDP-meta. O motor compila os arquivos de onboarding em uma especificação de fluxo de dados, chamada DataflowSpec, e os armazena em tabelas Delta (
bronze_dataflowspecesilver_dataflowspec) para uso posterior. - Em tempo de execução, um pipeline genérico lê o DataflowSpec e constrói dinamicamente o grafo de processamento da camada bronze. Ele lê seus dados de origem (arquivos, fluxos ou CDC) e aplica as expectativas corretas de dados para corresponder às suas regras de qualidade, gerando suas tabelas bronze e colocando registros em quarentena que não cumpram essas regras.
- O processamento de prata pode rodar em um pipeline genérico separado, que é o padrão para Declarative Automation Bundles, ou no mesmo pipeline quando você usa o modo combinado. O pipeline utiliza o DataflowSpec para aplicar as transformações apropriadas e outros processamentos, gerando tabelas de prata que são limpas, enriquecidas e prontas para análises.
Você executa os pipelines gerados pelo sdp-meta para manter o resultado atualizado à medida que os dados de origem são atualizados.
Introdução
Para usar o sdp-meta, você deve:
- Implante e configure a solução sdp-meta.
- Prepare os metadados para suas tabelas de camadas bronze e prata.
- Crie um trabalho para integrar os metadados.
- Use os metadados para criar fluxos de processamento para as suas tabelas.
O projeto sdp-meta suporta várias interfaces de implantação: bundles (recomendado), uma CLI interativa, um aplicativo Databricks com interface gráfica baseada em navegador, um servidor MCP para configuração assistida por IA e um Agent Skill portátil para agentes de IA conscientes da habilidade.
A documentação sdp-meta no GitHub tem um tutorial para ajudar você a começar esse processo. Para mais informações, veja como começar com o sdp-meta no GitHub.