Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
O AI Runtime oferece dois ambientes Python gerenciados. O ambiente padrão inclui cuda. A partir da versão 5 do ambiente, torch e torchvision não são mais pré-instalados. O ambiente de IA do Databricks vem pré-carregado com PyTorch, Transformers e outros frameworks de ML e deep learning. Escolha o ambiente Standard para controle total sobre sua pilha de dependências ou o ambiente de IA para uma configuração de treinamento pronta para uso. Você pode começar em qualquer um dos ambientes e instalar mais pacotes por conta própria.
Pontos-chave desta página:
- Escolha o ambiente Standard para ter controle total sobre as dependências ou o ambiente Databricks AI para uma pilha de aprendizado de máquina pronta para usar.
- O padrão inclui
cuda. A partir da versão 5 do ambiente,torchetorchvisionnão são pré-instalados. O ambiente de IA adiciona PyTorch, Transformers e mais. - Instale mais pacotes com
%uv pip install(ambiente versão 5 e superior) ou%pip installem um notebook, ou comenvironment.dependenciesna linha de código.
Qual ambiente usar
O AI Runtime oferece dois ambientes de Python gerenciados, o ambiente Standard e o ambiente de IA do Databricks. As cargas de trabalho que você envia com a CLI Databricks também podem ser executadas em uma imagem Docker personalizada.
| Environment | Características principais | Quando usar |
|---|---|---|
| Ambiente padrão | Mínimo; inclui cuda. A partir da versão 5 do ambiente, torch e torchvision não são mais pré-instalados. |
Você deseja ter controle total sobre sua pilha de dependências e prefere instalar apenas o que precisa |
| Ambiente de IA do Databricks | Pré-carregado com estruturas ML populares (PyTorch, Transformers e muito mais) | Você deseja um ambiente completo para treinamento, ajuste fino e experimentação sem gerenciamento manual de dependências |
| Imagem Docker personalizada (Prévia pública) | Sua própria imagem armazenada no Registro de Artefatos, geralmente construída a partir de uma imagem base do Databricks. Disponível para cargas de trabalho da CLI do Databricks. Um administrador de espaço de trabalho deve habilitar a pré-visualização do Registro de Artefatos do Databricks . | Você precisa de bibliotecas de sistema, extensões CUDA compiladas ou uma configuração de container existente que você não consegue reproduzir com environment.dependencies |
Você também pode usar um ambiente base do espaço de trabalho que um administrador do espaço de trabalho criou para o AI Runtime. Consulte Build para computação de GPU sem servidor (AI Runtime).
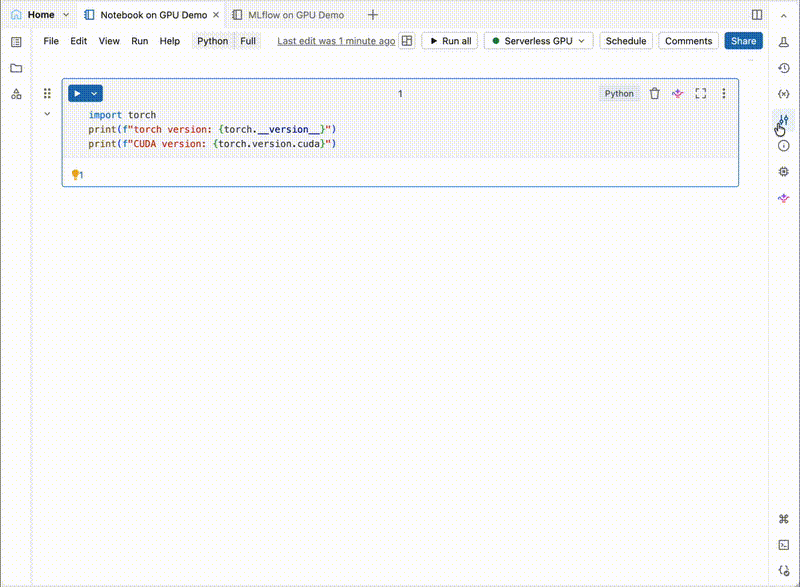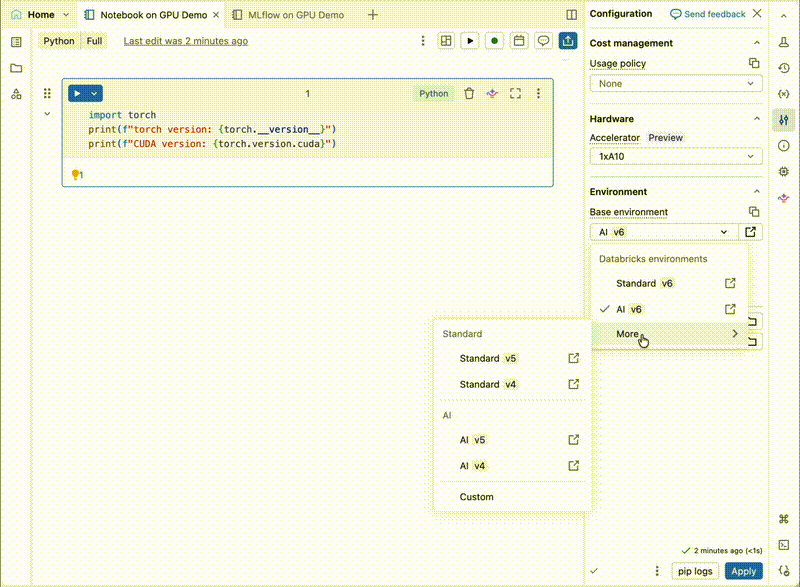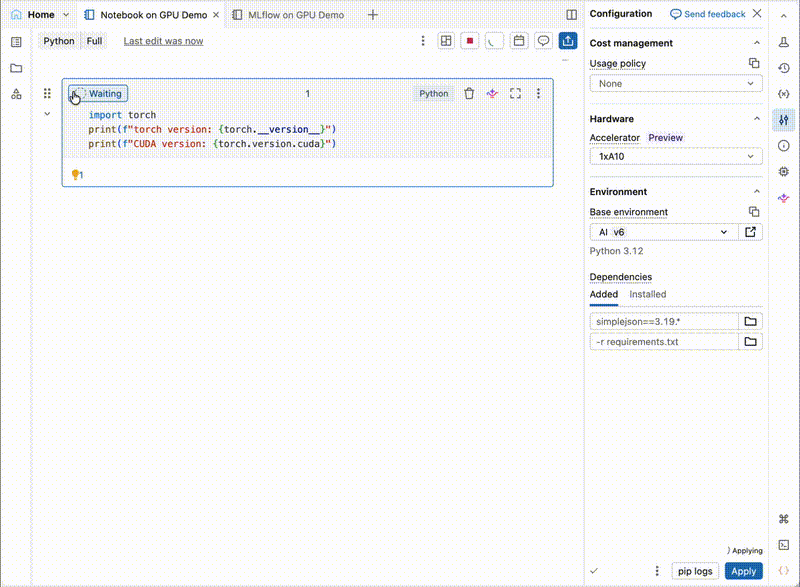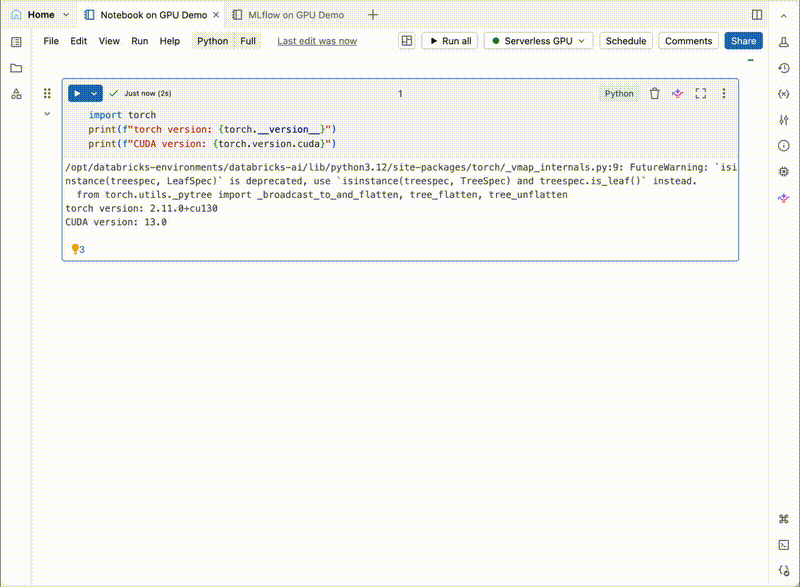
Para escolher um ambiente em um caderno, abra o painel lateral Ambiente e selecione um ambiente base:
Ambiente padrão (ambiente mínimo)
Um ambiente mínimo e estável que contém apenas os pacotes necessários para a operação de AI Runtime. O ambiente inclui cuda para suporte a GPU. A partir da versão 5 do ambiente, torch e torchvision não são mais pré-instalados. Instale as versões que sua carga de trabalho precisa com %uv pip install ou %pip install. Para obter os pacotes instalados em cada versão do ambiente, consulte as notas de versão abaixo.
Melhor para: usuários que querem controle total sobre sua pilha de dependências e preferem instalar apenas o que precisam.
Para selecionar: No painel lateral de Ambiente , escolha Standard v6 como seu ambiente base.
Para obter mais detalhes sobre as versões do pacote instaladas em diferentes versões do software, confira as notas de versão:
Ambiente de IA do Databricks
Disponível no ambiente 4 e posterior. O ambiente de IA é criado com base no ambiente Standard com pacotes de runtime comuns e pacotes específicos do aprendizado de máquina em GPUs. Os pacotes pré-instalados incluem:
- PyTorch (com suporte ao CUDA)
- Transformadores (Hugging Face)
- E dependências adicionais de ML/DL
Melhor para: profissionais de ML que desejam um ambiente completo para cargas de trabalho de treinamento, ajuste de precisão e experimentação sem gerenciamento manual de dependências.
Para selecionar: No painel lateral de Ambiente , escolha AI v6 como seu ambiente base.
Para obter mais detalhes sobre as versões do pacote instaladas em diferentes versões do software, confira as notas de versão:
Instale pacotes adicionais
Você pode começar a partir de um ambiente gerenciado ou de um ambiente base do espaço de trabalho e instalar seus próprios pacotes Python sobre ele. Como você os instala depende de como você se conecta ao AI Runtime.
Em um caderno
Instale pacotes no topo do seu notebook ou script de treinamento com %uv pip, que instala com uv e é mais rápido do que %pip. Fixe as versões para que as execuções permaneçam reproduzíveis:
%uv pip install "trl==1.1.0"
%uv pip install "transformers==5.5.4"
Para a referência completa de %pip e %uv pip, incluindo quais versões do ambiente oferecem suporte a cada um, consulte Gerenciar bibliotecas com comandos %uv.
Quando você usa o decorador @distributed para cargas de trabalho com várias GPUs, os pacotes que você instala antes de chamar .distributed() são automaticamente capturados em um snapshot e propagados para todos os processos distribuídos. O tamanho total dos pacotes instalados não deve exceder 15 GB. Para obter mais detalhes, consulte Adicionar dependências ao notebook.
Com o CLI
A air CLI utiliza os mesmos ambientes gerenciados. Selecione um com environment.version e depois liste, em environment.dependencies no seu YAML de carga de trabalho, os pacotes a serem instalados com base nele. A CLI os instala no ambiente selecionado com UV, então você não gerencia um ambiente virtual separado por conta própria:
environment:
  version: '6'
  dependencies:
    - trl==1.1.0
    - transformers==5.5.4
O ambiente Standard não inclui torch ou torchvision, portanto, se sua carga de trabalho os importar, adicione-os a dependencies. Para começar pelo ambiente de IA Databricks, que inclui o PyTorch, defina version para um identificador de ambiente de IA como databricks_ai_v6. Para o formato completo de dependência e os flags de instalação suportados, consulte environment. Para executar a carga de trabalho na sua própria imagem em vez de um ambiente gerenciado, consulte Usar imagens Docker personalizadas com AI Runtime.
Passe credenciais para uma carga de trabalho com segredos
Use segredos do espaço de trabalho para passar credenciais para cargas de trabalho enviadas com a CLI do Databricks. A carga de trabalho é executada como o usuário ou principal do serviço autenticado pelo perfil CLI selecionado. O procedimento a seguir usa um token Hugging Face como exemplo. Para passar outra credencial, substitua HF_TOKEN pela variável de ambiente que sua aplicação lê. Para os requisitos do token Hugging Face, consulte os Tokens do Hugging Face.
Selecione o espaço de trabalho onde você executa a carga de trabalho e confirme seu host:
export DATABRICKS_CONFIG_PROFILE=<profile>
databricks auth describe
Crie um escopo secreto com suporte do Databricks ou use um escopo existente no qual você possa gravar. Substitua o escopo e os marcadores de chave pelos nomes que você usa na sua carga de trabalho YAML:
databricks secrets create-scope <scope-name>
databricks secrets put-secret <scope-name> <key-name>
Digite o token no prompt interativo. Mantenha o token fora do YAML, dos argumentos de comando e do controle de versão. Se você usar um escopo existente, pule
create-scope. Nomes-chave não podem conter/. Se a chave já existir,put-secretsobrescreve seu valor.Se o usuário autenticado ou o principal de serviço não tiver
READacesso ao escopo, peça a um usuário comMANAGEpermissão sobre o escopo que conceda acesso. Se você criou o escopo com a mesma identidade, você já temMANAGE, que incluiREAD, e pode pular essa etapa. Substitua<principal>pelo endereço de e-mail do usuário autenticado, o ID do aplicativo do principal de serviço ou o nome do grupo:databricks secrets put-acl <scope-name> <principal> READConceder permissões em um escopo secreto requer o plano Premium. As permissões de escopo se aplicam a todo segredo do escopo. Use um escopo dedicado quando precisar restringir o acesso. Veja permissões do escopo de segredo.
Faça referência ao segredo no YAML da sua carga de trabalho:
secrets:
  HF_TOKEN: <scope-name>/<key-name>
O AI Runtime resolve a referência e fornece o token como a variável de ambiente
HF_TOKENpara a carga de trabalho. ConfigurarHF_TOKENapenas no seu shell local não configura a carga de trabalho remota.Verifique as permissões de chave e escopo sem recuperar ou imprimir o token:
databricks secrets list-secrets <scope-name>
databricks secrets list-acls <scope-name>
Confirme que a chave esperada existe e que o usuário ou principal de serviço autenticado possui
READou uma permissão superior, diretamente ou por meio de um grupo. Esses comandos mostram metadados-chave e permissões de escopo. Eles não validam o token ou a aprovação do modelo. Se você não puder listar permissões de escopo, peça a um usuário comMANAGEpermissão sobre o escopo para verificar o acesso.
Os segredos são restritos ao espaço de trabalho. Ao alterar perfis ou espaços de trabalho de CLI, repita as verificações host, chave e acesso no espaço de trabalho de destino. O mesmo escopo e os mesmos nomes de chave podem se referir a segredos diferentes em diferentes áreas de trabalho.
Após atualizar um segredo, uma carga de trabalho executada novamente recebe o novo valor. No código do notebook, leia o secret novamente para recuperar seu valor atualizado.
Para workloads de notebook, use dbutils.secrets.get para ler um segredo do workspace. Por exemplo, para definir HF_TOKEN no processo Python do notebook:
import os

os.environ["HF_TOKEN"] = dbutils.secrets.get(scope="<scope-name>", key="<key-name>")
Não imprima o segredo. A identidade do caderno precisa READ de acesso ao escopo. Veja o comando get (dbutils.secrets.get).
tokens do Hugging Face
Antes de executar uma carga de trabalho que leia um modelo privado ou com bloqueio, crie um token de acesso Hugging Face com acesso de leitura ao repositório do modelo. Para um token detalhado, conceda acesso de leitura a esse repositório. A conta Hugging Face que detém o token deve ter acesso ao modelo. Criar um token não garante aprovação para o modelo.
O mapeamento de segredo no procedimento fornece o token como HF_TOKEN, que as bibliotecas Hugging Face leem do ambiente da carga de trabalho.
Solucionar problemas de acesso a segredos e modelos
Se a carga de trabalho falhar, encontre o sintoma na tabela a seguir:
| Sintoma | Corrigir |
|---|---|
| A carga de trabalho não consegue encontrar o escopo ou a chave. | Confirme se o escopo e a chave no YAML da carga de trabalho correspondem aos que você criou no espaço de trabalho onde enviou a carga de trabalho. |
| Erro de permissão de segredo. | Conceda ao usuário ou principal do serviço autenticado pela CLI READ acesso ao escopo. Veja o procedimento anterior. |
| Hugging Face rejeita o token (401). | Verifique se o token é válido e possui acesso de leitura ao repositório do modelo. Substitua um token expirado ou revogado. |
GatedRepoError ou uma resposta 403 para um repositório com acesso restrito. |
Confirme que o acesso do proprietário do token ao modelo foi aprovado e que o token possui acesso de leitura a esse repositório. |
Ambientes base do workspace
Um administrador de workspace pode construir um ambiente base de workspace para o AI Runtime, que o torna disponível para todos os usuários do workspace através do menu suspenso Ambiente base. Para obter detalhes, consulte Build para computação de GPU sem servidor (AI Runtime).
Para usar um ambiente base em uma carga de trabalho agendada, referencie-o pelo identificador no bloco environments de um trabalho ou pacote. Por exemplo, esta tarefa Declarative Automation Bundles seleciona o ambiente de IA Databricks:
resources:
  jobs:
    train:
      tasks:
        - task_key: train
          environment_key: default
      environments:
        - environment_key: default
          spec:
            base_environment: databricks_ai_v6
Para um exemplo completo de job, consulte Programar cargas de trabalho de GPU e compor tarefas.
Cache de ambiente e módulos personalizados
Quando os ambientes são armazenados em cache?
O AI Runtime armazena em cache o ambiente do seu notebook, então quando você reabre o notebook não precisa reinstalar pacotes. Para detalhes, veja Resetar as dependências do ambiente.
Cache se aplica a cadernos interativos. Cargas de trabalho executadas por meio da air CLI ou agendadas como tarefas não usam esse cache; cada execução instala novamente as dependências.
Como boa prática, fixe pacotes para uma versão específica para que seu ambiente em cache permaneça válido e suas execuções sejam reproduzíveis.
Como importar módulos personalizados?
Os passos a seguir mostram como usar seus próprios módulos em Python.
- Sincronize seu código com o espaço de trabalho. Clone um repositório Git no workspace com uma pasta Git ou carregue os arquivos diretamente como arquivos do workspace. Armazene o código compartilhado em
/Workspace/Sharedpara projetos em equipe, ou na pasta do usuário para desenvolvimento pessoal. Manter o código em uma pasta Git mantém o controle de versão. -
Adicione a pasta a
sys.pathe importe-a no topo do seu notebook ou script de treinamento:
import sys
sys.path.append("/Workspace/Shared/my-project/src")
from my_module import my_function
Limitations
Os seguintes recursos não estão disponíveis no AI Runtime:
- Funções do Spark: você não pode importar ou usar funções do PySpark diretamente. O AI Runtime é um ambiente somente Python; O Spark não está disponível como um runtime local. No entanto, o Spark Connect está disponível para carregamento de dados. Consulte Carregar dados no AI Runtime.
- Bibliotecas de ML do Databricks Runtime: os pacotes pré-instalados não são um substituto para o Databricks Runtime ML. Algumas bibliotecas de ML disponíveis no Databricks Runtime ML podem não estar pré-instaladas no AI Runtime.
- Artefatos privados: o AI Runtime dá suporte a artefatos privados em determinados casos. Entre em contato com sua equipe de conta para obter mais detalhes.