Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
O AI Runtime se integra ao MLflow para fornecer ferramentas de rastreamento de experimentos, observabilidade e depuração. O MLflow oferece um único local para os parâmetros de uma execução, métricas, métricas do sistema GPU, logs e artefatos, seja desenvolvendo em um notebook, enviando uma carga de trabalho com a databricks air CLI ou agendando um trabalho.
O que o MLflow oferece
Um experimento MLflow agrupa execuções de treinamento relacionadas, e cada execução fornece um registro persistente da configuração e dos resultados do treinamento.
- Métricas e parâmetros: Registre a perda de treinamento, métricas de avaliação, taxas de aprendizado e hiperparâmetros, e então compare-os entre as execuções.
- Métricas do sistema: Veja a utilização da GPU, CPU e memória para execuções gerenciadas na aba de métricas do sistema .
- Visualização de logs: visualize a saída do driver para uma carga de trabalho com suporte de tarefa na guia Logs da execução. Consulte Visualizar logs na guia Logs do MLflow.
- Artefatos e modelos: Armazene arquivos de modelos, configurações e outras saídas junto com a execução. Use um volume do Unity Catalog para artefatos grandes ou duráveis.
- Compartilhamento e colaboração: Conceda acesso a um experimento para que outros usuários do espaço de trabalho possam visualizar e comparar suas execuções. Consulte Executar treinos com experimentos do MLflow.
- Integrações com frameworks: Use integrações MLflow com Hugging Face Transformers, PyTorch Lightning e outras bibliotecas suportadas.
Para cargas de trabalho respaldadas por trabalhos, como cargas submetidas com databricks air run, a execução do trabalho Azure Databricks complementa o MLflow registrando o status de execução, computação, tentativas e saída do driver.
Como as execuções do MLflow são criadas
Como você inicia ou ingressa em uma execução do MLflow depende de como você inicia a carga de trabalho:
| Como você administra a carga de trabalho | Como a execução do MLflow começa | Como selecionar o experimento |
|---|---|---|
Databricks CLI (databricks air run) |
Cada tentativa cria uma execução automaticamente. | Defina experiment_name no YAML da carga de trabalho. |
Notebook com o SDK de Runtime de IA Databricks (.distributed()) |
Cada chamada cria automaticamente uma execução. | Ligue mlflow.set_experiment() antes de .distributed(), ou defina MLFLOW_EXPERIMENT_NAME. |
| Código executado diretamente em um notebook anexado | Nenhuma execução é criada automaticamente. Use mlflow.start_run() ou registro em log automático. |
Chame mlflow.set_experiment() no notebook. |
Agendado ai_runtime_task |
A tarefa cria uma execução automaticamente. | Defina experiment na configuração da tarefa. Veja a tarefa de execução de IA. |
Depois que seu código iniciar ou ingressar na run correta, use a API de rastreamento do MLflow para registrar dados de treinamento personalizados. Para frameworks suportados, você pode usar o autologging em vez de adicionar chamadas individuais de log. Para padrões de deep learning, veja o fluxo de trabalho de deep learning do MLflow 3.
Use as práticas a seguir ao configurar o rastreamento do MLflow:
- Defina
steppara um valor significativo, como o lote global ou epoch. Registre em intervalos em vez de em cada lote. O MLflow limita o número de passos métricos por execução. Confira Limites de recursos. - Para treinamento distribuído, registre uma métrica a partir do rank 0 apenas para que cada valor seja registrado uma vez.
- Para fluxos de trabalho de notebooks, use caminhos absolutos do experimento, como
/Users/<username>/my-experimentou/Workspace/Shared/<team>/my-experiment. Coloque os experimentos que você quer compartilhar em uma pasta de um espaço de trabalho compartilhado. - Armazene checkpoints grandes e duráveis em um volume do Catálogo Unity. Para padrões de checkpointing, veja Melhorar o desempenho e a resiliência do treinamento em tempo de execução de IA.
Observação
Use o MLflow 3.7 e acima para os exemplos nesta página.
Rastrear cargas de trabalho da CLI do Databricks
Quando você envia uma carga de trabalho com databricks air run, o AI Runtime cria uma execução de job no Azure Databricks para detalhes de execução e uma execução do MLflow para dados de experimentos. A submissão original e suas tentativas compartilham uma execução de tarefa, enquanto cada tentativa cria uma execução separada de MLflow no mesmo experimento para que você possa comparar as tentativas.
Métricas do sistema de GPU, CPU e memória são capturadas automaticamente para cada execução gerenciada e aparecem na aba System metrics do MLflow.
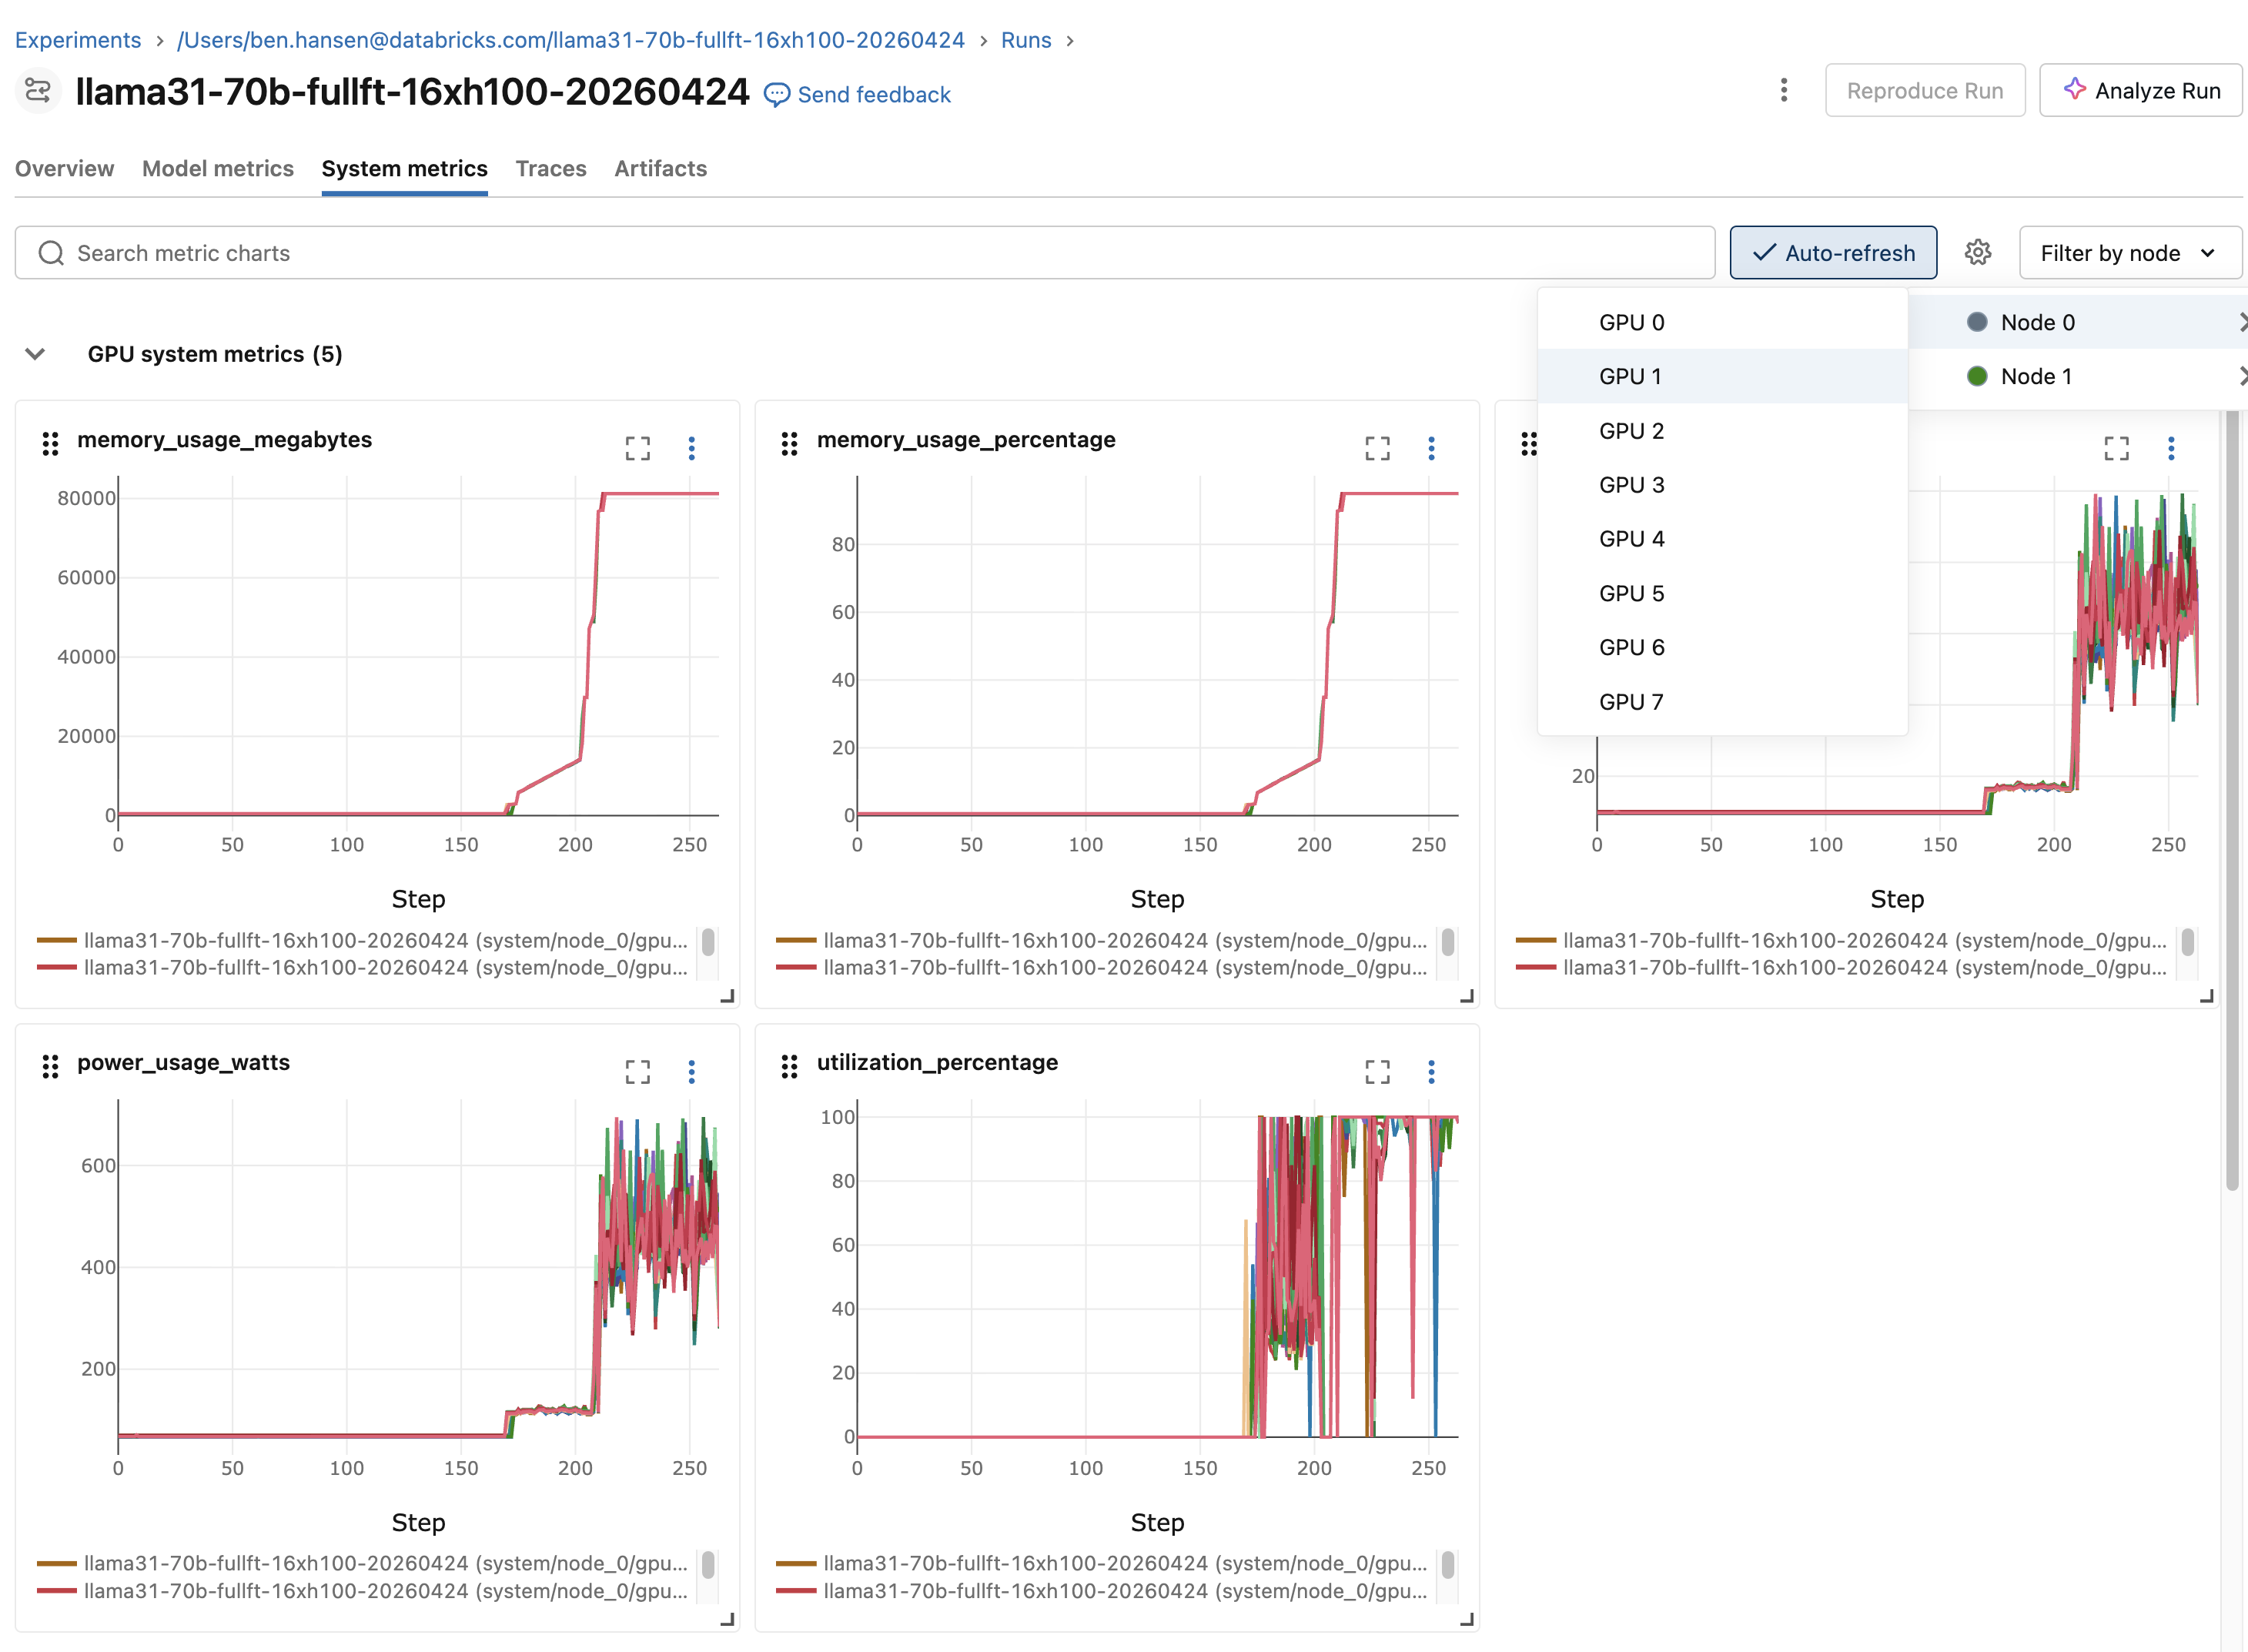
Configure e faça logon na execução
Use o YAML da carga de trabalho para selecionar o experimento e, opcionalmente, configure o nome da execução e a localização do artefato. O exemplo a seguir mostra os campos MLflow necessários:
experiment_name: my-training
mlflow_run_name: baseline-lr3e5
mlflow_artifact_location: /Volumes/main/default/mlflow-artifacts/my-training
Para requisitos de campo, padrões e valores suportados, veja referência Workload YAML.
AI Runtime expõe o ID da execução gerenciada através de MLFLOW_RUN_ID. Para registrar seus próprios parâmetros, métricas e artefatos nessa execução, reabra com a API de rastreamento do MLflow:
import os

import mlflow

# Log from rank 0 only because all nodes share the same MLFLOW_RUN_ID.
if os.environ.get("RANK", "0") == "0":
    with mlflow.start_run(run_id=os.environ["MLFLOW_RUN_ID"]):
        mlflow.log_param("learning_rate", 3e-4)
        for step, loss in enumerate(training_losses):
            mlflow.log_metric("train_loss", loss, step=step)
Encontre execuções e logs
Os logs estão disponíveis tanto pela CLI Databricks quanto pela página de execução do MLflow. Use os seguintes comandos para encontrar cargas de trabalho, inspecionar uma carga de trabalho e transmitir ou baixar logs:
databricks air list --all-status
databricks air get <job-run-id>
databricks air logs <job-run-id>
databricks air logs <job-run-id> --node 2
databricks air logs <job-run-id> --download-to ./logs/
Acompanhar as cargas de trabalho dos notebooks
A partir de um notebook, você pode rodar código diretamente na sessão anexada ou executar treinamento distribuído por meio do decorador @distributed a partir do Databricks AI Runtime SDK.
Execute código diretamente em um notebook
O código executado diretamente em um notebook conectado não cria automaticamente uma execução do MLflow. Selecione um experimento, depois inicie uma execução ou ative o autolog:
import mlflow

mlflow.set_experiment("/Users/<username>/my-experiment")

with mlflow.start_run(run_name="baseline"):
    train()
Para habilitar o autologging do PyTorch Lightning, use o seguinte padrão:
mlflow.pytorch.autolog()

with mlflow.start_run(run_name="lightning-baseline"):
    trainer.fit(model, datamodule=datamodule)
Para Hugging Face Transformers, configure TrainingArguments da seguinte forma:
from transformers import TrainingArguments

args = TrainingArguments(
    output_dir="/Volumes/<catalog>/<schema>/<volume>/checkpoints",
    report_to="mlflow",
    run_name="llama7b-sft-lr3e5",
    logging_steps=50,
)
Use o SDK de Runtime de IA Databricks
Para treinamento distribuído a partir de um notebook, use o @distributed decorador do Databricks AI Runtime SDK (databricks-sdk-air). O SDK está disponível no databricks.air namespace no ambiente GPU versão 6 e superior, ou como serverless_gpu no ambiente GPU versão 5 e abaixo.
from databricks.air import distributed

@distributed()
def train():
    # Training code
    ...

train.distributed()
Cada .distributed() chamada cria automaticamente uma execução de MLflow. O experimento padrão é /Users/{WORKSPACE_USER}/{notebook-name}. Para selecionar outro experimento, defina-o antes de chamar .distributed():
mlflow.set_experiment("/Users/<username>/my-experiment")
train.distributed()
Quando você chama .distributed() dentro de uma execução ativa, o AI Runtime cria uma execução filha aninhada:
with mlflow.start_run() as parent_run:
    train.distributed()
Para retomar uma execução anterior, defina MLFLOW_RUN_ID antes de .distributed():
import os

os.environ["MLFLOW_RUN_ID"] = "<previous-run-id>"
train.distributed()
Use o link de execução na saída da célula ou no painel Experiment do notebook para abrir a execução do MLflow.
Ver registros
- Saída do notebook: A saída padrão e erros do código de treino aparecem na saída da célula do notebook.
-
Logs do MLflow: Para cargas de trabalho de notebook com suporte de job, como chamadas
.distributed(remote=True), a aba Logs do MLflow exibe a saída da execução de job associada.
Monitore os recursos da GPU ao vivo
O painel de recursos da GPU do notebook mostra a utilização ao vivo da GPU, memória e temperatura para cargas de trabalho de nó único e multinó. Use a aba de métricas do Sistema MLflow quando precisar de um registro persistente vinculado a uma execução.
Para abrir o painel, conecte o notebook ao AI Runtime, depois clique em  Recursos de GPU no painel direito.
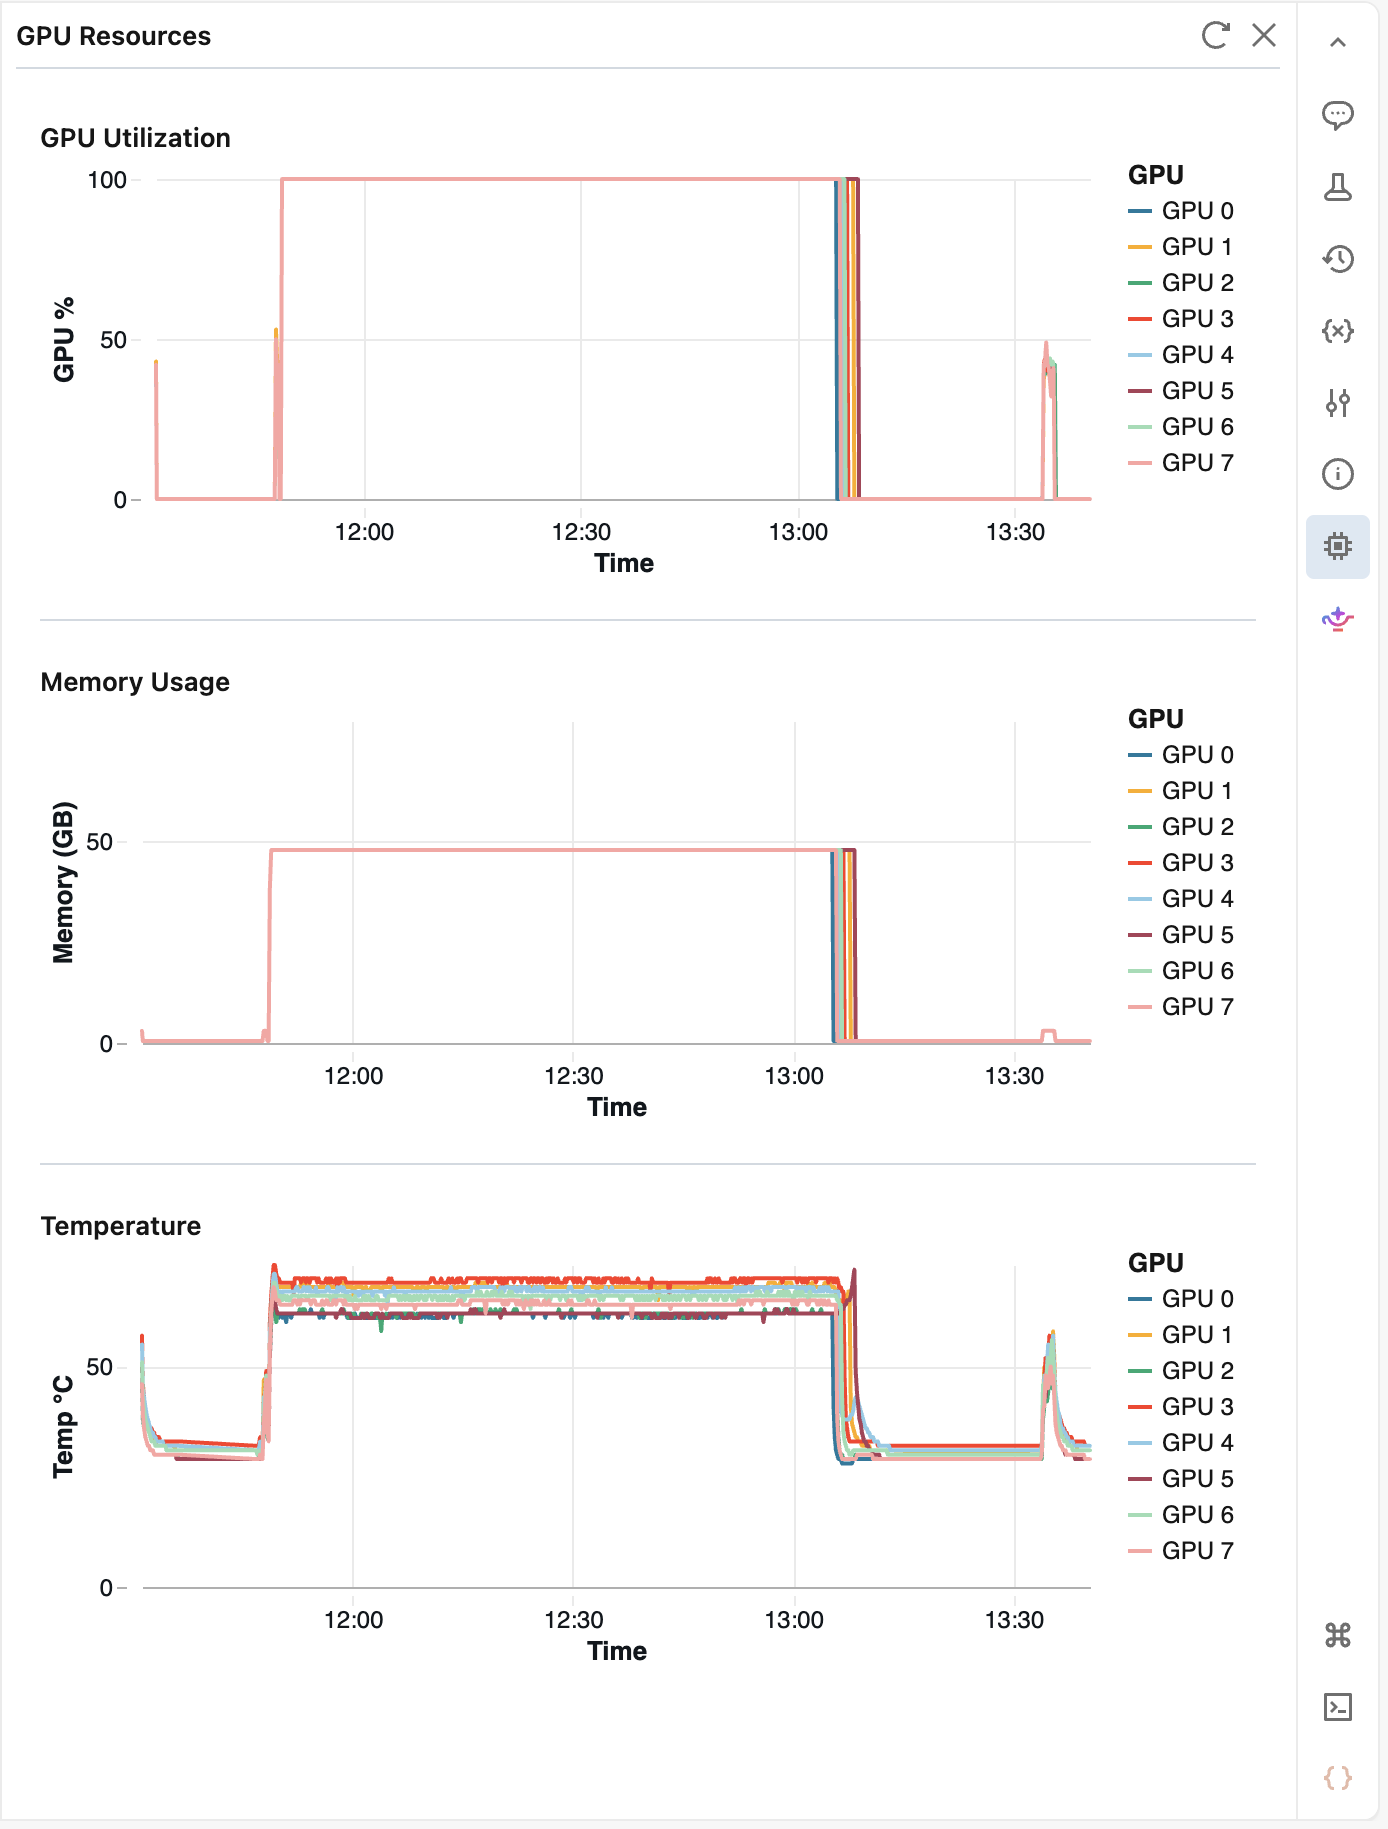
O painel consulta as métricas a cada 10 segundos e mantém até 2 horas de histórico. Clique  Atualizar para obter os valores mais recentes. Após 5 minutos de inatividade, o painel para. Reabra-o para retomar o monitoramento.
Veja os logs na aba MLflow Logs
A aba Logs em uma página de execução no MLflow mostra a saída de uma carga de trabalho do AI Runtime com suporte de job. Para abri-la, vá até a página de execução e clique em Logs.
Para novas rodagens, a aba Logs substitui os arquivos de log anteriormente armazenados na aba Artefatos da execução, que estão obsoletos. As execuções criadas anteriormente mantêm seus arquivos de log na aba Artefatos .
Na aba Logs , você pode:
- Busca: Mostre apenas as linhas que contêm um termo de pesquisa.
- Filtre por nó, nível e intervalo de tempo: selecione um único nó de uma carga de trabalho multi-nós, mostre apenas informações, alertas ou linhas de erro, ou reduza a visualização a um intervalo de tempo.
- Seguir uma carga de trabalho em execução: Enquanto a execução está ativa, uma nova saída aparece assim que chega. Role para cima para pausar a leitura.
- Copiar e baixar: Copie as linhas carregadas, ou baixe todas as linhas que correspondem aos filtros atuais.
Retenção de logs
Os registros ficam disponíveis na aba Registros por 60 dias.
Solucionar problemas de acesso aos logs
A aba Logs em uma página de run MLflow transmite a saída da execução associada do Azure Databricks. O acesso ao experimento MLflow não implica acesso ao job.
Se a guia mostrar Você não tem acesso a esses logs, peça a um usuário com permissão Pode gerenciar ou a um administrador do workspace para conceder a você pelo menos Pode visualizar no trabalho. Confira Controlar o acesso a um trabalho.
Limites globais em Azure Databricks
Confira Limites de recursos.