Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Controle de acesso
Os recursos são objetos governáveis do Catálogo do Unity. O acesso a um recurso é controlado pelos privilégios do CREATE FEATUREREAD FEATURECatálogo do Unity e MANAGE do Unity. Para obter descrições completas, consulte a referência de privilégios do Catálogo do Unity.
-
CREATE FEATURE: Necessário para criar uma característica em um esquema.create_featureeregister_featureexijaCREATE FEATUREno esquema pai. Seguindo o princípio de privilégio mínimo, concedaCREATE FEATUREno nível do esquema; você também pode concedê-lo em um catálogo para permitir a criação de recursos em qualquer esquema nesse catálogo. -
READ FEATURE: Obrigatório para ler metadados de recursos.get_feature,create_training_set, elist_materialized_featuresrequeremREAD FEATUREsobre a característica. Esse privilégio não concede acesso a dados de recursos em tabelas de origem ou de saída materializada. Para ler esses dados para treinamento ou serviço, você também deve estarSELECTnas tabelas aplicáveis.READ FEATUREconcedido em um esquema ou catálogo se aplica a todos os recursos atuais e futuros que ele contém. -
MANAGE: Necessário para gerenciar o ciclo de vida e as concessões de recursos de uma funcionalidade. Deletar uma característica comdelete_feature, e materializar uma característica commaterialize_features, requerMANAGEsobre a característica. Excluir uma característica materializada comdelete_materialized_featurenão é regida porMANAGE: apenas o criador da funcionalidade materializada pode excluí-la.
Todas as operações de recurso também exigem USE CATALOG no catálogo pai e USE SCHEMA no esquema pai. Para saber como MANAGE e READ FEATURE aplicar à materialização, consulte Permissões.
API do Modo de Exibição de Recurso
Feature construtor e register_feature()
A abordagem recomendada é construir um Feature objeto localmente e usá-lo register_feature para persistê-lo no Catálogo do Unity. Esse fluxo de trabalho de duas etapas permite que você experimente recursos (incluindo create_training_set) antes de registrá-los.
Feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
)
FeatureEngineeringClient.register_feature() registra uma construção Feature local no Catálogo do Unity.
FeatureEngineeringClient.register_feature(
    feature: Feature,       # Required: A Feature instance (not already registered)
    catalog_name: str,      # Required: UC catalog name
    schema_name: str,       # Required: UC schema name
) -> Feature
from databricks.feature_engineering.entities import Feature, DeltaTableSource, AggregationFunction, Sum, RollingWindow
from datetime import timedelta

# Step 1: Construct the feature locally
feature = Feature(
    source=DeltaTableSource(catalog_name="main", schema_name="store", table_name="transactions"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)

# Step 2: Register in Unity Catalog
fe = FeatureEngineeringClient()
registered_feature = fe.register_feature(
    feature=feature,
    catalog_name="main",
    schema_name="store",
)
create_feature()
FeatureEngineeringClient.create_feature() valida, constrói e registra imediatamente um recurso no Catálogo do Unity em uma única etapa. Use isso quando você não precisar experimentar o recurso localmente primeiro.
FeatureEngineeringClient.create_feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    catalog_name: str,                                     # Required: The catalog name for the feature
    schema_name: str,                                      # Required: The schema name for the feature
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
) -> Feature
Parâmetros:
-
source: A fonte de dados usada no cálculo de características (DeltaTableSource,StreamSource,RequestSource, ouFeatureViewSource). -
function: EAggregationFunctionque agrupa um operador e uma janela de tempo,ColumnSelection("column_name")para características de passagem ouCustomUDFpara transformações por linha. Veja Funções suportadas para tipos de fonte compatíveis. -
catalog_name: o nome do catálogo do Catálogo do Unity para o recurso. -
schema_name: o nome do esquema do Catálogo do Unity para o recurso. -
entity: lista de nomes de coluna que definem a agregação ou as chaves de pesquisa (chaves primárias). Exigido paraDeltaTableSourceeStreamSource. Por exemplo,["user_id"]agrega ou pesquisa por usuário. Omita eRequestSourceFeatureViewSource. -
timeseries_column: a coluna de carimbo de data/hora usada para agregação de janela de tempo ou seleção de valor mais recente. Exigido paraDeltaTableSourceeStreamSource. Omita eRequestSourceFeatureViewSource. -
name: nome do recurso opcional. Se omitido, gerado automaticamente da coluna de entrada, função e janela (por exemplo,amount_avg_rolling_7d). -
description: descrição opcional do recurso.
Retorna: Uma instância de funcionalidade validada
Gera: ValueError se alguma validação falhar
delete_feature()
Exclui um recurso do Catálogo do Unity por seu nome totalmente qualificado.
FeatureEngineeringClient.delete_feature(
    full_name: str,  # Required: '<catalog>.<schema>.<feature_name>'
) -> None
fe.delete_feature(full_name="main.store.amount_sum_rolling_7d")
Antes de excluir um recurso, remova ou atualize quaisquer modelos ou especificações de recursos que façam referência a ele. Uma funcionalidade não pode ser deletada enquanto ainda tiver funcionalidades materializadas. Exclua primeiro as funcionalidades materializadas, depois apague a funcionalidade. Veja como excluir um recurso materializado.
Nomes gerados automaticamente
Quando name é omitido, um nome é gerado automaticamente. Os nomes gerados seguem o padrão: {column}_{function}_{window}. Por exemplo:
-
price_avg_rolling_1h(preço médio de 1 hora) -
transaction_count_rolling_30d_1d(Contagem de 30 dias de transação com atraso de 1d do carimbo de data/hora do evento)
Funções suportadas
Funções de agregação
Note
As funções de agregação são encapsuladas em uma AggregationFunction janela de tempo, conforme descrito nas janelas de tempo. Cada função usa um input parâmetro que especifica a coluna de origem a ser agregada.
| Função | Description | Exemplo de caso de uso |
|---|---|---|
Sum(input="column") |
Total de valores | Uso diário de aplicativo por usuário em minutos |
Avg(input="column") |
Média de valores | Valor médio da transação |
Count(input="column") |
Número de registros | Número de logons por usuário |
Min(input="column") |
Valor mínimo | Menor freqüência cardíaca registrada por um dispositivo vestível |
Max(input="column") |
Valor máximo | Maior valor de transação por sessão |
StddevPop(input="column") |
Desvio padrão de população | Variabilidade diária do valor da transação em todos os clientes |
StddevSamp(input="column") |
Desvio padrão amostral | Variabilidade das taxas de clique da campanha publicitária |
VarPop(input="column") |
Variação da população | Distribuição de leituras de sensores para dispositivos IoT em uma fábrica |
VarSamp(input="column") |
Variância amostral | Distribuição de classificações de filmes em um grupo de exemplo |
ApproxCountDistinct(input="column", relativeSD=0.05) |
Contagem exclusiva aproximada | Contagem distinta de itens comprados |
ApproxPercentile(input="column", percentile=0.95, accuracy=100) |
Percentil aproximado | latência de resposta p95 |
First(input="column") |
Primeiro valor | Primeiro registro de data e hora de login |
Last(input="column") |
Último valor | Valor de compra mais recente |
FirstN(input="column", n=3) |
Primeiros n valores como um array |
Os três primeiros produtos vistos em uma sessão |
LastN(input="column", n=3) |
Últimos n valores como um array |
Três status mais recentes de casos de apoio |
FirstDistinct(input="column", n=3) |
Primeiro n , valores distintos como um array |
Primeiras três categorias de produtos distintas vistas |
LastDistinct(input="column", n=3) |
Últimos n valores distintos como um array |
Três categorias de comerciantes mais recentes e distintas |
Note
First, Last, FirstN, LastN, FirstDistinct, , e LastDistinct incluem valores nulos por padrão. Para ignorar nulos, adicione um filter_condition que exclua explicitamente as colunas de entrada que são nulas.
FirstN, LastN, , e LastDistinct use as timeseries_column características para ordenar linhas de entrada e retornar um array contendo até n valoresFirstDistinct. O n parâmetro deve ser um inteiro positivo.
FirstN e FirstDistinct selecione valores do mais antigo ao mais recente.
LastN e LastDistinct selecione valores do mais recente para o mais antigo, e então retorne os valores selecionados em ordem de carimbo de tempo.
FirstDistinct e LastDistinct remover valores duplicados ao selecionar valores nessa direção.
Por exemplo, se as linhas fonte de uma entidade forem ordenadas por event_time , ["A", "A", "B", "C", "B", "B"]as seguintes funções retornam:
| Função | Result |
|---|---|
FirstN(input="event_type", n=3) |
["A", "A", "B"] |
LastN(input="event_type", n=3) |
["C", "B", "B"] |
FirstDistinct(input="event_type", n=3) |
["A", "B", "C"] |
LastDistinct(input="event_type", n=3) |
["A", "C", "B"] |
FirstN, LastN, FirstDistinct, e LastDistinct requerem databricks-feature-engineering a versão 0.17.0 ou posterior.
CustomUDF
CustomUDFaplica uma função Python (UDF) registrada no Unity Catalog a cada linha. Use para transformar entradas de solicitações ou combinar valores de características. Ele não agrega linhas nem define uma janela de tempo.
CustomUDF(
    function_name="main.ecommerce.log_amount_udf",
    input_bindings={"amount": "transaction_amount"},
)
input_bindings mapeia o nome de cada parâmetro UDF para uma entrada. Para RequestSource, a entrada é o nome da coluna de origem. Para FeatureViewSource, é uma referência de recurso a montante. Vincule todos os parâmetros do UDF, incluindo parâmetros com os padrões padrão. Os tipos de entrada devem corresponder exatamente aos tipos de parâmetros UDF, sem casts numéricos implícitos. Use tipos escalares de entrada e retorno.
| Fonte | Behavior |
|---|---|
RequestSource |
Transforma colunas a partir do DataFrame de treinamento ou da solicitação de inferência. |
FeatureViewSource |
Combina valores de recursos a montante. Veja FeatureViewSource. |
Recursos respaldados CustomUDF por Delta não podem ser materializados ou servidos online. Para transformar valores de características respaldadas por tabela para treinamento e serviço, defina uma funcionalidade de agregação ou seleção de colunas apoiada em Delta e a referenciar por meio FeatureViewSourcede .
CustomUDF não é suportado por StreamSource. Para transformar a saída de um recurso de streaming, faça referência a esse recurso através FeatureViewSourcede .
CustomUDF com RequestSource requer databricks-feature-engineering a versão 0.17.0 ou posterior.
Para usar um CustomUDF, você precisa do EXECUTE privilégio no UDF, do USE CATALOG privilégio no catálogo pai e do USE SCHEMA privilégio no esquema pai.
O exemplo a seguir usa o NumPy para calcular log(1 + amount), reduzindo a escala de grandes quantidades de transações. Execute em computação serverless com dependências personalizadas de UDF ativadas. O main.ecommerce esquema deve existir.
spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.log_amount_udf(amount DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
ENVIRONMENT (
  dependencies = '["numpy==1.26.4"]',
  environment_version = '5'
)
AS $$
import numpy as np

if amount is None or not np.isfinite(amount) or amount < 0:
    return None
return float(np.log1p(amount))
$$
""")
Registre uma característica que vincule a coluna transaction_amount de solicitação ao parâmetro amountUDF :
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    CustomUDF, FieldDefinition, RequestSource, ScalarDataType,
)

fe = FeatureEngineeringClient()

log_transaction_amount = fe.create_feature(
    source=RequestSource(
        schema=[
            FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        ]
    ),
    function=CustomUDF(
        function_name="main.ecommerce.log_amount_udf",
        input_bindings={"amount": "transaction_amount"},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="log_transaction_amount",
)
O ENVIRONMENT UDF configura dependências para computação offline. Para atendimento online, também declare os pacotes em create_feature_spec(extra_pip_requirements=...) ou log_model(extra_pip_requirements=...). Eles não são copiados automaticamente da UDF.
Veja Dependências de Serviço de Características e Dependências de modelo.
CustomUDF as funcionalidades não podem ser implementadas. UDFs com suporte a pedidos e recursos funcionam sob demanda durante o treinamento e o serviço. Cada UDF em uma cadeia de dependências adiciona computação, então mantenha funções e cadeias pequenas. Os UDFs devem lidar com entradas ausentes, que podem ser None offline ou NaN online.
Para orientações sobre como lidar com valores ausentes, veja Como lidar com valores de recursos ausentes.
ColumnSelection (passagem)
ColumnSelection seleciona uma única coluna de uma origem sem aplicar nenhuma agregação. Ele é encapsulado diretamente no function parâmetro (não dentro AggregationFunction). O tipo de retorno é inferido do esquema de origem.
| Função | Description | Exemplo de caso de uso |
|---|---|---|
ColumnSelection("col") |
Valor mais recente de uma coluna (sem agregação) | Categoria de fornecedor mais recente, passagem de um campo de solicitação |
ColumnSelection Suporta as seguintes fontes de dados:
-
DeltaTableSource: retorna o valor mais recente por chave de entidade por meio de uma junção pontual (sem agregação de janela de lookback). -
StreamSource: Retorna o valor mais recente por chave de entidade do Stream (sem agregação de janela de retorno). -
RequestSource: passa pelo valor fornecido em tempo de inferência (ou extraído do DataFrame rotulado no tempo de treinamento).
Para um DeltaTableSource, ColumnSelection suporte filter_condition a características e transformation_sql, aplicado antes da seleção de valor mais recente, o mesmo que características de agregação.
from databricks.feature_engineering.entities import (
    ColumnSelection, DeltaTableSource, Feature, FieldDefinition,
    RequestSource, ScalarDataType,
)

delta_source = DeltaTableSource(
    catalog_name="main", schema_name="feature_store", table_name="transactions",
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="session_duration", data_type=ScalarDataType.DOUBLE),
    ]
)

# ColumnSelection from a Delta table
latest_amount = Feature(
    source=delta_source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    name="latest_transaction_amount",
)

# ColumnSelection from a RequestSource
session_feature = Feature(
    source=request_source,
    function=ColumnSelection("session_duration"),
    name="session_duration",
)
Exemplo: recursos de agregação e seleção de coluna
O exemplo a seguir mostra os recursos definidos na mesma fonte de dados.
from databricks.feature_engineering.entities import (
    AggregationFunction, Feature, Sum, Avg, ApproxCountDistinct,
    ColumnSelection, RollingWindow,
)
from datetime import timedelta

window = RollingWindow(window_duration=timedelta(days=7))

sum_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Sum(input="amount"), window),
)

avg_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Avg(input="amount"), window),
)

distinct_count = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(ApproxCountDistinct(input="product_id", relativeSD=0.01), window),
)

# Column selection (no aggregation, no time window)
latest_amount = Feature(
    source=source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="event_time",
    name="latest_amount",
)
Funções com condições de filtro
O filter_condition parâmetro permite filtrar linhas da tabela de origem antes de calcular agregações ou selecionar o valor da coluna mais recente. Isso funciona como uma cláusula SQL WHERE que é aplicada antes de agrupar e agregar dados.
Note
Para recursos de agregação, filter_condition filtra as linhas antes da agregação, como uma cláusula SQL WHERE aplicada antes GROUP BYde . Ele não altera a granularidade, que é sempre definida pela entity definição do recurso.
Os filtros são úteis ao trabalhar com tabelas de origem grandes que incluem um superconjunto de dados necessários para a computação de recursos e minimizar a necessidade de criar exibições separadas sobre essas tabelas.
from databricks.feature_engineering.entities import AggregationFunction, Sum, Count, RollingWindow, DeltaTableSource
from datetime import timedelta

# Source with filter applied at the source level
high_value_transactions = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="transactions",
    filter_condition="amount > 100",  # Only transactions over $100
)

high_value_sales = Feature(
    source=high_value_transactions,
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=30))),
)

# Multiple conditions
completed_orders_source = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="orders",
    filter_condition="status = 'completed' AND payment_method = 'credit_card'",
)

completed_orders = Feature(
    source=completed_orders_source,
    entity=["user_id"],
    timeseries_column="order_time",
    function=AggregationFunction(Count(input="order_id"), RollingWindow(window_duration=timedelta(days=7))),
)

# Filter on a StreamSource
from databricks.feature_engineering.entities import StreamSource

purchase_stream = StreamSource(
    full_name="main.ecommerce.transactions_stream",
    filter_condition="value.event_type = 'purchase'",
)

purchase_total = Feature(
    source=purchase_stream,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(Sum(input="value.amount"), RollingWindow(window_duration=timedelta(hours=1))),
)
Fontes de dados
DeltaTableSource
DeltaTableSource é um objeto Python efêmero usado para definir como os recursos são computados de uma tabela de origem. Ele não cria uma nova tabela. Ele especifica a configuração para ler dados e agregar recursos.
DeltaTableSource(
    catalog_name: str,                              # Required: Catalog name
    schema_name: str,                               # Required: Schema name
    table_name: str,                                # Required: Table name
    filter_condition: Optional[str] = None,         # Optional: SQL WHERE clause to filter source data
    transformation_sql: Optional[str] = None,       # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,         # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,       # Optional: Expected source settling time
)
Parâmetros:
-
catalog_name,schema_name,table_name: identifique a tabela Delta de origem no Catálogo do Unity. -
filter_condition: Uma cláusula SQLWHEREaplicada antes da agregação ou seleção de colunas. Exemplo:"status = 'completed'". -
transformation_sql: uma expressão SQLSELECTaplicada à tabela de origem. Use isso para renomear colunas, tipos de cast ou calcular colunas derivadas antes da agregação ou seleção de colunas. Se omitido, todas as colunas serão selecionadas (*). Exemplo:"user_id, CAST(amount AS DOUBLE) AS amount, event_time". -
dataframe_schema: o esquema do DataFrame resultante após transformações, no formato JSON do Spark StructType (dedf.schema.json()). Necessário setransformation_sqlfor fornecido. Isso informa ao sistema os nomes e tipos de coluna resultantes da transformação. -
lateness: UmSourceLatenessobjeto que descreve quanto tempo a fonte normalmente leva para se tornar completa em tempo de evento. Se omitida, a fonte é considerada completa imediatamente.
Quando ambos filter_conditiontransformation_sql e são definidos, a consulta resultante é: SELECT {transformation_sql} FROM {table} WHERE {filter_condition}.
SourceLateness.settling_delay é a forma recomendada de simular durante o treinamento um atraso consistente de ETL que afeta a materialização online. O Azure Databricks desloca o tempo de avaliação de treinamento elegível para trás nesse período, de modo que um exemplo de treinamento não use dados que ainda estariam em trânsito online. Durante a materialização, o Azure Databricks espera pelo mesmo período antes de publicar uma janela concluída e serve à última janela concluída durante o período intermediário.
Por exemplo, suponha que um trabalho diário de ETL seja concluído 8 horas após a meia-noite em um fuso horário local onde a meia-noite corresponde às 07:00 UTC. Use um atraso de assentamento de 8 horas e um desfasamento de janela de 7 horas:
from datetime import timedelta
from databricks.feature_engineering.entities import (
    DeltaTableSource,
    SourceLateness,
    TumblingWindow,
)

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    lateness=SourceLateness(settling_delay=timedelta(hours=8)),
)

window = TumblingWindow(
    window_duration=timedelta(days=1),
    offset=timedelta(hours=7),
)
Note
O timeseries_column deve ser do tipo TimestampType ou TimestampNTZType.
DateType não é suportado para séries temporais; conjure a coluna para TimestampType first (por exemplo, com transformation_sql).
Exemplo: Usar transformation_sql para transformações de coluna
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="raw_events",
    transformation_sql="user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time",
    filter_condition="event_type = 'purchase'",
    dataframe_schema=spark.sql(
        "SELECT user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time FROM main.analytics.raw_events LIMIT 0"
    ).schema.json(),
)
Exemplo: Derivando transformation_sql e dataframe_schema de um DataFrame do PySpark
Você pode escrever sua transformação como uma consulta PySpark e, em seguida, extrair o esquema do DataFrame resultante:
df = spark.sql(f"""
  SELECT user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time
  FROM main.analytics.events
  WHERE event_date >= date_sub(current_date(), 7)
  LIMIT 0
""")

# Use df.schema.json() as the dataframe_schema
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    transformation_sql="user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time",
    filter_condition="event_date >= date_sub(current_date(), 7)",
    dataframe_schema=df.schema.json(),
)
Expressões suportadas transformation_sql
As mesmas regras se aplicam a transformation_sql em DeltaTableSource e StreamSource.
transformation_sql suporta quaisquer expressões por linhas; operações avaliadas independentemente para cada linha. Eles não alteram o número de linhas nem a correspondência um a um com a fonte. Expressões por linha incluem renomeação de colunas, casts, operações aritméticas e mais.
Operações que alteram a forma ou a contagem de linhas não são suportadas, como agregações como SUM() ou COUNT(). Em vez disso, use AggregationFunction a definição de recurso.
DeltaTableSource.from_sql()
Como uma conveniência, você pode criar uma DeltaTableSource consulta SQL. O método analisa a consulta para extrair automaticamente o nome transformation_sqlda tabela e filter_condition.
DeltaTableSource.from_sql(
    sql: str,                           # Required: SQL SELECT query
    spark: SparkSession,                # Required: active SparkSession (for schema inference)
) -> DeltaTableSource
Há suporte apenas para consultas simples SELECT ... FROM ... [WHERE ...] . O SQL complexo (JOINs, subconsultas, CTEs, UNIONs) é rejeitado. Para consultas complexas, construa DeltaTableSource diretamente com transformation_sql e filter_condition.
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    Sum,
    TumblingWindow,
)

source = DeltaTableSource.from_sql(
    spark=spark,
    sql=f"SELECT customer_id, event_ts, amount * 2 AS doubled_amount, amount FROM {CATALOG}.{SCHEMA}.{TABLE}",
)

feature = Feature(
    source=source,
    function=AggregationFunction(Sum(input="doubled_amount"), time_window=TumblingWindow(window_duration=timedelta(days=7))),
    entity=["customer_id"], timeseries_column="event_ts",
)
Iterar com to_dataframe()
Use source.to_dataframe() para visualizar os dados que serão usados para computação de recursos. Isso é útil para iterar e filter_conditiontransformation_sql até que eles produzam os resultados esperados.
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    filter_condition="event_type = 'purchase'",
)

# Preview the filtered source data
source.to_dataframe().display()
Noções básicas sobre entidades
As colunas de entidade definem o nível de agregação para seus recursos. Eles são especificados na Feature definição, não em DeltaTableSource. As entidades determinam:
-
Como os dados são agrupados: os recursos são agregados por combinação exclusiva de valores de entidade (semelhante ao
GROUP BYSQL) - A estrutura de chave primária: cada combinação de entidade exclusiva resulta em uma linha de recursos computados
Exemplo: recursos no nível do cliente
O código a seguir agrega recursos no nível do cliente (uma linha por cliente):
from databricks.feature_engineering.entities import DeltaTableSource

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="user_events",
)

Feature(
    source=source,
    entity=["user_id"],                # Features aggregated per user
    timeseries_column="event_time",    # Timestamp for time windows
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Exemplo: recursos no nível da Loja do Cliente
Para agregar recursos em um nível mais detalhado (uma linha por combinação de repositório de clientes), use várias colunas de entidade:
source = DeltaTableSource(
    catalog_name="main",
    schema_name="retail",
    table_name="transactions",
)

Feature(
    source=source,
    entity=["user_id", "store_id"],  # Features aggregated per user-store pair
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Quando você precisar de recursos em diferentes níveis de agregação (por exemplo, no nível do cliente e no nível do repositório do cliente), use valores diferentes entity em suas definições de recurso. O mesmo DeltaTableSource pode ser compartilhado entre recursos com diferentes configurações de entidade.
StreamSource
StreamSource faz referência a um Stream. O Stream contém conexão, autenticação, esquema e configuração de ingestão para a fonte de streaming. Para o Kafka, as referências de coluna em definições de recurso devem ser prefixadas ou value.key. indicar qual parte da mensagem deve ser lida.
StreamSource(
    full_name: str,                       # Required: Three-part Stream name (catalog.schema.stream)
    filter_condition: Optional[str] = None,      # Optional: SQL WHERE clause applied before aggregation
    transformation_sql: Optional[str] = None,    # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,      # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,    # Optional: Expected source settling time
)
Parâmetros:
-
full_name: o nome completo de três partes de um Stream (por exemplo,"my_catalog.my_schema.my_stream"). -
filter_condition(opcional): uma cláusula SQLWHEREaplicada a dados de fluxo antes da agregação, usando referências de coluna prefixada por ponto (por exemplo,"value.event_type = 'purchase'"). -
transformation_sql(opcional): Uma expressão SQLSELECTaplicada antes da agregação ou seleção de colunas, usando referências com prefixo de pontos para askeyestruturas e.valueSuporta as mesmas expressões por linhas queDeltaTableSource. Se omitido, a fonte usa todas as colunas (*). -
dataframe_schema: O esquema JSON SparkStructTypeda saída projetada. Obrigatório se você definirtransformation_sql. -
lateness: UmSourceLatenessobjeto que descreve quanto tempo o fluxo normalmente leva para se completar em tempo de evento. ConsulteSourceLateness.settling_delay.
from databricks.feature_engineering.entities import StreamSource

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    filter_condition="value.event_type = 'purchase'",
)
Derive dataframe_schema rodando a projeção contra a tabela de ingestão do Stream, que expõe as key estruturas e value .
transformation_sql = (
    "value.amount * value.conversion_rate AS converted_amount, "
    "struct(value.user_id AS user_id, value.event_time AS time) AS event"
)

ingestion_table = "my_catalog.my_schema.events_ingestion"
dataframe_schema = spark.sql(
    f"SELECT {transformation_sql} FROM {ingestion_table} LIMIT 0"
).schema.json()

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    transformation_sql=transformation_sql,
    dataframe_schema=dataframe_schema,
)
RequestSource
RequestSource define um esquema para dados fornecidos em tempo de inferência no conteúdo da solicitação em vez de pesquisados de uma tabela pré-materializada. Durante o treinamento, essas colunas são extraídas do DataFrame rotulado passado para create_training_set. Durante o serviço de modelo, o chamador deve incluí-los no conteúdo da solicitação HTTP.
RequestSource pode ser usado com funções CustomUDF ou ColumnSelection Feature View. Ele não dá suporte a funções de agregação ou janelas de tempo.
Definindo o esquema
Defina o esquema como uma lista de FieldDefinition objetos, cada um especificando um nome de coluna e um ScalarDataType:
from databricks.feature_engineering.entities import (
    FieldDefinition, RequestSource, ScalarDataType,
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        FieldDefinition(name="vendor_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_time", data_type=ScalarDataType.DATE),
    ]
)
Tipos de dados com suporte
RequestSourcedá suporte aos tipos escalares definidos emScalarDataType: INTEGER, , FLOAT, BOOLEAN, STRING, DOUBLE, , LONG, TIMESTAMP, , DATE, . SHORT Não há suporte para tipos complexos, como matrizes, mapas e structs.
Como os dados de solicitação são hidratados
| Contexto | Behavior |
|---|---|
Treinamento (create_training_set) |
As colunas são extraídas do DataFrame rotulado. Os tipos são validados em relação ao esquema declarado. Incompatibilidades geram um erro (sem conversão implícita). |
| Servindo (ponto de extremidade de modelo) | As colunas são extraídas ou dataframe_recordsdataframe_split na solicitação HTTP. Os valores JSON são convertidos nos tipos declarados (por exemplo, número JSON → DOUBLE). |
Assinatura de modelo
Quando um modelo é registrado usando log_model um conjunto de treinamento que inclui RequestSource recursos, as RequestSource colunas são adicionadas à assinatura do modelo do MLflow como entradas necessárias. Isso significa que o esquema de API do ponto de extremidade de serviço reflete quais campos os chamadores devem fornecer em tempo de inferência.
FeatureViewSource
FeatureViewSource usa as saídas de outras Visualizações de Características como entradas para um CustomUDF. Encadear características cria um grafo direcionado acíclico (DAG). Por exemplo, uma funcionalidade de margem pode combinar agregados de receita e custos, e outra funcionalidade pode transformar a margem.
Use databricks-feature-engineering a versão 0.18.0 ou posterior para FeatureViewSource.
Passe uma lista de Feature objetos para features, não as strings de nome de características. Recuperar características registradas com get_feature. Em input_bindings, use o full_name. Para um recurso local e não registrado, use o seu name em vez disso.
O exemplo a seguir assume duas características registradas, revenue_sum_7d e cost_sum_7d, que retornam DOUBLE valores por customer_id e usam event_time para computação em um ponto no tempo:
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import CustomUDF, FeatureViewSource

fe = FeatureEngineeringClient()
revenue = fe.get_feature(full_name="main.ecommerce.revenue_sum_7d")
cost = fe.get_feature(full_name="main.ecommerce.cost_sum_7d")

spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.margin_udf(revenue DOUBLE, cost DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
import math

if revenue is None or cost is None:
    return None
if not math.isfinite(revenue) or not math.isfinite(cost) or revenue <= 0:
    return None
return (revenue - cost) / revenue
$$
""")

margin = fe.create_feature(
    source=FeatureViewSource(features=[revenue, cost]),
    function=CustomUDF(
        function_name="main.ecommerce.margin_udf",
        input_bindings={"revenue": revenue.full_name, "cost": cost.full_name},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="margin",
)
As restrições a seguir se aplicam:
- Apenas
CustomUDFé suportado como função. Recursos a montante podem ser agregações, seleções de colunas ou outrosCustomUDFrecursos. - Omita
entityetimeseries_columnna característica derivada. Cada recurso a montante mantém sua própria entidade, carimbo de tempo e definição de janela. - Um recurso tem uma única fonte. Para combinar um valor de requisição com uma característica de tabela de dados, defina uma
RequestSourcecaracterística e referencia-a ambos por meio deFeatureViewSource. - Cada recurso declarado a montante deve ser usado em
input_bindings. Bicicletas não são permitidas. - Registre as características a montante antes de registrar a característica derivada. Grafos locais e não registrados podem ser usados com
create_training_setpara experimentação. - Para treinamento ou serviço, você precisa do privilégio
READ FEATUREouMANAGEsobre a característica derivada e suas características transitivas a montante. Use nomes distintos de recursos ao longo do gráfico para registro e serviço, até mesmo entre catálogos ou esquemas. - Um recurso pode referenciar até 20 recursos diretos a montante. Grafos registrados suportam uma profundidade máxima de cinco características ao longo de um caminho de dependência, incluindo a característica base.
-
FeatureViewSourceAs características não podem ser materializadas ou avaliadas comcompute_features. Usecreate_training_setpara avaliá-los offline. Para o serviço online, materialize os recursos suportados com suporte a tabela upstream.
Para avaliação de dependências e seleção de saída, veja Treinar com recursos FeatureViewSource. Para implantação, veja recursos derivados do Serve.
API de treinamento e inferência
create_training_set e score_batch compute valores de recurso corretos pontuais sob demanda dos dados de origem. Para recursos que dão suporte à materialização offline, como agregações de janela deslizante em fontes de tabela delta, materializar recursos primeiro para um repositório offline melhora o desempenho de ambas as operações. Quando os recursos offline materializados estão disponíveis, as operações leem dados offline pré-compilados em vez de recomputar valores de recursos da origem. Consulte Materializar exibições de recursos para materializar recursos em um repositório offline.
create_training_set()
Cria um conjunto de dados de treinamento com computação de recurso correta pontual. Para obter detalhes, consulte Treinar modelos com exibições de recursos.
FeatureEngineeringClient.create_training_set(
    df: DataFrame,                                # DataFrame with training data
    features: Optional[List[Feature]],            # List of Feature objects
    label: Union[str, List[str], None],           # Label column name(s)
    exclude_columns: Optional[List[str]] = None,  # Optional: columns to exclude
) -> TrainingSet
log_model()
Registra um modelo com metadados de recurso para acompanhamento de linhagem e pesquisa automática de recursos durante a inferência. Para obter detalhes, consulte Treinar modelos com exibições de recursos.
FeatureEngineeringClient.log_model(
    model,                                    # Trained model object
    artifact_path: str,                       # Path to store model artifact
    flavor: ModuleType,                       # MLflow flavor module (e.g., mlflow.sklearn)
    training_set: TrainingSet,                # TrainingSet used for training
    registered_model_name: Optional[str],     # Optional: register model in Unity Catalog
)
score_batch()
Executa a inferência do lote offline com pesquisa automática de recursos. Usa os metadados de recurso armazenados com o modelo para computar recursos corretos pontuais, garantindo consistência com o treinamento.
FeatureEngineeringClient.score_batch(
    model_uri: str,                           # URI of logged model (e.g., "models:/catalog.schema.model/1")
    df: DataFrame,                            # DataFrame with entity keys and timestamps
) -> DataFrame
O DataFrame de entrada deve conter as colunas de entidade e de timeseries usadas durante o treinamento. Os recursos são calculados automaticamente a partir dos dados de origem.
fe = FeatureEngineeringClient()

# Batch scoring with automatic feature lookup
predictions = fe.score_batch(
    model_uri="models:/main.ecommerce.fraud_model/1",
    df=inference_df,
)
predictions.display()
Janelas de horas
As Vistas de Características suportam quatro tipos de janelas para controlar o comportamento de lookback para agregações baseadas em janelas temporais. Os tipos de janelas disponíveis dependem da fonte do recurso: recursos de fonte de streaming podem usar janelas rolantes e dentes de serra, e recursos de fonte em lote podem usar janelas rolantes, de rebolo e deslizantes.
- Janelas sem interrupção olham para trás a partir da hora do evento. Duração e atraso são definidos explicitamente.
- Janelas deslizantes são janelas de tempo fixas e não sobrepostas. Cada ponto de dados pertence a exatamente uma janela.
- Janelas deslizantes são janelas de tempo sobrepostas e contínuas, com um intervalo de deslizamento configurável.
- Janelas Sawtooth mantêm uma janela longa de retrospetiva fresca sobre uma fonte de streaming usando um caminho híbrido de lote e streaming. Veja a janela Sawtooth.
A ilustração a seguir mostra os tipos de janelas de rolamento, deslizamento, rolamento e dentes de serra.

Temporização da janela de tempo
Use delay para avaliar uma janela em um ponto analítico anterior. Por exemplo, uma janela de 30 dias com atraso de 7 dias calcula um valor de 30 dias a partir de uma semana antes do momento da avaliação.
delay é independente do horário de chegada da fonte. Para modelar o tempo que os dados de origem levam para chegar, configure SourceLateness.settling_delay em vez disso.
Quando ambos os cenários estão presentes, eles compõem. O Azure Databricks trata a janela como completa após o atraso de detonação de origem e a avalia usando o atraso analítico.
Use offset para alterar o alinhamento dos limites fixos das janelas. Por padrão, janelas de rebolo e janelas deslizantes estão alinhadas à meia-noite UTC. Por exemplo, um deslocamento de 22 horas alinha uma fronteira diária com 22:00 UTC. Para aproximar limites em um fuso horário local, configure um deslocamento estático em relação ao UTC. O deslocamento não ajusta para o horário de verão, não desloca o tempo de avaliação nem modela dados que chegam tarde.
A tabela a seguir resume o suporte para esses campos:
| Campo | Janelas suportadas | Constraint |
|---|---|---|
delay |
Rolando, rolando e deslizando | Deve ser um não-negativo datetime.timedelta |
offset |
Rolamentos e deslizamentos | Deve ser não negativo e mais curto que o período* |
SourceLateness.settling_delay |
Características de rolamento, rolamento e deslizamento | Deve ser um não-negativo datetime.timedelta |
start_time |
Rolando, rolando e deslizando | Deve ser um datetime.datetime |
*Ponto: Para uma janela de deslocamento, o deslocamento deve ser menor que window_duration. Para uma janela deslizante, ela deve ser menor que slide_duration.
Hora de início
Use start_time para definir a fronteira de tempo de evento mais antiga no UTC na qual uma funcionalidade pode emitir uma saída. A fronteira é inclusiva.
start_time Saídas de gates. Ela não restringe as linhas de fonte históricas que uma janela pode ler, nem altera o alinhamento da janela. Se start_time cair entre dois limites alinhados, a primeira saída elegível de janela fixa é a próxima fronteira.
Com start_time, janelas de duração fixa podem emitir antes que a duração completa da janela tenha se escorrido na fonte. Essas primeiras saídas usam qualquer histórico de fontes disponível. Por exemplo, considere uma janela deslizante com um ano window_duration e um slide_durationdia , sobre uma fonte cujos dados começam em 1º de janeiro de 2024:
- Sem
start_time, a funcionalidade será lançada pela primeira vez em 1º de janeiro de 2025, uma vez que uma janela completa de um ano puder ser formada. - Com o lançamento
start_timeprevisto para 21 de agosto de 2024, o longa será lançado pela primeira vez em 21 de agosto de 2024. Esse resultado cobre apenas o histórico de fontes disponível até agora, desde 1º de janeiro de 2024. A janela atinge seu período completo de um ano em 1º de janeiro de 2025 e gera resultados completos a partir de então.
Como start_time não altera o alinhamento da janela, um valor entre dois limites alinhados não cria um novo limite. Para uma janela oscilante com limites diários à meia-noite UTC, a start_time das 06:00 UTC emite primeiro na próxima fronteira da meia-noite. Um start_time que pousa exatamente em uma fronteira emite nessa fronteira, porque a fronteira é inclusiva.
Se start_time não estiver definido, janelas rolantes e janelas deslizantes de duração fixa emitem primeiro em uma fronteira alinhada após a formação de uma janela completa. Janelas deslizantes e janelas móveis ao longo da vida emitem assim que existem dados de fonte elegíveis.
Note
start_time é suportado para recursos lotados que usam DeltaTableSource com janelas rolantes, de rolamento ou deslizantes. Não é suportado por StreamSource ou SawtoothWindow.
Por exemplo:
from datetime import datetime, timedelta
from databricks.feature_engineering.entities import SlidingWindow

window = SlidingWindow(
    window_duration=timedelta(days=365),
    slide_duration=timedelta(days=1),
    start_time=datetime(2024, 8, 21),
)
Janela de rodar
Note
RollingWindow foi nomeado ContinuousWindowanteriormente. Se você estiver migrando de uma versão anterior do SDK, atualize suas importações de acordo.
Janelas sem interrupção são up-toagregações de data e tempo real, normalmente usadas em dados de streaming. Em pipelines de streaming, a janela sem interrupção emite uma nova linha somente quando o conteúdo da janela de comprimento fixo é alterado, como quando um evento entra ou sai. Quando um recurso de janela sem interrupção é usado em pipelines de treinamento, um cálculo preciso de recurso pontual é executado nos dados de origem usando a duração da janela de comprimento fixo imediatamente anterior ao carimbo de data/hora de um evento específico. Isso ajuda a evitar distorção ou vazamento de dados online offline. Recursos no tempo T agregam eventos de [T – duração, T).
class RollingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
A tabela a seguir lista os parâmetros de uma janela sem interrupção. Os horários de início e término da janela são baseados nesses parâmetros da seguinte maneira:
- Hora de início:
evaluation_time - window_duration - delay(inclusive) - Hora de término:
evaluation_time - delay(exclusivo)
| Parâmetro | Constraints |
|---|---|
delay (opcional) |
Deve ser ≥ 0. Desloca a janela analítica para trás a partir do carimbo temporal da avaliação. Use SourceLateness.settling_delay para modelar uma linha de base consistente para o atraso de chegada da fonte no seu fluxo. |
window_duration |
Deve ser > 0 |
start_time (opcional) |
Limite de tempo de evento mais antigo na qual a característica pode emitir uma saída. |
from databricks.feature_engineering.entities import RollingWindow
from datetime import timedelta

# Look back 7 days from evaluation time
window = RollingWindow(window_duration=timedelta(days=7))
Defina uma janela sem interrupção com atraso usando o código abaixo.
# Compute a 7-day value as of one day before the evaluation time
window = RollingWindow(
    window_duration=timedelta(days=7),
    delay=timedelta(days=1)
)
Exemplos de janela sem interrupção
window_duration=timedelta(days=7): cria-se uma janela de retrospetiva de 7 dias, que termina no momento da avaliação atual. Para um evento agendado para as 14:00 do dia 7, isso inclui todos os eventos que ocorreram desde as 14:00 do dia 0 até (mas não incluindo) as 14:00 do dia 7.window_duration=timedelta(hours=1), delay=timedelta(minutes=30): Isso estabelece uma janela de retrospectiva de 1 hora que termina 30 minutos antes do tempo de avaliação. Para um evento às 15h, isso inclui todos os eventos das 13h30 até (mas não incluindo) 14h30.
Use Last para limitar a frescura de um valor recente
Combine Last com RollingWindow quando um valor mais recente é válido apenas por um tempo limitado. Em um momento de avaliação, o recurso retorna o valor da linha com o carimbo de tempo mais recente nesse intervalo:
[evaluation_time - delay - window_duration, evaluation_time - delay)
Se a última linha do intervalo contiver um valor nulo, a característica retorna nula. Se quiser excluir valores de entrada nulos, defina a filter_condition na fonte.
Essa combinação difere de ColumnSelection.
ColumnSelection retorna o valor não nulo mais recente observado sem expirá-lo com base na idade.
Para recursos em lote, essa combinação possui um modo especial de materialização exclusivamente online. Ele suporta apenas DeltaTableSource, Last, RollingWindow, e TableTrigger. Veja Materialize valores mais recentes limitados à frescura.
Janela Deslizante
Para recursos definidos usando janelas de salto, as agregações são computadas em uma janela de comprimento fixo predeterminada que avança por um intervalo de deslizamento, produzindo janelas não sobrepostas que fazem o particionamento completo do tempo. Como resultado, cada evento na origem contribui para exatamente uma janela. Os recursos no momento t agregam dados de janelas que terminam em ou antes t (exclusivo). O Windows começa na época do Unix.
class TumblingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
A tabela a seguir lista os parâmetros de uma janela em cascata.
| Parâmetro | Constraints |
|---|---|
window_duration |
Deve ser > 0 |
delay (opcional) |
Deve ser ≥ 0. Desloca a janela analítica para trás a partir do carimbo temporal da avaliação. |
offset (opcional) |
Deve ser ≥ 0 e menor que window_duration. Desloca os limites das janelas a partir da meia-noite UTC. |
start_time (opcional) |
Limite de tempo de evento mais antigo na qual a característica pode emitir uma saída. |
from databricks.feature_engineering.entities import TumblingWindow
from datetime import timedelta

window = TumblingWindow(
    window_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Exemplo de janela em cascata
-
window_duration=timedelta(days=5): isso cria janelas de comprimento fixo predeterminadas de 5 dias cada. Exemplo: a janela nº 1 abrange o dia 0 até o dia 4, a janela nº 2 abrange o dia 5 ao dia 9, a janela nº 3 abrange o dia 10 até o dia 14 e assim por diante. Especificamente, a Janela nº 1 inclui todos os eventos com carimbos de data/hora que começam no00:00:00.00do dia 0 até (mas não incluindo) qualquer evento com carimbo de data/hora00:00:00.00no dia 5. Cada evento pertence a exatamente uma janela.
Janela Deslizante
Para características definidas usando janelas deslizantes, agregações são calculadas sobre uma janela que avança em um intervalo de deslizamento. Uma janela deslizante pode ter duração fixa ou duração de vida útil. Janelas de duração fixa se sobrepõem, então cada evento fonte pode contribuir para a agregação de recursos para múltiplas janelas. Uma janela de vida inclui todos os eventos de origem antes do fim da janela. Os recursos no momento t agregam dados de janelas que terminam em ou antes t (exclusivo). O Windows está alinhado à época Unix.
class SlidingWindow(TimeWindow):
    window_duration: Optional[datetime.timedelta]
    slide_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
A tabela a seguir lista os parâmetros de uma janela deslizante.
| Parâmetro | Constraints |
|---|---|
window_duration |
Deve ser positivo para uma janela de duração fixa. Configurado para None uma janela vitalícia. |
slide_duration |
Deve ser positivo. Para uma janela de duração fixa, ela também deve ser menor que window_duration. |
delay (opcional) |
Deve ser ≥ 0. Desloca a janela analítica para trás a partir do carimbo temporal da avaliação. |
offset (opcional) |
Deve ser ≥ 0 e menor que slide_duration. Desloca os limites das janelas a partir da meia-noite UTC. |
start_time (opcional) |
Limite de tempo de evento mais antigo na qual a característica pode emitir uma saída. |
from databricks.feature_engineering.entities import SlidingWindow
from datetime import timedelta

window = SlidingWindow(
    window_duration=timedelta(days=7),
    slide_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Exemplo de janela deslizante
-
window_duration=timedelta(days=5), slide_duration=timedelta(days=1): isso cria janelas de cinco dias sobrepostas que avançam 1 dia cada vez. Exemplo: a janela nº 1 abrange o dia 0 ao dia 4, a janela nº 2 abrange o dia 1 ao 5º dia, a janela nº 3 abrange o dia 2 até o dia 6 e assim por diante. Cada janela inclui eventos do00:00:00.00dia inicial até (mas sem incluir)00:00:00.00no dia final. Como as janelas se sobrepõem, um único evento pode pertencer a várias janelas (neste exemplo, cada evento pertence a até cinco janelas diferentes).
Janela vitalícia
Defina window_duration=None para criar uma janela vitalícia. Em cada limite de slide, a característica agrega todos os eventos de origem da entidade com carimbos de tempo anteriores a essa fronteira. Por exemplo, um slide de um dia produz um valor acumulado uma vez por dia.
Janelas de vida são suportadas apenas por SlidingWindow.
RollingWindow e TumblingWindow requerem um finito window_duration.
Note
As janelas vitalícias exigem uma databricks-feature-engineering versão cliente que suporte window_duration=None habilitação do workspace. Versões anteriores do cliente não suportam essa sintaxe.
from datetime import timedelta
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    SlidingWindow,
    Sum,
)

lifetime_spend = Feature(
    source=DeltaTableSource(
        catalog_name="main",
        schema_name="store",
        table_name="transactions",
    ),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(
        Sum(input="amount"),
        SlidingWindow(
            window_duration=None,
            slide_duration=timedelta(days=1),
        ),
    ),
    name="lifetime_spend",
)
Janela dente-de-serra
Importante
SawtoothWindow está em Beta.
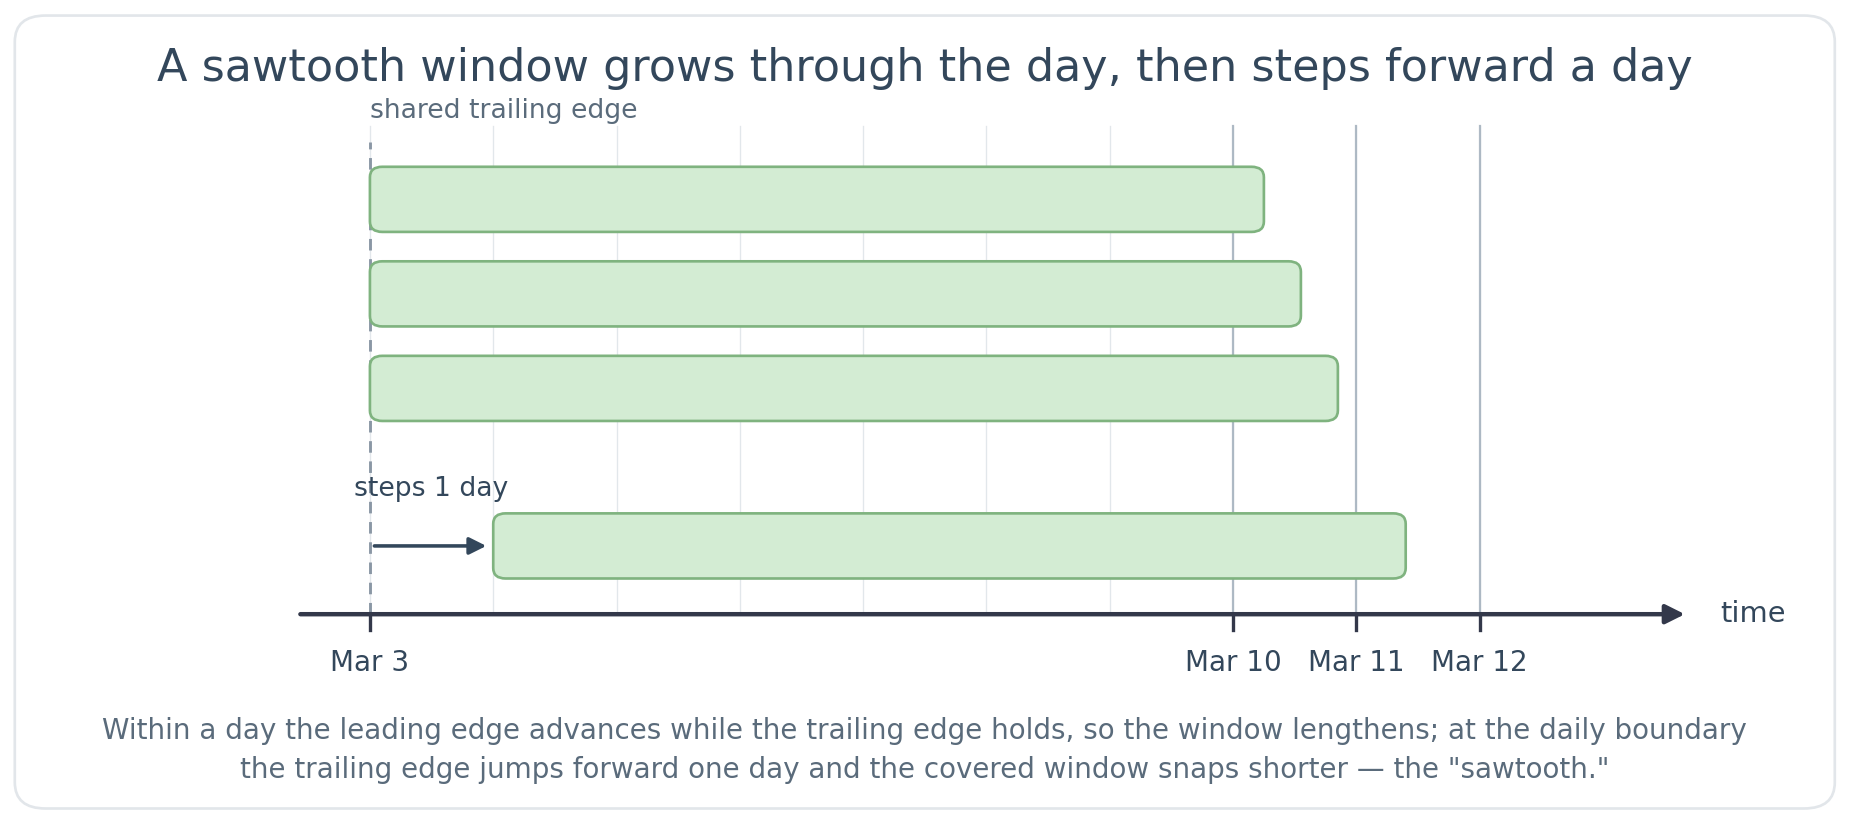
Uma janela dente de serra é uma agregação que suporta atualizações altamente recentes para eventos recentes, juntamente com compactação diária de dados históricos. Sua borda de fuga (mais antiga) avança em passos fixos e diários, enquanto a borda dianteira (recente) permanece atualizada com os eventos mais recentes, então o comprimento efetivo da janela "serra" ao longo de cada dia. A maior parte da janela é servida a partir dos dados na tabela de ingestão do Stream, e apenas os dois dias mais recentes vêm da transmissão ao vivo. Esse é um compromisso que calcula janelas de longa duração de forma eficiente (escalando para anos) enquanto permanece responsivo a atualizações recentes.
Janelas dentes de serra são materializadas em um caminho híbrido de lote e fluxo. Um pipeline batch mantém a maior parte da janela, enquanto um pipeline de streaming mantém os dados mais recentes frescos em tempo real. Os dois são fundidos na leitura, então para o modelo ou consumidor que atende é um recurso único.
Como a parte histórica da janela é calculada pelo duto em lote, uma característica dente de serra está pronta para servir logo após o início da materialização, mesmo quando a janela abrange meses ou anos. Uma janela rolante só é concluída após o término da duração total da janela. O mínimo window_duration deve ser maior que dois dias (o limite inferior imposto). A Databricks recomenda uma janela de serra para durações superiores a 7 dias. Para janelas com mais de dois dias e até sete dias, escolha entre a precisão de comprimento fixo de uma janela de rodagem e a prontidão de produção mais rápida de uma janela de dente de serra.
Note
Uma característica dente-serra depende da história que já está presente. A tabela de ingestão do Stream deve conter dados que cobrem pelo menos toda a duração da janela, ou a janela computada fica incompleta. Antes que 2 dias completos se decorram, o recurso reflete apenas os dados materializados até então. Não é recomendado oferecer o longa em produção até que tenham se passado 2 dias completos. Uma agregação sobre uma janela vazia retorna 0 para Sum e , e nulo para Avg, Min, Max, FirstLast, VarPop, VarSamp, , StddevPop, e StddevSampCount.
Para saber se uma funcionalidade dente de serra está pronta, abra a Visualização de Recursos no Explorador de Catálogo. Na seção de recursos materializados, o lote de preenchimento é concluído assim que o último tempo de materialização do recurso avança e seu status mostra sucesso. A parte de fluxo é materializada por um gasoduto declarativo Lakeflow. Após a Feature View passar pela validação, a funcionalidade materializada se conecta a esse pipeline, onde você pode monitorar seu status de execução.
Janelas dente de serra requerem um StreamSource e são materializadas com StreamingMode.
class SawtoothWindow(TimeWindow):
    window_duration: datetime.timedelta
As bordas de uma janela dente de serra se movem de forma diferente das de uma janela rolante: a borda de ataque acompanha o evento mais recente, enquanto a borda de fuga avança uma vez por dia em vez de continuamente. Todos os dias, com um limite fixo às 18:00 UTC, a borda de fuga avança até o limite UTC-meia-noite daquele dia. Como resultado, a janela efetiva é um pouco maior que window_duration a do que e cresce ao longo do dia antes de voltar um dia no corte seguinte. Treinamento e serviço usam o mesmo limite às 18:00 UTC, então treinamento offline e serviço online permanecem consistentes.
| Parâmetro | Constraints |
|---|---|
window_duration |
Deve ser mais de dois dias. Uma duração que não seja um número inteiro de dias (por exemplo, timedelta(days=3, minutes=15)) é permitida, mas a janela ainda é atualizada com granularidade diária. |
Janelas de dente de serra suportam as Sumfunções de agregação , Avg, Count, Min, StddevSampVarPopMaxLastVarSampFirstStddevPope agregação.
Exemplo da janela dente-de-serra
O exemplo a seguir mostra uma contagem de 7 dias das transações de um usuário. A borda de ataque acompanha o evento atual enquanto a borda de fuga avança um dia de cada vez. Para eventos em 10 de março, o intervalo remonta a cerca de 3 de março. À medida que o dia 10 de março avança, a borda de ataque continua avançando enquanto a borda de fuga segura, então o vão coberto aumenta. Então, no início de 11 de março, a borda de fuga avança para cerca de 4 de março. A janela efetiva é sempre um pouco maior que sete dias. Os dois dias mais recentes são servidos pela transmissão ao vivo, e os dias mais antigos são servidos pela tabela de ingestão da Stream.
from databricks.feature_engineering.entities import SawtoothWindow
from datetime import timedelta

# 7-day window kept continuously fresh with streaming data
window = SawtoothWindow(window_duration=timedelta(days=7))
Limitações da janela dente de serra
- Não
delayhá suporte para o parâmetro. - Não há suporte para
SourceLateness.settling_delay. - Funções de agregação diferentes de
Sum,Avg,Count,Min,Max,LastFirst,StddevPopVarSampVarPop, , eStddevSampnão são suportadas (por exemplo,ApproxCountDistinct,ApproxPercentile,FirstN,LastN,FirstDistinct, , e ).LastDistinct - Janelas dentes de serra exigem um
StreamSource. ADeltaTableSourcenão é suportado.
Gatilhos de materialização
Dispara o controle quando um pipeline de materialização é executado. O tipo de gatilho depende do tipo de recurso.
CronSchedule
Use CronSchedule para recursos de agregação em lote. Por padrão, o Azure Databricks deriva um cronograma a partir da janela de agregação. Um cronograma derivado considera o período da janela, delay janela e offset, e fonte settling_delay , de modo que uma execução não publique uma janela antes que seus dados fonte sejam esperados para serem concluídos. Os horários derivados suportam janelas de tumbling e deslizamento.
Para solicitar um cronograma derivado, omita a expressão cron.
CronSchedule() e a forma explícita CronSchedule(mode=CronScheduleMode.DERIVED) são equivalentes:
from databricks.feature_engineering.entities import (
    CronSchedule,
    CronScheduleMode,
)

trigger = CronSchedule(mode=CronScheduleMode.DERIVED)
Não defina quartz_cron_expression com CronScheduleMode.DERIVED. Quando você recupera a funcionalidade materializada, o cronograma retornado pode conter a expressão cron que o Azure Databricks calculou.
Para controlar o cronograma diretamente, forneça uma expressão cron de quartzo.
CronScheduleMode.MANUAL é inferido quando você fornece uma expressão:
from databricks.feature_engineering.entities import CronSchedule

trigger = CronSchedule(
    quartz_cron_expression="0 0 * * * ?",  # Hourly
    timezone_id="UTC",
)
TableTrigger
Use TableTrigger para ColumnSelection recursos ou recursos de agregação (AggregationFunction) com suporte de um DeltaTableSource. O pipeline é executado sempre que a tabela Delta upstream recebe uma nova confirmação.
Para recursos de agregação, o pipeline é limitado para não rodar em todos os commits. O pipeline roda no máximo uma vez a cada metade do comprimento da janela do recurso, mas nunca mais frequentemente que a cada 5 minutos. Por exemplo, um recurso com uma janela de queda de 1 hora roda no máximo uma vez a cada 30 minutos, ou um recurso com uma janela de 8 horas roda no máximo uma vez a cada 4 horas. O piso de 5 minutos se aplica quando metade da janela é menor que isso, então janelas de 10 minutos ou menos funcionam no máximo uma vez a cada 5 minutos. Recursos de agregação cuja janela é inferior a 5 minutos não podem usar TableTrigger, usam um gatilho de streaming em vez disso.
from databricks.feature_engineering.entities import TableTrigger

trigger = TableTrigger()
StreamingMode
Uso StreamingMode para recursos apoiados por um StreamSource. O pipeline é executado como um pipeline de streaming contínuo.
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    StreamSource, Feature, AggregationFunction, Sum,
    RollingWindow, OnlineStoreConfig, StreamingMode,
)
from datetime import timedelta

fe = FeatureEngineeringClient()

stream_source = StreamSource(full_name="my_catalog.my_schema.my_stream")

streaming_feature = fe.create_feature(
    source=stream_source,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(
        operator=Sum(input="value.amount"),
        time_window=RollingWindow(window_duration=timedelta(hours=1)),
    ),
    catalog_name="my_catalog",
    schema_name="my_schema",
    name="user_purchase_sum",
)

fe.materialize_features(
    features=[streaming_feature],
    online_config=OnlineStoreConfig(
        catalog_name="my_catalog",
        schema_name="my_schema",
        table_name_prefix="streaming_features_serving",
        online_store_name="feature_store_online",
    ),
    trigger=StreamingMode(),
)
Escolhendo um gatilho
Cada recurso usa um gatilho; As opções por tipo de recurso são:
| Tipo de funcionalidade | Disparador | Quando executado |
|---|---|---|
Agregação (AggregationFunction) de DeltaTableSource |
CronSchedule |
Em um cronograma derivado ou manual |
Agregação (AggregationFunction) de DeltaTableSource |
TableTrigger |
Em cada confirmação de tabela de origem |
ColumnSelection (de DeltaTableSource) |
TableTrigger |
Em cada confirmação de tabela de origem |
Recursos de StreamSource |
StreamingMode |
Streaming contínuo |
Não é possível materializar recursos que exigem tipos de gatilho diferentes em uma única materialize_features chamada. Em vez disso, emita chamadas separadas.