Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Aplica-se a:✅Armazém de dados no Microsoft Fabric
Este artigo descreve métodos para migrar data warehouses de SQL Server para Microsoft Fabric Data Warehouse.
Dica
Para mais informações sobre estratégia e planejamento, veja Planejamento de Migração: SQL Server a Fabric Data Warehouse.
Use o Fabric Assistente de Migração para Data Warehouse para uma experiência de migração automatizada a partir de SQL Server. O restante deste artigo descreve mais passos manuais de migração.
A tabela a seguir resume métodos para migração do esquema de dados (DDL), código de banco de dados (DML) e dados. Cada opção é descrita mais adiante neste artigo.
| Opção | Method | O que faz | Habilidade ou preferência | Scenario |
|---|---|---|---|---|
| 1 | Azure Data Factory | Conversão de esquema Extração de dados Ingestão de dados |
Pipeline do Data Factory | Simplificação da migração de esquemas e dados. Recomendado para tabelas de dimensões. |
| 2 | Data Factory com particionamento | Conversão de esquema Extração de dados Ingestão de dados |
Pipeline Data Factory | Migração paralelizada para grandes tabelas de fatos. |
| 3 | Migração com o esquema primeiro | Conversão de esquema | Pipeline Data Factory | Migre o esquema primeiro, e depois extraia e ingira os dados separadamente para maior controle sobre o throughput. |
| 4 | Scripts de migração SQL | Conversão de esquema Extração de dados Avaliação de códigos |
T-SQL | Use um IDE e scripts para controle granular sobre tarefas de migração. |
| 5 | Projetos do banco de dados SQL | Conversão de esquema Avaliação de códigos |
Projeto SQL | Use um projeto de banco de dados para controle de versão, avaliação e implantação. |
| 6 | dbt | Conversão de esquema Conversão de código de banco de dados |
dbt | Reutilize um projeto DBT existente mudando o adaptador e a configuração do alvo. |
Escolha a carga de trabalho para a migração inicial
Ao decidir por onde começar um projeto de migração do SQL Server para o Fabric Data Warehouse, escolha uma área de carga de trabalho na qual você possa:
- Comprove a viabilidade da migração para Fabric Data Warehouse entregando rapidamente os benefícios do novo ambiente. Comece pequeno e simples, e prepare-se para múltiplas migrações pequenas.
- Dê tempo para sua equipe técnica adquirir experiência relevante com os processos e ferramentas que eles usam para migrar outras cargas de trabalho.
- Crie um modelo para migrações futuras que seja específico para seu ambiente, ferramentas e processos do seu SQL Server.
Dica
Crie um inventário dos objetos que precisam ser migrados e documente o processo de migração do início ao fim para que possa ser repetido em outros bancos de dados ou cargas de trabalho.
O volume de dados em uma migração inicial deve ser grande o suficiente para demonstrar as capacidades e benefícios da Fabric Data Warehouse, mas pequeno o bastante para demonstrar valor rapidamente. Um tamanho entre 1 e 10 terabytes é típico.
Migrar com o Fabric Data Factory
O Fabric Data Factory oferece uma interface low-code que permite converter DDL de tabela e migrar dados do SQL Server.
O Data Factory Fabric pode executar as seguintes tarefas:
- Converta o esquema (DDL) para a sintaxe do Fabric Data Warehouse.
- Crie objetos de esquema em Fabric Data Warehouse.
- Migre dados para Fabric Data Warehouse.
Opção 1. Migração de esquemas e dados com o Copy assistant
Esse método utiliza o assistente Data Factory Copy para conectar ao banco de dados SQL Server fonte, converter DDL de tabela para sintaxe Fabric e copiar dados para Fabric Data Warehouse. Você pode selecionar uma ou mais tabelas fonte. O pipeline gerado utiliza uma atividade ForEach para copiar as tabelas selecionadas em paralelo.
Quando você configura a operação de cópia:
- Use o conector SQL Server para a conexão de origem.
- Limite cópias paralelas a um nível que o banco de dados e a rede de origem possam sustentar.
- Monitore o uso da CPU de origem, de E/S, do log de transações e a latência da carga de trabalho de produção durante a extração.
Uso recomendado
Use o Copy Assistant para uma interface simples que converte DDL e ingere tabelas selecionadas em uma única operação. Esse método é adequado para tabelas de dimensões e cargas de trabalho menores.
Para tabelas grandes, use particionamento para aumentar o paralelismo de leitura e escrita.
Opção 2. Migração de dados com particionamento
Para tabelas de fatos grandes, use uma atividade de Cópia para cada tabela e configure o particionamento de origem. Use partições físicas quando disponíveis, ou configure a partição por faixa dinâmica especificando uma coluna numérica ou de data adequada e seus valores mínimos e máximos.
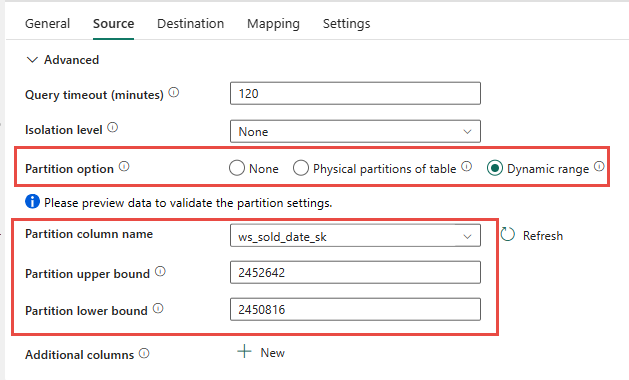
Quando você usa particionamento:
- Escolha uma coluna de partição que distribua as linhas de forma uniforme.
- Evite criar mais consultas de código fonte concorrentes do que o SQL Server pode processar sem afetar as cargas de trabalho de produção.
- Teste o intervalo de partições e as configurações de cópia paralela contra uma carga de trabalho representativa.
- Aumente o paralelismo gradualmente enquanto monitora a origem e o destino.
Uso recomendado
Use o particionamento Data Factory para grandes tabelas de dados quando a extração paralela melhora a taxa de transferência. Dimensione a contagem de lotes e as faixas de partição de acordo com seus recursos de banco de dados de origem e capacidade de rede.
Opção 3. Migração com abordagem schema-first
Para bancos de dados maiores, separe a migração de esquemas da migração de dados:
- Converta e crie esquemas de tabela em Fabric Data Warehouse.
- Extrair os dados de origem no Azure Data Lake Storage (ADLS) Gen2.
- Use Data Factory ou o comando COPY INTO para carregar os dados armazenados na área de staging no Fabric Data Warehouse.
Separar essas fases permite que você ajuste a extração e a ingestão de forma independente.
Migração de esquemas com Data Factory
Você pode usar um pipeline de Fabric para migrar esquemas de tabela de SQL Server para Fabric Data Warehouse sem copiar linhas.
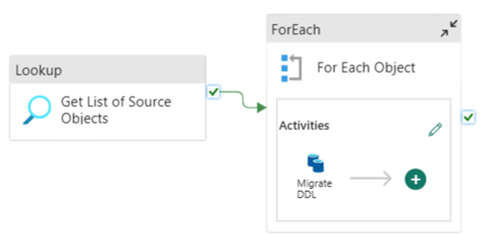
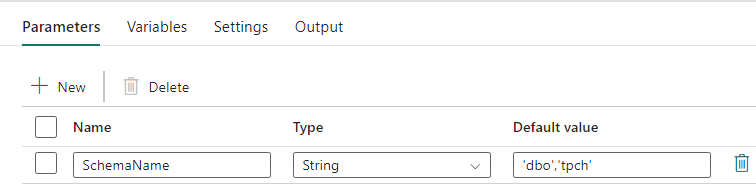
Configurar parâmetros do pipeline
Crie um SchemaName parâmetro que especifique quais esquemas migrar. Use dbo como padrão, ou insira uma lista delimitada por vírgulas como 'dbo','sales'.
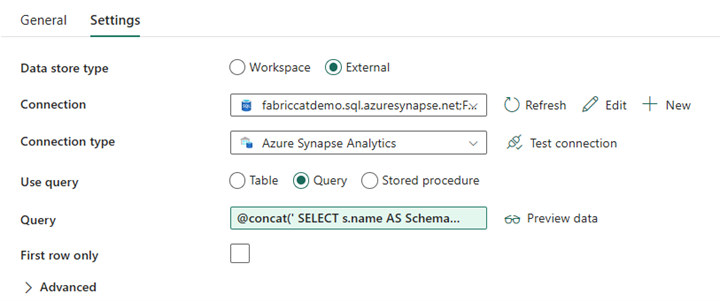
Configurar a atividade Pesquisa
Crie uma atividade de Busca e defina sua conexão com o banco de dados SQL Server de origem. Na aba Configurações:
- Defina o tipo de armazenamento de dados como externo.
- Selecione a conexão SQL Server de origem.
- Defina Usar consulta como Consulta.
- Adicione uma consulta dinâmica que retorne os nomes do esquema e das tabelas de origem.
Use a seguinte expressão para criar a consulta:
@concat('
SELECT s.name AS SchemaName,
t.name AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')
Configurar a atividade ForEach
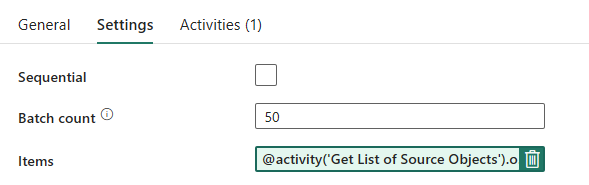
Na aba Configurações da atividade ForEach :
- Desative o Sequencial para permitir que as iterações sejam executadas simultaneamente.
- Defina a contagem de lotes para um valor que o banco de dados de origem possa sustentar. Comece com um valor conservador e teste.
- Defina Itens como
@activity('Get List of Source Objects').output.value.
Configurar a atividade de Cópia
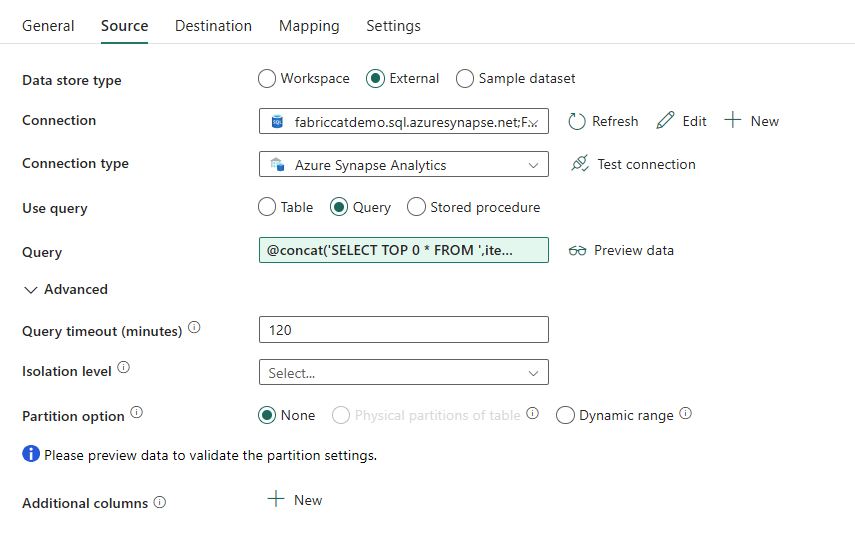
Dentro da atividade ForEach, adicione uma atividade Copy. Na guia Origem:
- Defina o tipo de armazenamento de dados como externo.
- Selecione a conexão SQL Server de origem.
- Defina Usar consulta como Consulta.
- Defina Consulta como
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)para que apenas os metadados da tabela sejam migrados.
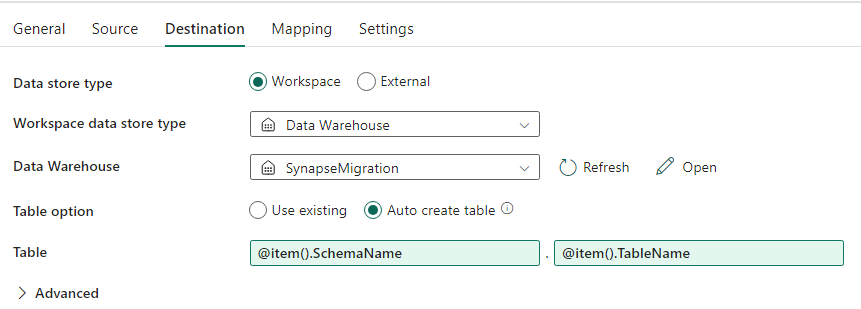
Na guia Destino:
- Defina o tipo de armazenamento de dados como espaço de trabalho.
- Defina o tipo de armazenamento de dados do Workspace para Data Warehouse e selecione o depósito de destino.
- Defina o esquema de destino para
@item().SchemaName. - Defina a tabela de destino para
@item().TableName.
Depois de rodar o pipeline, verifique se Fabric Data Warehouse contém cada tabela selecionada com o esquema esperado.
Migrar usando scripts SQL
Use scripts de migração T-SQL e PowerShell quando quiser controle granular sobre conversão de esquema, extração de dados e avaliação de código.
Scripts de migração podem:
- Converta o esquema (DDL) para a sintaxe do Fabric Data Warehouse.
- Crie objetos de esquema em Fabric Data Warehouse.
- Extrair dados do SQL Server para ADLS Gen2.
- Sinalize a sintaxe T-SQL não suportada em procedimentos armazenados, funções e visualizações.
A equipe CAT do Microsoft Fabric fornece exemplos de código de migração no repositório fabric-migration.
Uso recomendado
Use scripts quando estiver familiarizado com T-SQL, preferir um ambiente de desenvolvimento integrado e precisar controlar tarefas individuais de migração. Use COPY INTO ou o Data Factory para ingerir os dados extraídos no Fabric Data Warehouse.
Migração usando o projeto de banco de dados SQL
Fabric Data Warehouse é suportado na extensão SQL Database Projects para Visual Studio Code.
Um projeto de banco de dados SQL fornece controle de versão, testes de banco de dados, validação de esquemas e capacidades de implantação. Ele pode:
- Converta o esquema (DDL) para a sintaxe do Fabric Data Warehouse.
- Crie objetos de esquema em Fabric Data Warehouse.
- Avalie a sintaxe T-SQL não suportada em procedimentos armazenados, funções e visualizações.
Para migração de dados, use o Data Factory para copiar diretamente do SQL Server ou extraia os dados para o ADLS Gen2 e ingeri-los com COPY INTO ou o Data Factory.
Para um passo a passo de como usar projetos de banco de dados SQL com scripts de migração, consulte o fabric-migration repository.
Para mais informações, veja Comece com a extensão SQL Database Projects e Construa um projeto de banco de dados a partir da linha de comando.
Migração com dbt
Se o armazém de dados do SQL Server usa dbt, você pode usar o adaptador do dbt para o Fabric Data Warehouse para converter o esquema e o código do banco de dados, alterando o perfil de destino e o adaptador.
O framework dbt gera scripts DDL e DML a partir de arquivos modelo. Você deve migrar os dados separadamente usando o Data Factory ou outra opção de migração de dados neste artigo.
Para começar, veja o Tutorial: Configurar o DBT para Fabric Data Warehouse.
Ingestão de dados em Fabric Data Warehouse
Para dados preparados, use COPY INTO ou o Fabric Data Factory para carregar arquivos do ADLS Gen2 no Fabric Data Warehouse. Considere as seguintes orientações:
- Extraia tabelas grandes em paralelo quando o banco de dados de origem e a rede tiverem capacidade suficiente.
- Prefiro arquivos Parquet para reduzir o armazenamento e o uso da rede e melhorar a eficiência da ingestão.
- Carregue várias tabelas de destino simultaneamente quando a capacidade do Fabric for capaz de suportar a carga de trabalho.
- Monitore tanto a extração da fonte quanto a capacidade do Fabric para encontrar o grau ideal de paralelismo.