Transformar dados com junções e definir operadores
Os fluxos de trabalho de engenharia de dados geralmente exigem a combinação de informações de vários conjuntos de dados. Junções combinam tabelas horizontalmente correlacionando linhas em colunas associadas, enquanto operadores set combinam tabelas verticalmente acrescentando, cruzando ou excluindo linhas. Entender quando usar cada abordagem ajuda você a criar pipelines de transformação eficientes.
Nesta unidade, você aprenderá a unir tabelas com base em relações e aplicar operadores de conjunto para combinar conjuntos de dados com esquemas correspondentes.
Combinar tabelas com junções
Realiza a junção de linhas de duas tabelas com base em uma coluna comum. O tipo de junção determina quais linhas aparecem no resultado e como as linhas sem correspondência são tratadas.
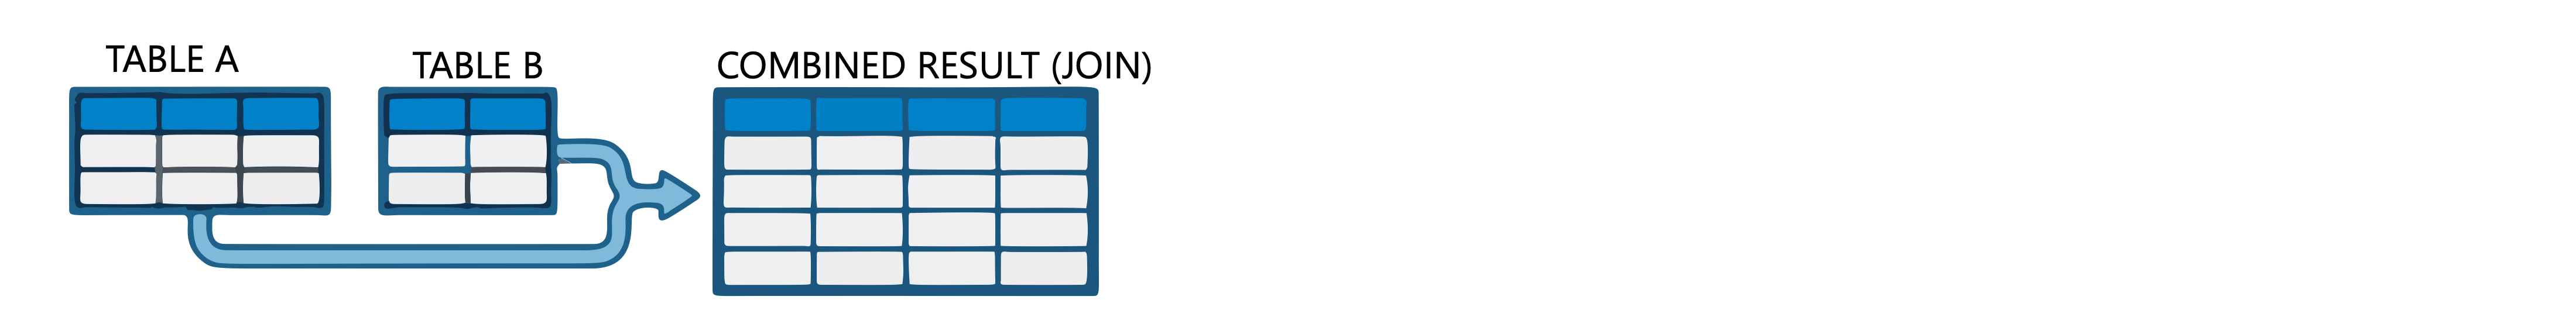
Entender os tipos de junção
Cada tipo de junção serve a uma finalidade específica na transformação de dados:

| Tipo de junção | Description | Caso de uso |
|---|---|---|
INNER |
Retorna apenas linhas correspondentes de ambas as tabelas | Vincular pedidos com clientes válidos |
LEFT |
Retorna todas as linhas da tabela esquerda; adiciona NULLs para a tabela direita quando não há correspondência | Incluir todos os clientes, mesmo sem pedidos |
RIGHT |
Retorna todas as linhas da tabela à direita; adiciona NULLs para a tabela à direita quando não há correspondência com a tabela à esquerda. | Incluir todos os departamentos, mesmo sem funcionários |
FULL |
Retorna todas as linhas de ambas as tabelas; adiciona valores nulos para não correspondências | Combinar conjuntos de dados para encontrar lacunas em ambos os lados |
SEMI |
Retorna linhas da tabela esquerda que têm correspondências na tabela direita | Filtrar clientes que realizaram pedidos |
ANTI |
Retorna linhas da tabela esquerda que não têm correspondência na tabela direita | Localizar clientes que nunca realizaram pedidos |
CROSS |
Retorna o produto cartesiano de todas as linhas | Gerar todas as combinações possíveis |
Unir tabelas com SQL
A JOIN cláusula combina tabelas com base em uma condição especificada com ON ou USING. Os exemplos a seguir usam tabelas de funcionários e departamentos:
CREATE TEMP VIEW employee(id, name, deptno) AS
    VALUES (105, 'Chloe', 5),
           (103, 'Paul',  3),
           (101, 'John',  1),
           (102, 'Lisa',  2),
           (104, 'Evan',  4),
           (106, 'Amy',   6);

CREATE TEMP VIEW department(deptno, deptname) AS
    VALUES (3, 'Engineering'),
           (2, 'Sales'),
           (1, 'Marketing');
Para fazer a correspondência dos funcionários com seus departamentos, use uma junção interna:
-- Inner join: only employees with matching departments
SELECT e.id, e.name, e.deptno, d.deptname
FROM employee e
INNER JOIN department d ON e.deptno = d.deptno;
Uma junção interna retorna apenas três linhas: funcionários cujos números de departamento existem na tabela de departamentos. Os funcionários dos departamentos 4, 5 e 6 não aparecem porque esses departamentos não estão na tabela do departamento.
Quando precisar incluir todos os funcionários, independentemente das correspondências do departamento, use uma junção à esquerda:
-- Left join: all employees, NULL for missing departments
SELECT e.id, e.name, e.deptno, d.deptname
FROM employee e
LEFT JOIN department d ON e.deptno = d.deptno;
Isso retorna todos os seis funcionários. Aqueles sem departamentos correspondentes mostram NULL na coluna deptname.
Unir DataFrames ao PySpark
O método do join() PySpark fornece a mesma funcionalidade. O how parâmetro especifica o tipo de junção:
df_employee = spark.table("employee")
df_department = spark.table("department")

# Inner join
df_inner = df_employee.join(
    df_department,
    on=df_employee.deptno == df_department.deptno,
    how="inner"
)
display(df_inner)
Para junções externas à esquerda, à direita ou completas, altere o parâmetro how.
# Left join: keep all employees
df_left = df_employee.join(
    df_department,
    on="deptno",
    how="left"
)

# Full outer join: keep all rows from both tables
df_full = df_employee.join(
    df_department,
    on="deptno",
    how="full"
)
Quando a coluna de junção tiver o mesmo nome em ambos os DataFrames, passe o nome da coluna como uma cadeia de caracteres. Essa abordagem evita colunas duplicadas no resultado.
Filtrar dados com junções semi e anti
Junções semi e anti filtram dados com base na existência em outra tabela. Uma junção semi retorna linhas da tabela esquerda que têm correspondências, sem incluir colunas da tabela direita:
-- Find employees who belong to listed departments
SELECT *
FROM employee
LEFT SEMI JOIN department ON employee.deptno = department.deptno;
Uma junção anti retorna o oposto – linhas sem correspondências:
-- Find employees in departments not listed
SELECT *
FROM employee
LEFT ANTI JOIN department ON employee.deptno = department.deptno;
No PySpark, use how="semi" ou how="anti":
# Employees with matching departments
df_semi = df_employee.join(df_department, on="deptno", how="semi")

# Employees without matching departments
df_anti = df_employee.join(df_department, on="deptno", how="anti")
Combinar linhas com operadores de conjunto
Os operadores de conjunto funcionam verticalmente, combinando linhas de consulta com a mesma estrutura de coluna. Ao contrário das junções, os operadores set não correspondem às condições: eles empilham ou comparam conjuntos de resultados inteiros.
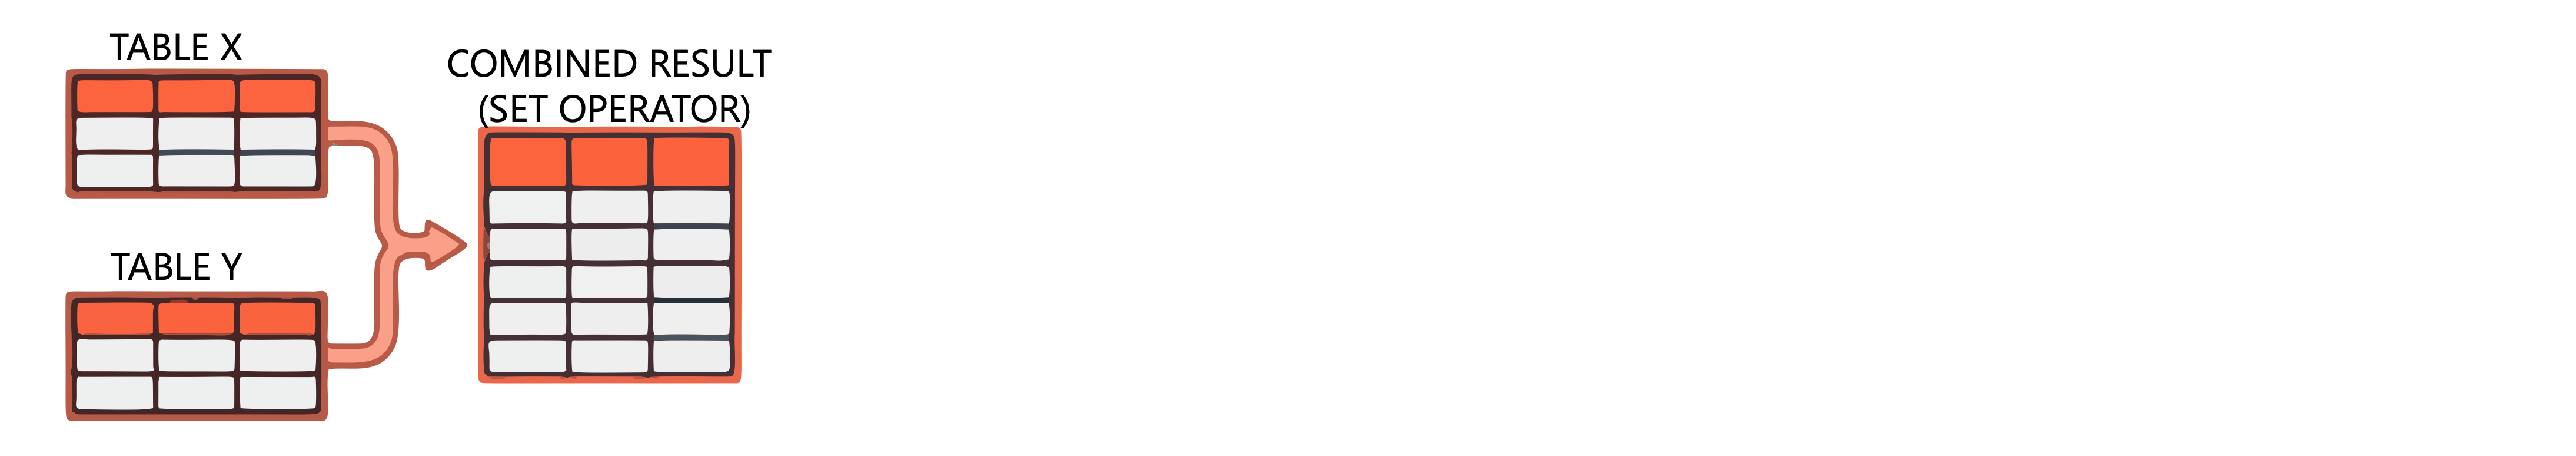
Entender operadores definidos
O Azure Databricks dá suporte a três operadores de conjunto:
| Operator | Description | Comportamento |
|---|---|---|
UNION |
Combina linhas de ambas as consultas | Remove duplicados como padrão; use ALL para mantê-los |
INTERSECT |
Retorna linhas que existem em ambos os conjuntos de consulta | Somente linhas correspondentes são exibidas |
EXCEPT |
Retorna as linhas da primeira consulta que não estão na segunda. | Remove duplicatas por padrão |
Ambas as consultas devem ter o mesmo número de colunas com tipos de dados compatíveis.
Mesclar conjuntos de dados com UNION
UNION acrescenta linhas de uma consulta para outra. Por padrão, ele remove duplicatas:
-- Combine active and archived customers (no duplicates)
SELECT customer_id, name, email FROM active_customers
UNION
SELECT customer_id, name, email FROM archived_customers;
Para preservar todas as linhas, incluindo as duplicatas, use UNION ALL:
-- Combine all rows, keeping duplicates
SELECT customer_id, name, email FROM active_customers
UNION ALL
SELECT customer_id, name, email FROM archived_customers;
Use UNION ALL se souber que não há duplicatas ou quando as duplicatas forem significativas. Desempenha melhor porque ignora a etapa de desduplicação.
No PySpark, use union() para combinar DataFrames. Observe que o union() do PySpark se comporta como UNION ALL: ele mantém duplicatas:
df_active = spark.table("active_customers")
df_archived = spark.table("archived_customers")

# Combine both tables (keeps duplicates)
df_combined = df_active.union(df_archived)

# Remove duplicates if needed
df_distinct = df_active.union(df_archived).distinct()
Localizar linhas comuns com INTERSECT
INTERSECT retorna apenas as linhas que aparecem em ambas as consultas. Isso ajuda a identificar dados sobrepostos:
-- Find customers in both active and archived tables
SELECT customer_id FROM active_customers
INTERSECT
SELECT customer_id FROM archived_customers;
Essa consulta identifica os clientes que de alguma forma aparecem em ambas as tabelas, úteis para verificações de qualidade de dados ou para identificar registros que precisam de reconciliação.
Excluir linhas com EXCEPT
EXCEPT retorna linhas da primeira consulta que não existem no segundo. Isso ajuda a identificar lacunas ou registros exclusivos:
-- Find active customers not in the archived table
SELECT customer_id FROM active_customers
EXCEPT
SELECT customer_id FROM archived_customers;
Você também pode usar MINUS como sinônimo para EXCEPT:
-- Same result using MINUS syntax
SELECT customer_id FROM active_customers
MINUS
SELECT customer_id FROM archived_customers;
Como UNION, INTERSECT e EXCEPT removem duplicatas por padrão. Adicione ALL para preservar duplicatas quando necessário.
Dica
Ao encadear operações de conjunto, lembre-se de que INTERSECT tem precedência maior que UNION e EXCEPT. Use parênteses para controlar a ordem de avaliação.
Escolher entre junções e definir operadores
A escolha entre junções e operadores de conjunto depende da meta de transformação. Junções combinam colunas de tabelas relacionadas horizontalmente, enquanto operadores de conjunto combinam linhas verticalmente.
Use joins quando você precisar:
- Enriquecer registros adicionando colunas de tabelas relacionadas
- Corresponder registros com base em relações-chave
- Filtrar dados com base na existência em outra tabela (junções semi/anti)
Use operadores definidos quando precisar:
- Anexar registros de várias fontes com esquemas idênticos
- Localizar registros comuns entre conjuntos de dados
- Identificar registros exclusivos de um conjunto de dados
Ambas as abordagens formam a base de pipelines de transformação de dados eficazes. Na próxima unidade, você explorará como carregar dados transformados em tabelas de destino no Catálogo do Unity.