Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Применимо к: SQL Server в Linux
В этой статье объясняется, как управлять экземпляром резервного кластера SQL Server (FCI) на Linux. Чтобы создать FCI SQL Server в Linux, см. Настройка экземпляра отказоустойчивого кластера в Linux (RHEL).
Описание архитектуры
Кластерный слой основан на дополнении Red Hat Enterprise Linux (RHEL) HA, построенном на базе Pacemaker. Corosync и Pacemaker координируют обмен данными и управление ресурсами. Экземпляр SQL Server активен одновременно только на одном узле.
На следующей схеме показаны компоненты кластера Linux с SQL Server.
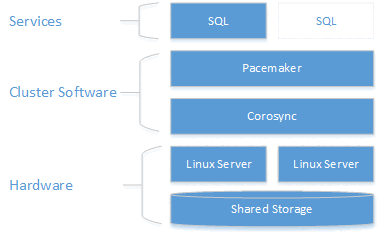
Для получения дополнительной информации о конфигурации кластера, опциях агента ресурсов и управлении посетите справочную документацию RHEL.
Failover
Переключение на резерв для FCI аналогично кластеру отказоустойчивости Windows Server (WSFC). Если узел кластера, размещающий FCI, испытывает какие-либо сбои, FCI должен автоматически переключиться на другой узел. В отличие от WSFC, нет возможности задать предпочитаемых владельцев, поэтому Pacemaker выбирает хост, который станет новым хостом для FCI.
Иногда может потребоваться вручную выполнить переключение FCI на другой узел. Процесс отличается от работы с FCIs в WSFC. В кластере WSFC переключение на резервный узел ресурсов выполняется на уровне роли. В Pacemaker вы выбираете ресурс для перемещения, и если все ограничения правильны, всё остальное тоже перемещается.
Способ отказа зависит от дистрибутива Linux. Следуйте инструкциям для вашего дистрибутива Linux.
Ручное аварийное переключение (RHEL или Ubuntu)
Чтобы выполнить ручное переключение на резерв на серверах, работающих под управлением Red Hat Enterprise Linux (RHEL) или Ubuntu, последуйте следующим шагам.
Выполните следующую команду:
sudo pcs resource move <FCIResourceName> <NewHostNode><FCIResourceName>— это имя ресурса Pacemaker для SQL Server FCI и<NewHostNode>название узла кластера, на котором вы хотите разместить FCI.Во время ручного переключения на резерв Pacemaker создает ограничение местоположения для ресурса, который был выбран для перемещения вручную. Чтобы просмотреть это ограничение, выполните команду
sudo pcs constraint.После завершения переключения при отказе необходимо снять ограничение:
sudo pcs resource clear <FCIResourceName>
Ручное резервное переключение (SLES)
Note
Начиная с SQL Server 2025 (17.x), SUSE Linux Enterprise Server (SLES) не поддерживается. Для SQL Server 2022 (16.x) и более ранних версий поддерживается только SLES 15.
В SUSE Linux Enterprise Server (SLES) используйте команду migrate для ручного переключения SQL Server FCI. Рассмотрим пример.
crm resource migrate <FCIResourceName> <NewHostNode>
<FCIResourceName> — это имя ресурса для экземпляра резервного кластера, а <NewHostNode> — имя нового хоста-получателя.
Отслеживание отказоустойчивого кластера
Просмотр текущего состояния кластера:
sudo pcs status
Просмотр текущего состояния кластера и ресурсов:
sudo crm_mon
Просмотрите логи агентов ресурсов по адресу /var/log/cluster/corosync.log.
Добавление узла в кластер
Проверьте IP-адрес для каждого узла. Для отображения IP-адреса текущего узла выполните следующий сценарий.
ip addr showНовый узел требует уникального имени из 15 символов или меньше. Задайте имя компьютера, добавив его к
/etc/hosts. Следующий сценарий позволяет изменить/etc/hostsс помощьюvi.sudo vi /etc/hostsВ следующем примере показаны
/etc/hostsс дополнениями для трех узлов с именамиsqlfcivm1,sqlfcivm2иsqlfcivm3.127.0.0.1 localhost localhost4 localhost4.localdomain4 ::1 localhost localhost6 localhost6.localdomain6 10.128.18.128 sqlfcivm1 10.128.16.77 sqlfcivm2 10.128.14.26 sqlfcivm3Файл должен быть одинаковым на каждом узле.
Остановите службу SQL Server на новом узле.
Следуйте инструкциям, чтобы смонтировать каталог файлов базы данных в общую точку.
На сервере NFS установите
nfs-utils:sudo yum -y install nfs-utilsОткройте брандмауэр на клиентах и сервере NFS:
sudo firewall-cmd --permanent --add-service=nfs
sudo firewall-cmd --permanent --add-service=mountd
sudo firewall-cmd --permanent --add-service=rpc-bind
sudo firewall-cmd --reload
Измените файл
/etc/fstab, чтобы включить команду подключения.<IP OF NFS SERVER>:<shared_storage_path> <database_files_directory_path> nfs timeo=14,intrЧтобы изменения вступили в силу, выполните команду
mount -a.На новом узле создайте файл для хранения имени пользователя и пароля SQL Server для входа с помощью Pacemaker. Следующая команда создает и заполняет такой файл:
sudo touch /var/opt/mssql/secrets/passwd
echo "<loginName>" | sudo tee -a /var/opt/mssql/secrets/passwd
echo "<password>" | sudo tee -a /var/opt/mssql/secrets/passwd
sudo chown root:root /var/opt/mssql/secrets/passwd
sudo chmod 600 /var/opt/mssql/secrets/passwd
Предостережение
Пароль должен соответствовать политике паролей по умолчанию SQL Server. По умолчанию пароль должен быть не короче восьми символов и содержать три вида символов из следующих: прописные буквы, строчные буквы, десятичные цифры, специальные символы. Пароли могут иметь длину до 128 символов. Рекомендуется использовать максимально длинные и сложные пароли.
В брандмауэре на новом узле откройте порты Pacemaker. Чтобы открыть эти порты с помощью
firewalld, выполните следующую команду:sudo firewall-cmd --permanent --add-service=high-availability sudo firewall-cmd --reloadЕсли вы используете другой файрвол без встроенной конфигурации высокой доступности, откройте следующие порты для взаимодействия Pacemaker с другими узлами кластера:
- TCP: порты 2224, 3121, 21064
- UDP: порт 5405
Установите пакеты Pacemaker на новом узле.
sudo yum install pacemaker pcs fence-agents-all resource-agentsЗадайте пароль для пользователя по умолчанию, который создается при установке пакетов Pacemaker и Corosync. Используйте тот же пароль, что и для существующих узлов.
sudo passwd haclusterВключите и запустите службу
pcsdи Pacemaker. Новый узел может вновь присоединиться к кластеру после перезагрузки. Выполните следующую команду на новом узле.sudo systemctl enable pcsd sudo systemctl start pcsd sudo systemctl enable pacemaker sudo systemctl start pacemakerУстановите агент ресурсов FCI для SQL Server. Выполните следующую команду на новом узле.
sudo yum install mssql-server-haНа существующем узле кластера аутентифицировать новый узел и добавить его в кластер:
sudo pcs cluster auth <nodeName3> -u hacluster
sudo pcs cluster node add <nodeName3>
Удаление узлов из кластера
Чтобы удалить узел из кластера, выполните следующую команду:
sudo pcs cluster node remove <nodeName>
Изменение частоты мониторинга ресурсов
sudo pcs resource op monitor interval=<interval>s <sqlResourceName>
Следующий пример устанавливает интервал мониторинга в 2 секунды для ресурса mssqlha :
sudo pcs resource op monitor interval=2s mssqlha
Troubleshoot
При устранении неполадок кластера важно понять, как три демона работают вместе для управления ресурсами кластера.
| Daemon | Description |
|---|---|
| Corosync | Обеспечивает членство в кворуме и обмен сообщениями между узлами кластера. |
| Кардиостимулятор | Работает поверх Corosync и предоставляет машины состояний для ресурсов. |
| ПКСД | Управляет Pacemaker и Corosync с помощью pcs средств. |
Чтобы использовать средства pcs, необходимо, чтобы PCSD был запущен.
Текущее состояние кластера
sudo pcs status возвращает основные сведения о кластере, кворуме, узлах, ресурсах и состоянии управляющих программ для каждого узла.
Следующий пример показывает вывод исправного кворума Pacemaker:
Cluster name: MyAppSQL
Last updated: Thu Oct 31 12:00:00 2024  Last change: Thu Oct 31 11:00:00 2024 by root via crm_resource on sqlvmnode1
Stack: corosync
Current DC: sqlvmnode1  (version 1.1.13-10.el7_2.4-44eb2dd) - partition with quorum
3 nodes and 1 resource configured

Online: [ sqlvmnode1 sqlvmnode2 sqlvmnode3 ]

Full list of resources:

mssqlha (ocf::sql:fci): Started sqlvmnode1

PCSD Status:
sqlvmnode1: Online
sqlvmnode2: Online
sqlvmnode3: Online

Daemon Status:
corosync: active/disabled
pacemaker: active/enabled
В этом примере partition with quorum означает, что кворум большинства узлов находится в сети. Если кластер теряет большинство узлов в кворуме, pcs status возвращает partition WITHOUT quorum, и все ресурсы останавливаются.
Online: [sqlvmnode1 sqlvmnode2 sqlvmnode3] возвращает имена всех узлов, которые сейчас участвуют в кластере. Если какие-либо узлы не участвуют, pcs status возвращается OFFLINE: [<nodename>].
PCSD Status показывает состояние кластера для каждого узла.
Причины, по которым узел может быть офлайн
Если узел находится в автономном режиме, проверьте следующие элементы.
Брандмауэр.
Откройте следующие порты на всех узлах, чтобы Pacemaker мог взаимодействовать:
- TCP: порты 2224, 3121, 21064
- UDP: порт 5405
Службы Pacemaker или Corosync работают
Связь между узлами
Сопоставления имен узлов