Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
В этом руководстве показано, как проверить устойчивость кластера Valkey, развернутого в службе Azure Kubernetes (AKS), с помощью платформы нагрузочного тестирования Locust. В нем рассматривается создание тестового клиента, развертывание его в AKS, имитация сбоев и анализ поведения кластера.
Note
В этой статье содержатся ссылки на главный термин (основной), который больше не используется корпорацией Майкрософт. Когда термин удаляется из программного обеспечения Valkey, мы удалим его из этой статьи.
Создание примера клиентского приложения для Valkey
Ниже показано, как создать пример клиентского приложения для Valkey.
Пример клиентского приложения использует платформу нагрузочного тестирования Locust для имитации рабочей нагрузки в кластере Valkey, настроенном и развернутом. Код Python реализует класс Locust User, который подключается к кластеру Valkey и выполняет операции установки и получения. Этот класс можно развернуть для реализации более сложных операций.
Note
Рекомендуется использовать самый безопасный поток проверки подлинности. Поток проверки подлинности, описанный в этой процедуре, требует очень высокого уровня доверия к приложению и несет риски, которые не присутствуют в других потоках. Этот поток следует использовать только в том случае, если другие более безопасные потоки, такие как управляемые удостоверения, не являются жизнеспособными.
Создайте Dockerfile и
requirements.txtпоместите их в новый каталог с помощью следующих команд:mkdir valkey-client cd valkey-client cat > Dockerfile <<EOF FROM python:3.10-slim-bullseye COPY requirements.txt . COPY locustfile.py . RUN pip install --upgrade pip && pip install --no-cache-dir -r requirements.txt EOF cat > requirements.txt <<EOF valkey locust EOFlocustfile.pyСоздайте файл, содержащий код клиентского приложения Valkey:cat > locustfile.py <<EOF import time from locust import between, task, User, events,tag, constant_throughput from valkey import ValkeyCluster from random import randint class ValkeyLocust(User): wait_time = constant_throughput(50) host = "valkey-cluster.valkey.svc.cluster.local" def __init__(self, *args, **kwargs): super(ValkeyLocust, self).__init__(*args, **kwargs) self.client = ValkeyClient(host=self.host) def on_stop(self): self.client.close() @task @tag("set") def set_value(self): self.client.set_value("set_value") @task @tag("get") def get_value(self): self.client.get_value("get_value") class ValkeyClient(object): def __init__(self, host, *args, **kwargs): super().__init__(*args, **kwargs) with open("/etc/valkey-password/valkey-password-file.conf", "r") as f: self.password = f.readlines()[0].split(" ")[1].strip() self.host = host self.vc = ValkeyCluster(host=self.host, port=6379, password=self.password, username="default", cluster_error_retry_attempts=0, socket_timeout=2, keepalive=1 ) def set_value(self, key, command='SET'): start_time = time.perf_counter() try: result = self.vc.set(randint(0, 1000), randint(0, 1000)) if not result: result = '' length = len(str(result)) total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=length, ) except Exception as e: total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=0, exception=e ) result = '' return result def get_value(self, key, command='GET'): start_time = time.perf_counter() try: result = self.vc.get(randint(0, 1000)) if not result: result = '' length = len(str(result)) total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=length, ) except Exception as e: total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=0, exception=e ) result = '' return result EOF
Создание и отправка образа Docker в ACR
Создайте образ Docker и отправьте его в реестр контейнеров Azure (ACR) с помощью
az acr buildкоманды.az acr build --image valkey-client --registry ${MY_ACR_REGISTRY} .Убедитесь, что образ успешно отправлен с помощью
az acr repository listкоманды.az acr repository list --name ${MY_ACR_REGISTRY} --output tableВывод должен показать изображение
valkey-client, как показано в следующем примере:Result ---------------- valkey-client
Разверните пример клиентского пода в AKS
PodСоздайте образ клиента Valkey, встроенный на предыдущем шагеkubectl applyс помощью команды. Спецификация pod содержит том CSI хранилища секретов с паролем Valkey, который клиент использует для подключения к кластеру Valkey.kubectl apply -f - <<EOF --- kind: Pod apiVersion: v1 metadata: name: valkey-client namespace: valkey spec: affinity: nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: agentpool operator: In values: - nodepool1 containers: - name: valkey-client image: ${MY_ACR_REGISTRY}.azurecr.io/valkey-client command: ["locust", "--processes", "4"] volumeMounts: - name: valkey-password mountPath: "/etc/valkey-password" volumes: - name: valkey-password csi: driver: secrets-store.csi.k8s.io readOnly: true volumeAttributes: secretProviderClass: "valkey-password" EOFПеренаправьте порт 8089 для доступа к веб-интерфейсу Locust на локальном
kubectl port-forwardкомпьютере с помощью команды.kubectl port-forward -n valkey valkey-client 8089:8089Получите доступ к веб-интерфейсу
http://localhost:8089Locust и запустите тест. Вы можете настроить количество пользователей и частоту возникновения, чтобы имитировать рабочую нагрузку в кластере Valkey. На следующем графике используется 100 пользователей и 10 разреженных частот: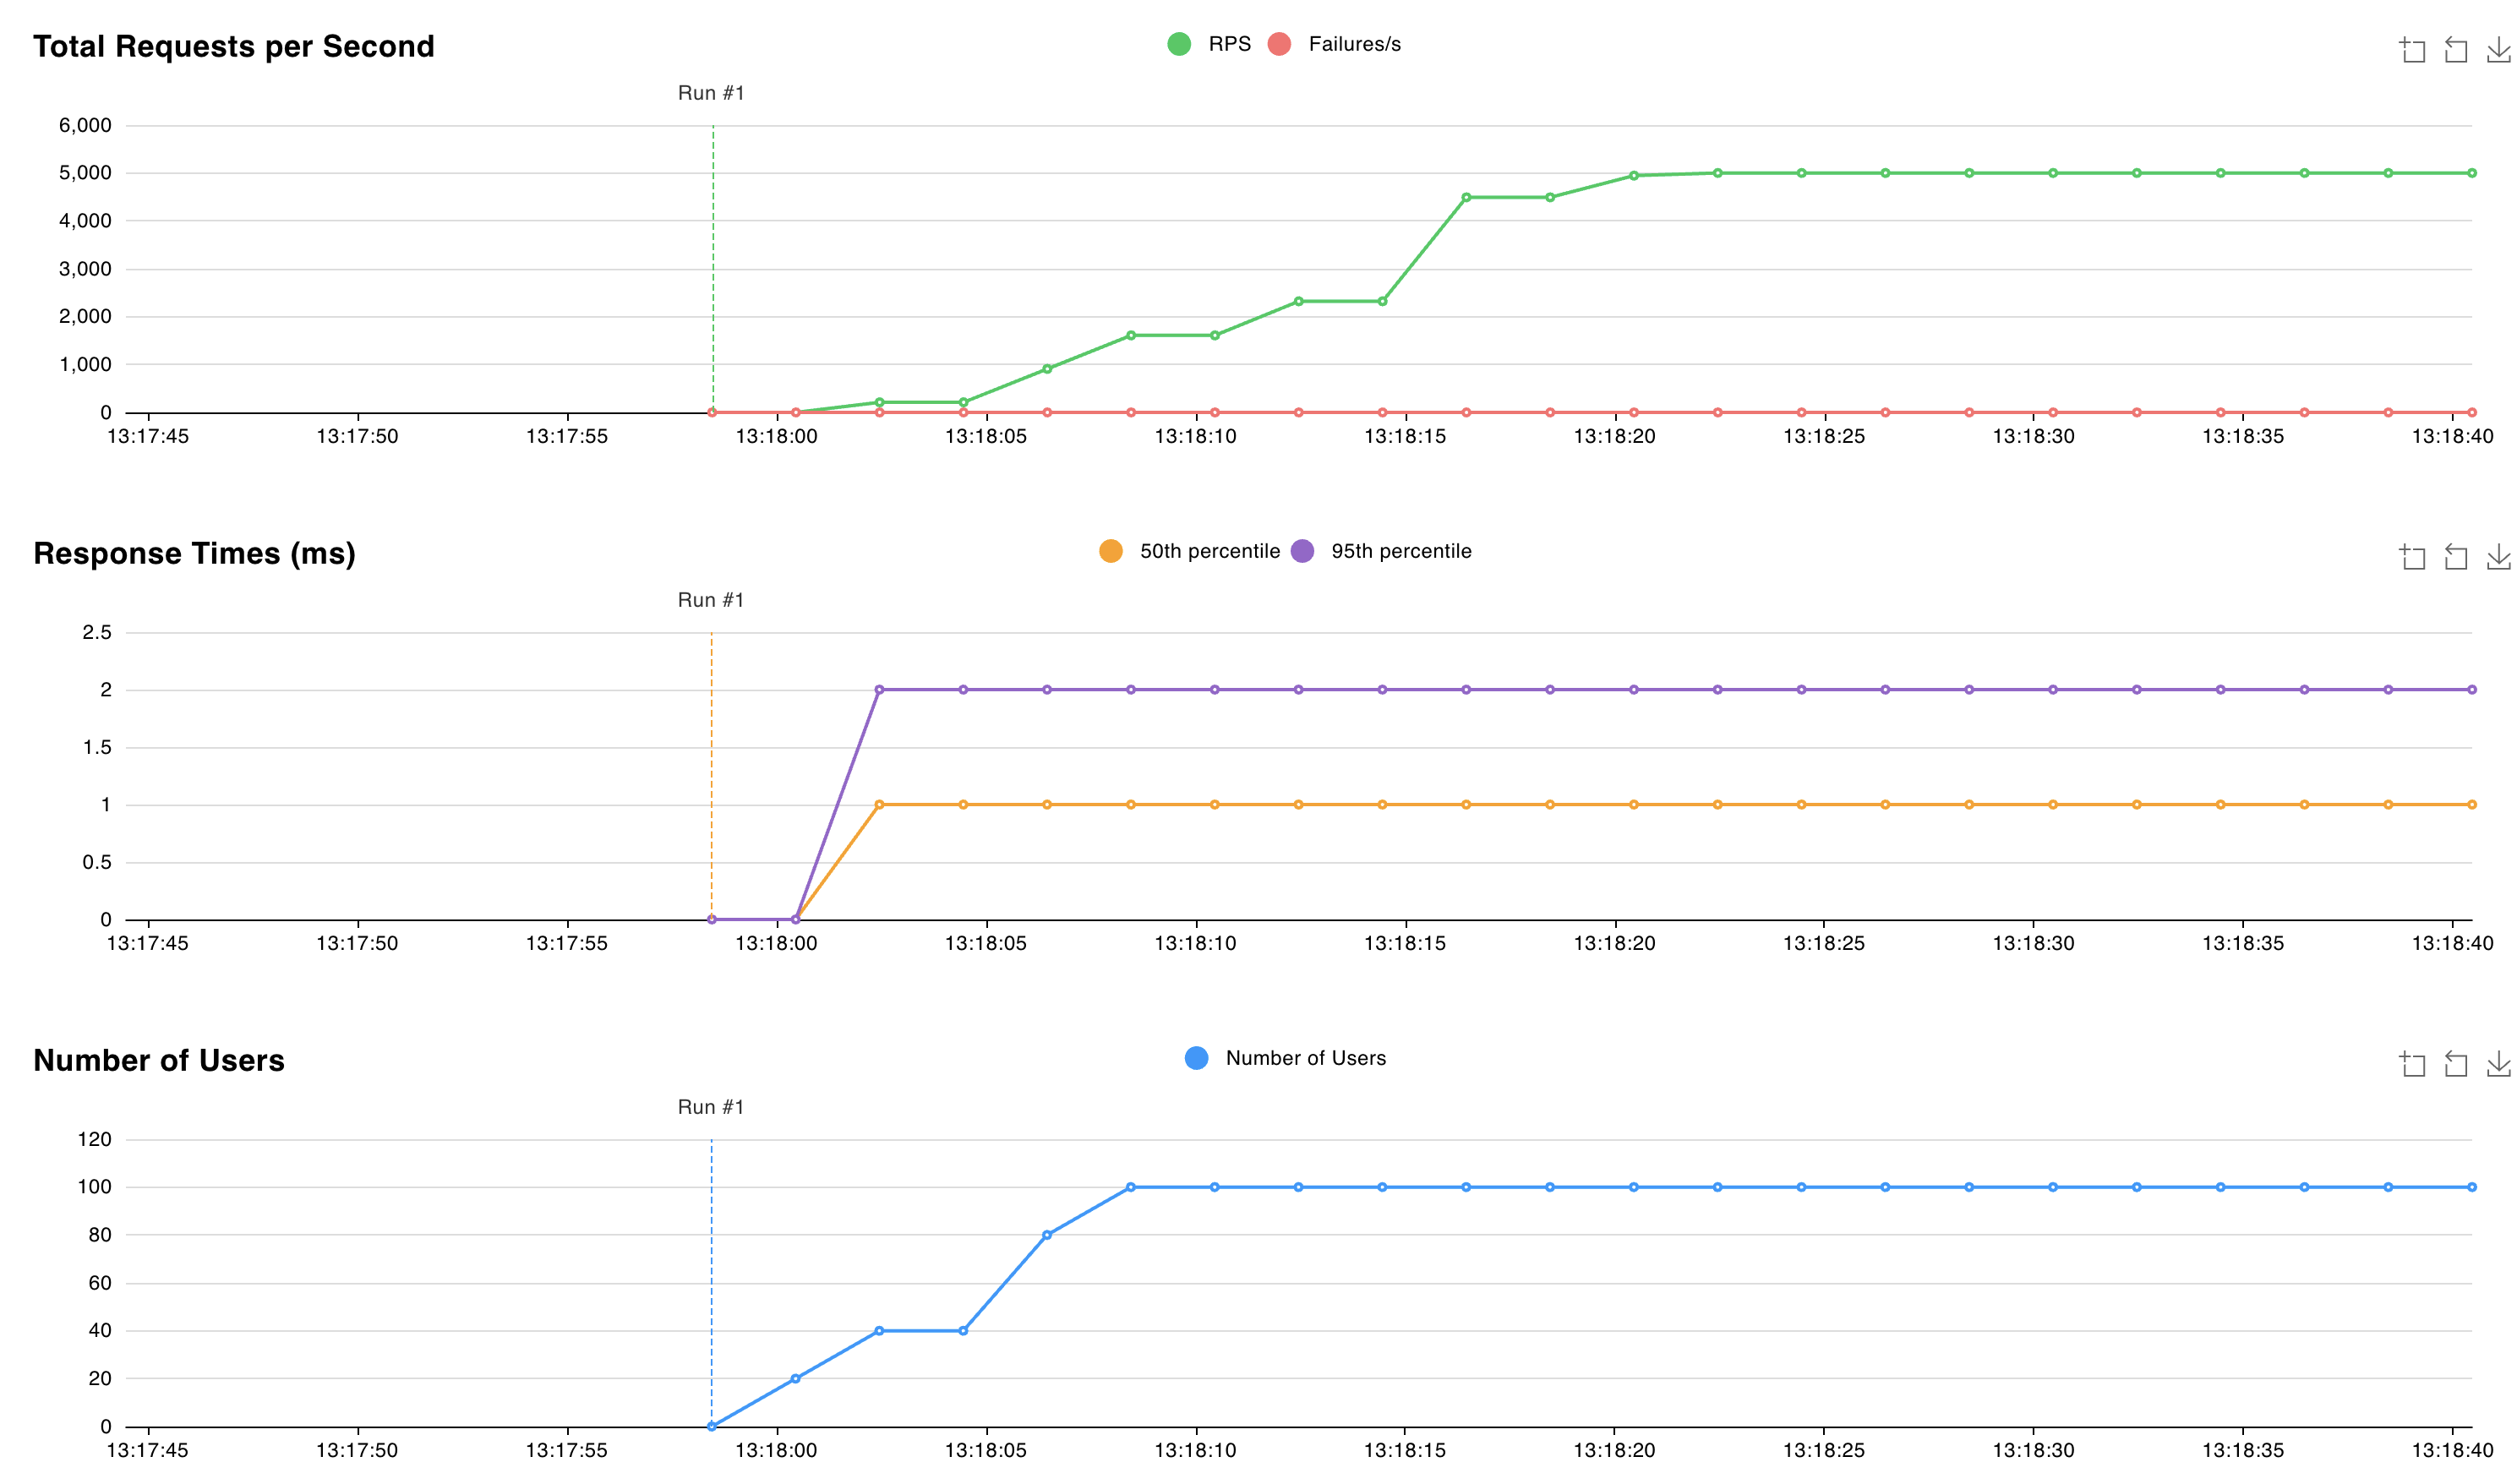
Имитация сбоя и наблюдение за поведением кластера Valkey
Имитируйте сбой, удалив
StatefulSetкоманду сkubectl deleteфлагом--cascade=orphan. Цель заключается в том, чтобы удалить один pod без немедленногоStatefulSetвоссоздания удаленного pod.kubectl delete statefulset valkey-masters --cascade=orphanvalkey-masters-0Удалите pod с помощью командыkubectl delete pod.kubectl delete pod valkey-masters-0Проверьте список подов командой
kubectl get pods.kubectl get podsВыходные данные должны указывать, что модуль pod
valkey-masters-0был удален. Остальные поды должны находиться в состоянииRunning, как показано в следующем примере.NAME READY STATUS RESTARTS AGE valkey-client 1/1 Running 0 6m34s valkey-masters-1 1/1 Running 0 16m valkey-masters-2 1/1 Running 0 16m valkey-replicas-0 1/1 Running 0 16m valkey-replicas-1 1/1 Running 0 16m valkey-replicas-2 1/1 Running 0 16mПолучите журналы pod
valkey-replicas-0с помощью командыkubectl logs valkey-replicas-0.kubectl logs valkey-replicas-0В выходных данных мы видим, что полное событие длится около 18 секунд:
1:S 05 Nov 2024 12:18:53.961 * Connection with primary lost.
1:S 05 Nov 2024 12:18:53.961 * Caching the disconnected primary state.
1:S 05 Nov 2024 12:18:53.961 * Reconnecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:18:53.961 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:18:53.964 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:18:54.910 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:18:54.910 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:18:54.912 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:18:55.920 * Connecting to PRIMARY 10.224.0.250:6379
[..CUT..]
1:S 05 Nov 2024 12:19:10.056 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:19:10.057 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:19:10.058 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:19:10.709 * Node c44d4b682b6fb9b37033d3e30574873545266d67 () reported node 9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e     () as not reachable.
1:S 05 Nov 2024 12:19:10.864 * NODE 9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e () possibly failing.
1:S 05 Nov 2024 12:19:11.066 * 10000 changes in 60 seconds. Saving...
1:S 05 Nov 2024 12:19:11.068 * Background saving started by pid 29
1:S 05 Nov 2024 12:19:11.068 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:19:11.068 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:19:11.069 # Error condition on socket for SYNC: Connection refused
29:C 05 Nov 2024 12:19:11.090 * DB saved on disk
29:C 05 Nov 2024 12:19:11.090 * Fork CoW for RDB: current 0 MB, peak 0 MB, average 0 MB
1:S 05 Nov 2024 12:19:11.169 * Background saving terminated with success
1:S 05 Nov 2024 12:19:11.884 * FAIL message received from ba36d5167ee6016c01296a4a0127716f8edf8290 () about     9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e ()
1:S 05 Nov 2024 12:19:11.884 # Cluster state changed: fail
1:S 05 Nov 2024 12:19:11.974 * Start of election delayed for 510 milliseconds (rank #0, offset 7225807).
1:S 05 Nov 2024 12:19:11.976 * Node d43f370a417d299b78bd1983792469fe5c39dcdf () reported node 9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e     () as not reachable.
1:S 05 Nov 2024 12:19:12.076 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:19:12.076 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:19:12.076 * Currently unable to failover: Waiting the delay before I can start a new failover.
1:S 05 Nov 2024 12:19:12.078 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:19:12.581 * Starting a failover election for epoch 15.
1:S 05 Nov 2024 12:19:12.616 * Currently unable to failover: Waiting for votes, but majority still not reached.
1:S 05 Nov 2024 12:19:12.616 * Needed quorum: 2. Number of votes received so far: 1
1:S 05 Nov 2024 12:19:12.616 * Failover election won: I'm the new primary.
1:S 05 Nov 2024 12:19:12.616 * configEpoch set to 15 after successful failover
1:M 05 Nov 2024 12:19:12.616 * Discarding previously cached primary state.
1:M 05 Nov 2024 12:19:12.616 * Setting secondary replication ID to c0b5b2df8a43b19a4d43d8f8b272a07139e0ca34, valid up to offset:     7225808. New replication ID is 029fcfbae0e3e4a1dccd73066043deba6140c699
1:M 05 Nov 2024 12:19:12.616 * Cluster state changed: ok
В течение этого периода времени 18 секунд мы видим, что запись в сегмент, принадлежащий удаленному модулу pod, завершается сбоем, а кластер Valkey выбирает новый первичный элемент. Задержка запроса возрастает до 60 мс в течение этого периода времени.
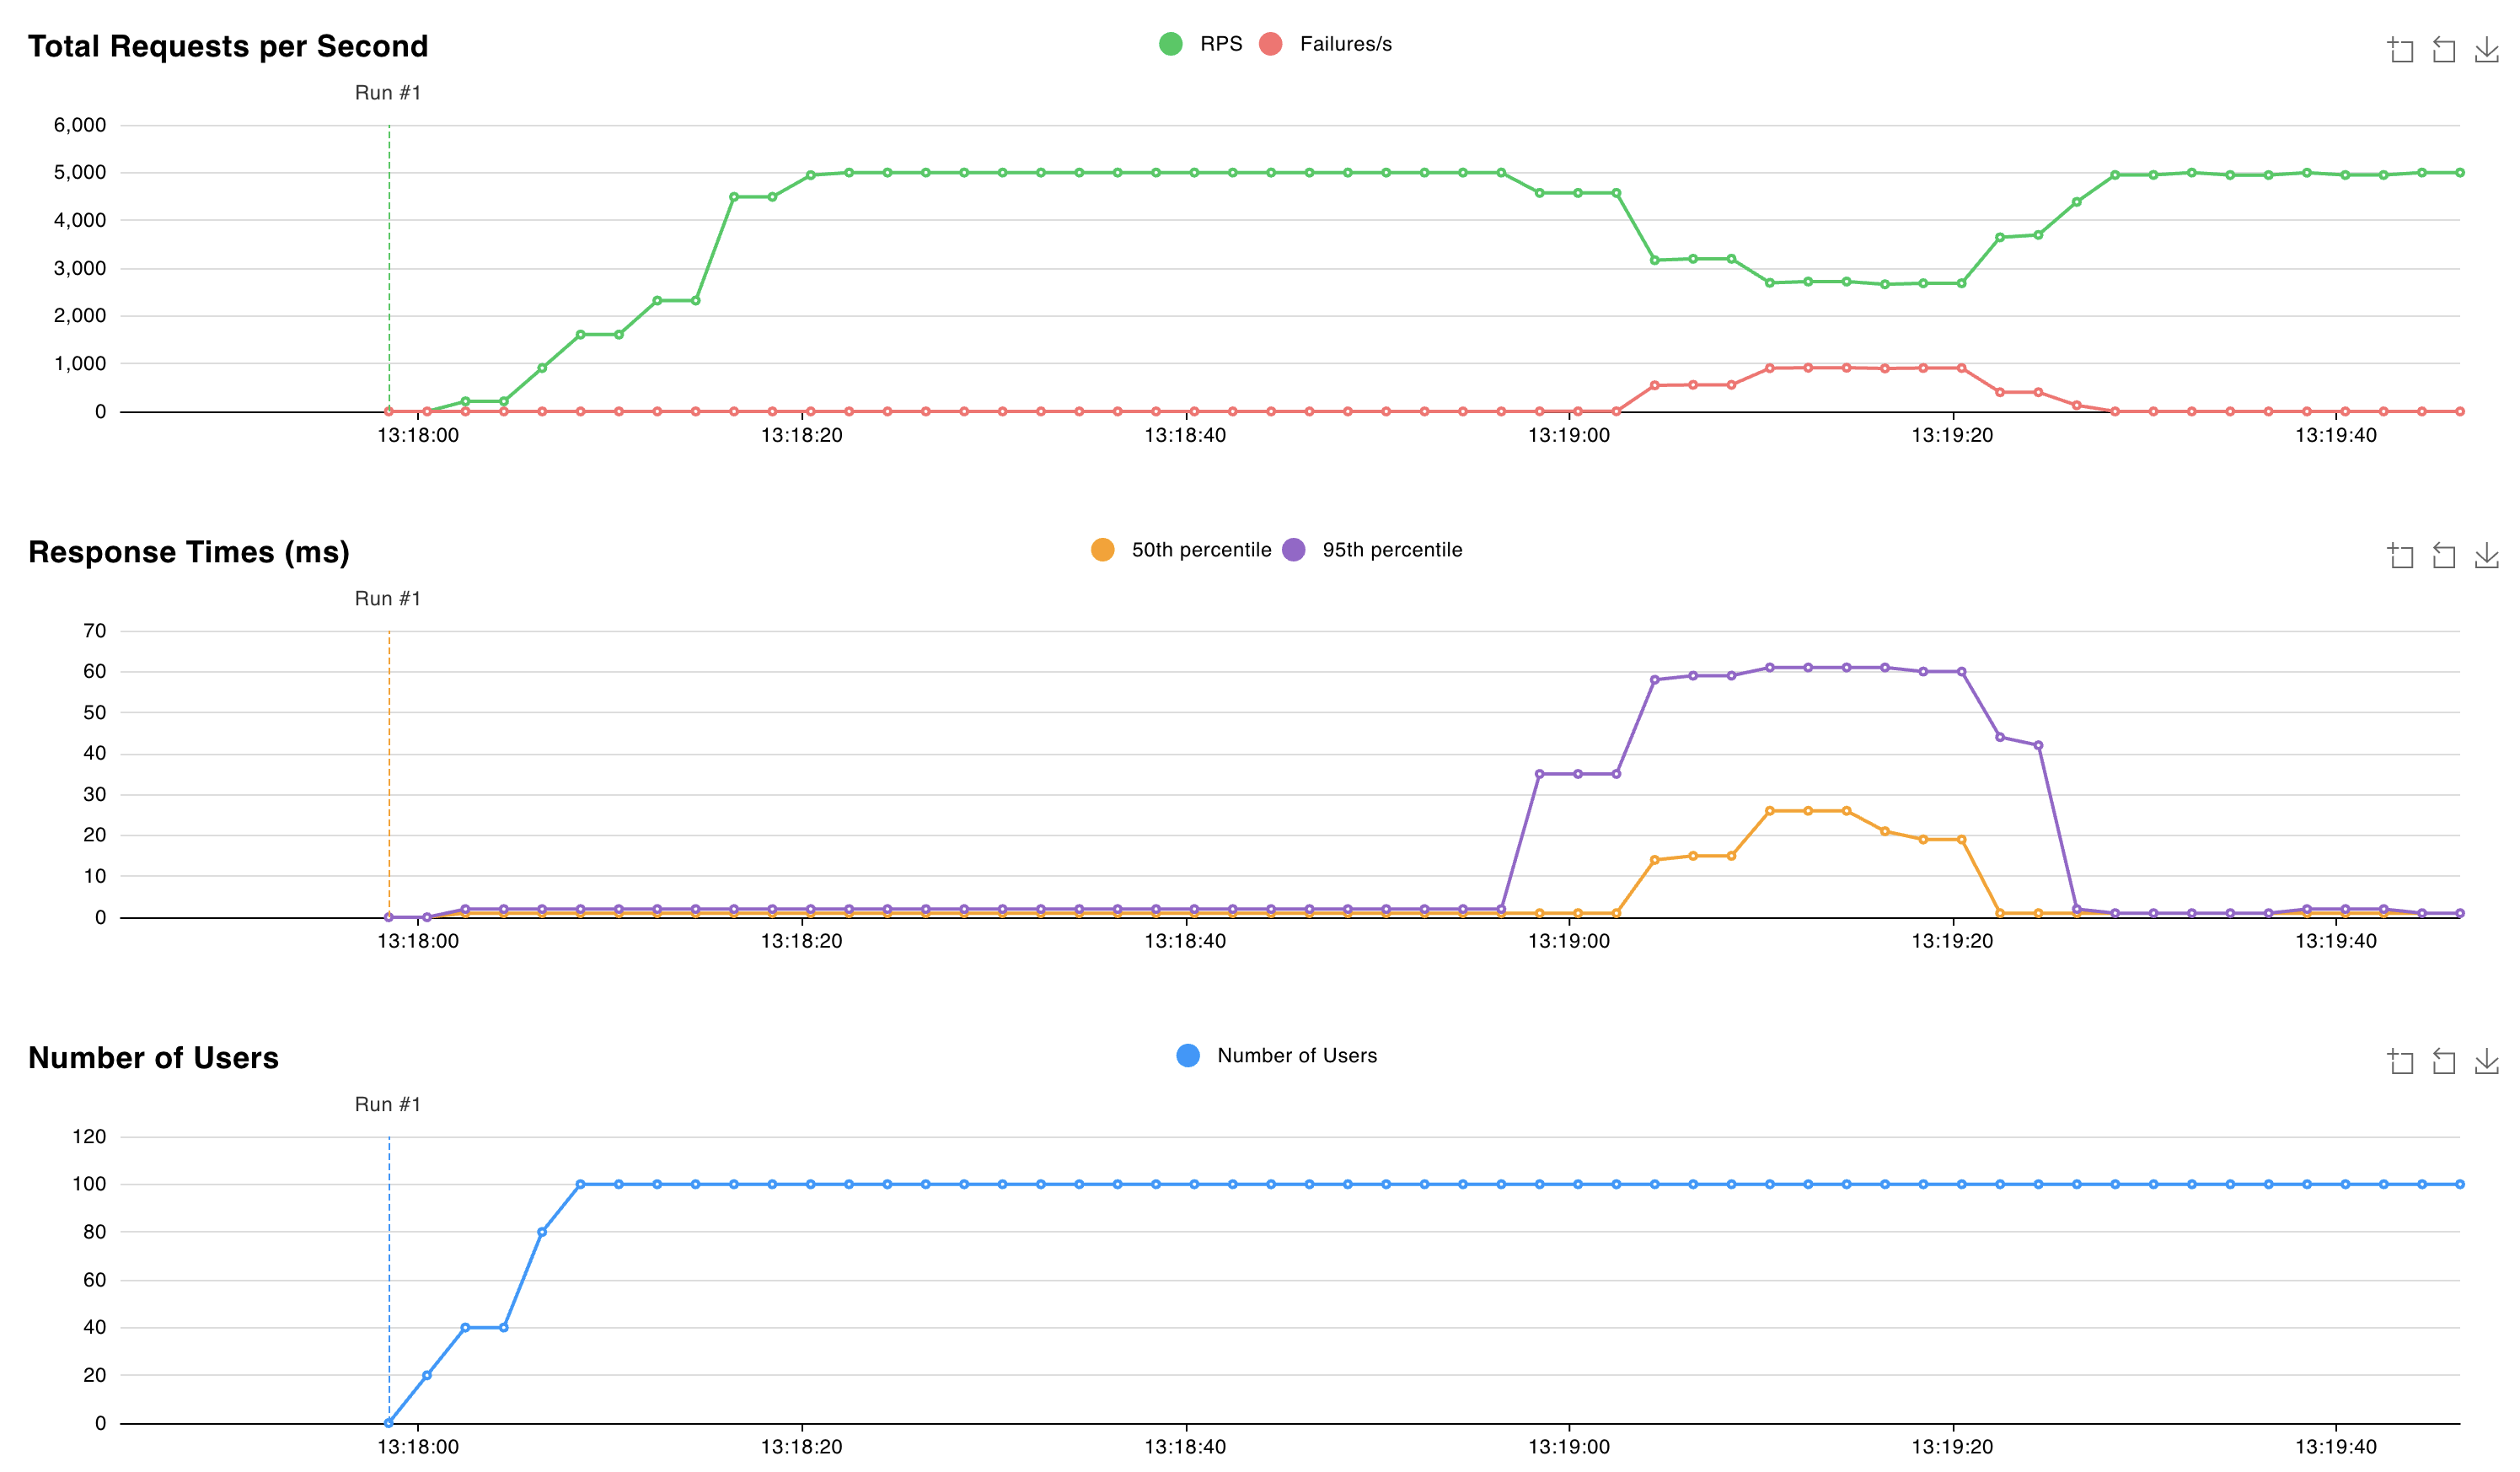
После выбора нового первичного кластера Valkey продолжает обслуживать запросы с задержкой около 2 мс.
Следующий шаг
Contributors
Корпорация Майкрософт поддерживает эту статью. Следующие участники первоначально написали:
- Nelly Kiboi | Инженер службы
- Saverio Proto | Главный инженер по работе с клиентами