Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Azure NetApp Files
Microsoft Fabric
Поиск с использованием ИИ Azure
Microsoft Foundry
Машинное обучение Azure
Идеи решения
В этой статье описывается идея решения. Это руководство может быть использовано облачным архитектором для визуализации основных компонентов типичной реализации этой архитектуры. Используйте эту статью в качестве отправной точки для разработки хорошо спроектированного решения, которое соответствует конкретным требованиям рабочей нагрузки.
Эта идея решения описывает, как REST API объектов Azure NetApp Files помогает организациям использовать существующие корпоративные данные файлов для аналитики и искусственного интеллекта без первого копирования в отдельное хранилище объектов. Приложения, совместимые с Amazon S3, могут поддерживать поиск документов и анализ с помощью ИИ, пока существующие рабочие процессы NFS и SMB продолжают получать доступ к этим данным. Если не создавать отдельную копию исходных данных, можно сократить время на подключение аналитических рабочих нагрузок, снизить избыточные затраты на хранение данных и устранить необходимость в конвейерах синхронизации, которые в противном случае командам пришлось бы создавать, контролировать и отлаживать. Меньше репозиториев исходных данных также означает меньше копий для управления и защиты. Этот подход поддерживает добавочную модернизацию, не требуя от организаций замены существующих приложений на основе файлов.
Architecture
Эта архитектура посвящена интеграции Microsoft Fabric с Azure NetApp Files через REST API объектов. На схеме также показан Azure Databricks в качестве альтернативного аналитического потребителя тех же данных Azure NetApp Files. Вам не нужно развертывать обе платформы. Существующие приложения продолжают получать доступ к данным через NFS или SMB, в зависимости от конфигурации тома и требований клиента.
Вычислительные ресурсы Azure Databricks получают доступ к конечной точке Object REST API Azure NetApp Files с помощью S3-совместимых запросов, используя коннектор Hadoop S3A. Этот альтернативный путь аналитики не использует локальный шлюз данных или Microsoft OneLake.
Последующие службы ИИ на схеме приведены в качестве примера. Их интеграция загрузки данных не отображается.
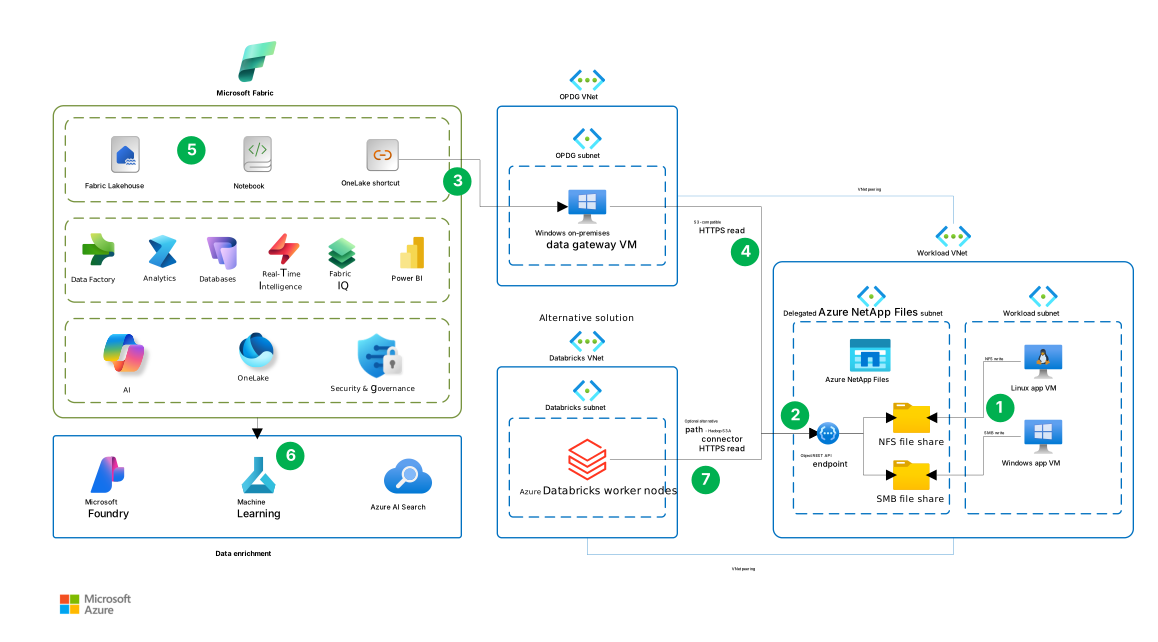
Скачайте файл Visio для этой архитектуры.
Поток данных
Следующие нумерованные взаимодействия описывают схему архитектуры. Шаги 1–5 описывают основной путь Microsoft Fabric. Шаг 6 представляет необязательное обогащение данных на последующих этапах. Шаг 7 — это альтернативный путь аналитики, а не продолжение потока Fabric. Стрелки, помеченные HTTPS read, отображают запросы к конечной точке REST API объекта; запрошенные данные возвращаются потребителю.
Приложения записывают данные в файл. В подсети рабочей нагрузки виртуальная машина приложения Linux записывает в общую папку NFS, а виртуальная машина приложения Windows записывает в общую папку SMB. Azure NetApp Files размещает обе общие папки в делегированной подсети.
REST API объекта предоставляет данные файла. Конечная точка в делегированной подсети ANF предоставляет S3-совместимый доступ к настроенным каталогам на томах Azure NetApp Files. Подключения от конечной точки к общим папкам NFS и SMB представляют доступ к существующим данным, а не копию в отдельное хранилище объектов.
Fabric обращается к данным с помощью ярлыка-ссылки OneLake. Ярлык ссылается на данные Azure NetApp Files через подключение, использующее виртуальную машину Windows с локальным шлюзом данных в подсети OPDG (локальный шлюз данных (on-premises data gateway)). Ярлык OneLake подключен к этому шлюзу.
Шлюз считывает данные из Object REST API. Шлюз использует пиринг между виртуальной сетью OPDG и виртуальной сетью рабочей нагрузки для достижения конечной точки. Путь чтения HTTPS, совместимый с S3, подключает шлюз к конечной точке, которая обращается к данным указанного файла для Fabric. Требования к подключению см. в разделе Подключение OneLake к тому Azure NetApp Files.
Fabric обрабатывает и анализирует данные. Поддерживаемые рабочие нагрузки Fabric используют данные с помощью ярлыка-ссылки. Например, ноутбуки считывают указанные файлы и записывают производные результаты в таблицы Lakehouse для анализа и отчетов Power BI. В блоке Fabric на схеме показаны эти возможности обработки и аналитики.
Необязательные последующие сервисы обогащают данные. Стрелка ниже Fabric приводит к группе обогащения данных, содержащей Microsoft Foundry, Машинное обучение Azure и Поиск с использованием ИИ Azure. Этот шаг представляет необязательную последующую обработку. На схеме не отображаются прием данных или оркестрация, необходимые для подключения этих служб, и ярлык OneLake не устанавливает эти интеграции.
Кроме того, Azure Databricks считывает данные файла напрямую. Рабочие узлы в подсети Databricks используют соединитель Hadoop S3A для отправки HTTPS-запросов на чтение в ту же конечную точку Object REST API через пиринговые виртуальные сети. Этот путь заменяет Fabric пути доступа и обработки в шагах 3–5. Он не проходит через локальный шлюз данных или OneLake.
Выберите расположение ярлыка в зависимости от того, как вы планируете использовать данные:
- Существующие совместимые таблицы Delta. Создайте ярлык таблицы в разделе таблиц Lakehouse, предназначенный для полной таблицы Delta, включая журнал транзакций. Fabric распознает целевой объект как таблицу, которую можно запрашивать через Spark и конечную точку аналитики SQL, а исходные данные остаются в Azure NetApp Files.
- Файлы для прямого доступа или обработки. Создайте ярлыки в разделе Files Lakehouse. Совместимые рабочие нагрузки могут считывать отдельные файлы Parquet, CSV и JSON, помимо документов, не копируя исходные файлы в OneLake. Если для нижестоящей аналитики требуются таблицы lakehouse, преобразуйте или загрузите исходные данные в производные таблицы Delta в OneLake.
Автономные файлы Parquet не являются автоматически разностными таблицами. Ярлык в файлах не регистрирует свой целевой объект в качестве таблицы автоматически. Дополнительные сведения см. в разделе «Где разместить ярлыки в Lakehouse».
Components
Следующие компоненты поддерживают архитектуру, ориентированную на Fabric, и необязательную альтернативу Azure Databricks.
Azure NetApp Files — это полностью управляемая служба хранения файлов, созданная на основе технологии NetApp. В этой архитектуре он хранит корпоративный набор данных и предоставляет объектный доступ, совместимый с NFS, SMB и S3, через REST API объекта. Он также предоставляет возможности моментального снимка и репликации.
Azure NetApp Files REST API объектов предоставляет существующие данные файлов через интерфейс, совместимый с S3. В этой архитектуре она позволяет совместимым приложениям аналитики и искусственного интеллекта получать доступ к данным, не создавая отдельную копию хранилища объектов. Интерфейс поддерживает подмножество операций Amazon S3. Убедитесь, что поддерживаемые операции соответствуют требованиям приложения перед выбором этой интеграции.
Microsoft Fabric — это платформа аналитики, которая объединяет перемещение данных, обработку данных, прием, преобразование, потоковую обработку с помощью Real-Time Intelligence и построение отчетов. В этой архитектуре она предоставляет платформу аналитики для обработки и анализа данных из Azure NetApp Files с помощью ярлыков OneLake.
OneLake — это унифицированное логическое озеро данных для Fabric. В этой архитектуре ярлыки OneLake делают данные Azure NetApp Files доступными для поддерживаемых рабочих нагрузок Fabric.
Azure Virtual Network обеспечивает частное подключение между ресурсами Azure в этой архитектуре. Пиринг между виртуальными сетями позволяет виртуальной машине шлюза и необязательным Azure Databricks вычислительным ресурсам достичь конечной точки REST API объекта Azure NetApp Files.
Локальный шлюз данных подключает ярлыки OneLake к конечной точке бакета Azure NetApp Files. Несмотря на его имя, в этой архитектуре шлюз работает в стандартном режиме на виртуальной машине Azure с поддерживаемой Windows операционной системой. Выберите образ, соответствующий требованиям к установке шлюза. Установка основных серверных компонентов и Windows контейнеров не поддерживается. Шлюз инициирует исходящие подключения через Azure Relay для взаимодействия с Fabric. Не требуются входящие подключения из Fabric. Настройте брандмауэр или прокси-сервер, чтобы разрешить исходящие конечные точки, описанные в разделе "Настройка параметров связи" для локального шлюза данных.
Azure Databricks — это необязательная альтернативная аналитическая платформа для рабочих нагрузок инженерии данных и машинного обучения. Его задания Spark используют соединитель Hadoop S3A, настроенный для конечной точки Object REST API для доступа к набору данных Azure NetApp Files вместо использования интеграции Fabric.
Alternatives
Эта архитектура включает несколько компонентов, которые можно заменить другими службами Azure или подходами в зависимости от функциональных и нефункциональных требований рабочей нагрузки. Рассмотрим следующие варианты и их компромиссы.
Storage
Учитывайте требования к протоколу приложений и измеряемую производительность при выборе между Хранилище BLOB-объектов Azure и Azure NetApp Files:
Выберите Хранилище BLOB-объектов, когда клиенты могут использовать REST API Хранилище BLOB-объектов или NFS 3.0 и не требуют SMB или NFS 4.1. Оба интерфейса могут получить доступ к одинаковым данным. Путь доступа Хранилище BLOB-объектов NFS 3.0 оптимизирован для высокопроизводительных последовательных рабочих нагрузок с высокой пропускной способностью, где пропускная способность имеет больше низкой задержки.
Выберите Azure NetApp Files, когда приложениям и аналитическим рабочим нагрузкам необходимо получить доступ к тем же файлам через SMB или NFS 4.1 и REST API объектов, совместимых с S3, или когда приложениям файлов требуется низкая задержка случайных операций ввода-вывода. Для данных, уже размещенных в Azure NetApp Files, Object REST API добавляет доступ к аналитике без переноса исходных приложений или данных.
Для любого из вариантов измеряйте сквозную задержку и пропускную способность при параллельной нагрузке со стороны исходного приложения и аналитики. Производительность NFS или SMB не отражает производительность REST API для объектов или Fabric, поэтому проверьте предполагаемый путь доступа на соответствие требованиям рабочей нагрузки. Сравните общие затраты, включая изменения приложений, миграцию и любые текущие дублирования и синхронизацию. Сведения о сравнении протоколов и рабочих нагрузок см. в разделе Сравнение служб хранилища Azure.
Integration
задания Azure Databricks могут использовать соединитель Hadoop S3A для чтения данных Azure NetApp Files через REST API объектов без OneLake или локального шлюза данных. Настройте доверие TLS и безопасно хранимые учетные данные и проверьте необходимые операции записи, прежде чем полагаться на обратную запись. Если вам нужны скрипты инициализации, используйте скрипты с областью действия кластера, хранящиеся в томах каталога Unity в поддерживаемых вычислительных ресурсах, следуя текущим рекомендациям Azure Databricks по скриптам инициализации.
Подробности сценария
Используйте этот шаблон, если тот же набор данных должен использоваться приложениями, ожидающими подключенную файловую систему, и службами аналитики или ИИ, которые ожидают интерфейс объекта, совместимый с S3.
Приложения, работающие на виртуальных машинах или в контейнерах, могут продолжать использовать Azure NetApp Files через NFS или SMB. Например, они могут использовать существующий код доступа к файлам, подключенные общие папки и структуры каталогов. REST API объекта Azure NetApp Files сопоставляет корневой каталог тома или подкаталог с бакетом, совместимым с S3, чтобы совместимые клиенты объектов могли получить доступ к тем же базовым файлам.
Этот подход полезен, когда требуется добавить средства аналитики или ИИ к существующим файловым рабочим нагрузкам без изменения исходных приложений для работы с объектным хранилищем. Последующие рабочие процессы по-прежнему могут при необходимости создавать производные данные, такие как преобразованные наборы данных, индексы, эмбеддинги и кэши.
Когда клиенты файлов и объектов получают доступ к одним и тем же данным, учитывайте различия в удостоверении, разрешениях, блокировке и требованиях к согласованности приложений. Определите, как производители сигнализируют о том, что формирование или передача файла или пакета завершена до его обработки потребителями объектов. Производители должны завершить запись и закрыть файлы, прежде чем подавать сигнал о готовности, а затем не изменять эти файлы, пока потребители их обрабатывают. Проверьте эту передачу управления на прерванные записи и повторные попытки обработки.
Модели идентификации и авторизации также отличаются между методами доступа. Исходные разрешения для каждого пользователя не автоматически переносятся в Fabric. Настройте разрешения Fabric для целевых потребителей и убедитесь, что удостоверение, используемое Object REST API, имеет доступ только к необходимым исходным данным. Дополнительные сведения см. в разделе Безопасность.
Сопоставляйте каталоги с отдельными корзинами, когда пользователям нужны разные уровни доступа. Классификация данных, их хранение, последующая авторизация и управление производными данными остаются в зоне ответственности рабочей нагрузки. Дополнительные сведения см. в разделе Создание бакета.
Потенциальные варианты использования
Эта архитектура может поддерживать рабочие нагрузки, которые должны анализировать структурированные или неструктурированные данные, уже хранящиеся в Azure NetApp Files. В следующих примерах показаны различные способы, которыми Fabric может использовать эти данные.
Обработка документов
Приложения могут сохранять документы, изображения или другие неструктурированные файлы в Azure NetApp Files по протоколу NFS или SMB. Блокнот Fabric может считывать готовые файлы с использованием ярлыка OneLake и отправлять их содержимое в службу обработки документов, например Azure Document Intelligence, для извлечения данных. Сохраните полученные структурированные данные в таблицах Lakehouse для проверки, анализа и подготовки отчетов.
Сведения об интеграции см. в разделе Интеграция Анализа документов с помощью SynapseML.
Аналитика данных
Приложения могут записывать структурированные данные, такие как файлы CSV или Parquet, в общий ресурс Azure NetApp Files. Блокноты Fabric могут читать готовые файлы с помощью ярлыка OneLake, объединять их с другими данными lakehouse и записывать производные результаты в таблицы lakehouse.
Этот шаблон может поддерживать такие сценарии, как инженерный анализ и анализ качества, анализ данных датчиков и операционные отчеты, не требуя от исходных приложений изменять способ хранения их файлов.
Для существующих совместимых наборов данных Delta создайте ярлык OneLake в разделе Tables lakehouse, указывающий на полную таблицу Delta, включая журнал транзакций. Fabric затем может распознать целевой объект как таблицу, а исходные данные при этом могут по-прежнему храниться в Azure NetApp Files. Дополнительные сведения см. в разделе "Где разместить ярлыки в lakehouse".
Поиск и извлечение с использованием ИИ
Документы, хранящиеся в Azure NetApp Files, также могут служить исходными данными для рабочих нагрузок ИИ. Например, конвейер обработки может читать документы через ярлык OneLake и использовать их для создания индекса Поиск с использованием ИИ Azure для генерации с дополнением поиском (RAG).
Индекс поиска и любые эмбеддинги являются производными данными и хранятся отдельно от исходных файлов. Разработайте процесс, который обеспечивает синхронизацию проиндексированного содержимого с обновлениями, переименованиями и удалениями в исходных данных. Кроме того, обеспечьте применение соответствующих элементов управления доступом при извлечении проиндексированного содержимого, так как исходные разрешения SMB и NFS автоматически не становятся пользовательскими разрешениями на поиск.
Тот же шаблон можно расширить на другие задачи ИИ. Например, записные книжки Fabric могут подготавливать наборы данных из исходных файлов и хранить подготовленные данные в OneLake для использования Машинное обучение Azure. Сведения о вариантах интеграции и ограничениях см. в разделе Integrate OneLake with Машинное обучение Azure.
Considerations
Эти рекомендации реализуют основные принципы платформы Azure Well-Architected Framework, которая представляет собой набор руководящих принципов, которые можно использовать для улучшения качества рабочей нагрузки. Для получения дополнительной информации см. Well-Architected Framework. Дополнительные рекомендации см. в рекомендациях Well-Architected Framework для Azure NetApp Files.
Reliability
Надежность помогает гарантировать, что ваше приложение может выполнять обязательства, которые вы выполняете для клиентов. Для получения дополнительной информации см. Контрольный список проверки конструкции на надежность.
Azure NetApp Files работает на отказоустойчивом парке физических серверов под управлением ONTAP и обеспечивает SLA высокой доступности. Для дополнительной защиты от сбоев в зоне доступности или в регионе можно при необходимости настроить межзонную или межрегиональную репликацию. Эта репликация является асинхронной и требует инициируемого клиентом переключения при отказе на целевой том. Выберите вариант репликации и расписание в соответствии с целями восстановления рабочей нагрузки. Дополнительные сведения см. в разделе Надежность Azure NetApp Files.
Совместное использование одного набора данных также делает доступность хранилища общей зависимостью для файловых приложений и аналитики. Эти возможности хранилища не обеспечивают сквозную доступность для шлюза, конвейера индексирования или приложений-потребителей. Согласуйте цели восстановления с полным рабочим процессом, включая шлюз, последующую обработку и производные данные.
Единственная виртуальная машина-шлюз — это единая точка отказа для пути интеграции Fabric. Для критически важных для бизнеса рабочих нагрузок разверните по крайней мере два члена шлюза на отдельных виртуальных машинах в кластере шлюза. Убедитесь, что каждый член может обращаться к конечной точке Object REST API и установить необходимые исходящие подключения. Проверьте поведение рабочей нагрузки, когда узел шлюза становится недоступным.
- Восстановление файлов и томов поддерживается с помощью мгновенных снимков на определённый момент времени, экономно использующих дисковое пространство. В Teams можно восстановить отдельный файл, откатить весь том или создать новый том из точки восстановления после случайного удаления, повреждения или неудачного процесса аналитики. Сведения о доступных операциях восстановления см. в защите данных на основе моментальных снимков в Azure NetApp Files.
Security
Безопасность обеспечивает гарантии от преднамеренного нападения и неправильного использования ценных данных и систем. Для получения дополнительных сведений см. контрольный список для проверки конструкции на безопасность.
Сохранение меньшего количества копий исходных данных может снизить количество репозиториев для защиты. Azure NetApp Files шифрует данные при хранении, а REST API объектов использует TLS для защиты данных при передаче. Разрешения доступа к файлам зависят от протокола:
Клиенты SMB и NFS продолжают использовать существующие модели проверки подлинности и авторизации. Существующие списки управления доступом NTFS (ACL), разрешения NFS и правила сопоставления идентификаторов продолжают действовать для этих клиентов.
Клиенты Object REST API проходят проверку подлинности с помощью ключа доступа S3. Разрешения бакета определяют, имеет ли клиент доступ только для чтения или для чтения и записи в сопоставленном каталоге. Запросы объектов не включают идентификационные данные отдельного пользователя SMB, NFS или нижестоящего пользователя. Azure NetApp Files выполняет каждую операцию объекта с использованием настроенной делегированной идентичности файловой системы бакета. Существующие разрешения файлов и списки управления доступом оцениваются только в отношении этого субъекта безопасности.
Идентификатор файловой системы, используемый для олицетворения, — это идентификатор пользователя (UID) и идентификатор группы (GID) для томов NFS или учетная запись пользователя для томов SMB. Тома с поддержкой двух протоколов используют тип идентификации, соответствующий настроенному для них стилю безопасности. Эта учетная запись определяет права доступа к файлам. Ключ доступа S3 проверяет подлинность клиента объектного хранилища. Дополнительные сведения см. в разделе Безопасность и разрешения REST API объекта.
Ярлык, совместимый с OneLake S3, проходит аутентификацию в бакете с помощью идентификатора ключа доступа и секретного ключа доступа. Исходные списки управления доступом NTFS, разрешения NFS и идентификаторы владельцев отдельных файлов не копируются в OneLake и не сопоставляются в нем. Пользователи Fabric авторизованы через OneLake и разрешения доступа Fabric. Они могут получать доступ только к содержимому, к которому ярлык предоставляет доступ через bucket и идентификатор олицетворяемой учетной записи, однако OneLake не обеспечивает соблюдение исходных разрешений на доступ к файлам для отдельных пользователей. OAuth на основе Microsoft Entra, субъекты-служб и RoleArn не поддерживаются для этого типа ярлыка.
Например, пользователь Fabric может читать документ через ярлык, даже если его личная учетная запись SMB не может напрямую прочитать его, если разрешения Fabric предоставляют доступ, а имперсонируемая идентичность бакета может прочитать документ. Перед предоставлением каталога убедитесь, что предполагаемая аудитория Fabric авторизована для доступа к его содержимому.
Настройте учетную запись, используемую для олицетворения бакета, только с теми исходными разрешениями, которые необходимы рабочей нагрузке. Ограничить доступ к ярлыку и lakehouse. Используйте процесс работы с сертификатами на основе Azure Key Vault и хранилище учетных данных для управления сертификатами TLS и ключами доступа S3. Определите и проверьте процедуру ротации, которая координирует изменения сертификатов и учетных данных с обновлениями для подключений Fabric и других потребителей. Создание новых учетных данных бакета немедленно делает существующую пару недействительной, поэтому учтите возможный перерыв в работе, пока вы обновляете потребителей, и проверьте доступ после ротации.
Если вы используете самоподписанный сертификат TLS, убедитесь, что каждый хост шлюза доверяет ему. Дополнительные сведения см. в разделе Предварительные требования к шлюзу OneLake.
Безопасность и соответствие требованиям зависят от конфигурации хранилища, доступа и нижестоящих служб. Включите последующую обработку и производные данные в область действия механизмов управления и соответствия требованиям. Требования, такие как GDPR и HIPAA, применяются ко всей рабочей нагрузке, если применимо. Дополнительные сведения см. в статьях Безопасность и разрешения REST API объектов и Создание ярлыка, совместимого с Amazon S3, в OneLake.
Оптимизация затрат
Оптимизация затрат фокусируется на способах сокращения ненужных расходов и повышения эффективности работы. Дополнительные сведения см. в разделе «Контрольный список проверки проектного решения для оптимизации затрат».
Избегая отдельной копии исходных данных, можно сократить затраты на избыточное хранение и синхронизацию. Сопоставьте эту экономию с затратами на емкость и производительность Azure NetApp Files, вычислительные ресурсы шлюза, емкость Fabric, а также последующую обработку и хранение.
В эту примерную оценку стоимости входят пул емкости Azure NetApp Files уровня Standard объемом 1 ТиБ, виртуальная машина Windows D8s_v5 для локального шлюза данных, два управляемых диска P10 емкостью 128 ГиБ, шлюз NAT с общедоступным IP-адресом и обработкой исходящего трафика, емкость Fabric F2 и 100 ГБ собственного хранилища OneLake.
Конфигурация с одним шлюзом не обеспечивает высокой доступности. Затраты на Optional AI Search, службы эмбеддингов и Azure Databricks не включены. Настройте ресурсы в соответствии с требованиями рабочей нагрузки к емкости, сети и доступности.
Доступ к холодным данным: Перемещайте неактивные блоки данных, включая данные снимков, в более дешевое хранилище, сохраняя доступ к файлам и объектам. Оцените плату за извлечение данных, задержку и изменения пропускной способности, характерные для конкретного уровня обслуживания, с учетом шаблона доступа рабочей нагрузки.
Уровни обслуживания и оптимальный размер: Выберите уровень обслуживания Azure NetApp Files, соответствующий требованиям к емкости и пропускной способности набора данных. Уровень обслуживания Гибкий позволяет выделять емкость пула и пропускную способность независимо. Просмотрите тарифицируемую емкость пула и пропускную способность по мере изменения спроса, чтобы избежать постоянного чрезмерного выделения ресурсов.
Операционная эффективность
Операционное совершенство охватывает операционные процессы, используемые для развертывания приложения и поддержания его работы в промышленной среде. Для получения дополнительной информации см. Контрольный список для оценки проектирования с точки зрения операционной эффективности.
Ярлыки OneLake снижают сложность эксплуатации, устраняя необходимость в конвейере, который поддерживает отдельную копию данных-источника для аналитики. Без отдельного конвейера копирования командам не нужно планировать задания копирования, восстанавливаться после сбоев передачи или согласовывать исходные и скопированные данные в рамках обычных операций.
Команды приложения-источника и аналитики должны координировать изменения и реагирование на инциденты для общего набора данных Azure NetApp Files. Назначение ответственности за мониторинг, сбои при обработке и управление учетными данными и сертификатами Object REST API.
Отслеживайте производительность хранилища, шлюза и Fabric для выявления ограничений и настройки емкости или пропускной способности:
Используйте Azure Monitor для отслеживания пропускной способности операций чтения и записи тома, IOPS чтения и записи, других IOPS, средней задержки чтения и записи, потребления емкости и индикатора достижения предельной пропускной способности. Настраивайте оповещения на устойчивое увеличение задержки, повторяющиеся ограничения QoS и пороговые значения использования емкости, а не на отдельные пики; метрики Azure NetApp Files агрегируются по интервалам, а задержка хранилища не включает каждый клиентский компонент REST.
Сопоставляйте метрики хранилища с клиентскими измерениями, такими как процентиль задержки запросов, размер объекта, параллелизм, повторные попытки, коды состояния HTTP, ЦП, память и пропускная способность сети. Это позволяет отличить ограничение пропускной способности тома от вычислительного клиента недостаточного размера, неэффективных параметров пакета SDK, затрат на небольшие объекты или сетевого расстояния.
Отслеживайте ЦП, память, доступное место на диске и пропускную способность сети для каждой виртуальной машины шлюза, а также ошибки шлюза и время завершения рабочей нагрузки. Настройте оповещения для длительной высокой нагрузки на ресурсы и нехватки места на диске, используя пороговые значения, установленные во время репрезентативных тестов рабочей нагрузки. Используйте журналы диагностики шлюза при устранении ошибок или медленном доступе. Отслеживайте виртуальную машину и сеть отдельно, так как диагностика шлюза не обеспечивает полное покрытие инфраструктуры.
Отслеживайте использование емкости Fabric и троттлинг с помощью приложения метрик емкости Fabric. Настройте уведомления об использовании ресурсов для ответственных администраторов. Сопоставляйте использование ресурсов емкости с показателями шлюза и хранилища, чтобы определить, возникают ли задержки при доступе к источнику или во время обработки в Fabric, прежде чем изменять емкость.
Эффективность работы
Эффективность производительности — это способность рабочей нагрузки эффективно масштабироваться в соответствии с требованиями пользователей. Для получения дополнительной информации см. контрольный список проверки проектного решения на эффективность производительности .
Azure NetApp Files может поддерживать как чувствительные к задержкам приложения NFS или SMB, так и аналитику, совместимую с S3, или потребителей ИИ, использующих один и тот же набор данных. Сохранение исходных данных на одном томе может исключить этап копирования, который в противном случае задержал бы индексирование, обучение или пакетную обработку, а также потреблять пропускную способность клиента, сети и хранилища назначения.
Задержка хранилища менее миллисекунды на поддерживаемых уровнях обслуживания Azure NetApp Files наиболее актуальна для рабочих нагрузок NFS и SMB. Это не гарантирует сквозную задержку для запросов к HTTPS Object REST API. Проведите тестирование пути доступа, совместимого с S3, с репрезентативными объектами и параллелизмом перед установкой цели задержки.
Размер хранилища: Подберите пропускную способность с учетом совокупной нагрузки файловых приложений и потребителей объектов. Автоматическое QoS связывает пропускную способность тома с квотой тома. Ручная настройка QoS позволяет отдельно выделять ресурсы в пределах бюджета пропускной способности пула. Проведите тестирование типичных рабочих нагрузок перед настройкой параметров производительности.
Выбор размера шлюза: Подберите размер виртуальных машин шлюза с учетом совокупных требований рабочих нагрузок, которые обращаются к Azure NetApp Files через ярлыки OneLake. Используйте рекомендации по выбору размера и масштабированию шлюза в качестве отправной точки. Проверьте правильность выбора конфигурации с использованием репрезентативных объемов данных и параллельного доступа с помощью ярлыков. Измеряйте ЦП шлюза, память и пропускную способность сети вместе со временем завершения рабочей нагрузки, чтобы определить, следует ли увеличивать ресурсы виртуальной машины или добавлять члены шлюза.
Подберите размер емкости Fabric: Подберите размер емкости Fabric для объединенной рабочей нагрузки обработки и отчетности, включая Power BI. Следуйте указаниям в Fabric capacity planning guide, чтобы оценить исходную вычислительную мощность, провести тестирование на репрезентативном пилотном проекте и скорректировать вычислительную мощность на основе измеренного использования и троттлинга.
Размещайте вычислительные ресурсы ближе к тому хранения, правильно подбирайте параметры сети клиента и тестируйте на реальной рабочей нагрузке. Увеличьте параллелизм и используйте подходящие большие запросы для последовательной аналитики, но ограничьте параллелизм при увеличении задержки или ошибок. Для NFS или SMB проверьте параметры монтирования, протокола и приложения. Для REST проверьте поддержку необходимых операций API клиента и проверьте повторное использование подключения, поведение отправки, повторные попытки и перечисление объектов.
Проверьте сквозную пропускную способность и задержку в условиях одновременной нагрузки и сбалансируйте нагрузку со стороны аналитики с требованиями к производительности приложения-источника.
Авторы
Ведение этой статьи осуществляет Microsoft. Следующие авторы написали эту статью.
Основные авторы:
- Дэн Джексон | Архитектор облачных решений, NetApp
- Энтони Машфорд | Архитектор облачных решений, NetApp
- Даниэль Сёдерхольм | Старший инженер по решениям, облачные платформы и ИИ, Microsoft
Другие участники:
- Хизер Гранди | Старший инженер по решениям для платформ данных, Microsoft
Чтобы увидеть непубличные профили в LinkedIn, войдите в LinkedIn.
Дальнейшие действия
- Общие сведения об Object REST API для Azure NetApp Files
- Подключение OneLake к тому Azure NetApp Files
- Скрипты инициализации в Azure Databricks
- Интеграция OneLake с Машинное обучение Azure