Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Azure Data Explorer (ADX) — это полностью управляемая платформа аналитики для анализа крупномасштабных данных телеметрии и журналов в реальном времени. В этой статье объясняется, как вычисляется стоимость за ГБ трафика в Azure Data Explorer, какие факторы влияют на эту стоимость, и как вы можете оптимизировать ваш кластер для повышения эффективности затрат. Платформы аналитики больших данных используют разные модели ценообразования. Многие платформы основывают цены на такие факторы, как том запросов, прием данных, длительность хранения и вычислительные ресурсы. Эта сложность затрудняет сравнение цен в разных продуктах.
Чтобы понять затраты на использование Azure Data Explorer, в этой статье используется метрика стоимость за ГБ данных. Эта метрика — это общая стоимость кластера (вычислительные ресурсы, хранение данных, сеть и разметка служб), разделенная на общее количество исходных данных исходного размера, принятых в течение этого периода.
Репрезентативный снимок кластеров ADX в июне 2025 г. используется для анализа примера. В следующих разделах показаны основные результаты анализа, объясните, что приводит к изменениям затрат и как пользователи могут оптимизировать затраты на прием в ГБ без ущерба для производительности.
Замечание
- Все данные о затратах в этой статье показывают прейскурантные цены и не включают скидки или экономию, связанную с обязательствами.
- Для этого примера анализа затраты на ГБ выражаются в примерах единиц затрат (SCUS), где каждый SCU представляет общую единицу затрат, например один процент США.
- Сведения о ценах на список и их вычислении см. в калькуляторе цен Azure Data Explorer.
Анализ стоимости за каждый загруженный ГБ
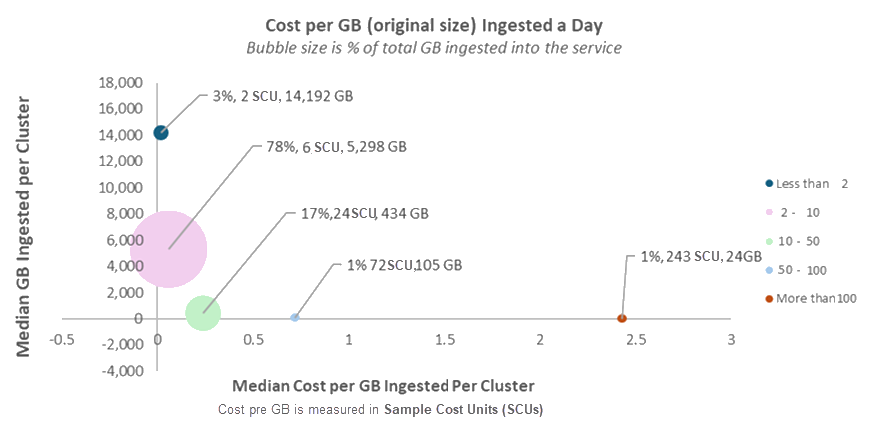
На приведенной ниже диаграмме показана медиана ежедневного объема данных (ГБ) в исходном размере (ось Y) по сравнению с медианной стоимостью за ГБ инжестации (ось X) для каждой группы затрат. Размер пузырька представляет собой долю данных, которую группа внесла в сервис.
Стоимость за ГБ данных различается в разных кластерах, но несколько закономерностей выделяются:
Большинство данных (>75%) поглощается по цене от 2 до 10 SCUs за ГБ (без учета скидок).
Менее 5% данных загружается со скоростью менее 2 SCU на ГБ.
Даже в той же категории использования (или "пузырь") наблюдается значительная вариация. Например, в крупнейшем пузырьке один кластер выполняет прием 2 единиц SCU на ГБ, а другой — 10 единиц SCU на ГБ. Это разница в 5X. В следующих разделах объясняется основные причины этого варианта.
Кластеры с более высокими затратами на ГБ являются менее распространенными и обычно имеют более низкие объемы приема. Как правило, меньшие объемы данных означают более высокую стоимость за ГБ.
Это важно
Диаграмма пузырьков показывает, что стоимость за ГБ приема варьируется в разных кластерах. Этот вариант не указывает на хорошие или плохие практики. Он отражает различные сценарии, конфигурации и шаблоны использования службы.
Например, один кластер может хранить данные дольше для соответствия требованиям, что повышает затраты на хранение. Другой может использовать политики обновления, обрабатывающие данные во время приема, что увеличивает использование вычислительных ресурсов. Эти сценарии являются преднамеренными вариантами проектирования, согласованными с конкретными целями, и они, естественно, влияют на затраты на ГБ.
Что определяет стоимость за ГБ при вводе данных
Эти ключевые факторы обуславливают различия в затратах на ГБ данных на кластер.
Длительность хранения: чем дольше хранится данные, тем выше стоимость. См. политику хранения.
Высокая загрузка ЦП: такие действия, как тяжелые запросы, обработка данных или преобразования, приводят к высокой загрузке ЦП.
Параметры кэша: кэширование большего объема данных повышает производительность, но может увеличить затраты. См. политику кэша.
Использование холодных данных: запросы, которые обращаются к холодным данным, инициируют транзакции чтения и увеличивают затраты. См. горячий и холодный кэш.
Преобразование и оптимизация данных: такие функции, как политики обновления, материализованные представления и секционирование используют ресурсы ЦП и могут повысить затраты. См. Политики обновления, Материализованные представления и Секции.
Объем приема: кластеры работают более экономично при более высоких объемах приема.
Стриминговая и очередная загрузка: Каждый из них имеет разный профиль затрат в зависимости от варианта использования. См. потоковую передачу и очередь.
Схема: широкие таблицы с большим количеством столбцов требуют больше вычислительных ресурсов и ресурсов хранилища, что повышает затраты.
Дополнительные возможности: такие параметры, как подписчики, частные конечные точки и песочницы Python, потребляют больше ресурсов и могут добавляться к затратам.
Выбор конвейера данных: некоторые пути приема данных обходятся дешевле. Например, прием Event Grid обычно дешевле, чем Event Hubs.
Автомасштабирование: кластеры без автомасштабирования часто стоят больше, потому что они не корректируют их размер на основе спроса.
Большинство этих факторов можно настроить для оптимизации производительности и затрат.
Более подробный взгляд на ключевые драйверы затрат
В этом разделе рассматриваются ключевые факторы, влияющие на затраты на 1 ГБ в Azure Data Explorer, предоставляющие аналитические сведения о том, как управлять и оптимизировать эти затраты.
Влияние хранения данных на затраты
В ADX все приемные данные хранятся в постоянном хранилище. Каждая таблица и материализованное представление имеют политику хранения , которая определяет, сколько времени хранятся данные. Чем дольше хранятся данные, тем выше стоимость на основе цен на службу хранилища Azure. Если требуется долгосрочное хранение, например для соответствия требованиям, стоимость за ГБ данных увеличивается, так как в неё включены постоянные расходы на хранение.
Помимо размера экстентов, сообщаемых кластером, существует два дополнительных драйвера затрат:
- Буфер хранения: дополнительный 7 дней данных хранится по умолчанию для защиты от случайной потери данных.
- Затраты на восстановление: для таблиц, в которых включен параметр возможности восстановления (по умолчанию), данные сохраняются в течение дополнительных 14 дней. Сюда входят промежуточные большие двоичные объекты, созданные во время операций слияния и перестроения.
Размер кластера
Размер кластера — это количество компьютеров (узлов) в кластере. Каждое устройство увеличивает стоимость в зависимости от типа (SKU). Автомасштабирование настраивает размер кластера на основе использования ЦП, поэтому система может оптимизировать затраты и производительность, избегая простоя или избыточных ресурсов.
Автомасштабирование настраивает размер кластера, чтобы обеспечить размещение кэшированных данных в пределах доступного пространства SSD. В результате большой кэш может увеличить размер кластера и, если загрузка ЦП низка, это может привести к более высокой стоимости за ГБ. См. вкладку "Кэш" и инструмент "Аналитика кластеров" для получения дополнительной информации об оптимизации размера кэша.
Кластеры, выполняющие множество запросов или выполняющие задачи с большим объемом ЦП, такие как материализованные представления, политики обновления или секционирование, могут масштабировать кластер, увеличивая затраты на ГБ. Обратите внимание, что эти функции могут значительно повысить производительность запросов и сократить использование ЦП запросов и, таким образом, повысить общую эффективность.
Объем приема данных
По мере роста кластера добавляются больше узлов, увеличивая общую стоимость. Эта стоимость распределяется по всем загруженным данным, поэтому чем больше данных вы загружаете, тем ниже затраты на ГБ.
Использование холодных данных
Когда запросы часто обращаются к холодным данным, хранящимся на диске, они вызывают транзакции чтения, использующие дополнительные ресурсы, и могут увеличить общую стоимость кластера.
Потоковая передача данных и буферизированный прием данных
Каждый метод приема имеет разные характеристики затрат, задержки и функциональности, поэтому каждый из них лучше подходит для различных сценариев. С точки зрения затрат, потоковая запись дешевле, когда вы передаете множество небольших таблиц с постадийным поступлением данных, тогда как очередная запись более экономична для больших таблиц.
Подсказка
Оптимизация затрат на гигабайт обработанных данных
Проверьте конфигурации ключевых драйверов затрат , чтобы убедиться, что они соответствуют потребностям кластера и требованиям к службам для повышения эффективности. В частности:
- Минимизируйте запросы к холодным данным для уменьшения числа транзакций чтения.
- Включите автомасштабирование для динамического сопоставления размера кластера с спросом.