Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Перенос рабочих нагрузок из классических вычислений в бессерверные вычисления. Бессерверные вычислительные ресурсы обрабатывают подготовку, масштабирование, обновление среды выполнения и автоматическую оптимизацию.
Большинство классических рабочих нагрузок могут переноситься с минимальными изменениями кода или без них. На этой странице основное внимание уделяется этим рабочим нагрузкам. Некоторые функции, такие как df.cache, пока не поддерживаются в бессерверной среде, но не будут требовать изменения кода после того, как они станут доступны. Для некоторых рабочих нагрузок, зависящих от записных книжек R или Scala, требуются классические вычисления и они не смогут быть перенесены на бессерверные решения. Полный список текущих ограничений см. в разделе об ограничениях бессерверных вычислений.
Выполните миграцию с помощью агента миграции
Important
Эта функция доступна в бета-версии. Администраторы рабочих пространств могут включить его на странице предпросмотра , включив в предпросмотр Compute Agent . См. статью "Управление предварительными версиями Azure Databricks".
Вы можете использовать агент миграции, чтобы перенести один блокнот или одну задачу на бессерверные вычисления. Агент проверяет среду рабочей нагрузки, библиотеки, конфигурации Spark, теги и код, затем предлагает каждое изменение как индивидуальное предложение для вас принять или отклонить. Принятые изменения применяются на месте и могут быть отменены.
Что агент проверяет и меняет
| Area | Что делает агент |
|---|---|
| Окружающая среда и библиотеки | Преобразует установки библиотек в спецификацию бессерверной среды, включая установки %pip, скрипты инициализации кластера, библиотеки кластера в заданиях и ссылки на закрытый индекс пакетов. |
| Переменные среды | Преобразует переменные среды кластера в их эквиваленты для бессерверной среды, сохраняя ссылки на секреты рабочего пространства и исключая значения, управляемые платформой. |
| Доступ к данным и хранению | Перезаписывает пути, несовместимые с бессерверными вычислениями, такие как пути к локальному диску, dbfs:/, и точки монтирования, в тома Unity Catalog. Агент автоматически применяет однозначные изменения и просит вас выбрать том, если целевой объект неоднозначен. |
| Конфигурации Spark | Классифицирует каждую конфигурацию Spark, комментирует конфигурации, которые безопасно выбросить, а также отмечает и удаляет конфигурации, которые serverless не поддерживает. Охватывает как конфигурации, подключённые к кластеру, так и конфигурации в ноутбуке. |
| Код рабочей нагрузки | Переписывает код, который не поддерживается в бессерверной среде, в совместимые аналоги, например заменяя операции RDD операциями DataFrame, и корректирует код с учётом поведения SQL в режиме ANSI в бессерверной среде. |
| Tags | Переводит пользовательские кластерные теги, такие как тег центра затрат, в их безсерверные аналоги. |
| Режим исполнения | Предлагает режим производительности, основанный на конфигурации кластера. См. раздел "Выбор режима производительности". |
Требования
Рекомендуется доступ к администратору рабочего пространства для обеспечения полной миграции. Это связано с тем, что агент также проверяет глобальные init-скрипты на уровне рабочего пространства за пределами целевой нагрузки. Возможно, вы сможете перейти, если у вас есть
CAN MANAGEразрешение на рабочую нагрузку, но без администраторских разрешений это может привести к отсутствию библиотек, настроек среды или тегов.Убедитесь, что у вас есть доступ к агенту. Введите
/computeв Genie Code./computeдолжно появиться в меню автозаполнения. Если он не отображается, администратор рабочего пространства должен включить предпросмотр в вашем рабочем пространстве.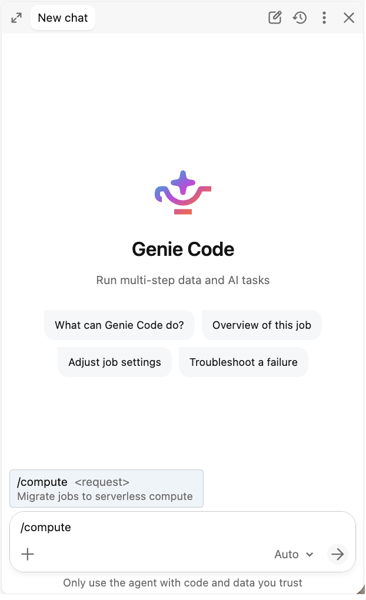
Перенести блокнот
- Откройте блокнот, который хотите перенести.
- Откройте Genie Code и запустите
/compute migrate to serverlessиз палитры/команд. - Изучите выводы агента. Агент сканирует окружение блокнота, библиотеки и код и предлагает изменение для каждого элемента, который в этом нуждается, например перенос установки библиотеки в спецификацию окружения или переписывание кодовой ячейки для выполнения в бессерверной среде.
- Принимайте или отвергайте каждое предлагаемое изменение.
- Примените те изменения, которые вы приняли. Их записывают непосредственно в блокнот.
- Подключите ноутбук к serverless и запустите его, чтобы убедиться, что он ведёт себя так, как вы ожидаете. См. Проверка миграционной рабочей нагрузки.
Перенести задание
- Откройте ту вакансию, которую хотите перевести.
- Откройте Genie Code и запустите
/compute migrate to serverlessиз палитры/команд. - Агент клонирует ваше задание и пытается перенести его в бессерверный режим.
- Изучите выводы агента. Для многозадачной задачи агент перечисляет каждую задачу и её конфигурацию кластера для каждой задачи, предлагая изменения для каждой задачи, сохраняя расписание задачи.
- Принять или отклонить каждое предлагаемое изменение во всех областях миграции: окружение и библиотеки, конфигурации Spark и любой код рабочих нагрузок, который необходимо изменить.
- Примените те изменения, которые вы приняли. Вычислительные ресурсы задания переведены на бессерверный режим.
- Запустите задание в бессерверной среде и подтвердите результаты. См. Проверка миграционной рабочей нагрузки.
- По желанию, в качестве последнего шага, агент повышает мигрированного клона. Он копирует конфигурацию клона и блокноты обратно на вашу исходную задачу (сохраняя тот же идентификатор работы, расписание и разрешения), затем удаляет клон. Если вы пропускаете повышение и сохраняете обе должности, остановите расписание на той вакансии, которую не выполняете, иначе тот же триггер сработает обе и может повторить записи или другие побочные эффекты.
Проверьте перенесённую рабочую нагрузку
Агент предлагает и вносит изменения, но не запускает вашу нагрузку и не проверяет её результат. Всегда запускайте мигрированную нагрузку в бессерверной среде и проверяйте результаты, прежде чем использовать её в работе, особенно если эта нагрузка записывает данные в производственные таблицы. Если агент предлагает изменение, которое выглядит неправильно, отклоните его и отправьте нам обратную связь, чтобы мы могли улучшить агента. См. Отправить отзыв о продукте.
Tip
Пока вы проверяете мигрированную нагрузку, запускайте её в режиме оптимизации производительности. Он запускается быстрее, чем в стандартном режиме, поэтому при подтверждении результатов вы получаете обратную связь быстрее. Переключитесь на режим, который лучше всего подходит для нагрузки, прежде чем запускать его в продакшене. См. раздел "Выбор режима производительности".
Когда агент находит что-то, что не может безопасно мигрировать, он сообщает о блокировщике и по умолчанию останавливается. Вы можете явно указать, чтобы система продолжила работу, несмотря на некоторые ограничения совместимости или зависимостей, но в этом случае вы принимаете риск того, что эти зависимости, отнесение затрат или поведение во время выполнения могут не сохраниться при переносе, и рабочая нагрузка может завершиться сбоем в бессерверной среде.
Отменить изменения миграции
Изменения, которые вносит агент, обратимы.
Для блокнота откройте его и восстановите версию непосредственно перед миграцией. См. историю версий в записных книжках Databricks.
Для работы, если вы не продвигали мигрированного клона, ваша исходная работа никогда не менялась: запускайте её как раньше и удаляете клон. Если вы продвигали клона, восстанавливайте из резервной копии, которую агент написал до внесения изменений:
- Откройте папку резервных копий в вашем рабочем пространстве:
/Workspace/Users/<your-username>/serverless-migration/backups/job-<job-id>/<timestamp>/. Агент показал этот путь во время миграции. Если есть несколько временных меток, выберите ту, что была непосредственно перед миграцией. - Откройте
job.yaml, где хранятся настройки задания до миграции, и снова примените их к тому же заданию с помощью запросаPOST /api/2.2/jobs/reset, который перезаписывает настройки задания указанными вами. Вы также можете вставить их в JSON-описание задания в интерфейсе. Это возвращает задачу к классическим вычислениям. - Open
mapping.yaml, где перечислены каждый резервный файл и исходный путь, откуда он пришёл. Копируйте каждый резервный файл обратно на исходный путь, чтобы отменить переписывание кода. - Запустите задачу, чтобы убедиться, что она ведёт себя так же, как до миграции.
Процесс миграции никогда не удаляет эту резервную копию. Задачи, которые агент не изменял, например задачи из Git, SQL или dbt, записываются в job.yaml, но их файлы не копируются в резервную копию, поэтому при необходимости восстановите их из основного источника данных.
Известные ограничения
- Следующие элементы указаны как блокирующие факторы: пользовательские образы, варианты ML Runtime, версии Databricks Runtime ниже 13, конфигурации Spark, которые нельзя безопасно игнорировать в serverless-среде, а также зависимости, такие как пакеты egg, JAR-файлы и библиотеки Maven. Блокировщик означает, что агент останавливается, а не мигрирует этот элемент. Вы можете либо решить это самостоятельно и запустить миграцию снова, либо всё равно попросить агента мигрировать, что оставит этот пункт нерешённым и может привести к сбою нагрузки в serverless.
- Агент читает init-скрипты, хранящиеся в файлах рабочего пространства или томах Unity Catalog. Скрипты инициализации, хранящиеся в ABFSS или DBFS, не удаётся прочитать, и они помечаются как блокирующие факторы.
- Агент не проверяет каждый классический вычислительный атрибут. Доставка журналов кластера и SSH-ключи не учитываются в модели, и хотя система обнаруживает многие зависимости от точек монтирования DBFS в коде рабочих нагрузок, она не перечисляет и не разрешает все точки монтирования.
- API для кэширования и контрольных точек, глобальные временные представления, вызовы управления монтированием DBFS, а также код на Scala или R по умолчанию считаются жёсткими ограничениями. Вы можете дать агенту команду продолжить, но неисправленная функциональность останется без изменений и может не работать в бессерверной среде.
- Работы с более чем 10 мигрируемыми задачами в настоящее время нельзя мигрировать.
- Агент мигрирует по одной рабочей нагрузке за раз. Нет общего процесса поиска информации, массовой миграции или одобрения администратором.
- Агент предлагает изменения и применяет те, что вы принимаете, но не выполняет вашу нагрузку и не проверяет корректность выхода. Проверьте перенесённую рабочую нагрузку, прежде чем использовать её для обработки производственных данных.
- Если источником истины для вашей рабочей нагрузки является Databricks Asset Bundle или папка Git, агент применяет изменения непосредственно к объекту рабочей области. Согласуйте эти изменения с вашим пакетом или репозиторием, чтобы при более позднем развертывании миграция не перезаписалась.
Перейти на бессерверную архитектуру вручную
Чтобы перенести рабочие нагрузки из классических вычислений в бессерверные вычисления, выполните следующие действия.
- Проверьте предварительные требования. Убедитесь, что доступ к рабочей области, сети и облачному хранилищу соответствует требованиям. См . статью "Перед началом работы".
- Обновление кода. Внесите необходимые изменения в код и конфигурацию. См. Обновите ваш код
- Проверьте нагрузки: убедитесь в совместимости и правильности перед переключением. См. статью "Тестирование рабочих нагрузок".
- Выберите режим производительности: выберите режим производительности, который лучше всего соответствует вашим требованиям к рабочей нагрузке. См. раздел "Выбор режима производительности".
- Переход по этапам: поэтапное развертывание бессерверных технологий, начиная с новых и с низким риском рабочих нагрузок. См. раздел "Миграция на этапах".
- Мониторинг затрат: отслеживание потребления бессерверных DBU и настройка оповещений. См. раздел "Мониторинг затрат".
Перед тем как начать
Перед началом миграции может потребоваться обновить устаревшие конфигурации в рабочей области.
| Предпосылка | Действие | Сведения |
|---|---|---|
| Рабочая область активирована для использования с каталогом Unity. | Миграция из хранилища метаданных Hive при необходимости | Обновление рабочей области Azure Databricks до каталога Unity |
| Настроено сетевое подключение | Замена пиринга VPC на NCCs, Приватный канал или правила брандмауэра | Сетевые взаимодействия в плоскости бессерверных вычислений |
| Доступ к облачному хранилищу | Замена устаревших шаблонов доступа к данным внешними расположениями каталога Unity | Подключение к облачному хранилищу объектов с помощью каталога Unity |
Убедитесь, что рабочая область находится в поддерживаемом регионе.
Обновление кода
В следующих разделах перечислены изменения кода и конфигурации, необходимые для обеспечения совместимости рабочих нагрузок с бессерверными.
Доступ к данным
Устаревшие шаблоны доступа к данным не поддерживаются без сервера. Обновите код, чтобы вместо этого использовать каталог Unity.
| Классический шаблон | Бессерверная замена | Сведения |
|---|---|---|
Пути DBFS (dbfs:/...) |
Тома каталога Unity | Что такое тома каталога Unity? |
| Таблицы хранилища метаданных Hive | Таблицы каталога Unity (или федерация HMS) | Обновление рабочей области Azure Databricks до каталога Unity |
| Данные для входа в аккаунт хранилища | Внешние расположения каталога Unity | Подключение к облачному хранилищу объектов с помощью каталога Unity |
| Пользовательские JDBC-JAR-файлы | Федерация Lakehouse | Что такое федерация запросов? |
Предупреждение
Доступ к DBFS ограничен в среде serverless. Перед миграцией обновите все пути dbfs:/ к томам Unity Catalog. Дополнительные сведения см. в разделе "Миграция файлов", хранящихся в DBFS.
Пример. Замена путей DBFS и ссылок на хранилище метаданных Hive
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
API и код
Некоторые API и шаблоны кода не поддерживаются на бессерверных серверах. Ознакомьтесь с этой таблицей, чтобы узнать, нужно ли обновить код.
| Классический шаблон | Бессерверная замена | Сведения |
|---|---|---|
RDD API (sc.parallelize, rdd.map) |
API кадра данных | Сравнение Spark Connect с классической версией Spark |
df.cache(), df.persist() |
Удалить вызовы кэширования | Ограничения бессерверных вычислений |
spark.sparkContext, sqlContext |
Использование spark (SparkSession) напрямую |
Сравнение Spark Connect с классической версией Spark |
Переменные Hive (${var}) |
SQL DECLARE VARIABLE или Python f-strings |
DECLARE VARIABLE |
| Неподдерживаемые конфигурации Spark | Удалите неподдерживаемые конфигурации. Бессерверная автоматическая настройка большинства параметров. | Настройка свойств Spark для бессерверных записных книжек и заданий |
Пример. Замена операций RDD кадрами данных
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
Пример. Замена SparkContext и кэширование
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")

# df.cache() → remove caching calls
# Materialize expensive intermediate results to Delta as a workaround:
df = spark.read.parquet(path)
result = df.filter("status = 'active'")
expensive_df.write.format("delta").mode("overwrite").saveAsTable("main.scratch.temp")
result = spark.table("main.scratch.temp")
Библиотеки и среды
Вы можете управлять библиотеками и средами на уровне рабочей области с помощью базовых сред и на уровне записной книжки с помощью бессерверной среды записной книжки.
| Классический шаблон | Бессерверная замена | Сведения |
|---|---|---|
| Инициализационные скрипты | Бессерверные среды | Настройка бессерверной среды |
| Библиотеки кластера | Библиотеки, привязанные к ноутбуку, или окружения | Настройка бессерверной среды |
| Библиотеки Maven/JAR | Поддержка задач JAR для заданий; PyPI для записных книжек | Операция JAR для заданий |
| Контейнеры Docker | Бессерверные среды для потребностей библиотеки | Настройка бессерверной среды |
Закрепление пакетов Python в requirements.txt для воспроизводимых сред. См. раздел Указание версий пакетов Python.
Стриминг
Рабочие нагрузки потоковой передачи поддерживаются без сервера, но некоторые триггеры не поддерживаются. Обновите код, чтобы использовать поддерживаемые триггеры.
| Триггер Spark | Поддерживается | Примечания |
|---|---|---|
Trigger.AvailableNow() |
Да | Рекомендуется |
Trigger.Once() |
Да | Это не рекомендуется. Вместо этого используйте Trigger.AvailableNow(). |
Trigger.ProcessingTime(interval) |
Нет | Возвращает INFINITE_STREAMING_TRIGGER_NOT_SUPPORTED. |
Trigger.Continuous(interval) |
Нет | Вместо этого используйте непрерывный режим конвейеров Lakeflow |
Значение по умолчанию (не задан параметр .trigger()) |
Нет | Опущение .trigger() переключает на ProcessingTime("0 seconds"), что не поддерживается в бессерверной архитектуре. Всегда устанавливайте .trigger(availableNow=True) явно. |
Для непрерывной потоковой передачи перейдите в декларативные конвейеры Spark в непрерывном режиме или используйте задания с непрерывным расписанием с AvailableNow. Для больших источников задайте maxFilesPerTrigger или maxBytesPerTrigger, чтобы предотвратить ошибки переполнения памяти.
Пример. Исправление триггеров потоковой передачи
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
Тестирование рабочих нагрузок
- Быстрый тест совместимости. Запустите рабочую нагрузку на классических вычислениях с помощью стандартного режима доступа и Databricks Runtime 14.3 или более поздней версии. Если выполнение выполнено успешно, рабочая нагрузка может перейти на бессерверный без изменений кода.
- Сравнение A/B (рекомендуется для рабочей среды): выполнение той же рабочей нагрузки на классической (контрольной группе) и бессерверной (экспериментальная группа). Выходные таблицы диффа и проверка правильности. Итерации до тех пор, пока не будут совпадать выходные данные.
- Временные конфигурации: во время тестирования можно временно задать поддерживаемые конфигурации Spark. Удалите их после стабилизации.
Выбор режима производительности
Бессерверные задания и конвейеры поддерживают два режима производительности: стандартный и оптимизированный для производительности. Выбранный режим производительности зависит от требований рабочей нагрузки.
| Режим | Availability | Запуск | лучше всего подходит для |
|---|---|---|---|
| Стандарт | Задания, конвейеры Lakeflow | 4–6 минут | Пакет, учитывающий затраты |
| Оптимизировано для производительности | Блокноты, задания, конвейеры Lakeflow | Секунды | Интерактивный, чувствительный к задержке |
Миграция на этапах
- Новые рабочие нагрузки: запуск всех новых записных книжек и заданий без сервера.
- Рабочие нагрузки с низким риском: переносите рабочие нагрузки PySpark/SQL, которые уже находятся в стандартном режиме доступа и используют Databricks Runtime версии 14.3 или выше.
- Сложные рабочие нагрузки: миграция рабочих нагрузок, требующих изменений кода (перезаписи RDD, обновления DBFS, исправления триггеров).
- Оставшиеся рабочие нагрузки: периодически пересматривайте их, по мере расширения возможностей.
Мониторинг затрат
Бессерверное выставление счетов основано на использовании DBU, а не на время простоя кластера. Проверьте соответствие ожиданий затрат с помощью типичных рабочих нагрузок перед масштабной миграцией. Средства и стратегии для мониторинга бессерверных затрат см. в статье "Мониторинг затрат на бессерверные вычисления".
Дополнительные ресурсы
- Рекомендации по бессерверным вычислениям: советы по оптимизации для бессерверных рабочих нагрузок
- Ограничения бессерверных вычислений: полный список текущих ограничений и неподдерживаемых функций
- Настройка бессерверной среды: управление библиотеками и зависимостями
- Поддерживаемые конфигурации Spark: конфигурации Spark, доступные на бессерверном сервере
- Spark Connect и классический Spark: различия поведения в бессерверной архитектуре
- Безсерверная сетевая безопасность: NCCs, Приватный канал и конфигурация брандмауэра
- Заметки о выпуске бессерверных вычислений: Отслеживайте новые возможности по мере их выпуска
- Руководство по обновлению каталога Unity. Миграция из хранилища метаданных Hive в каталог Unity
Дополнительные сведения см. в следующих записях блога:
- Что такое бессерверные вычисления?: Обзор бессерверных возможностей и результатов клиентов
- Эволюция инженерии данных: как бессерверные вычисления преобразуют записные книжки и задания Lakeflow: как бессерверные технологии обеспечивают задания и конвейеры Lakeflow