Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Адаптивное выполнение запросов (AQE) — это оптимизация запросов, которая возникает во время выполнения запроса.
Перед запуском запроса оптимизатор выбирает план запроса на основе оценок размера данных. Эти оценки могут быть ошибочными, если статистика таблицы отсутствует или устарела, если данные искажены, либо для последующих этапов сложного запроса. План, построенный на ошибочных оценках, может использовать медленную стратегию join, создавать слишком много мелких задач после shuffle или создавать несколько слишком больших задач, которые задерживают всю стадию. AQE решает эти проблемы, переоптимизируя план во время выполнения запроса, исходя из фактического размера данных.
В конце каждой перетасовки или широковещательного обмена Azure Databricks предоставляет точную статистику по данным, созданным к этому моменту. AQE использует эти статистические данные для выбора лучшей физической стратегии, оптимального количества и размера разделов после перетасовки, либо для применения оптимизаций, требующих подсказок к запросу, например, обработку перекошенных соединений.
AQE включен по умолчанию. Вам не нужно менять свои запросы, чтобы получить от этого пользу. Проверьте, изменил ли AQE план запроса при устранении неполадок с медленным запросом. Настраивайте настройки AQE только тогда, когда настройки по умолчанию не подходят под вашу нагрузку. См. Планы запросов и Конфигурация.
Возможности
AQE имеет четыре основные функции:
- Динамически изменяет сортировку слиянием на вещательное хеш-соединение.
- Динамически объединяет разделы (объединение небольших разделов в разделы достаточного размера) после обмена при перемешивании. Очень небольшие задачи имеют хуже пропускной способности ввода-вывода и, как правило, страдают больше от планирования затрат и затрат на настройку задач. Объединение небольших задач экономит ресурсы и повышает пропускную способность кластера.
- Динамически обрабатывает перекос при соединении сортировочного слияния и перетасовке при хэш-соединении путем разделения (и репликации при необходимости) перекошенных задач на задачи примерно равного размера.
- Динамически обнаруживает и распространяет пустые отношения, которые являются частями запроса, не возвращающими ни одной строки.
Поддерживаемые запросы
AQE применяется к запросам, соответствующим обоим этим условиям:
- Запрос не является стриминговым запросом.
- Запрос содержит как минимум один оператор Exchange (обычно из соединения, агрегата или окна), как минимум один подзапрос или оба.
AQE переоптимизирует все поддерживаемые запросы, но результат может быть тем же планом, который оптимизатор скомпилировал до запуска запроса. Чтобы проверить, изменил ли AQE план запроса, см. раздел «Планы запроса».
Планы запросов
Запросы, примененные к AQE, содержат один или несколько узлов AdaptiveSparkPlan, которые обычно выступают в роли корневого узла каждого основного или вложенного запроса. У каждого AdaptiveSparkPlan узла есть свой isFinalPlan флаг. Флаг имеет значение false до и во время выполнения запроса и меняется на true по завершении запроса.
Чтобы просмотреть план запроса, используйте интерфейс Spark, DataFrame.explain()или SQL EXPLAIN. Каждый из них показывает разную информацию о том, как AQE меняет план.
Пользовательский интерфейс Spark
Диаграмма плана запроса в интерфейсе Spark показывает самый актуальный план и обновляется по мере выполнения запроса. Узлы, которые уже были запущены и имеют метрики, не меняются. Узлы, которые ещё не запущены, могут измениться по мере переоптимизации плана AQE.
В этом примере показана диаграмма плана запроса:
схема плана запросов 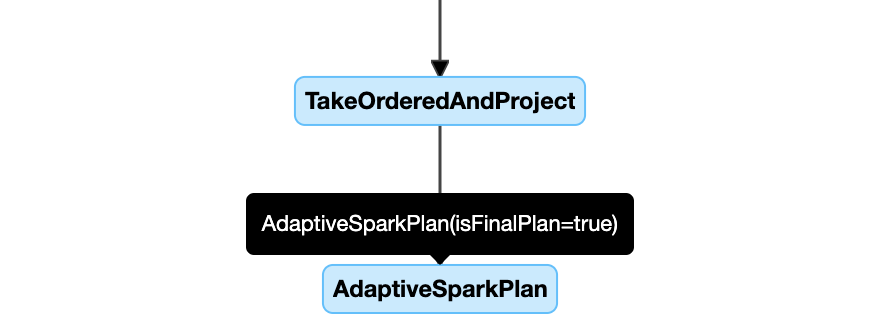
DataFrame.explain()
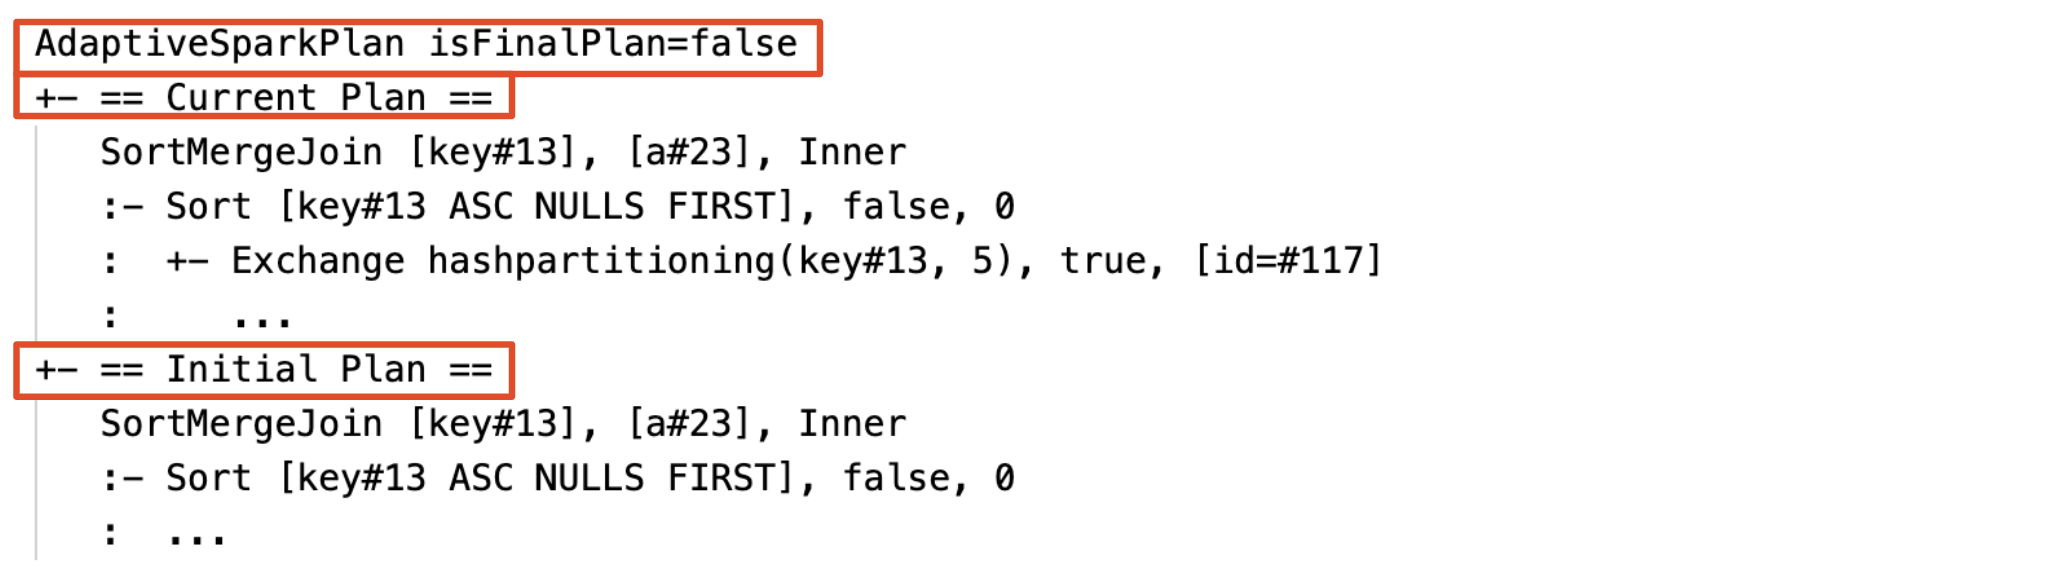
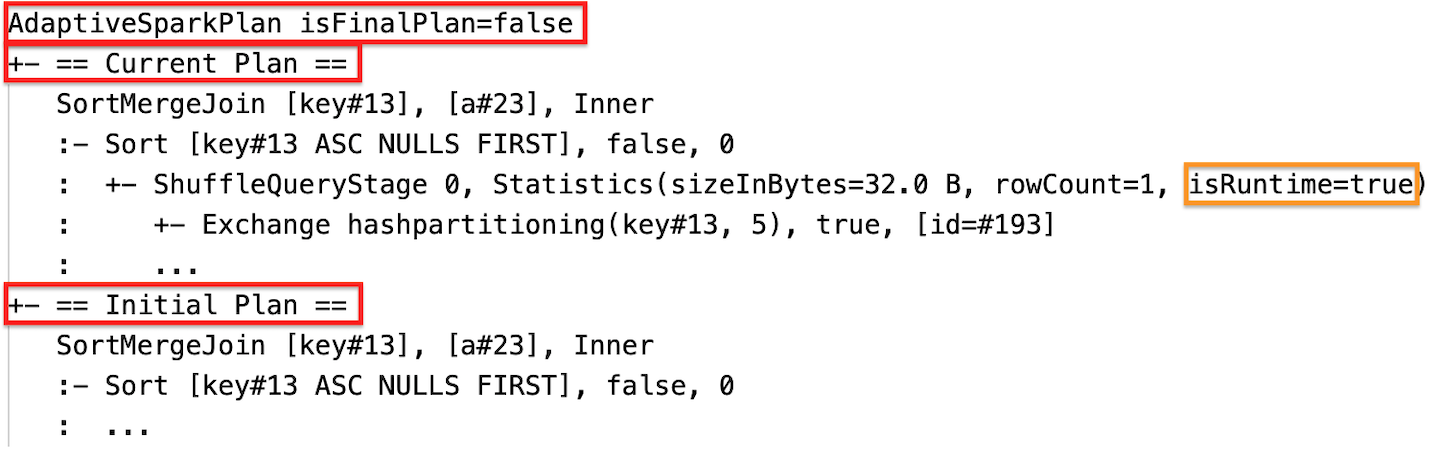
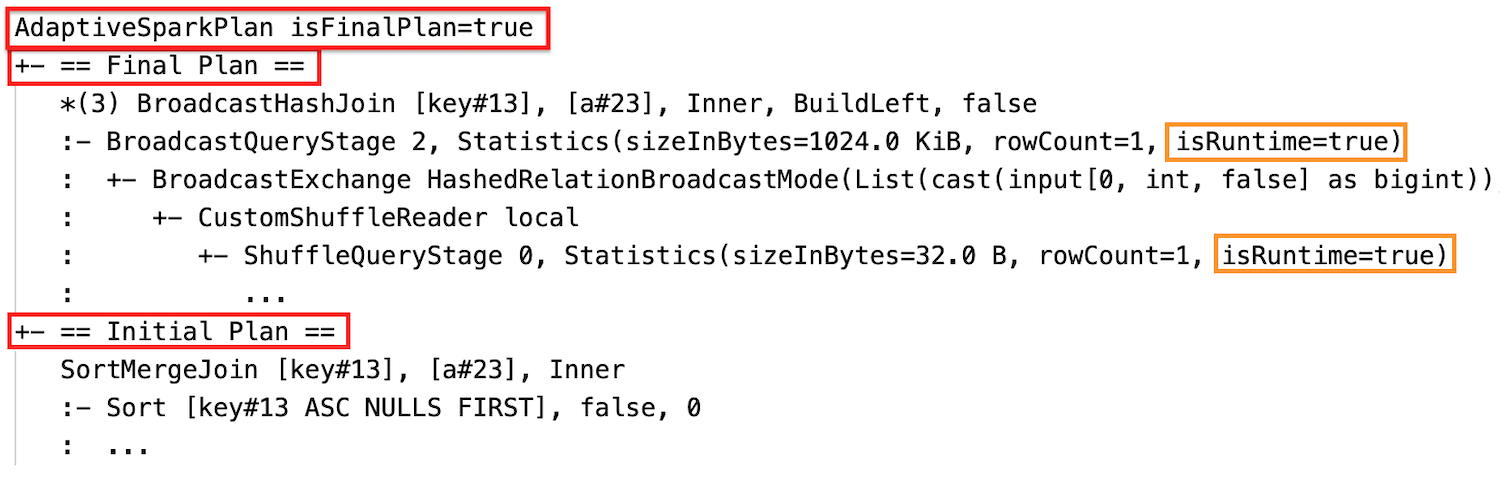
DataFrame.explain() показывает два плана под каждым AdaptiveSparkPlan узлом: начальный план, до того как AQE применит какие-либо оптимизации, и текущий план. Текущий план меняется по мере выполнения запроса и становится окончательным планом после завершения запроса.
Выход включает статистику данных для каждого этапа перетасовки и широковещательной передачи. Статистика зависит от того, прошёл ли этап:
- До и во время выполнения этапа
isRuntime— этоfalse, а статистика представляет собой приблизительные оценки времени компиляции. Например:Statistics(sizeInBytes=1024.0 KiB, rowCount=4, isRuntime=false). - После запуска этапа
isRuntimeимеет статусtrue, и статистика является измерениями времени выполнения. Например:Statistics(sizeInBytes=658.1 KiB, rowCount=2.81E+4, isRuntime=true).
Эти скриншоты показывают DataFrame.explain() вывод до, во время и после выполнения:
Перед выполнением
Во время выполнения
После выполнения
SQL EXPLAIN
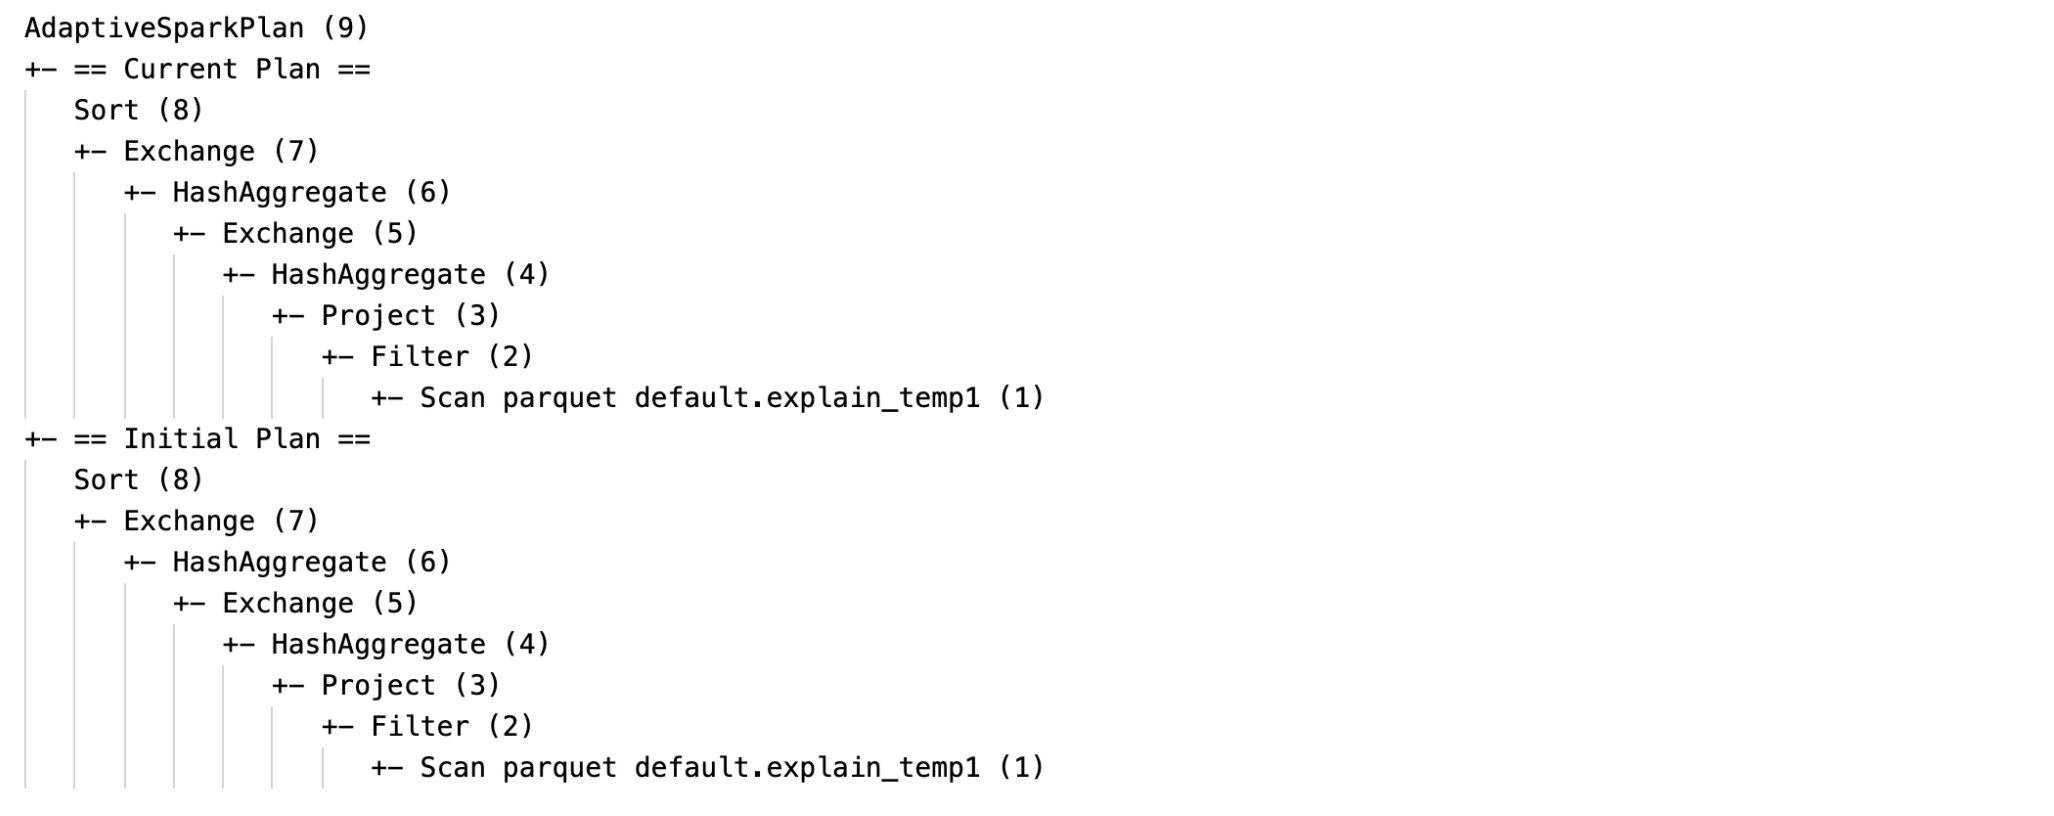
SQL EXPLAIN не запускает запрос, поэтому AQE не может его переоптимизировать. Вывод показывает только первоначальный план, который может отличаться от плана, который выполняет AQE.
В этом примере показаны SQL EXPLAIN выходные данные:
Определите применённые оптимизации в плане запроса
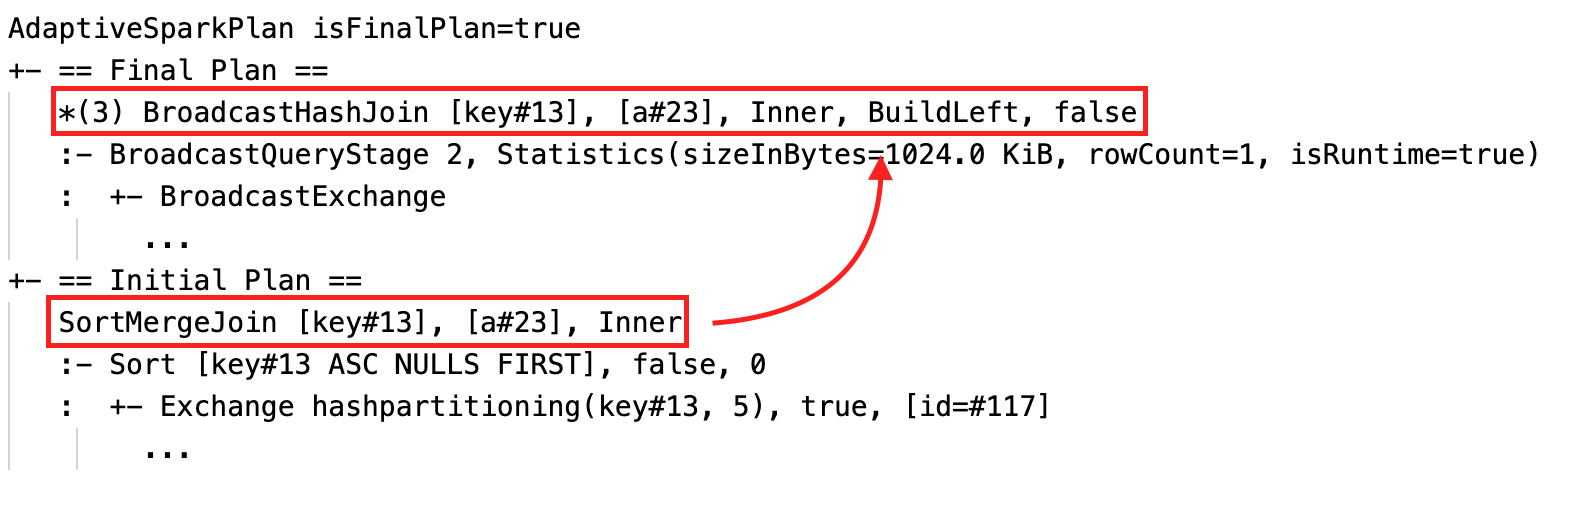
Когда AQE применяет оптимизацию, план запроса меняется. Чтобы определить, какие оптимизации вступили в силу, сравните текущий или окончательный план с первоначальным. Каждая оптимизация меняет план определённым образом:
Изменение стратегии объединения Текущий или окончательный план имеет физический узел соединения, отличный от узла в первоначальном плане.
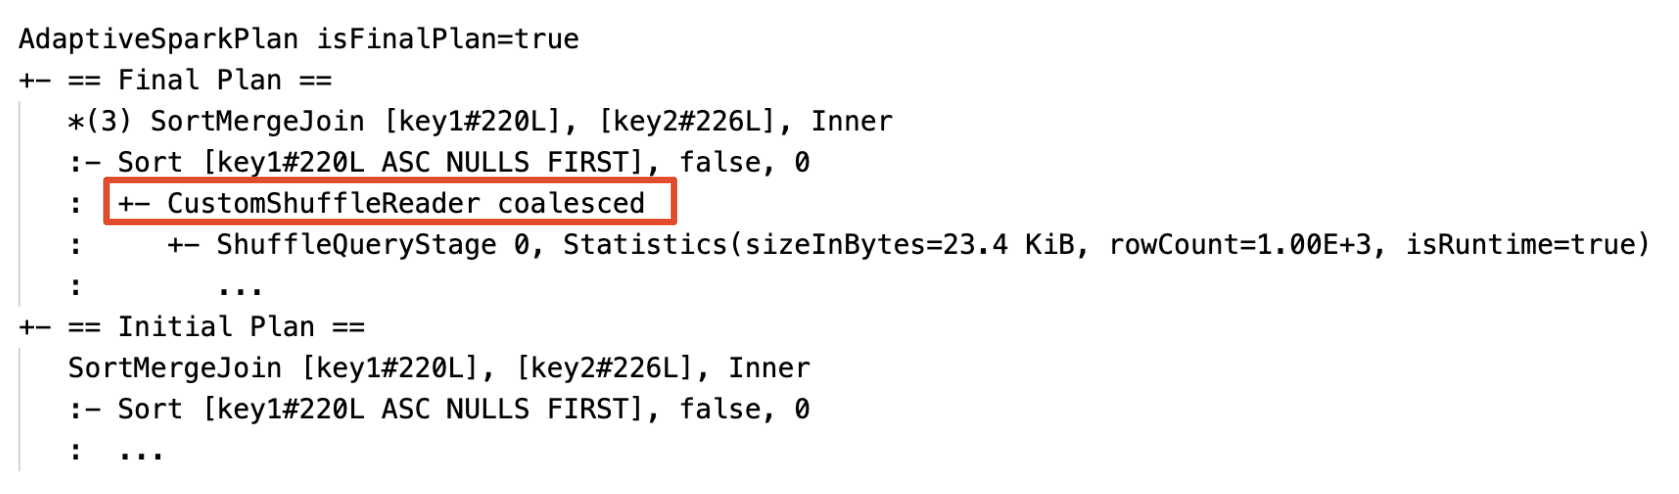
Объединение разделов План содержит узел
CustomShuffleReaderсо свойствомCoalesced.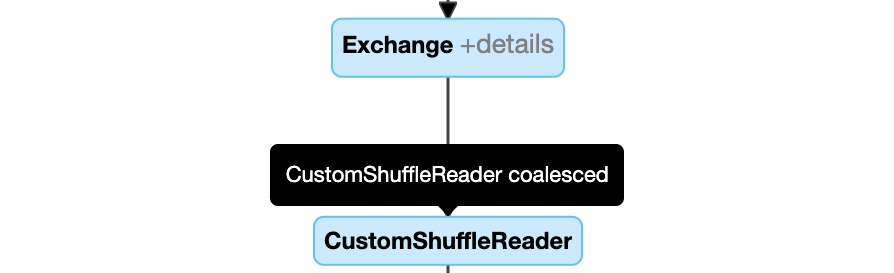
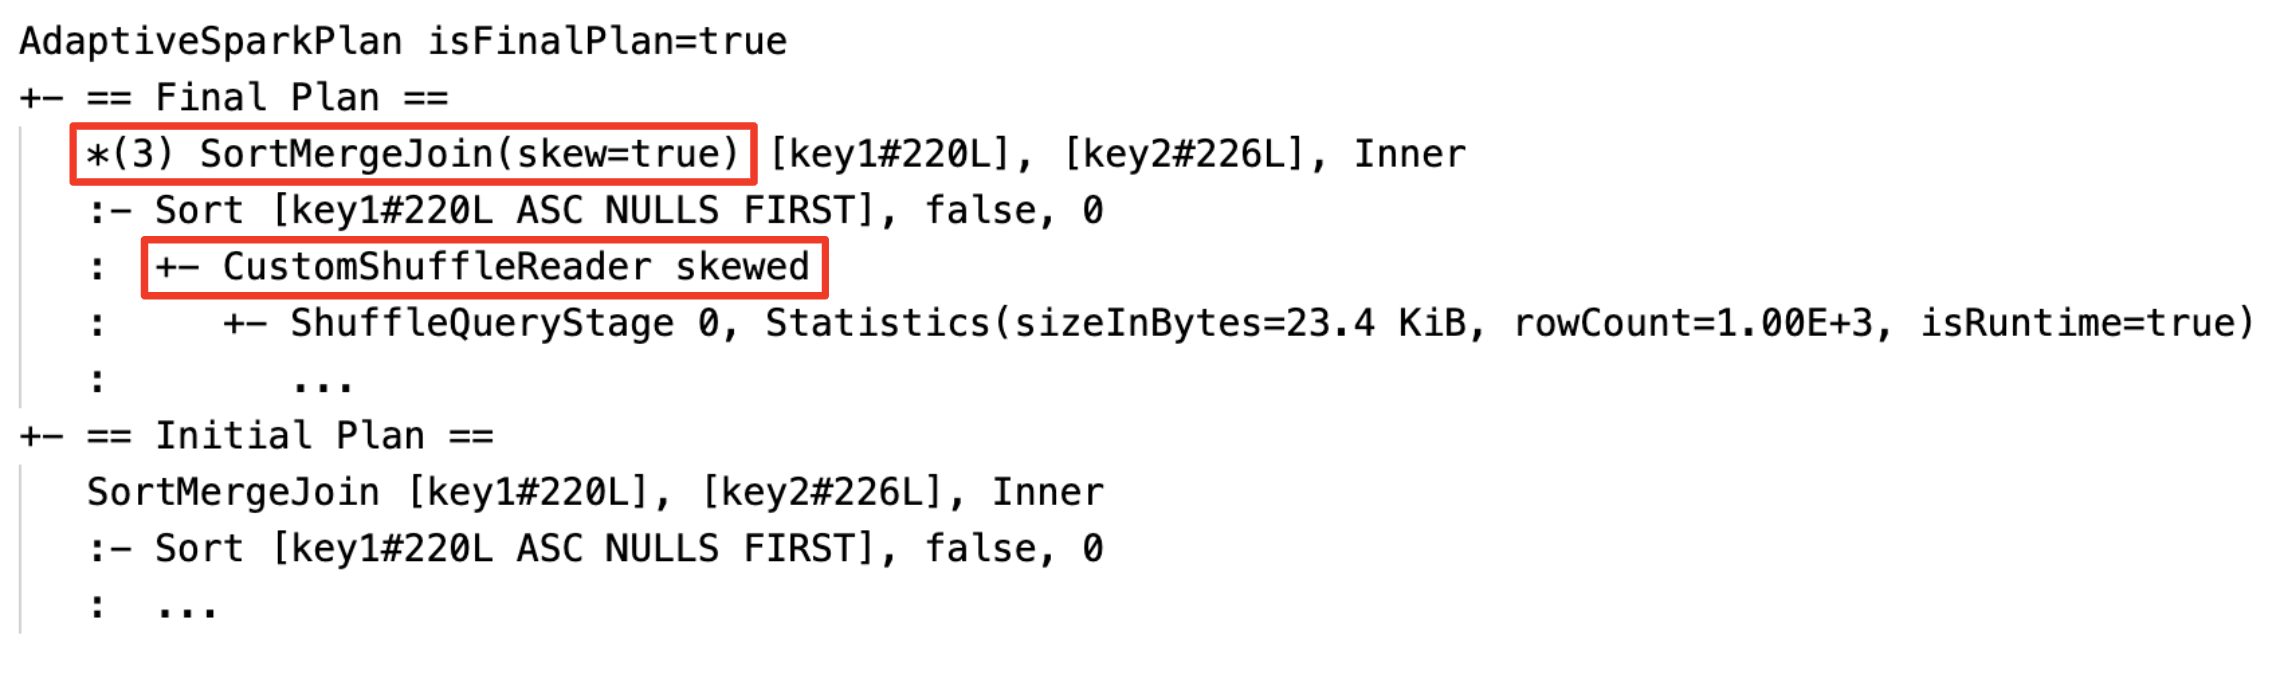
Обработка skew join. План содержит
SortMergeJoinузел сisSkewполем, установленным вtrue.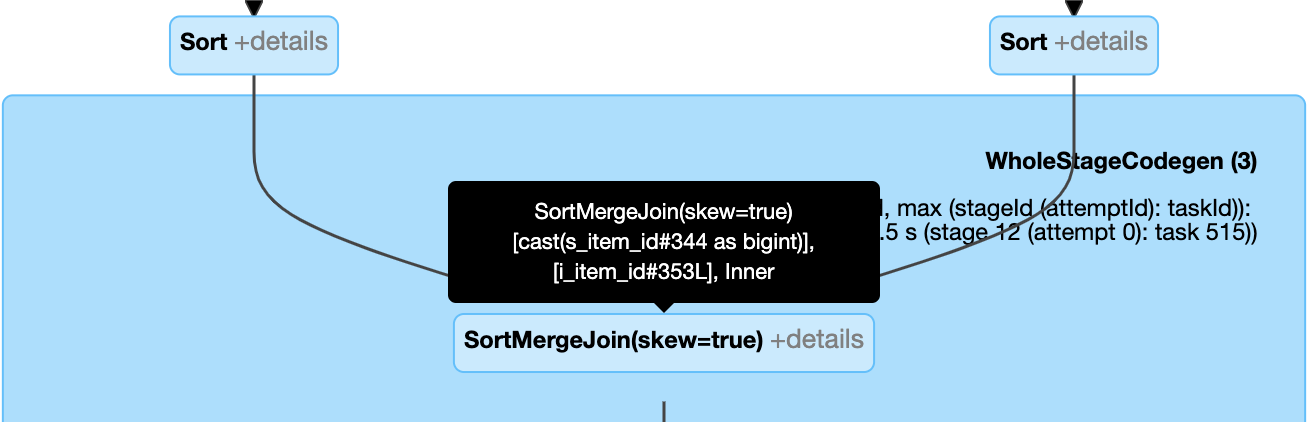
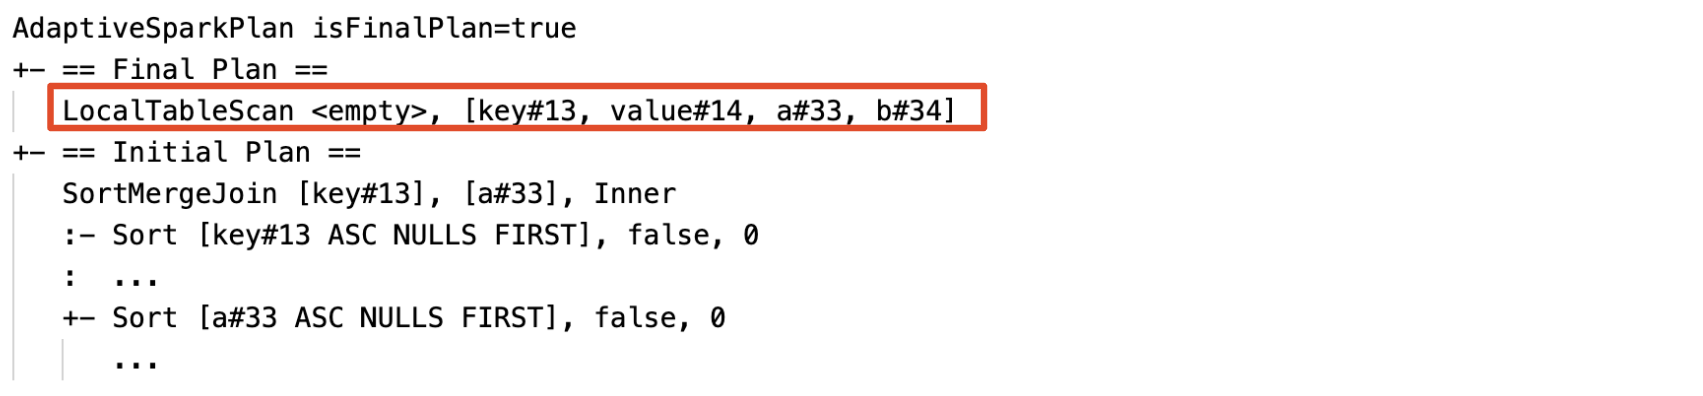
Распространение пустой связи.
LocalTableScanУзел с пустым полем отношений заменяет часть или весь план.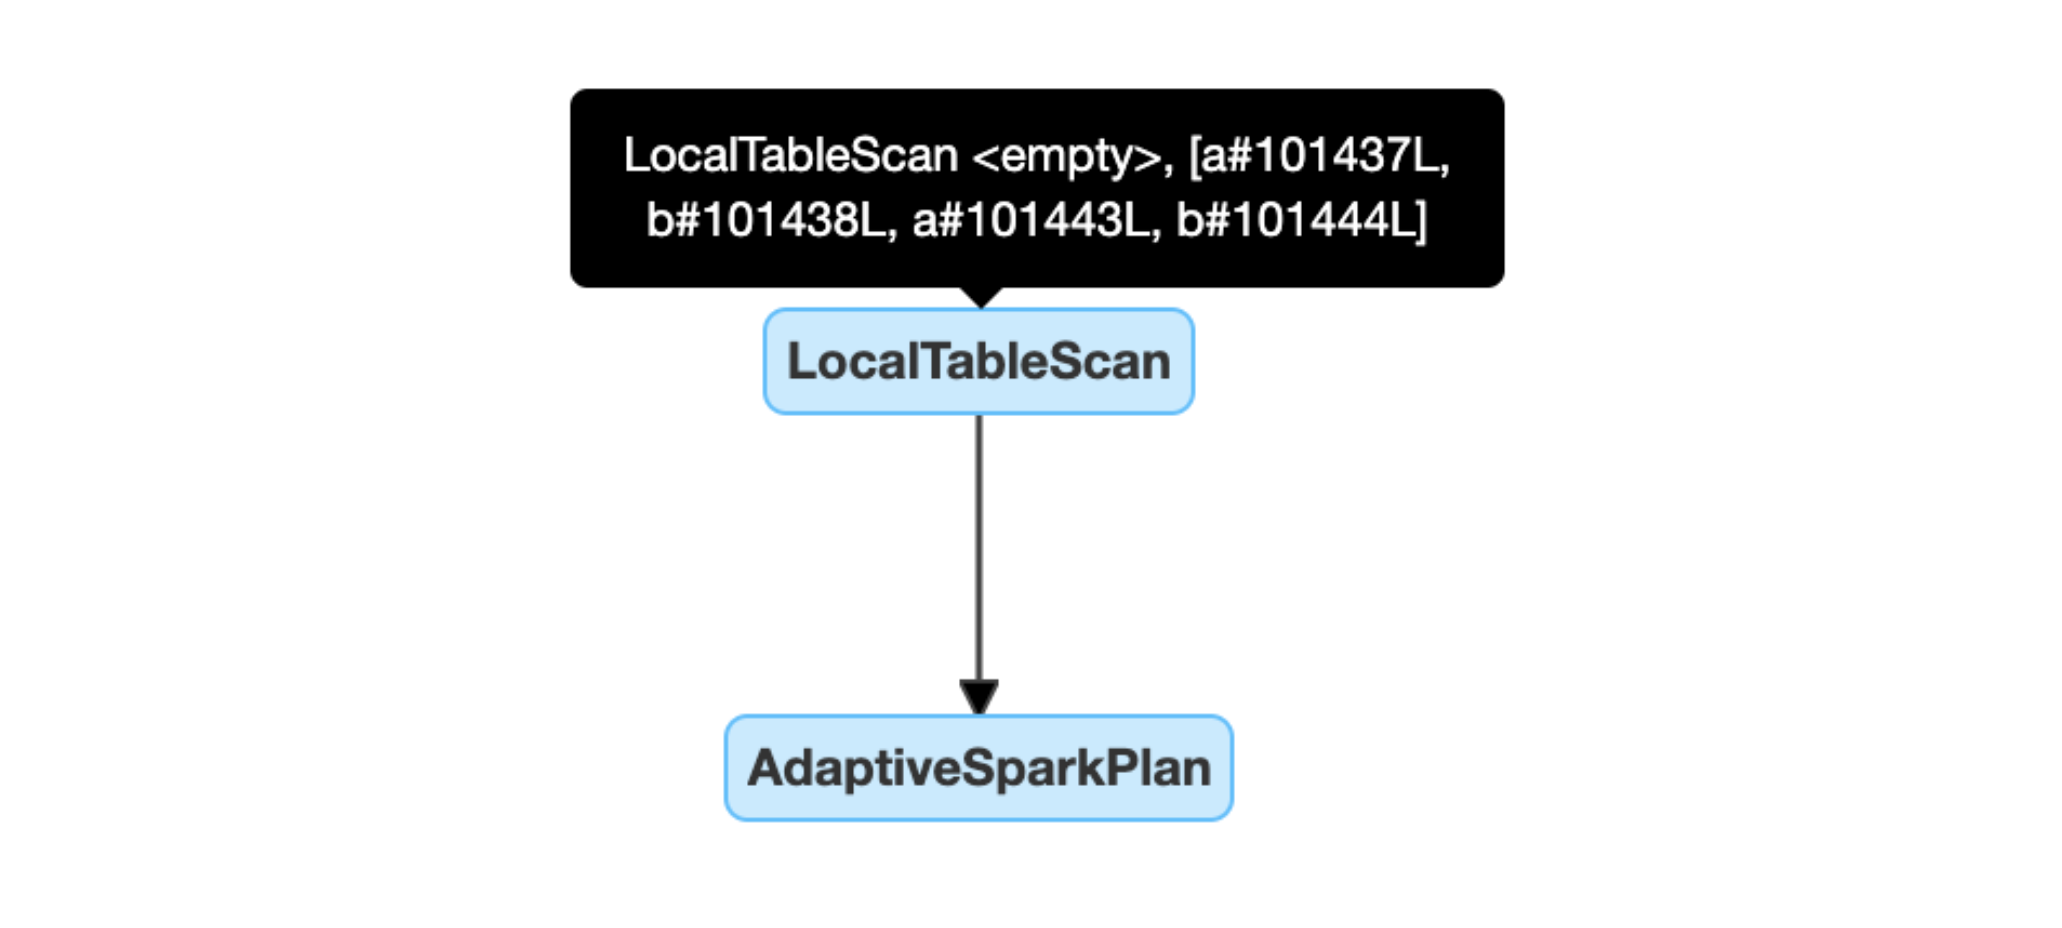
Конфигурация
Эти свойства конфигурации Apache Spark управляют AQE. Большинство рабочих нагрузок не нуждаются в изменении стандартных параметров.
Включить AQE и настроить индивидуальные оптимизации
Используйте эти свойства для включения или выключения AQE и настройки автооптимизированного перемешивания, переключения на широковещательное соединение и распространения пустых результатов:
| Свойство | Type | Default | Description |
|---|---|---|---|
spark.databricks.optimizer.adaptive.enabled |
Boolean |
true |
Включает или выключает адаптивное выполнение запросов. |
spark.sql.shuffle.partitions |
Integer |
200 |
Количество секций по умолчанию, используемых при перетасовке данных для соединений или агрегаций. Установите значение auto, чтобы включить автооптимизированное перемешивание, которое устанавливает это число на основе плана запроса и размера входных данных запроса.Для Structured Streaming нельзя изменить это значение между перезапусками запросов из одного и того же расположения контрольной точки. |
spark.databricks.adaptive.autoBroadcastJoinThreshold |
Byte String |
30MB |
Порог размера для переключения соединения слиянием с сортировкой на широковещательное хеш-соединение во время выполнения. |
spark.databricks.adaptive.emptyRelationPropagation.enabled |
Boolean |
true |
Включает или выключает распространение динамической пустой связи. |
Динамическое объединение разделов
| Свойство | Type | Default | Description |
|---|---|---|---|
spark.sql.adaptive.coalescePartitions.enabled |
Boolean |
true |
Включает или выключает слияние разделов. |
spark.sql.adaptive.advisoryPartitionSizeInBytes |
Byte String |
64MB |
Целевой размер после объединения. Объединённые разделы близки к этому размеру, но не больше. |
spark.sql.adaptive.coalescePartitions.minPartitionSize |
Byte String |
1MB |
Минимальный размер разделов после объединения. Объединённые разделы не меньше этого размера. |
spark.sql.adaptive.coalescePartitions.minPartitionNum |
Integer |
В два раза больше ядер кластера | Минимальное количество разделов после слияния. Не устанавливайте это свойство, потому что его настройка переопределяет spark.sql.adaptive.coalescePartitions.minPartitionSize. |
Динамическая обработка соединения с дисбалансом
| Свойство | Type | Default | Description |
|---|---|---|---|
spark.sql.adaptive.skewJoin.enabled |
Boolean |
true |
Включает или выключает управление соединениями skew join. |
spark.sql.adaptive.skewJoin.skewedPartitionFactor |
Integer |
5 |
Множитель медианного размера разбиения, который должно превышать разбиение, чтобы считаться перекошенным. |
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes |
Byte String |
256MB |
Минимальный размер, который должно превышать разбиение, чтобы считаться перекошенным. |
AQE рассматривает разбиение как смещённое только тогда, когда оба этих условия верны: (partition size > skewedPartitionFactor * median partition size) и (partition size > skewedPartitionThresholdInBytes).
Часто задаваемые вопросы (ЧАВО)
Почему AQE не транслировал небольшую таблицу соединения?
Если таблица меньше spark.databricks.adaptive.autoBroadcastJoinThreshold, но AQE не передаёт её, проверьте следующие причины:
- Тип join не поддерживает широковещательную передачу. Некоторые типы соединения не могут реплицировать одну из сторон. Например, AQE не может реплицировать левую часть
LEFT OUTER JOIN. - В таблице много пустых партиций. Большинство задач в sort merge join быстро заканчиваются, или обработка skew join оптимизирует соединение. AQE не меняет соединение слиянием после сортировки на широковещательное хеш-соединение, если процент непустых разделов ниже
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoin.
Стоит ли мне всё равно использовать подсказку на broadcast join с включённым AQE?
Да, если вы хорошо знаете свой запрос. Broadcast-соединение, которое оптимизатор планирует до выполнения запроса, обычно работает лучше, чем соединение, которое AQE планирует во время выполнения. AQE может не переключаться на широковещательное соединение до тех пор, пока не перемешает обе стороны соединения, и только тогда узнает фактические размеры таблиц.
AQE уважает подсказки запросов так же, как и статическая оптимизация, и при этом применяет динамические оптимизации, которые подсказки не затрагивают.
Стоит ли использовать хинт для перекошенного соединения или обработку перекошенного соединения в AQE?
Используйте обработку соединений с перекосом данных AQE. Это выполняется автоматически и обычно работает лучше, чем указание skew join.
Почему AQE не пересмотрел мои операции JOIN?
AQE не меняет порядок соединений во время выполнения. Чтобы улучшить порядок соединения таблиц, собирайте статистику таблиц, чтобы оптимизатор по затратам мог выбрать лучший план. См. Оптимизатор на основе затрат.
Почему AQE не обнаружила отклонение данных?
AQE рассматривает раздел как несбалансированный только тогда, когда оба этих условия верны:
- Раздел больше, чем
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes(по умолчанию256MB). - Раздел больше, чем в
spark.sql.adaptive.skewJoin.skewedPartitionFactorраз медианного размера раздела (по умолчанию —5).
AQE также обрабатывает перекос данных только в соединениях, основанных на тасовке, а именно соединениях слиянием с сортировкой и хеш-соединениях с перемешиванием. Он никогда не оптимизирует перекос данных в широковещательных соединениях. Для объединений на основе перемешивания тип объединения определяет, какую сторону AQE может оптимизировать:
| Тип соединения | Смещение оптимизировано с левой стороны | Перекос оптимизирован справа |
|---|---|---|
INNER |
Yes | Yes |
CROSS |
Yes | Yes |
LEFT OUTER |
Yes | нет |
RIGHT OUTER |
нет | Yes |
LEFT SEMI |
Yes | нет |
LEFT ANTI |
Yes | нет |
FULL OUTER |
нет | нет |
Наследство
В Spark 1.6 появилась функция адаптивного исполнения, но AQE в Spark 3.0 — это другая функция. Адаптивное выполнение Spark 1.6 динамически объединяет разделы. AQE — это фреймворк, который планирует и перепланирует запросы на основе статистики во время выполнения и поддерживает все оптимизации на этой странице.