Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Important
Элементы, помеченные предварительным просмотром в этой статье, в настоящее время находятся в предварительной версии. Эта предварительная версия предоставляется без соглашения об уровне обслуживания, и Microsoft не рекомендует использовать её для рабочих нагрузок в производственной среде. Некоторые функции могут не поддерживаться или их возможности могут быть ограничены. Дополнительные сведения см. в статье Дополнительные условия использования предварительных версий Microsoft Azure.
Important
Для интерактивного обучения требуется явное разрешение на доступ. Запросите доступ через форму предварительной регистрации и дождитесь утверждения перед созданием обучающего сеанса.
Интерактивное обучение (предварительная версия) — это API для создания собственного цикла дообучения над моделями с открытыми весами в Microsoft Foundry. Вы управляете экспериментом в Python. Foundry выполняет выборку модели и обновления низкоранговой адаптации (LoRA) на бессерверных GPU.
Для обучения с подкреплением (RL) ваш код управляет сбором rollout-ов, наградами, преимуществами и планированием обновлений. Те же примитивы поддерживают обучение с учителем, обучение предпочтений, дистилляцию и рабочие процессы с пользовательской функцией потерь.
Когда его использовать
Используйте интерактивное обучение, когда сам цикл обучения является частью исследования:
- Вам нужен настраиваемый сигнал обучения. Предоставляйте демонстрации, вычисляйте вознаграждения и преимущества или составляйте локальную функцию потерь для обучения предпочтениям или других целей.
- Модель взаимодействует с средой. Координируйте ответы модели, вызовы инструментов, наблюдения и вознаграждения в вашем драйвере.
- Вам нужен контроль над отдельными обновлениями. Выберите батчи, маски токенов, параметры потери и параметры оптимизатора. Решите, когда накапливать градиенты и применять обновление.
- Вы хотите проверить и адаптировать эксперимент. Выборка из текущего адаптера, оценка на отложенных запросах и выбор следующих запросов на основе наблюдаемых результатов.
- Необходимо сохранить и продолжить прогресс. Сохраните состояние адаптера и оптимизатора, а затем возобновите работу в совместимом сеансе. Сохраняйте положение набора данных и другое состояние эксперимента в драйвере.
Управляемая донастройка также поддерживает оценщики для донастройки с подкреплением. Выберите интерактивное обучение, если вам нужен контроль над циклом, а не только над грейдером или настройками задания. См. раздел Выберите подход к обучению.
Кто что делает
Ваша программа на Python управляет обучением. Он подготавливает входные данные и координирует эксперимент. Foundry поддерживает состояние модели и адаптера и выполняет запрошенные операции.
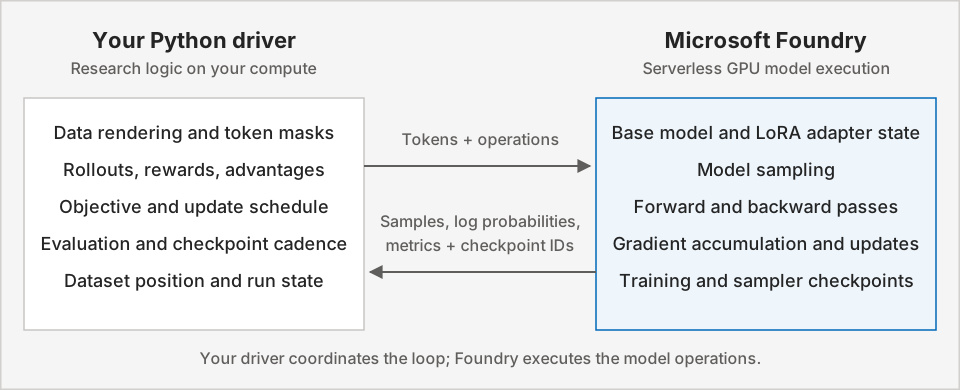
Драйвер может работать на ЦП, включая вашу собственную машину или вычислительную среду. Модель вознаграждения или среда, которую вы добавляете, может иметь собственные требования к вычислительным ресурсам. Не останавливайте драйвер, пока он управляет циклом.
Основные понятия и примитивы
Сеанс хранит состояние: градиентные вычисления, обновления оптимизатора и выборка являются отдельными операциями для выбранной модели и адаптера. Это разделение позволяет выбирать, когда собирать данные, накапливать градиенты, обновлять и оценивать.
| Базовый элемент | Что делает |
|---|---|
| Сеанс обучения и адаптер LoRA |
FineTuningSession.create инициализирует поддерживаемую базовую модель с конфигурацией адаптера. Сеанс содержит состояние, используемое в последующих операциях. |
| Токенизированные пакеты и маски |
Datum содержит входные данные модели и входные данные функции потерь. Маски определяют, какие токены участвуют в обучении, например токены помощника, а не промпты или наблюдения инструментов. |
| Выборка |
sample создает ответы из выбранного чекпоинта сэмплера. Входные данные RL сопоставляют сэмплированные токены с логарифмами вероятностей rollout и преимуществами, производными от вознаграждения. |
| Прямой и обратный проход |
forward возвращает выходные данные функции потери для каждого примера без накапливания градиентов.
forward_backward вычисляет выбранную целевую функцию и накапливает градиенты. Он не применяет обновление оптимизатора. |
| Обновление оптимизатора |
optim_step применяет накопленные градиенты с параметрами оптимизатора Adam. Вы выбираете, когда следует обновлять и какую скорость обучения следует использовать. |
| контрольная точка Sampler |
save_weights_for_sampler подготавливает веса адаптера для генерации. Обновите эти веса после обновления перед выборкой из обновленного адаптера. |
| Контрольная точка при обучении |
save_weights сохраняет веса адаптера и состояние оптимизатора.
FineTuningSession.create_from_checkpoint возобновляет тренировку в совместимом сеансе. |
Пакет SDK включает в себя cross_entropy для обновлений с учителем и потерь RL, таких как importance_sampling и ppo. Эти потери являются примитивами потерь, а не предопределенными сквозными алгоритмами. Сведения о входных контрактах и пользовательской композиции функции потерь см. в основных понятиях.
Как работает цикл RL
Рассмотрим эксперимент по математическому рассуждению: модель создает несколько ответов на каждую проблему, и ваша программа оценивает их правильность. Чтобы посмотреть пример с пошаговым разбором, перейдите к Get started.
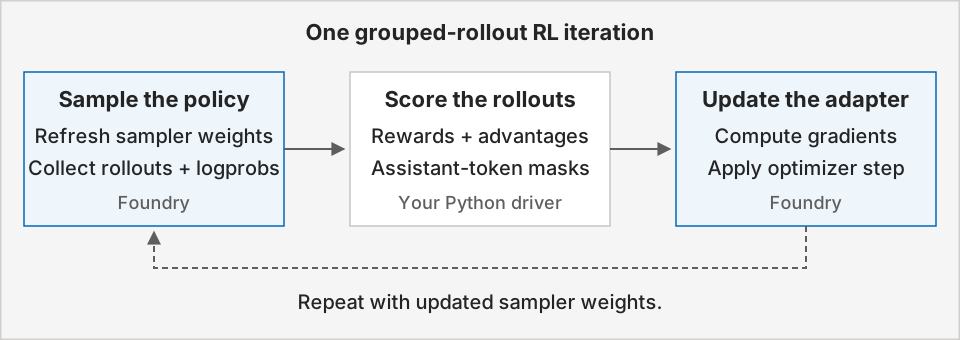
Создайте отложенные базовые показатели и протестируйте функцию вознаграждения перед первым обновлением. Затем повторите:
- Подготовьте текущую политику для отбора. Сохраните веса сэмплера из обучающего адаптера, а затем соберите несколько ответов, или rollouts, для каждого запроса.
- Оцените и сравните ответы. Функция вознаграждения назначает оценку каждой траектории. Вычитайте среднее вознаграждение группы запросов, чтобы получить advantage каждого rollout.
- Подготовьте обучающий сигнал. Сопоставьте сэмплированные токены ассистента с логарифмами вероятностей rollout и преимуществами. Исключите подсказки и наблюдения за средой из сигнала обучения.
- Вычислите градиенты. Отправьте пакет в
forward_backwardсimportance_sampling. Завершите вычисление градиента перед обновлением, которое потребляет этот градиент. - Обновите адаптер. Вызовите
optim_step, а затем обновите веса сэмплера перед сбором ответов из обновлённой policy. - Оцените и сохраните прогресс. Сравните правильность на отложенной выборке с базовым уровнем и сохраните контрольные точки обучения с выбранной периодичностью.
Get started
Выберите отправную точку, которая соответствует вашей задаче:
- Краткое руководство: Следуйте примеру краткого руководства, чтобы клонировать репозиторий и запустить короткий сценарий обучения с подкреплением.
- Попробуйте другие рецепты: Ознакомьтесь с репозиторием примеров точной настройки для получения дополнительных примеров обучения.
- Поиск операции: Используйте памятку пакета SDK (предварительная версия) для функций и ключевых параметров.
- Разберитесь в цикле обучения: Ознакомьтесь с основными понятиями о вознаграждениях, преимуществах, масках маркеров и контрольных точках.
Поддерживаемые модели и регионы
Ознакомьтесь с обзором по точной настройке: поддерживаемые модели и поддерживаемые регионы.