Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Гибкая обработка (предварительная версия) обеспечивает вывод со скидкой на 50% по сравнению со стандартной обработкой для рабочих нагрузок, которые могут допускать более медленное время отклика и случайные недоступные ресурсы. Выберите обработку Flex для отдельного запроса к Responses API или Chat Completions API, установив flex в значение service_tier.
Используйте обработку Flex для неинтерактивной и низкоприоритетной работы, таких как оценки моделей, обогащение данных, анализ документов и асинхронные рабочие процессы приложений. Для рабочих нагрузок, чувствительных к задержкам или пропускной способности, используйте вместо этого Standard processing, Priority processing или выделенную пропускную способность.
Important
С введением обработки Flex запросы, в которых значение service_tier установлено на flex, обрабатываются только в том случае, если выбранная модель поддерживает обработку Flex. Неподдерживаемая модель возвращает HTTP 400 invalid_request_error и не возвращается к стандартной обработке. Для обработки Flex не предусмотрены ни SLA по задержке, ни SLA на обслуживание.
Необходимые условия
Подписка на Azure. Создайте аккаунт бесплатно.
Ресурс Azure OpenAI с поддерживаемой моделью, развернутой с использованием типа развертывания Global Standard.
Конечная точка ресурса и ключ API или учетные данные Microsoft Entra ID. В примерах в этой статье используется ключ API, хранящийся в переменной
AZURE_OPENAI_API_KEYсреды.Рабочая нагрузка, которая может допускать переменную задержку и временные ответы о недоступности ресурсов.
Python 3.10 или более поздней версии и пакет OpenAI Python для примеров Python:
pip install --upgrade openai
Отправка запроса Flex
Установите для service_tier значение flex в каждом запросе, который должен использовать обработку Flex. Значение model — это имя развертывания вашей модели Azure.
Python
В следующем примере отправляется запрос Flex с помощью API ответов:
import os

from openai import OpenAI

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

# Send a request for Flex processing.
response = openai.responses.create(
    model="YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    input="Analyze these records and summarize the recurring themes.",
    service_tier="flex",
)

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: flex
Ответ содержит созданный анализ и уровень служб, обрабатывающий запрос.
Справочник:API Responses
REST
Следующий пример отправляет тот же запрос непосредственно в API ответов:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "flex"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
Чтобы проверить, какой уровень обрабатывает запрос, проверьте service_tier поле в успешном ответе.
Справочник:по REST API Responses
Выбор параметра обработки
Flex, Standard и Priority — это варианты уровня обслуживания для онлайн-запросов к API. Пакетная и подготовленная пропускная способность — это отдельные варианты развертывания и приобретения.
| Опция | Как выбрать его | Задержка и доступность | Модель затрат | лучше всего подходит для |
|---|---|---|---|---|
| Flex-обработка | Установите для уровня запроса значение service_tier: flex. |
Переменная задержка Запросы могут возвращать HTTP 429, если емкость Flex недоступна. | Скидка 50% по сравнению со стандартными тарифами на токены. Также применяются скидки на кэшированные токены. | Оценивание, обогащение, офлайн-анализ и фоновая работа, допускающая задержки. |
| Стандартная обработка | Задайте для уровня запроса значение или используйте уровень service_tierdefault"Стандартный", настроенный для развертывания. |
Онлайн-обработка по мере возможности для общих рабочих нагрузок. | Стандартная ставка оплаты за токен. | Нагрузки для разработки, тестирования и промышленной эксплуатации с переменным трафиком. |
| Приоритетная обработка | Настройте приоритет для развертывания или задайте service_tierприоритет на уровне запросаpriority. |
Более низкая и согласованная задержка с определенным целевым объектом для поддерживаемых моделей. | Приоритетная ставка оплаты за токен. | Онлайн-приложения, чувствительные к задержкам, без обязательств по резервированию емкости. |
| Партия | Отправьте асинхронное пакетное задание для развертывания Batch. | Результаты планируется подготовить в течение 24 часов. Целевое значение задержки в реальном времени отсутствует. | Льготный тариф за пакетную обработку. | Большие автономные задания, которые не требуют немедленного ответа. |
| Подготовленная пропускная способность | Создайте подготовленное развертывание и приобретите или зарезервируйте единицы подготовленной пропускной способности (PTUs). | Зарезервированная емкость с прогнозируемой пропускной способностью и задержкой. | Почасовая оплата PTU или резервирование в Azure. | Высоконагруженные, критически важные производственные рабочие нагрузки. |
Выберите обработку Flex при применении всех следующих условий:
- Ваша рабочая нагрузка допускает более длительное и переменное время обработки.
- Вы предпочитаете более низкую стоимость по сравнению с прогнозируемой задержкой.
- Приложение может повторить временные сбои или перенаправить неудачный запрос к стандартной обработке.
- Поддерживаются выбранные модели и контекст запроса.
Не используйте обработку Flex, если применяются какие-либо из следующих условий:
- Пользователь ожидает интерактивного ответа.
- Запрос должен завершаться в рамках жёсткого целевого значения задержки.
- Приложение не может терпеть или повторять временные ответы HTTP 429.
- Требуется зарезервированная емкость обработки или прогнозируемая пропускная способность.
Обработка Flex имеет следующие характеристики:
-
Выбор на уровне запроса: Задайте для
service_tierзначениеflexдля каждого запроса, который должен использовать обработку Flex. - Отдельное развертывание не требуется: Отправляйте запросы Standard и Flex в одно и то же развертывание Global Standard и выбирайте уровень для каждого отдельного запроса.
- Поддерживаемые API: Используйте API ответов или API завершения чата.
- Синхронный ответ: Вызов API остается синхронным, даже если рабочая нагрузка может занять больше времени. Обработка Flex — это не то же самое, что Batch API.
- Доступность, зависящая от емкости: Запрос может возвращать HTTP 429, если емкость Flex недоступна.
-
Без автоматического перехода к режиму Standard: Приложение должно явно выполнить повторную попытку с параметром
service_tier, установленным в значениеdefault, если стандартная обработка допустима. - Общая квота: Запросы Flex и Standard используют квоту, выделенную для развертывания Global Standard.
- То же качество выходных данных модели: Flex использует ту же базовую модель, что и стандартная. Уровень обработки изменяет задержку, доступность и цену, а не качество модели.
Note
Для токенов ввода и вывода Flex действует скидка 50% по сравнению с соответствующими ставками для токенов Standard. На подходящие кэшированные токены входных данных также распространяется соответствующая скидка для кэшированных токенов. Текущие тарифы см. в тарифах Azure OpenAI.
Просмотр поддерживаемых моделей
Для Flex processing на момент запуска доступно ограниченное количество моделей.
gpt-5.6-sol является первой поддерживаемой моделью. В следующей таблице перечислены поддерживаемые модели. Microsoft добавляет больше моделей, так как поддержка становится доступной.
| Модель | Version | Тип развертывания | Доступность по регионам |
|---|---|---|---|
gpt-6.1-sol |
2026-09-29 |
Глобальный стандарт | Все регионы Azure, где доступен Global Standard |
gpt-6-sol |
2026-09-22 |
Глобальный стандарт | Все регионы Azure, где доступен Global Standard |
gpt-6-luna |
2026-09-22 |
Глобальный стандарт | Все регионы Azure, где доступен Global Standard |
gpt-6-astra |
2026-09-03 |
Глобальный стандарт | Все регионы Azure, где доступен Global Standard |
gpt-5.6-sol |
2026-07-09 |
Глобальный стандарт | Все регионы Azure, где доступен Global Standard |
gpt-5.6-luna |
2026-07-09 |
Глобальный стандарт | Все регионы Azure, где доступен Global Standard |
gpt-5.6-terra |
2026-07-09 |
Глобальный стандарт | Все регионы Azure, где доступен Global Standard |
Проверьте эту таблицу перед отправкой запроса Flex. Не предполагайте, что модель или новая версия модели поддерживает обработку Flex, так как она поддерживает обработку уровня "Стандартный" или "Приоритет". Неподдерживаемая модель возвращает HTTP 400. Чтобы избежать сбоев в работе приложения, реализуйте на уровне приложения механизм переключения на обработку уровня Standard, если цены и производительность уровня Standard являются приемлемыми.
Возврат к стандартной обработке
Обработка Flex не перенаправляет запрос в Standard автоматически, если мощности Flex недоступны. Если завершение запроса важнее, чем сохранение тарифов Flex, повторите запрос, установив service_tier значение default.
В следующем примере используется политика с приоритетом завершения. Он сначала пытается выполнить обработку Flex и повторить попытку один раз с стандартной обработкой после любого ответа HTTP 429:
import os

from openai import OpenAI, RateLimitError

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

request = {
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
}

# Try Flex processing, and fall back to Standard after an HTTP 429 response.
try:
    response = openai.responses.create(**request, service_tier="flex")
except RateLimitError:
    response = openai.responses.create(**request, service_tier="default")

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: <flex-or-default>
Переход на стандартный режим изменяет стоимость и характеристики производительности запроса. Используйте эту схему только в том случае, если рабочая нагрузка допускает тариф Standard.
Ответ HTTP 429 может указывать на недоступность емкости Flex или ограничение квоты. Поскольку режимы обработки Flex и Standard используют общую квоту, запрос на обработку Standard также может завершиться ошибкой, если исходный ответ был вызван исчерпанием квоты. Установите ограничения на количество повторных попыток и обработайте второй элемент RateLimitError в приложении. Когда служба возвращает специфичный для Flex идентификатор ошибки, используйте его, чтобы ограничить переход к резервной обработке только ответами, связанными с ёмкостью.
Для рабочих нагрузок, в которых приоритетом является минимальная стоимость, перед переходом к резервному варианту повторите обработку Flex с экспоненциальной задержкой. Для рабочих нагрузок, для которых приоритетом является время завершения, после первой ошибки нехватки ёмкости Flex переключайтесь обратно на Standard.
Ссылка:RateLimitError
Устранение ошибок Flex
Отличайте постоянные ошибки запросов от временных ошибок нехватки ресурсов.
| Состояние HTTP | Error | Причина | Рекомендуемая обработка |
|---|---|---|---|
| 400 | invalid_request_error |
Выбранная модель, версия модели, длина контекста, API или конфигурация запроса не поддерживает обработку Flex. | Не повторяйте тот же запрос без изменений. Выберите поддерживаемую модель или размер контекста, или явно повторите попытку, указав для service_tier значение default. |
| 408 | Время ожидания запроса | Запрос не завершается в течение настроенного времени ожидания клиента или службы. Запросы Flex могут занять больше времени, чем стандартные запросы. | Используйте более длительное время ожидания клиента. Повторите попытку с ограниченной экспоненциальной задержкой. Если время выполнения важнее, чем тариф Flex, повторите попытку, используя Standard. |
| 429 | Ресурс недоступен или ограничен скоростью | Емкость Flex временно недоступна или запрос превысил применимое ограничение скорости. Емкость Flex является предопределенной, поэтому временная недоступность, скорее всего, во время пиковых часов. | Если запрос превысил ограничение скорости, увеличьте ограничение скорости развертывания Global Standard, назначив больше квоты. Flex и Standard используют эту квоту совместно. Если у подписки недостаточно квоты для рабочей нагрузки с большой пропускной способностью, запросите увеличение квоты. Если емкость Flex временно недоступна, повторите попытку с экспоненциальной задержкой между повторами и джиттером, перенесите задачи, допускающие задержку, на периоды вне пиковой нагрузки, например на ночи в будние дни или выходные, либо повторите попытку с параметром service_tier, установленным в значение default. Учитывайте Retry-After, если он присутствует. |
| 500, 502, 503 или 504 | Временная ошибка службы | Не удалось завершить операцию из-за временной проблемы со службой или шлюзом. | Повторите попытку с ограниченной экспоненциальной задержкой. Не отправляйте неограниченное количество повторных попыток. |
| 401 или 403 | Ошибка проверки подлинности или авторизации | Учетные данные отсутствуют, недопустимы, истекли или не предоставляют доступа к ресурсу. | Исправьте учетные данные или назначение роли. Не повторяйте попытку до изменения конфигурации. |
| 404 | Развертывание не найдено | Неверно указано имя развертывания или URL-адрес конечной точки. | Убедитесь, что model соответствует имени развертывания и что базовый URL-адрес указывает на правильный ресурс Azure OpenAI. |
Note
Если запрос Flex отклонён из-за недоступности вычислительных мощностей, плата за него не взимается. Однако вы можете заметить, что доступный лимит запросов стал меньше, поскольку запросы Flex и Standard делят общую квоту, выделенную для развертывания Global Standard.
Используйте экспоненциальное увеличение интервалов между повторными попытками со случайным разбросом для ответов HTTP 408, 429 и временных ошибок 5xx. Задайте максимальное число повторных попыток и максимальную задержку, чтобы неудачный запрос не оставался в несвязанном цикле повторных попыток.
- Сохраняйте
Retry-After, если он присутствует в ответе. - В противном случае выждите экспоненциально увеличивающуюся задержку со случайным разбросом.
- Используйте Retry Flex только пока задержка остается приемлемой для данной рабочей нагрузки.
- Если лимит повторных попыток исчерпан и приложение допускает более высокую стоимость уровня Standard, перейдите на Standard.
- Возвращает явный сбой, если ни отложенная обработка Flex, ни резервный вариант "Стандартный" не соответствует требованиям приложения.
Не повторяйте повторение одного неподдерживаемого запроса Flex. Повтор выполняется только после изменения модели, длины контекста, конфигурации API или уровня служб.
Отслеживание использования и затрат
Используйте метрики Azure Monitor для сравнения трафика Flex и Standard в одном развертывании. Отслеживайте в вашем приложении объем запросов, потребление токенов, задержку, сбои и частоту, с которой запросы Flex переключаются на Standard.
Войдите на портал Azure.
Перейдите к ресурсу OpenAI Azure и выберите метрики.
Добавьте метрику запросов OpenAI Azure. Кроме того, можно добавить задержку Azure OpenAI, использование Azure OpenAI и метрики ошибок.
Добавьте фильтр, в котором ServiceTierRequest равно
flex.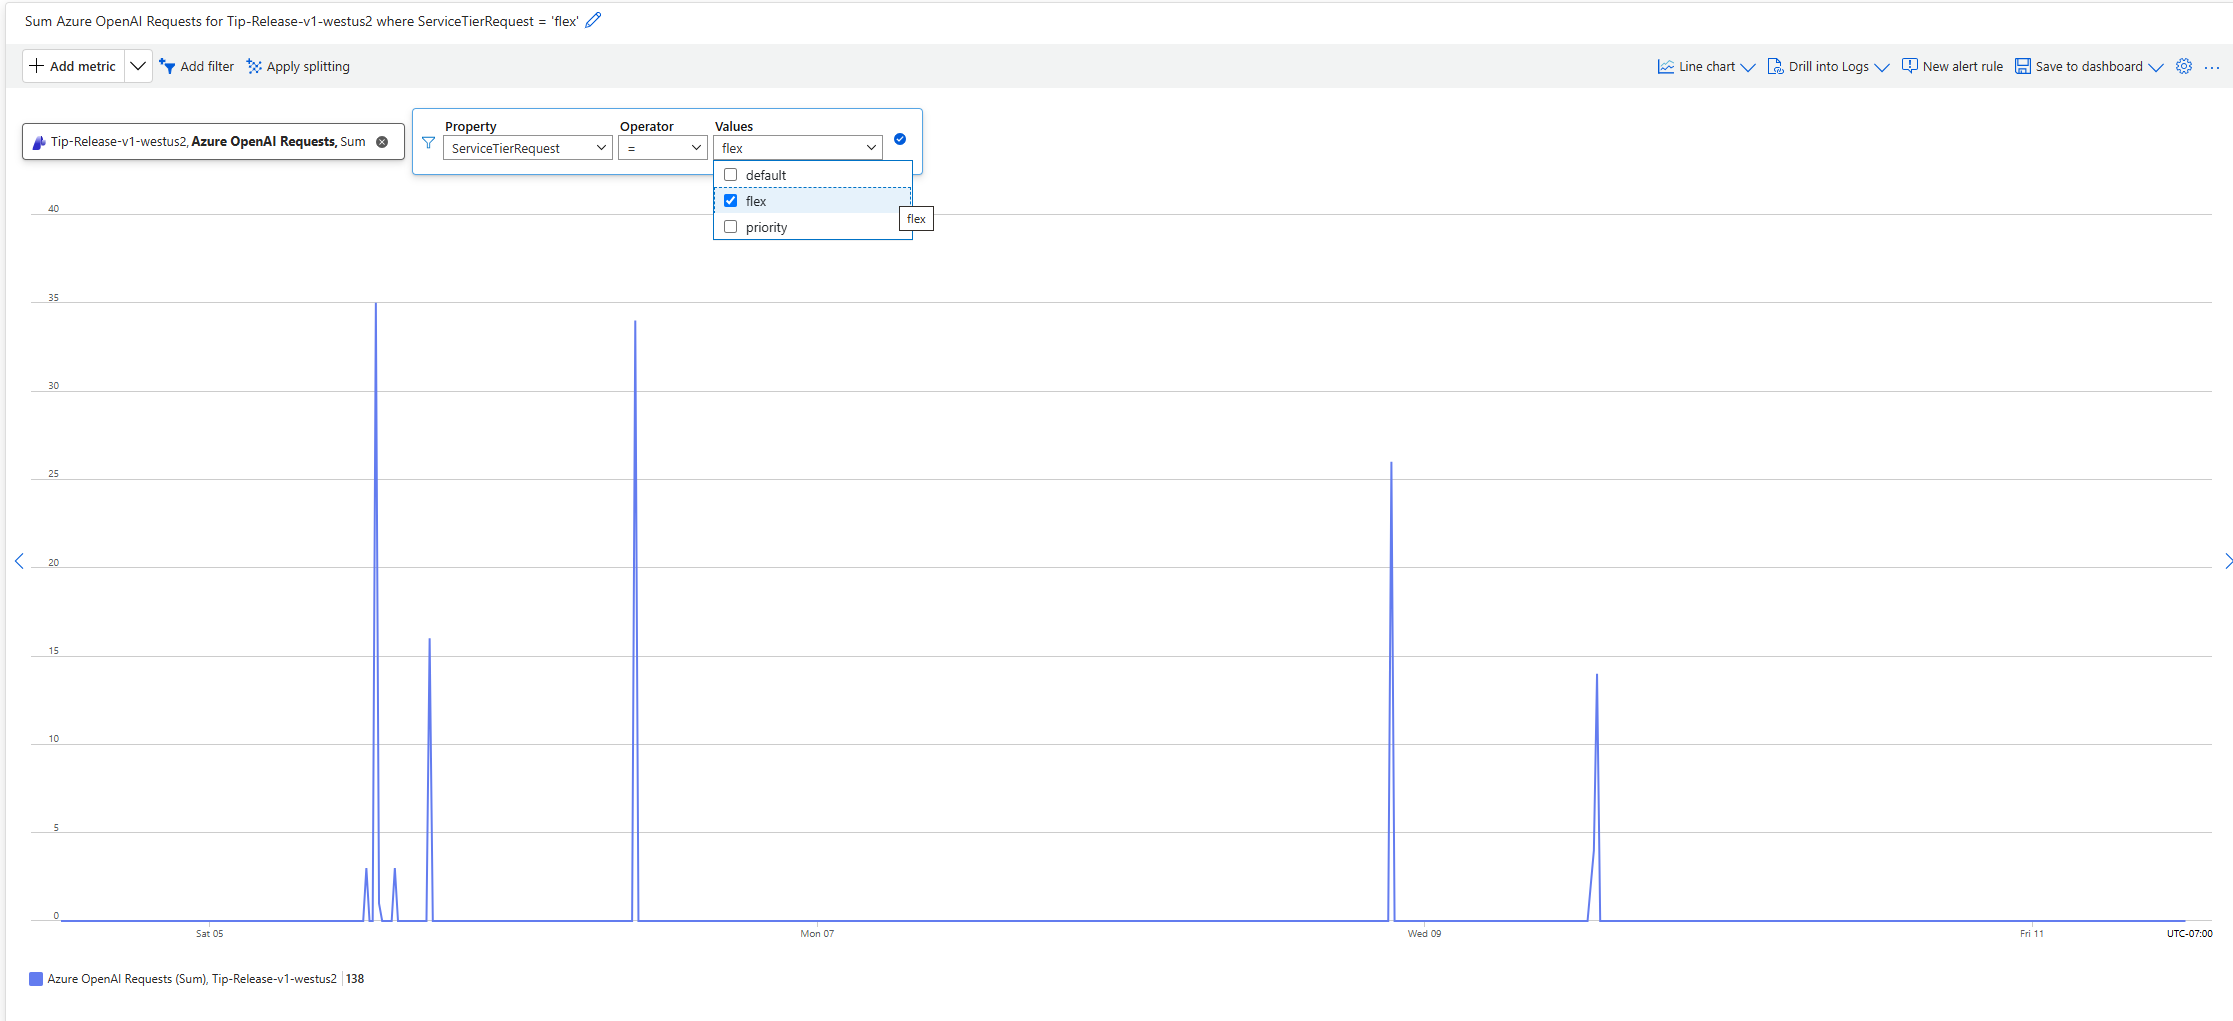
Создайте оповещения для постоянно повторяющихся ответов HTTP 429, повышенной частоты ошибок и задержки, превышающей бюджет повторных попыток вашей нагрузки.
Отслеживайте следующие сигналы для каждой рабочей нагрузки:
| Сигнал | Почему это важно |
|---|---|
| Число запросов Flex | Показывает внедрение и маршрутизацию трафика для более низкой стоимости обработки. |
| Частота успешных запросов Flex | Показывает, как часто ресурс Flex принимает и выполняет запросы. |
| Скорость HTTP 429 | Показывает периоды, когда емкость Flex или квота развертывания ограничена. |
| Стандартное резервное число и скорость | Показывает преимущество надежности и добавленную стоимость от резервного восстановления, управляемого приложением. |
| Входные токены, кэшированные входные токены и выходные токены | Поддерживает атрибуцию затрат и позволяет проверить влияние кэширования промптов. |
| Сквозная задержка | Помогает определить, подходит ли рабочая нагрузка для Flex. |
Количество HTTP 400 invalid_request_error |
Определяет неподдерживаемые модели, версии модели, длины контекста или конфигурации запросов. |
Дополнительные сведения о развертываниях моделей мониторинга см. в статье "Мониторинг Azure OpenAI".
Использование Flex тарифицируется по отдельным счетчикам Flex, чтобы его можно было отличать от использования по стандартному тарифу. Используйте анализ затрат, чтобы просмотреть затраты на токен Flex по ресурсам и развертыванию.
- На портале Azure откройте Управление затратами и выставление счетов>Анализ затрат.
- Отфильтруйте по подписке, группе ресурсов или ресурсу Azure OpenAI, в котором содержится развертывание.
- Сгруппируйте или отфильтруйте по показателю, чтобы разделить использование Flex и Standard.
- Добавьте фильтр по тегу выставления счетов, выберите deployment и выберите имя deployment.
- Сравните экономию при использовании Flex с затратами на резервный вариант Standard и требованиями к завершению рабочей нагрузки.
Токены ввода и вывода Flex стоят 50% от соответствующих стандартных тарифов. Кэширование промптов может дополнительно снизить стоимость входных токенов, подпадающих под кэширование. Если запрос Flex отклонён из-за недоступности вычислительных мощностей, плата за него не взимается.
Применяйте рекомендации по работе в рабочей среде
- Установите более длительный тайм-аут. Запросы Flex могут занять больше времени, чем стандартные запросы. Начните с времени ожидания клиента, подходящего для рабочей нагрузки, например 15 минут, и проверьте с помощью репрезентативных запросов.
- Используйте ограниченные повторные попытки. Ограничьте количество повторных попыток и общее затраченное время.
- Добавьте дрожание. Случайные задержки отката, чтобы избежать синхронизированных пиков повторных попыток.
- Явно укажите резервный вариант. Установите для
service_tierзначениеdefaultвместо того чтобы полагаться на неявное поведение. - Отслеживайте уровень обработки. Запишите значение ответа
service_tierс задержкой, состоянием, использованием маркеров и данными о затратах. - Разделение интерактивного и фонового трафика. Используйте для пользовательских запросов режимы Standard, Priority или выделенную пропускную способность, если только переменная задержка Flex не является допустимой.
- Контролируйте дублирование работы. Убедитесь, что приложение не отправляет одно и то же логическое задание несколько раз после истечения времени ожидания на стороне клиента.
- Тестовые пути сбоя. Проверка обработки ответов HTTP 400, 408, 429 и временных ответов 5xx перед использованием обработки Flex в рабочих процессах.
- Просмотрите поддержку модели перед обновлением. Замещающая модель или версия модели не наследует поддержку Flex автоматически.
Переопределите уровень обслуживания с помощью заголовка запроса
x-ms-service-tier Используйте заголовок запроса, если шлюз, прокси-сервер или централизованный уровень маршрутизации должен выбрать уровень служб без проверки или изменения текста запроса. Заголовок также может уменьшить изменения миграции для приложений, которые уже выбирают уровень служб OpenAI с помощью заголовка запроса.
Заголовок принимает следующие значения:
| Значение заголовка | Запрошенный уровень обработки |
|---|---|
flex |
Flex |
priority |
Priority |
default |
Стандарт |
auto |
Priority |
Если заголовок присутствует и действителен, он имеет приоритет над service_tier значением в тексте запроса.
| Ввод заголовка | Ввод текста запроса | Поведение и выходные данные |
|---|---|---|
| Заголовок опущен | Допустимое service_tier значение |
Тело запроса определяет уровень. В успешном ответе указывается обработанный уровень в service_tier. |
| Допустимое значение заголовка | Любое значение или не указано | Заголовок выбирает запрошенный уровень. В успешном ответе указывается обработанный уровень в service_tier. |
| Неподдерживаемое значение заголовка | Любое значение или не указано | Запрос возвращает HTTP 400. Служба не возвращается к значению текста запроса. |
В этом примере запрашивается обработка Flex с помощью заголовка. Заголовок переопределяет значение default в теле запроса:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -H "x-ms-service-tier: flex" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "default"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
Заголовок override не поддерживает автоматический переход к резервному варианту. Недопустимое значение заголовка или уровень, который не поддерживает выбранное развертывание, возвращает HTTP 400.