Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Service Fabric состоит из многоуровневых подсистем. Эти подсистемы позволяют создавать приложения, которые:
- высокая доступность;
- Масштабируемость
- Выполнимый
- Тестируемых
На следующей схеме показаны основные подсистемы Service Fabric.
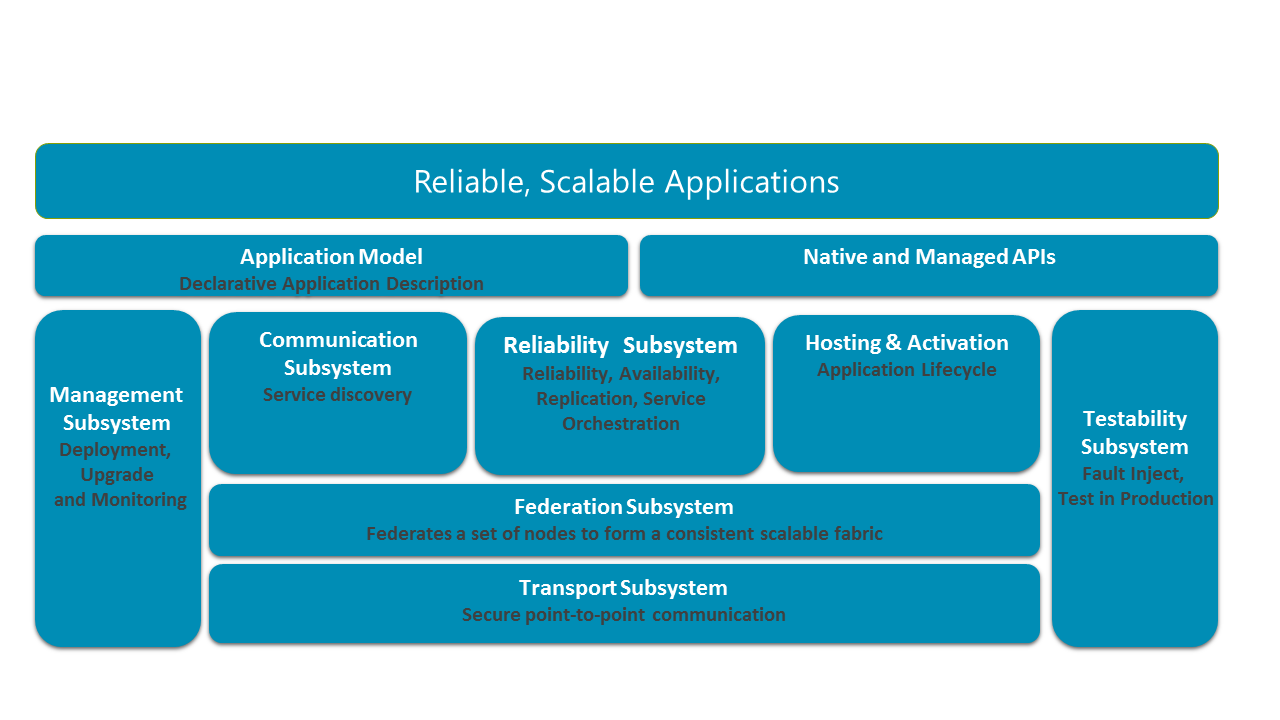
В распределенной системе возможность безопасного обмена данными между узлами в кластере имеет решающее значение. В основе стека находится подсистема транспорта, которая обеспечивает безопасную связь между узлами. Над подсистемой транспорта лежит подсистема федерации, которая кластеризует различные узлы в одну сущность (именованные кластеры), чтобы Service Fabric могли обнаруживать сбои, выполнять выборы лидера и обеспечивать согласованную маршрутизацию. Подсистема надежности, наложенная на подсистему федерации, отвечает за надежность служб Service Fabric с помощью таких механизмов, как репликация, управление ресурсами и отработка отказа. Подсистема федерации также лежит в основе подсистемы размещения и активации, которая управляет жизненным циклом приложения на одном узле. Подсистема управления управляет жизненным циклом приложений и служб. Подсистема тестирования помогает разработчикам приложений тестировать свои службы с помощью имитированных сбоев до и после развертывания приложений и служб в рабочих средах. Service Fabric предоставляет возможность разрешать расположения служб через подсистему связи. Модели программирования приложений, предоставляемые разработчиками, размещаются поверх этих подсистем вместе с моделью приложения для включения инструментов.
Подсистема транспорта
Подсистема транспорта реализует канал связи по принципу "точка-точка" с использованием датаграмм. Этот канал используется для обмена данными в кластерах Service Fabric и взаимодействия между кластером Service Fabric и клиентами. Он поддерживает односторонние и запрос-ответ шаблоны, которые предоставляют основу для реализации широковещательной и многоадресной рассылки на уровне Федерации. Подсистема транспорта обеспечивает обмен данными с помощью сертификатов X509 или безопасности Windows. Эта подсистема используется внутри Service Fabric и не доступна разработчикам для программирования приложений напрямую.
Подсистема федерации
Чтобы подумать о наборе узлов в распределенной системе, необходимо иметь согласованное представление системы. Подсистема федерации использует примитивы связи, предоставляемые транспортной подсистемой, и объединяет различные узлы в единый кластер, который можно анализировать. Он предоставляет примитивы распределенных систем, необходимые другим подсистемам — обнаружение сбоев, выборы лидера и последовательная маршрутизация. Подсистема федерации построена на основе распределенных хэш-таблиц с 128-разрядным пространством маркеров. Подсистема создает кольцевую топологию над узлами, при этом каждому узлу в кольце выделяется подмножество пространства маркера для владения. Для обнаружения сбоев слой использует механизм аренды на основе избиения сердца и арбитража. Подсистема федерации также гарантирует, что в любой момент существует только один владелец токена, благодаря сложным протоколам включения и выхода. Это обеспечивает выборы лидеров и согласованные гарантии маршрутизации.
Подсистема надежности
Подсистема надежности предоставляет механизм для обеспечения высокого уровня доступности службы Service Fabric с помощью репликатора, диспетчера переключения при отказе и балансировщика ресурсов.
- Репликатор гарантирует, что изменения состояния в первичной реплике службы будут автоматически реплицированы на вторичные реплики, сохраняя согласованность между основными и вторичными репликами в наборе реплик службы. Репликатор отвечает за управление кворумом среди реплик в наборе реплик. Он взаимодействует с модулем отказоустойчивости, чтобы получить список операций для репликации, а агент переконфигурации предоставляет ему конфигурацию набора реплик. Эта конфигурация указывает, какие реплики необходимо реплицировать. Service Fabric предоставляет репликатор по умолчанию под названием Fabric Replicator, который можно использовать с API модели программирования для достижения высокой доступности и надежности состояния службы.
- Диспетчер резервирования обеспечивает автоматическое перераспределение нагрузки между доступными узлами при добавлении или удалении узлов из кластера. Если узел в кластере выходит из строя, кластер автоматически перенастроит реплики служб для сохранения доступности.
- Менеджер ресурсов размещает реплики служб в зонах отказа в кластере и гарантирует, что все единицы резервирования работают. Resource Manager также балансирует ресурсы службы в базовом общем пуле узлов кластера, чтобы обеспечить оптимальное равномерное распределение нагрузки.
Подсистема управления
Подсистема управления обеспечивает комплексное управление службами и жизненным циклом приложений. Командлеты PowerShell и административные API позволяют подготавливать, развертывать, обновлять и отменять подготовку приложений без потери доступности. Подсистема управления выполняет это с помощью следующих служб.
- Диспетчер кластеров: это основная служба, которая взаимодействует с диспетчером отработки отказа от надежности, чтобы разместить приложения на узлах на основе ограничений размещения служб. Resource Manager в подсистеме отказоустойчивости гарантирует, что ограничения никогда не нарушаются. Диспетчер кластеров управляет жизненным циклом приложений от подготовки к отмене подготовки. Она интегрируется с менеджером здоровья, чтобы гарантировать, что доступность приложений не утрачивается с точки зрения семантического здоровья во время обновлений.
- Диспетчер работоспособности. Эта служба обеспечивает мониторинг работоспособности приложений, служб и сущностей кластера. Сущности кластера (такие как узлы, разделы служб и реплики) могут предоставлять информацию о состоянии, которые затем объединяются в централизованное хранилище состояния. Эта информация о работоспособности предоставляет общий моментальный снимок работоспособности служб и узлов, распределенных по нескольким узлам в кластере, что позволяет выполнять все необходимые действия по исправлению. API запросов состояния системы позволяют запрашивать события, переданные подсистеме состояния здоровья. API запросов работоспособности возвращают необработанные данные работоспособности, хранящиеся в хранилище работоспособности или агрегированные, интерпретированные данные о работоспособности для определенной сущности кластера.
- Хранилище образов: эта служба предоставляет хранилище и распространение двоичных файлов приложения. Эта служба предоставляет простое распределенное хранилище файлов, в котором приложения загружаются и скачиваются из него.
Подсистема хостинга
Диспетчер кластеров сообщает подсистеме хостинга (работает на каждом узле), какими службами необходимо управлять для определенного узла. Подсистема размещения затем управляет жизненным циклом приложения на этом узле. Он взаимодействует с компонентами надежности и здоровья, чтобы убедиться, что реплики правильно размещены и находятся в хорошем состоянии.
Подсистема коммуникации
Эта подсистема обеспечивает надежную передачу сообщений в кластере и обнаружении служб через службу именования. Служба именования преобразует имена служб в расположение в кластере и позволяет пользователям управлять именами и свойствами служб. С помощью службы именования клиенты могут безопасно взаимодействовать с любым узлом в кластере для разрешения имени службы и получения метаданных службы. Используя простой API клиента для именования, пользователи Service Fabric могут разрабатывать службы и клиенты, которые способны определять текущее сетевое расположение, несмотря на динамичность узлов или изменение размера кластера.
Подсистема тестирования
Тестируемость — это набор средств, специально предназначенных для тестирования служб, созданных на основе Service Fabric. Средства позволяют разработчику легко вызывать значимые ошибки и выполнять тестовые сценарии для выполнения и проверки многочисленных состояний и переходов, которые служба будет испытывать в течение всего времени существования, все в управляемом и безопасном режиме. Возможность тестирования также предоставляет механизм выполнения длительных тестов, которые могут итерационно проходить различные возможные сбои без потери доступности. Это обеспечивает тестовую рабочую среду.