Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Eventstream в Microsoft Fabric — это полностью управляемый сервис поглощения и потокового потока событий, который позволяет обрабатывать данные и анализировать данные в реальном времени. Вы можете интегрировать eventstream с ноутбуками Fabric с помощью Spark Structured Streaming для обработки и анализа потоковых данных в реальном времени.
Эта интеграция позволяет исследовать потоки событий и другие источники в реальном времени через Real-Time-хаб, прямо из ваших Fabric блокнотов. Вы также можете создавать новые потоки событий и начинать получать данные из почти 30 (и растущих) потоковых источников, включая базы данных CDC, брокеры сообщений, стриминговые сервисы и публичные ленты. Новая модель программирования позволяет легко подключаться к eventstream, читать потоковые данные и выполнять аналитику в реальном времени с помощью знакомых API Spark без каких-либо строк подключения или учетных данных, что делает создание приложений в реальном времени более безопасным
Предпосылки
Прежде чем начать, убедитесь, что у вас есть следующие предварительные требования:
- Рабочее пространство Fabric с включённым eventstream.
- Среда блокнота, настроенная в Fabric.
- Базовые знания о структурированной потоковой передаче Spark и PySpark или Scala.
Шаги по запросу потока событий из записной книжки
Обнаружение и добавление событий в записную книжку:
Откройте записную книжку Microsoft Fabric.
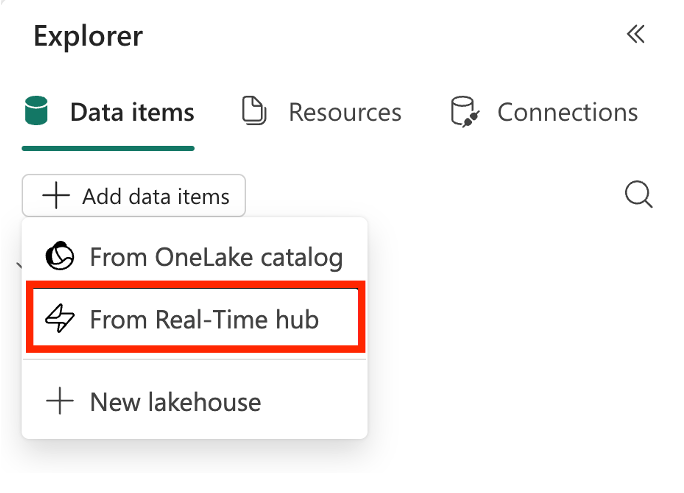
Выберите "Добавить элементы данных" на вкладке "Элементы данных", а затем выберите "Из Real-Time hub" в раскрывающемся меню.
В диалоговом окне Real-Time концентратора найдите целевой поток событий, который требуется запросить с различными параметрами поиска и фильтрации.
Добавьте поток событий в среду записной книжки.
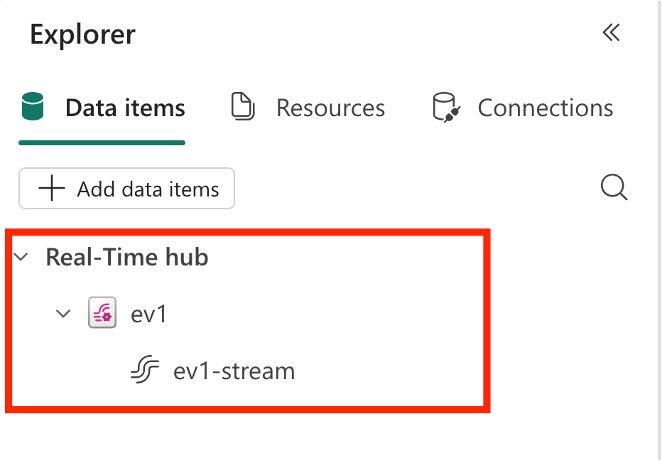
После добавления элемента потока событий он появится под узлом хаба Real-Time в обозревателе объектов записной книжки с именем этого элемента, после расширения узла, вы увидите поток по умолчанию или производный поток в элементе потока событий.
Чтение потоковых данных из потока событий:
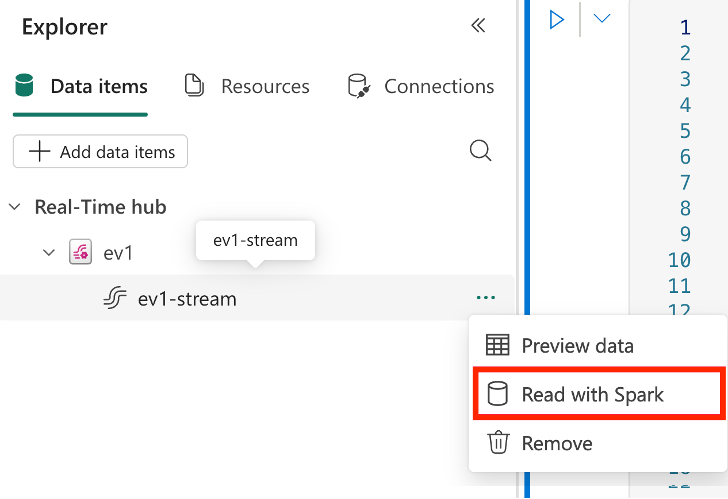
В контекстном меню элемента потока событий в обозревателе объектов выберите Read with Spark , чтобы создать предварительно настроенную ячейку кода для чтения из выбранного потока событий.
В созданной ячейке кода можно использовать следующий фрагмент кода PySpark для чтения потоковых данных из потока событий:
from pyspark.sql import SparkSession
from pyspark.sql.functions import col
from pyspark.sql.types import StringType
from pyspark.sql.dataframe import DataFrame

eventstream_options = {
    "eventstream.itemid": __in_eventstream_item_id,
    "eventstream.datasourceid": __in_eventstream_datasource_id
}

# Read from Kafka using the config map
df_raw = spark.readStream.format("kafka").options(**eventstream_options).load()

decoded_df = df_raw.select(
    col("key").cast(StringType()).alias("key"),
    col("value").cast(StringType()).alias("value"),
    col("partition"),
    col("offset")
)

def showDf(x:DataFrame, y:int):
    x.show()

# Print messages to the console
query = decoded_df.writeStream.foreachBatch(showDf).outputMode("append").start()
query.awaitTermination()
Значения параметров
eventstream.itemidиeventstream.datasourceidавтоматически заполняются в ячейке параметров над этой ячейкой кода.Замечание
Для каждого выбора в Чтение с помощью Spark создается новая ячейка кода с автоматически заполненными необходимыми параметрами, а для элемента Eventstream создается новая записная книжка назначения, где
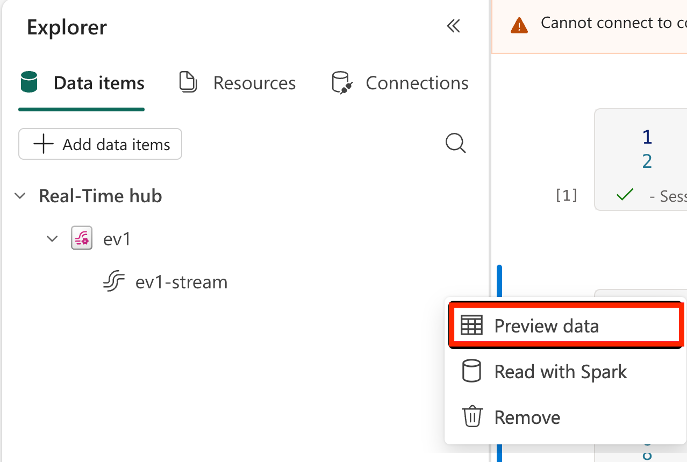
eventstream.datasourceidявляется уникальным для каждого назначения записной книжки. Для одного элемента записной книжки рекомендуется задать его один раз в качестве назначения для одного элемента Eventstream, чтобы избежать создания нескольких назначений.Перед выполнением любого задания можно также просмотреть потоковые данные, нажав кнопку предварительного просмотра данных в контекстном меню элемента Eventstream. На боковой панели появится снимок данных потоковой передачи рядом с ноутбуком.
Добавьте записную книжку в качестве назначения: Вы также можете добавить записную книжку в качестве назначения для потока событий, чтобы начать принимать данные в поток событий непосредственно из записной книжки. Дополнительные сведения см. в разделе "Добавление назначения записной книжки Spark" в поток событий.
Conclusion
Интеграция eventstream в Fabric с ноутбуками с помощью Spark Structured Streaming позволяет бесшовно обрабатывать и анализировать данные в реальном времени. Следуя инструкциям, описанным в этой статье, вы легко подключаетесь к eventstream, читаете потоковые данные и выполняете аналитику в реальном времени с помощью знакомых API Spark. Эта интеграция открывает новые возможности для создания приложений в реальном времени и получения инсайтов из потоковой передачи данных внутри экосистемы Fabric.
Связанный контент
Чтобы узнать больше о работе с eventstreams и тетрадями в Fabric, ознакомьтесь со следующими ресурсами