Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Используйте служебные программы записной книжки для запуска записной книжки, параллельного запуска нескольких записных книжек или выхода из записной книжки со значением. Чтобы получить общие сведения о доступных методах, используйте следующую команду:
notebookutils.notebook.help()
В следующей таблице перечислены доступные методы запуска и оркестрации ноутбуков:
| Метод | Signature | Описание |
|---|---|---|
run |
run(path: str, timeout_seconds: int = 90, arguments: dict = None, workspace: str = ""): str |
Запускает ноутбук и возвращает значение выхода. |
runMultiple |
runMultiple(dag: Any, config: dict = None): dict[str, dict[str, Any]] |
Запускает несколько ноутбуков одновременно с поддержкой зависимостей. |
validateDAG |
validateDAG(dag: Any): bool |
Проверяет, правильно ли структурировано определение DAG. |
exit |
exit(value: str): None |
Завершает текущую записную книжку со значением. |
Сведения об операциях CRUD с записной книжкой (создание, получение, обновление, удаление, перечисление) см. в разделе "Управление артефактами записной книжки".
Замечание
Параметр config в runMultiple() доступен только в Python. Scala и R не поддерживают этот параметр.
Замечание
Служебные программы записной книжки не применимы для определений заданий Apache Spark (SJD).
Ссылка на записную книжку
Метод run() ссылается на блокнот и возвращает его код завершения. Вызовы вложенных функций можно запускать в блокноте в интерактивном режиме или в конвейерной обработке. Записная книжка, на которую ссылаются, выполняется в Spark-пуле той же записной книжки, которая вызывает эту функцию.
notebookutils.notebook.run("notebook name", <timeout_seconds>, <arguments>, <workspace>)
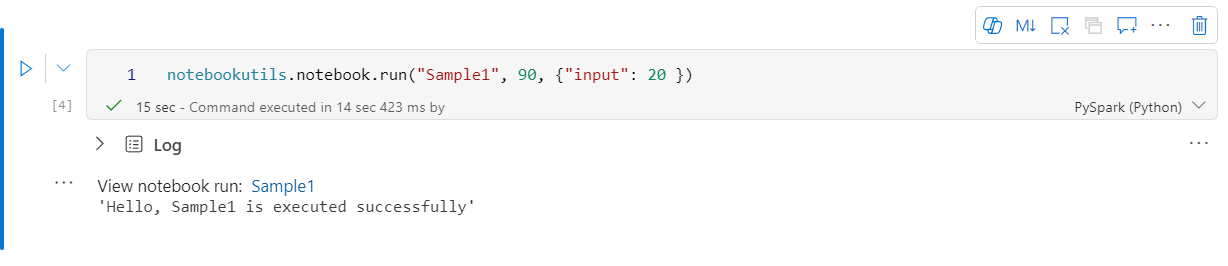
Рассмотрим пример.
notebookutils.notebook.run("Sample1", 90, {"input": 20 })
Возвращаемое значение
Метод run() возвращает точную строку, переданную notebookutils.notebook.exit(value) в дочернюю записную книжку. Если exit() не вызывается в дочернем блокноте, возвращается пустая строка ("").
Записные книжки Fabric также поддерживают ссылки на записные книжки в разных рабочих областях, указав идентификатор рабочей области.
notebookutils.notebook.run("Sample1", 90, {"input": 20 }, "fe0a6e2a-a909-4aa3-a698-0a651de790aa")
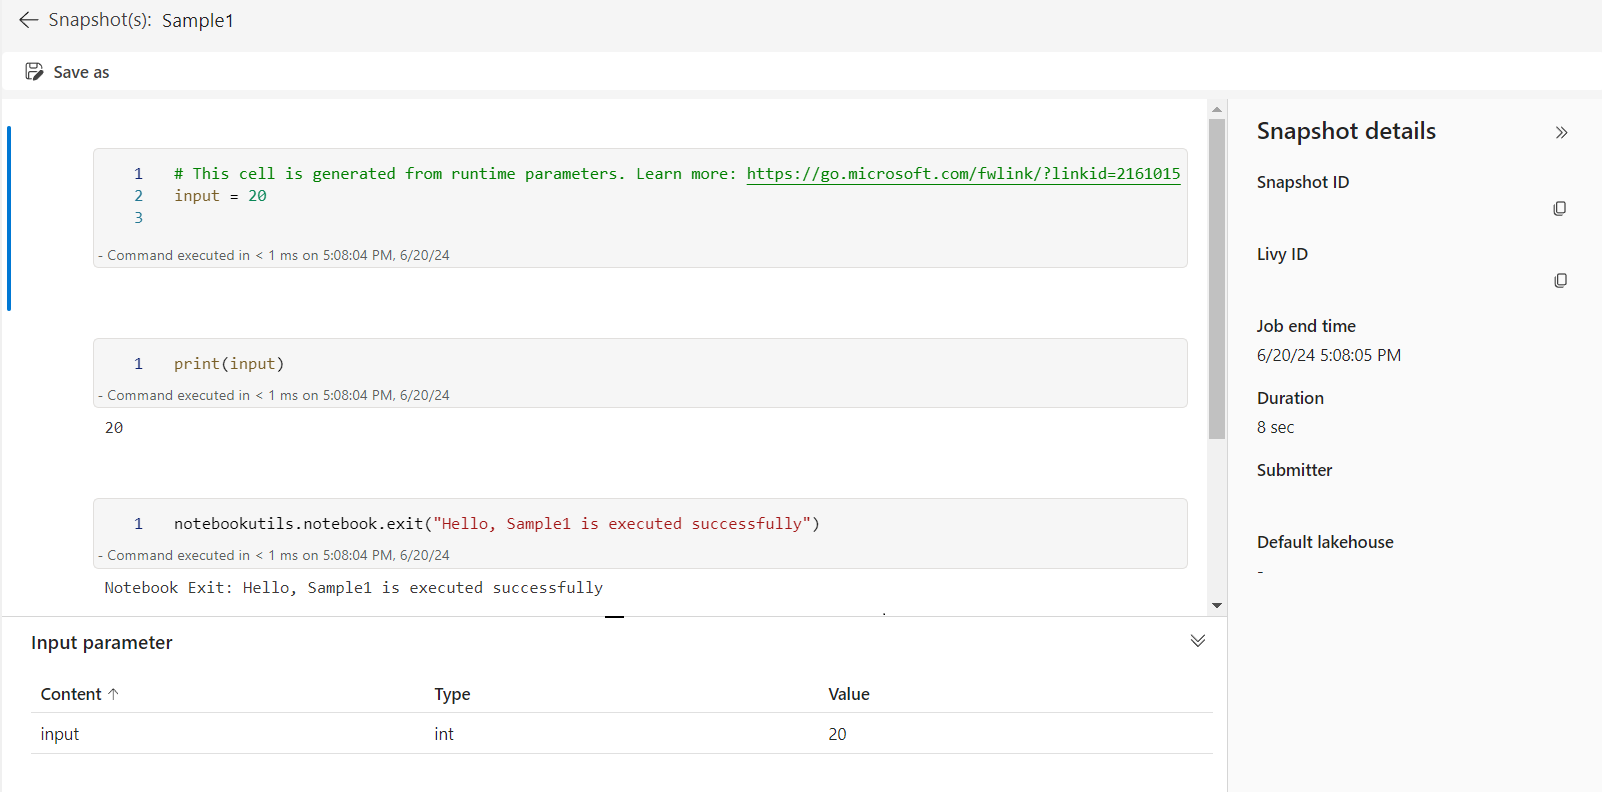
Откройте ссылку на снимок состояния в выводе ячейки, чтобы проверить эталонный прогон. Снимок записывает результаты выполнения и помогает с отладкой указанного ноутбука.
Настройте дочерние записные книжки для получения параметров
При создании дочерней записной книжки, вызываемой через run() или runMultiple(), настройте параметрическую ячейку, чтобы записная книжка получила аргументы от родительской записной книжки.
- Создайте ячейку кода со значениями параметров по умолчанию.
- Пометьте ячейку в качестве ячейки параметров, выбрав "Пометить ячейку" в качестве параметров в пользовательском интерфейсе записной книжки.
- Во время выполнения значения ячейки параметра заменяются аргументами, передаваемыми из родительского элемента.
# This cell should be marked as "parameters" cell
# Default values are overridden when the notebook is called
date = "2024-01-01"
region = "US"
Подсказка
Значения выхода всегда являются строками. Если требуется числовое значение в родительской записной книжке, преобразуйте результат после извлечения (например, int(result)).
Рекомендации
- Межпространственная справочная записная книжка поддерживается, начиная с версии среды выполнения 1.2 и выше.
- Если вы используете файлы в разделе "Ресурс записной книжки", используйте
notebookutils.nbResPathв указанной записной книжке, чтобы убедиться, что она указывает на ту же папку, что и в интерактивном запуске. - Ссылка запуска позволяет дочерним записным книжкам осуществлять запуск только в том случае, если они используют то же озеро данных, что и родительское, наследуют озеро данных родительского или если ни в одной из них озеро данных не определено. Выполнение блокируется, если дочерний блокнот указывает на другой lakehouse, чем родительский блокнот. Чтобы обойти эту проверку, задайте
useRootDefaultLakehouse: Trueв аргументах. - Не вызывайте
notebookutils.notebook.exit(value)внутриtry-catchблока. Вызов выхода не вступит в силу при обработке исключений.
Параллельный запуск нескольких ноутбуков
Используйте notebookutils.notebook.runMultiple() для параллельного запуска нескольких ноутбуков или по заранее заданной топологической структуре. API реализован с использованием многопоточности в сеансе Spark, что означает, что ссылающиеся блокноты разделяют вычислительные ресурсы.
С помощью notebookutils.notebook.runMultiple():
Одновременно выполняйте несколько блокнотов, не дожидаясь завершения каждого из них.
Укажите зависимости и порядок выполнения записных книжек с помощью простого формата JSON.
Оптимизируйте использование вычислительных ресурсов Spark и уменьшите затраты на проекты Fabric.
Просматривайте снимки каждой записи запуска записной книжки в результатах, чтобы было удобно отлаживать и отслеживать задачи записной книжки.
Получите результат выполнения каждой выполняемой задачи и используйте их в зависимых задачах.
Запустите notebookutils.notebook.help("runMultiple") , чтобы просмотреть дополнительные примеры и сведения об использовании.
Запустите простой список блокнотов
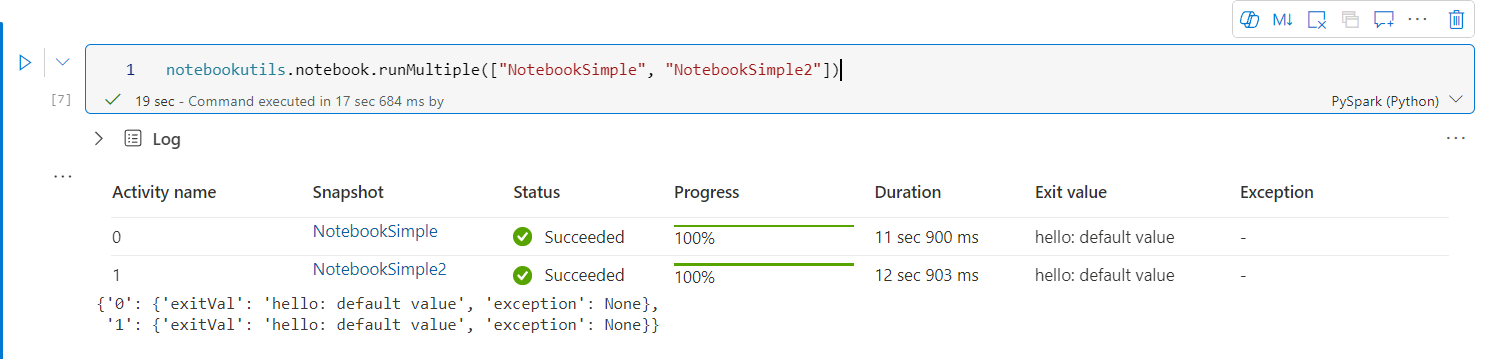
В следующем примере запускается список тетрадей параллельно:
Результат выполнения корневой записной книжки выглядит следующим образом:
Возвращаемое значение
Метод runMultiple() возвращает словарь, в котором каждый ключ — это имя действия, а каждое значение — словарь со следующими ключами:
-
exitVal: строка, возвращаемая вызовомexit()дочерней записной книжки, или пустая строка, еслиexit()не был вызван. -
exception: объект ошибки, если действие завершилось сбоем илиNoneесли оно выполнено успешно.
Запуск записных книжек со структурой DAG
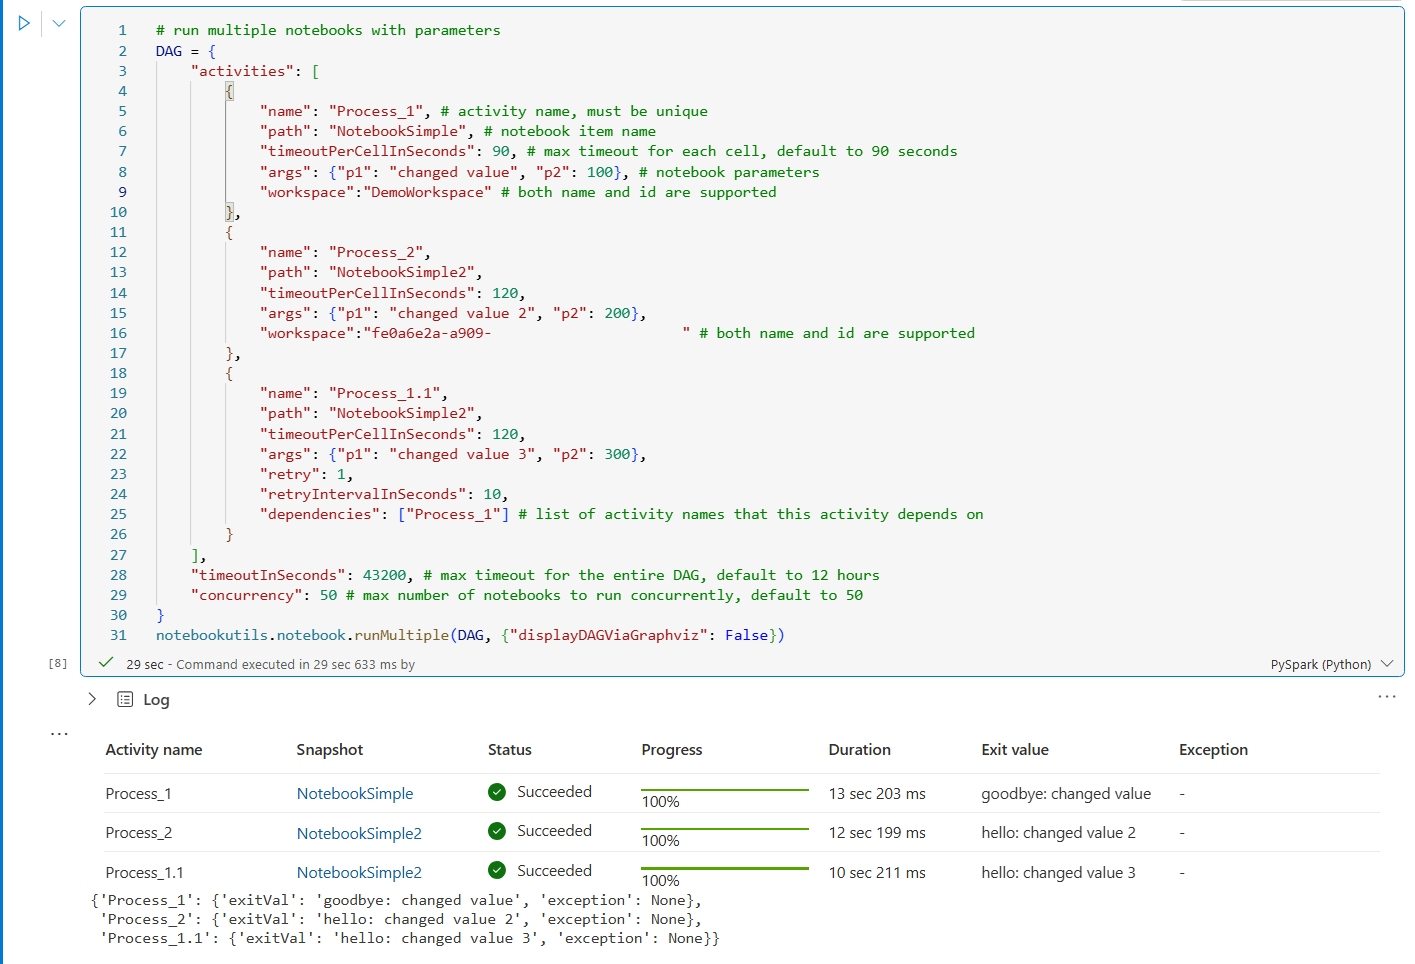
В следующем примере записные книжки выполняются в структуре DAG с помощью notebookutils.notebook.runMultiple().
# run multiple notebooks with parameters
DAG = {
    "activities": [
        {
            "name": "Process_1", # activity name, must be unique
            "path": "NotebookSimple", # notebook item name
            "timeoutPerCellInSeconds": 90, # max timeout for each cell, default to 90 seconds
            "args": {"p1": "changed value", "p2": 100}, # notebook parameters
            "workspace":"WorkspaceName" # both name and id are supported
        },
        {
            "name": "Process_2",
            "path": "NotebookSimple2",
            "timeoutPerCellInSeconds": 120,
            "args": {"p1": "changed value 2", "p2": 200},
            "workspace":"id" # both name and id are supported
        },
        {
            "name": "Process_1.1",
            "path": "NotebookSimple2",
            "timeoutPerCellInSeconds": 120,
            "args": {"p1": "changed value 3", "p2": 300},
            "retry": 1,
            "retryIntervalInSeconds": 10,
            "dependencies": ["Process_1"] # list of activity names that this activity depends on
        }
    ],
    "timeoutInSeconds": 43200, # max timeout for the entire DAG, default to 12 hours
    "concurrency": 12 # max number of notebooks to run concurrently, default to 3x CPU cores, 0 means unlimited
}
notebookutils.notebook.runMultiple(DAG, {"displayDAGViaGraphviz": False})
Результат выполнения корневой записной книжки выглядит следующим образом:
Справочник по параметрам DAG
В следующей таблице описано каждое поле, используемое в определении DAG:
| Поле | Уровень | Обязательный | Описание |
|---|---|---|---|
activities |
Корень | Да | Список объектов активности, определяющих блокноты для выполнения. |
timeoutInSeconds |
Корень | Нет | Максимальный таймаут для всего DAG. Значение по умолчанию — 43200 (12 часов). |
concurrency |
Корень | Нет | Максимальное количество записных книжек для параллельного выполнения. Значение по умолчанию — в 3 раза больше доступного количества ядер ЦП. Задайте это значение явным образом, если требуется более жесткий контроль или использование 0 для неограниченного параллелизма. |
name |
Activity | Да | Уникальное имя активности. Используется для идентификации результатов и определения зависимостей. |
path |
Activity | Да | Имя элемента записной книжки или путь для выполнения. |
timeoutPerCellInSeconds |
Activity | Нет | Максимальный таймаут для каждой ячейки в дочернем ноутбуке. Значение по умолчанию — 90 секунд. |
args |
Activity | Нет | Словарь параметров, передаваемых дочерней записной книжке. |
workspace |
Activity | Нет | Имя или идентификатор рабочей области, в которой находится записная книжка. По умолчанию дочерняя записная книжка выполняется в той же рабочей области, что и вызывающий. |
retry |
Activity | Нет | Число попыток повтора при сбое действия. Значение по умолчанию — 0. |
retryIntervalInSeconds |
Activity | Нет | Время ожидания в секундах между повторными попытками. Значение по умолчанию — 0. |
dependencies |
Activity | Нет | Список названий активностей, которые должны быть выполнены до запуска этого действия. |
Ссылочные значения выхода между действиями
Вы можете использовать args выражение, чтобы ссылаться на значение выхода зависимой активности в поле @activity(). Этот шаблон позволяет передавать данные между записными книжками в DAG.
DAG = {
    "activities": [
        {
            "name": "Extract",
            "path": "ExtractData",
            "timeoutPerCellInSeconds": 120,
            "args": {"source": "prod_db"}
        },
        {
            "name": "Transform",
            "path": "TransformData",
            "timeoutPerCellInSeconds": 180,
            "args": {
                "data_path": "@activity('Extract').exitValue()"
            },
            "dependencies": ["Extract"]
        }
    ]
}

results = notebookutils.notebook.runMultiple(DAG)
Подсказка
Используйте выражение @activity('activity_name').exitValue() в поле args, чтобы передавать результаты из одного действия в другое внутри DAG.
Создание динамической DAG
Структуры DAG можно создавать программным способом для таких сценариев, как разветвлённая обработка в нескольких разделах.
def create_fan_out_dag(partitions):
    activities = []

    for partition in partitions:
        activities.append({
            "name": f"Process_{partition}",
            "path": "ProcessPartition",
            "timeoutPerCellInSeconds": 180,
            "args": {"partition": partition}
        })

    activities.append({
        "name": "Aggregate",
        "path": "AggregateResults",
        "timeoutPerCellInSeconds": 120,
        "dependencies": [f"Process_{p}" for p in partitions]
    })

    return {"activities": activities, "concurrency": 25}

partitions = ["2024-01", "2024-02", "2024-03", "2024-04"]
dag = create_fan_out_dag(partitions)

results = notebookutils.notebook.runMultiple(dag)
Валидация DAG
Используйте validateDAG() для проверки допустимости структуры DAG перед выполнением. Он перехватывает такие проблемы, как повторяющиеся имена действий, отсутствующие зависимости и циклические ссылки.
Возвращаемое значение
Метод validateDAG() возвращает True , если структура DAG действительна или вызывает исключение, если проверка завершается ошибкой.
Подсказка
Всегда вызывайте validateDAG() раньше runMultiple() в рабочих процессах, чтобы поймать структурные ошибки раньше.
Обработка сбоев runMultiple
Метод runMultiple() возвращает словарь, где каждый ключ — это имя действия, и каждое значение содержит exitVal (строку) и exception (объект ошибки или None). Вы можете проверить частичные результаты, даже если некоторые действия завершаются ошибкой:
from notebookutils.common.exceptions import RunMultipleFailedException

try:
    results = notebookutils.notebook.runMultiple(DAG)
except RunMultipleFailedException as ex:
    results = ex.result

for activity_name, result in results.items():
    if result["exception"]:
        print(f"{activity_name} failed: {result['exception']}")
    else:
        print(f"{activity_name} succeeded: {result['exitVal']}")
Рекомендации
- Степень параллелизма выполнения нескольких записных книжек ограничена общим доступным вычислительным ресурсом сеанса Spark.
- Число параллельных записных книжек по умолчанию составляет 3 раза больше, чем количество доступных ядер ЦП. Это значение можно настроить, но чрезмерное параллелизм может привести к проблемам стабильности и производительности из-за высокого использования вычислительных ресурсов. Если возникают проблемы, рассмотрите возможность разделения записных книжек на несколько
runMultipleвызовов или уменьшения параллелизма, изменив поле параллелизма в параметре DAG. - Время ожидания по умолчанию для всего DAG составляет 12 часов, а время ожидания по умолчанию для каждой ячейки дочерней записной книжки составляет 90 секунд. Вы можете изменить время ожидания, задав поля timeoutInSeconds и timeoutPerCellInSeconds в параметре DAG.
- Настройте
retryиretryIntervalInSecondsдля деятельностей, которые могут потерпеть неудачу из-за временных проблем, таких как время ожидания сети или временная недоступность службы. - Параллельные ноутбуки совместно используют вычислительные ресурсы в едином сеансе Spark. Отслеживайте использование ресурсов, чтобы избежать нехватки памяти и конфликтов ЦП.
Выход из ноутбука
Метод exit() завершает записную книжку со значением. Вызовы вложенных функций можно запускать в блокноте в интерактивном режиме или в конвейерной обработке.
При вызове функции
exit()в интерактивном режиме из записной книжки, записная книжка Fabric выдает исключение, пропускает выполнение последующих ячеек и сохраняет сеанс Spark активным.При управлении записной книжкой в потоке, который вызывает
exit()функцию, активность записной книжки возвращается со значением выхода. Это завершает запуск конвейера и останавливает сеанс Spark.При вызове
exit()функции в записной книжке, на которую ссылается ссылка, Fabric Spark останавливает дальнейшее выполнение записной книжки, на которую ссылается ссылка, и продолжает выполнять следующие ячейки в главной записной книжке, которая вызываетrun()функцию. Например: Ноутбук Notebook1 содержит три ячейки и вызывает функциюexit()во второй ячейке. Записная книжка Notebook2 содержит пять ячеек и вызываетrun(notebook1)в третьей ячейке. При запуске Notebook2 Записная книжка 1 останавливается на второй ячейке при достиженииexit()функции. Notebook2 продолжает выполнять свои четвертую и пятую ячейки.
Поведение возврата
Метод exit() не возвращает значение. Он завершает выполнение текущей записной книжки и передает указанную строку вызывающей записной книжке или конвейеру.
Замечание
Функция exit() перезаписывает текущие выходные данные ячейки. Чтобы избежать потери выходных данных других строк кода, вызовите notebookutils.notebook.exit() в отдельной ячейке.
Это важно
Не вызывайте notebookutils.notebook.exit() внутри try-catch блока. Выход не будет действовать, если он обернут в обработку исключений. Вызов exit() должен находиться на верхнем уровне кода для правильной работы.
Рассмотрим пример.
Записная книжка Sample1 содержит следующие две ячейки:
Ячейка 1 определяет входной параметр со значением по умолчанию, равным 10.
Ячейка 2 выходит из записной книжки с входным значением.
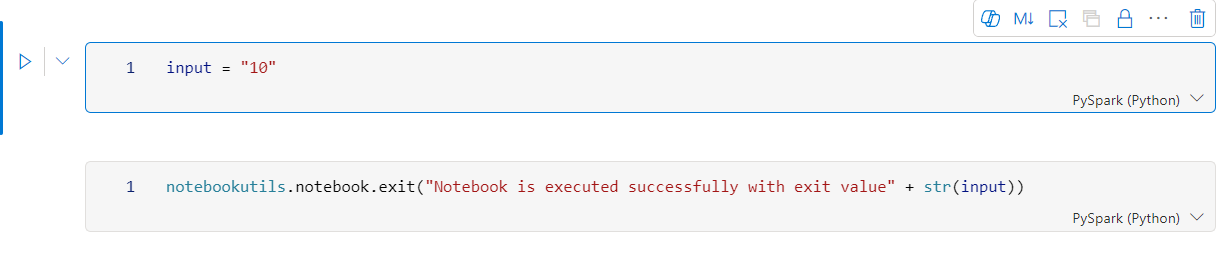
Вы можете запустить Sample1 в другой записной книжке со значениями по умолчанию:
exitVal = notebookutils.notebook.run("Sample1")
print (exitVal)
Выходные данные:
10
Вы можете запустить Sample1 в другом ноутбуке и установить значение input на 20:
exitVal = notebookutils.notebook.run("Sample1", 90, {"input": 20 })
print (exitVal)
Выходные данные:
20