Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Используя Fabric SDK для оценки, вы можете программно проверить, насколько хорошо ваш агент данных отвечает на вопросы естественного языка. Используя простой интерфейс Python, вы можете определять эталонные примеры, запускать оценку и анализировать результаты — всё это прямо в среде ноутбука. Этот процесс помогает проверить точность, отладить ошибки и уверенно улучшить работу агента перед развертыванием в продакшене.
Это важно
Эта функция доступна в предварительной версии.
Предпосылки
- Платная емкость Fabric F2 или более высокой или Power BI Premium для емкости (P1 или выше) с включенной функцией Microsoft Fabric.
- Включите межрегиональную обработку и межрегиональное хранение для искусственного интеллекта на основе требований, описанных в настройках клиента агента данных Fabric.
- По крайней мере один из этих источников данных с данными: хранилище, lakehouse (озеро данных), семантическая модель Power BI, база данных KQL, зеркальная база данных или онтология. У вас должен быть доступ на чтение к источнику данных.
Установка пакета SDK агента данных
Чтобы начать программную оценку вашего агента данных Fabric, установите агент данных Fabric Python SDK. Этот SDK предоставляет инструменты и методы, необходимые для взаимодействия с вашим агентом данных, проведения оценок и записи результатов. Установите последнюю версию, выполнив следующую команду в записной книжке:
%pip install -U fabric-data-agent-sdk
Этот шаг гарантирует, что новейшие функции и исправления доступны в пакете SDK.
Загрузка набора данных эталонной истины
Чтобы оценить ваш агент данных Fabric, вам нужен набор примерных вопросов вместе с ожидаемыми ответами. Используйте эти вопросы, чтобы проверить, насколько точно агент отвечает на реальные запросы.
Определите эти вопросы непосредственно в вашем коде, используя pandas DataFrame:
import pandas as pd

# Define a sample evaluation set with user questions and their expected answers.
# You can modify the question/answer pairs to match your scenario.
df = pd.DataFrame(
    columns=["question", "expected_answer"],
    data=[
        ["Show total sales for Canadian Dollar for January 2013", "46,117.30"],
        ["What is the product with the highest total sales for Canadian Dollar in 2013", "Mountain-200 Black, 42"],
        ["Total sales outside of the US", "19,968,887.95"],
        ["Which product category had the highest total sales for Canadian Dollar in 2013", "Bikes (Total Sales: 938,654.76)"]
    ]
)
Или, если у вас есть уже существующий набор данных для оценки, загрузите его из CSV-файла со столбцами question и expected_answer:
# Load questions and expected answers from a CSV file
input_file_path = "/lakehouse/default/Files/Data/Input/curated_2.csv"
df = pd.read_csv(input_file_path)
Этот набор данных служит входными данными для проведения автоматизированных оценок вашего агента данных для оценки точности и покрытия.
Оцените и проанализируйте агента данных
Следующий шаг — выполнить оценку с помощью функции evaluate_data_agent . Эта функция сравнивает ответы агента с ожидаемыми результатами и сохраняет метрики оценки.
Note
Для этого шага требуется агент данных, уже опубликованный на этапе, который вы оцениваете (production или sandbox). Если у вас его ещё нет, смотрите раздел «Создать агент данных Fabric».
from fabric.dataagent.evaluation import evaluate_data_agent

# Name of your data agent
data_agent_name = "AgentEvaluation"

# (Optional) Name of the workspace if the data agent is in a different workspace
workspace_name = None

# (Optional) Name of the output table to store evaluation results (default: "evaluation_output")
# Two tables will be created:
# - "<table_name>": contains summary results (e.g., accuracy)
# - "<table_name>_steps": contains detailed reasoning and step-by-step execution
table_name = "demo_evaluation_output"

# Specify the data agent stage: "production" (default) or "sandbox"
data_agent_stage = "production"

# Run the evaluation and get the evaluation ID
try:
    evaluation_id = evaluate_data_agent(
        df,
        data_agent_name,
        workspace_name=workspace_name,
        table_name=table_name,
        data_agent_stage=data_agent_stage
    )
    print(f"Unique ID for the current evaluation run: {evaluation_id}")
except Exception as e:
    print(f"Evaluation failed: {e}")
После завершения запуска вы видите результат, похожий на следующий текст:
Unique ID for the current evaluation run: <evaluation-id>
Получение сводки по оценке
После выполнения оценки вы можете получить общий обзор результатов с помощью функции get_evaluation_summary . Эта функция даёт информацию о том, насколько хорошо ваш агент данных работал в целом, включая метрики, такие как количество ответов, совпадающих с ожидаемыми ответами.
from fabric.dataagent.evaluation import get_evaluation_summary

# Retrieve a summary of the evaluation results
summary_df = get_evaluation_summary(table_name)
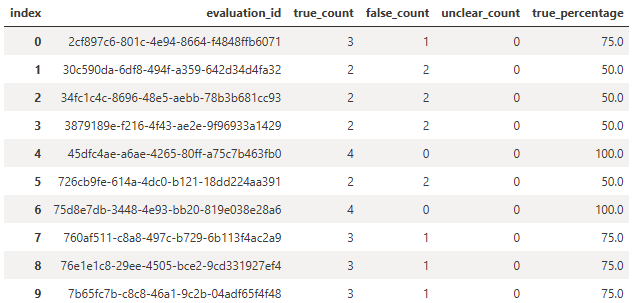
По умолчанию эта функция ищет таблицу с именем evaluation_output. Если при оценке вы указали пользовательское имя таблицы (например demo_evaluation_output), передайте это имя в table_name качестве аргумента.
Возвращаемый кадр данных содержит статистические метрики, такие как количество правильных, неправильных или неясных ответов. Этот результат помогает быстро оценить точность агента и определить области для улучшения.
Проверка подробных результатов оценки
Чтобы глубже разобраться, как ваш агент данных отвечал на каждый отдельный вопрос, используйте функцию get_evaluation_details . Эта функция возвращает подробный анализ выполнения оценки, включая фактические ответы агента, соответствие ожидаемым ответам и ссылку на поток оценки (видимый только пользователю, который выполнил оценку).
from fabric.dataagent.evaluation import get_evaluation_details

# Table name used during evaluation
table_name = "demo_evaluation_output"

# Whether to return all evaluation rows (True) or only failures (False)
get_all_rows = False

# Whether to print a summary of the results
verbose = True

# Retrieve evaluation details for a specific run
eval_details = get_evaluation_details(
    evaluation_id,
    table_name,
    get_all_rows=get_all_rows,
    verbose=verbose
)
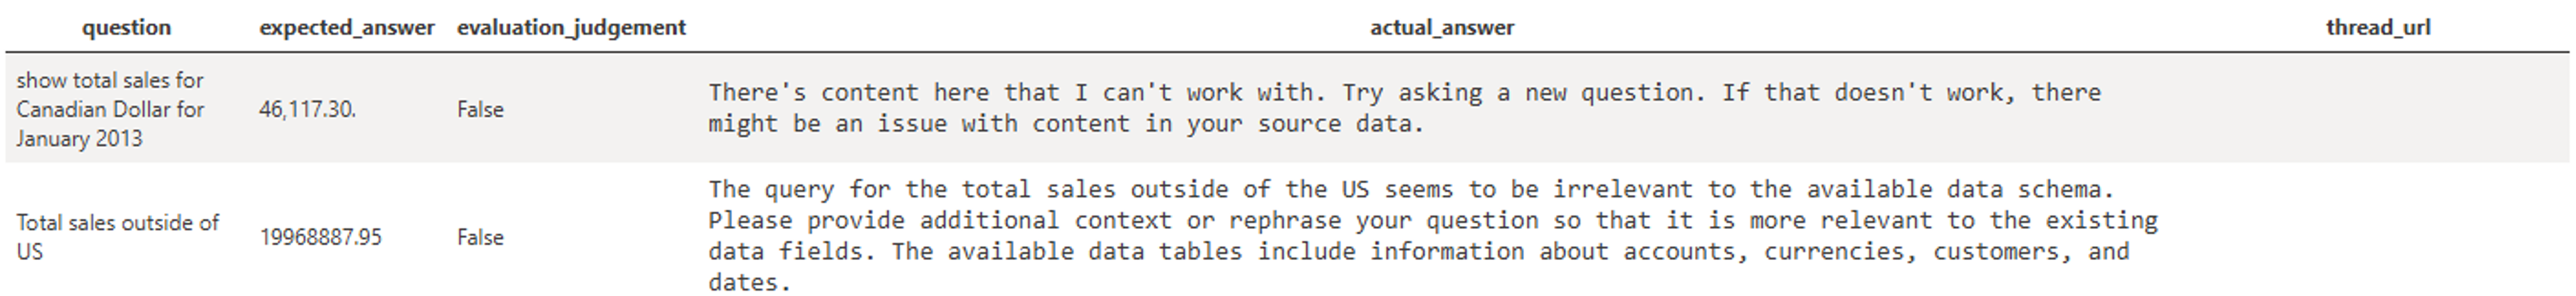
Настройте ваш запрос для оценки
По умолчанию Fabric SDK использует встроенный запрос для оценки соответствия фактического ответа агента данных ожидаемому. Однако вы можете предоставить свой собственный запрос для более тонких или специфических для каждой области оценок, используя этот critic_prompt параметр.
Настраиваемый запрос должен содержать заполнители {query}, {expected_answer}, и {actual_answer}. В процессе оценки эти заполнители динамически заменяются для каждого вопроса.
from fabric.dataagent.evaluation import evaluate_data_agent

# Define a custom prompt for evaluating agent responses
critic_prompt = """
    Given the following query, expected answer, and actual answer, please determine if the actual answer is equivalent to expected answer. If they are equivalent, respond with 'yes'.

    Query: {query}

    Expected Answer:
    {expected_answer}

    Actual Answer:
    {actual_answer}

    Is the actual answer equivalent to the expected answer?
"""

# Name of the data agent
data_agent_name = "AgentEvaluation"

# Run evaluation using the custom critic prompt
evaluation_id = evaluate_data_agent(df, data_agent_name, critic_prompt=critic_prompt)
Эта функция особенно полезна, если:
- Вы хотите применять более мягкие или более строгие критерии того, что считать совпадением.
- Ваши ожидаемые и реальные ответы могут различаться по формату, но всё равно оставаться семантически эквивалентными.
- Вам нужно уловить нюансы, относящиеся к конкретной области, в оценке ответов.
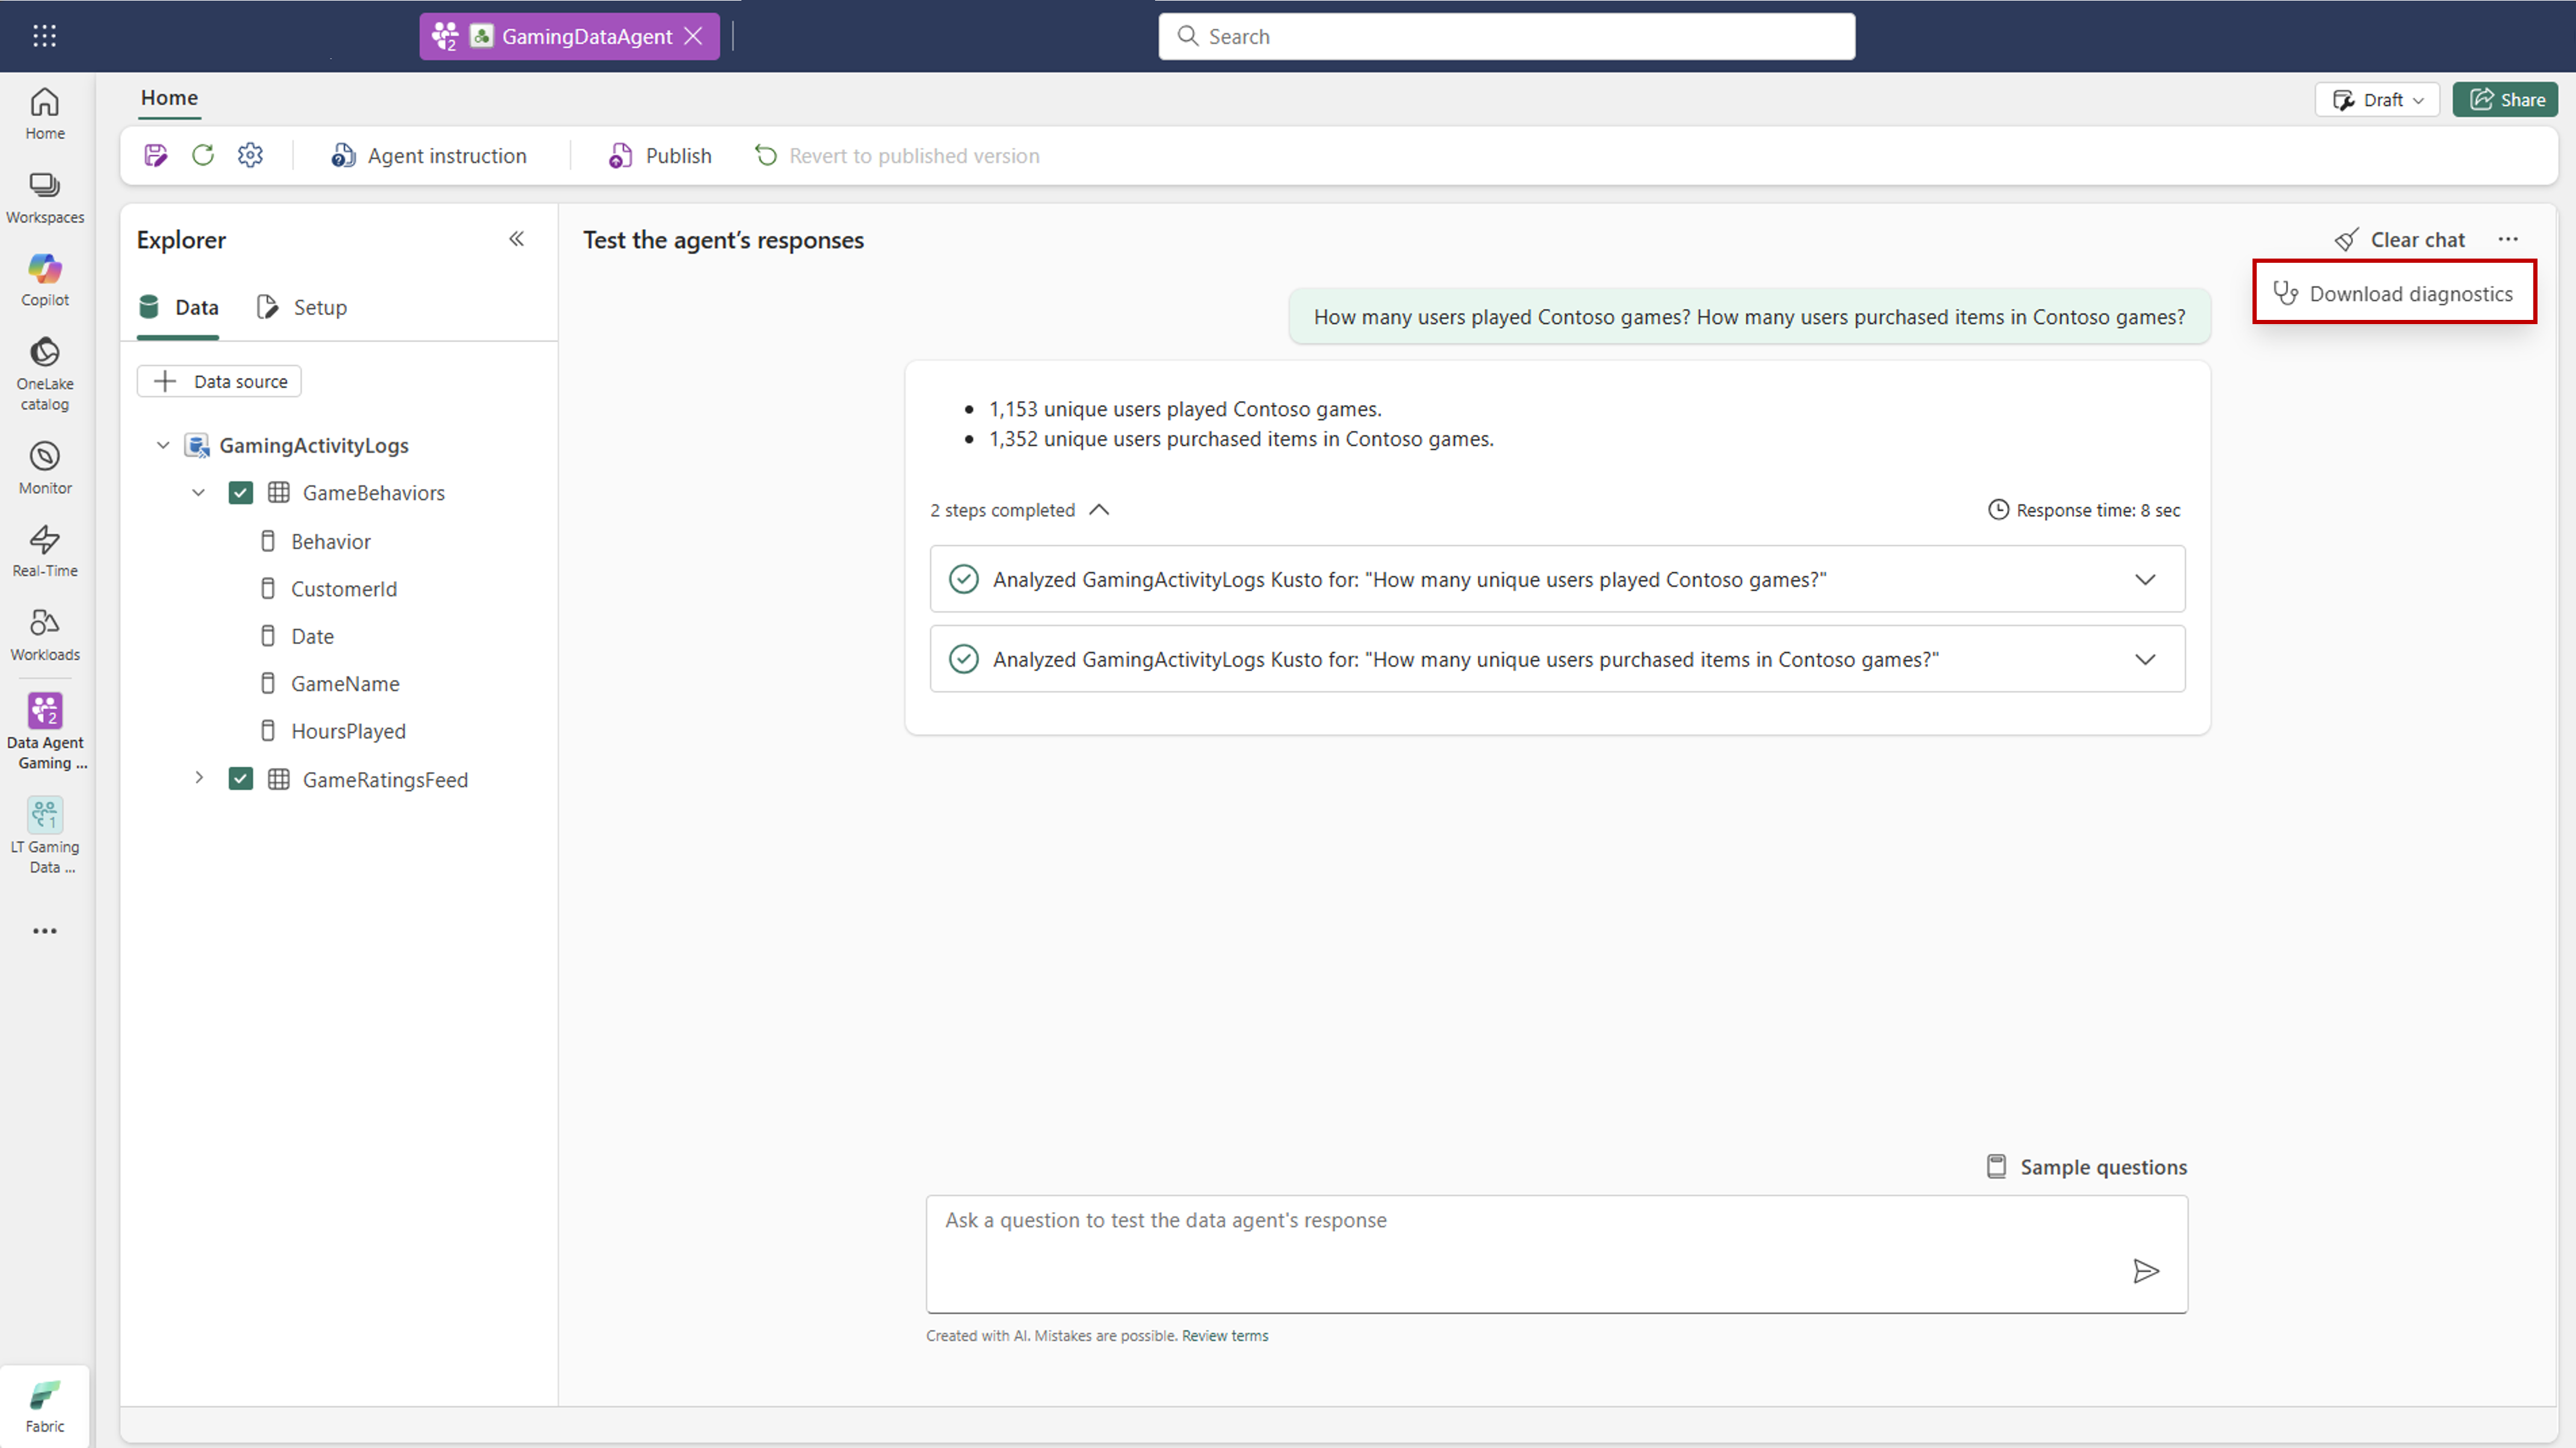
Кнопка диагностики
Кнопка «Диагностика» позволяет скачать полный снимок конфигурации и шагов выполнения вашего Data Agent. Этот экспорт включает такие детали, как настройки источника данных, применённые инструкции, примеры используемых запросов и основные шаги, которые агент данных выполнял для генерации своего ответа.
Используйте эту функцию при работе с служба поддержки Майкрософт или при устранении неожиданных поведений. Просматривая загруженный файл, вы можете увидеть, как агент обработал ваш запрос, какие конфигурации были применены и где возникли возможные проблемы. Такой уровень прозрачности облегчает отладку и оптимизацию производительности вашего Data Agent.
Troubleshooting
| Проблема | Причина | Резолюция |
|---|---|---|
| Агент данных не найден | Неверно значение data_agent_name или workspace_name, либо агент не опубликован. |
Проверьте имя агента и рабочее пространство, а также убедитесь, что агент опубликован в указанном data_agent_stage. |
| Пустые или отсутствующие результаты | Название таблицы не совпадает с тем, которое использовалось во время evaluate_data_agent. |
Передайте один и тот же table_name в get_evaluation_details и get_evaluation_summary. |
message_url недоступна |
Потоки оценки видны только пользователю, который проводил оценку. | Повторите оценку под своим именем, чтобы получить доступ к ссылкам на темы. |
| Настраиваемый запрос не действует или вызывает ошибки |
critic_prompt не содержит обязательных заполнителей. |
Включите {query}, {expected_answer}, и {actual_answer} в свой запрос. |
| Ошибка разрешения или пропускной способности | Отсутствует ресурс уровня F2 или выше либо доступ на чтение к источнику данных. | Подтвердите необходимые требования, включая пропускную способность и доступ к чтению источников данных. |