Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
В этом учебном пособии представлен сквозный пример рабочего процесса в области Data Science. Сценарий строит модель обнаружения мошенничества с использованием алгоритмов машинного обучения, обученных на исторических данных. Затем она использует модель для обнаружения будущих мошеннических транзакций.
В этом руководстве рассматриваются следующие действия.
- Установка пользовательских библиотек
- Загрузка данных
- Понимание и обработка данных с помощью анализа аналитических данных
- Используйте scikit-learn для обучения модели машинного обучения и отслеживайте эксперименты с помощью функций автологирования MLflow и Fabric.
- Сохранение и регистрация модели machine learning с высокой производительностью
- Загрузка модели machine learning для оценки и прогнозирования
Необходимые условия
Получите подписку Microsoft Fabric. Или зарегистрируйте бесплатную пробную версию Microsoft Fabric.
Войдите в Microsoft Fabric.
Перейдите к Fabric с помощью переключателя интерфейса в левой нижней части домашней страницы.
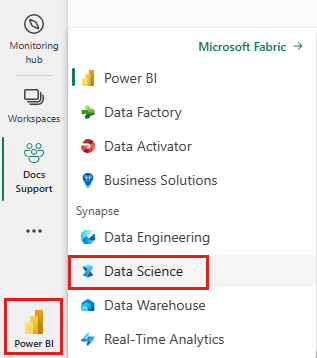
- При необходимости создайте lakehouse Microsoft Fabric, как это описано в разделе Создание lakehouse в Microsoft Fabric.
Следуйте инструкциям в записной книжке
Чтобы следить за текстом в блокноте, выберите один из следующих вариантов:
- Откройте и запустите встроенную записную книжку.
- Отправьте записную книжку из GitHub.
Открытие встроенной записной книжки
Примерный ноутбук для обнаружения мошенничества сопровождает это руководство.
Чтобы открыть пример записной книжки для этого руководства, следуйте инструкциям в Подготовке системы для учебников по обработке и анализу данных.
Перед началом выполнения кода обязательно подключить lakehouse к ноутбуку.
Импорт записной книжки из GitHub
Записная книжка AIsample — Обнаружение мошенничества.ipynb, сопровождающая это руководство.
Чтобы открыть сопровождающий ноутбук для этого руководства, следуйте инструкциям в для подготовки вашей системы к учебным руководствам по науке о данных, чтобы импортировать ноутбук в рабочую область.
Если вы хотите скопировать и вставить код на этой странице, можно создать новую записную книжку.
Не забудьте подключить lakehouse к блокноту перед началом выполнения кода.
Шаг 1. Установка пользовательских библиотек
Для разработки моделей machine learning или нерегламентированного анализа данных может потребоваться быстро установить пользовательскую библиотеку для сеанса Apache Spark. Существует два варианта установки библиотек.
- Используйте встроенные функции установки (
%pipили%conda) ноутбука для установки библиотеки только в текущем ноутбуке. - Кроме того, можно создать среду Fabric, установить библиотеки из общедоступных источников или отправить в нее пользовательские библиотеки, а затем администратор рабочей области может присоединить среду в качестве значения по умолчанию для рабочей области. Все библиотеки в среде доступны для использования в любых записных книжках и определениях заданий Spark в рабочей области. Дополнительные сведения о средах см. в разделе создание, настройка и использование среды в Microsoft Fabric.
В этом руководстве используйте %pip install, чтобы установить библиотеку imblearn в вашем ноутбуке.
Заметка
Ядро PySpark перезапускается после %pip install запусков. Установите необходимые библиотеки перед запуском любых других ячеек.
# Use pip to install imblearn
%pip install imblearn
Шаг 2. Загрузка данных
Набор данных обнаружения мошенничества содержит транзакции кредитной карты с сентября 2013 года, которые европейские держатели карт сделали в течение двух дней. Набор данных содержит только числовые функции из-за преобразования основного анализа компонентов (PCA), примененного к исходным функциям. PCA преобразовал все функции, кроме Time и Amount. Для защиты конфиденциальности исходные функции или дополнительные фоновые сведения о наборе данных недоступны.
Эти сведения описывают набор данных:
- Признаки
V1,V2,V3,V28являются главными компонентами, полученными с помощью метода главных компонент. - Функция
Timeсодержит прошедшие секунды между транзакцией и первой транзакцией в наборе данных. - Функция
Amount— это сумма транзакции. Эту функцию можно использовать для обучения, зависящего от примеров и чувствительного к затратам. - Столбец
Class— это переменная ответа (целевая переменная). Оно имеет значение1для мошенничества и0в противном случае.
Только 492 транзакции, из 284 807 транзакций, являются мошенническими. Набор данных сильно несбалансирован, так как класс меньшинства (мошеннический) составляет только около 0,172%% всей информации.
В этой таблице показана предварительная версия данных creditcard.csv:
| Время | Версия 1 | Версия 2 | Версия 3 | V4 | V5 | V6 | V7 | V8 | V9 | V10 | Версия 11 | V12 | V13 | V14 | V15 | V16 | V17 | V18 | V19 | Версия 20 | Версия 21 | Версия 22 | Версия 23 | Версия 24 | V25 | V26 | V27 | V28 | Количество | Класс |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | -1.3598071336738 | -0.0727811733098497 | 2.53634673796914 | 1,37815522427443 | -0.338320769942518 | 0.462387777762292 | 0.239598554061257 | 0.0986979012610507 | 0.363786969611213 | 0.0907941719789316 | -0.551599533260813 | -0.617800855762348 | -0.991389847235408 | -0.311169353699879 | 1.46817697209427 | -0.470400525259478 | 0.207971241929242 | 0.0257905801985591 | 0.403992960255733 | 0.251412098239705 | -0.018306777944153 | 0.277837575558899 | -0.110473910188767 | 0.0669280749146731 | 0.128539358273528 | -0.189114843888824 | 0.133558376740387 | -0.0210530534538215 | 149.62 | "0" |
| 0 | 1,19185711131486 | 0.26615071205963 | 0.16648011335321 | 0.448154078460911 | 0.0600176492822243 | -0.0823608088155687 | -0.0788029833323113 | 0.0851016549148104 | -0.255425128109186 | -0.166974414004614 | 1.61272666105479 | 1.06523531137287 | 0.48909501589608 | -0.143772296441519 | 0.635558093258208 | 0.463917041022171 | -0.114804663102346 | -0.183361270123994 | -0.145783041325259 | -0.0690831352230203 | -0.225775248033138 | -0.638671952771851 | 0.101288021253234 | -0.339846475529127 | 0.167170404418143 | 0.125894532368176 | -0.00898309914322813 | 0.0147241691924927 | 2.69 | "0" |
Скачайте набор данных и отправьте его в lakehouse
Определите эти параметры, чтобы использовать эту записную книжку с различными наборами данных:
IS_CUSTOM_DATA = False  # If True, the dataset has to be uploaded manually

TARGET_COL = "Class"  # Target column name
IS_SAMPLE = False  # If True, use only <SAMPLE_ROWS> rows of data for training; otherwise, use all data
SAMPLE_ROWS = 5000  # If IS_SAMPLE is True, use only this number of rows for training

DATA_FOLDER = "Files/fraud-detection/"  # Folder with data files
DATA_FILE = "creditcard.csv"  # Data file name

EXPERIMENT_NAME = "aisample-fraud"  # MLflow experiment name
Этот код скачивает общедоступную версию набора данных, а затем сохраняет ее в Fabric lakehouse.
Важный
Перед запуском записной книжки добавьте lakehouse. В противном случае возникает ошибка.
if not IS_CUSTOM_DATA:
    # Download data files into the lakehouse if they're not already there
    import os, requests

    remote_url = "https://synapseaisolutionsa.z13.web.core.windows.net/data/Credit_Card_Fraud_Detection"
    fname = "creditcard.csv"
    download_path = f"/lakehouse/default/{DATA_FOLDER}/raw"

    if not os.path.exists("/lakehouse/default"):
        raise FileNotFoundError("Default lakehouse not found, please add a lakehouse and restart the session.")
    os.makedirs(download_path, exist_ok=True)
    if not os.path.exists(f"{download_path}/{fname}"):
        r = requests.get(f"{remote_url}/{fname}", timeout=30)
        with open(f"{download_path}/{fname}", "wb") as f:
            f.write(r.content)
    print("Downloaded demo data files into lakehouse.")
Настройка отслеживания экспериментов MLflow
Процесс отслеживания экспериментов сохраняет все соответствующие сведения, связанные с экспериментом, для каждого выполняемого эксперимента. Иногда вы не можете получить лучшие результаты при выполнении определенного эксперимента. В этих случаях остановите эксперимент и попробуйте новый.
Data Science включает функцию автологирования. Эта функция уменьшает объем кода, необходимый для автоматического регистрации параметров, метрик и элементов модели machine learning во время обучения. Эта функция расширяет возможности автологирования MLflow. Он глубоко интегрирован в рабочую нагрузку по Data Science.
С помощью автологирования можно легко отслеживать и сравнивать производительность различных моделей и экспериментов без необходимости отслеживания вручную. Дополнительные сведения см. в разделе Autologging in Microsoft Fabric.
Чтобы отключить автологирование Microsoft Fabric в сеансе записной книжки, вызовите mlflow.autolog() и установите disable=True:.
# Set up MLflow for experiment tracking
import mlflow

mlflow.set_experiment(EXPERIMENT_NAME)
mlflow.autolog(disable=True)  # Disable MLflow autologging
Чтение необработанных данных из лейкхауса
Этот код считывает необработанные данные из озерного хранилища:
df = (
    spark.read.format("csv")
    .option("header", "true")
    .option("inferSchema", True)
    .load(f"{DATA_FOLDER}/raw/{DATA_FILE}")
    .cache()
)
Шаг 3. Выполнение анализа аналитических данных
В этом разделе вы сначала изучите необработанные данные и высокоуровневую статистику. Затем, чтобы преобразовать данные, приведите столбцы к правильным типам и преобразуйте их из DataFrame Spark в DataFrame pandas для упрощения визуализации. Наконец, вы изучаете и визуализируете распределения классов в данных.
Отображение необработанных данных
Изучите необработанные данные и просмотрите высокоуровневую статистику
displayс помощью команды. Дополнительные сведения о визуализации данных см. в разделе Визуализация в блокноте Microsoft Fabric.display(df)Печать некоторых основных сведений о наборе данных:
# Print dataset basic information
print("records read: " + str(df.count()))
print("Schema: ")
df.printSchema()
Преобразование данных
Приведение столбцов набора данных к правильным типам:
import pyspark.sql.functions as F

df_columns = df.columns
df_columns.remove(TARGET_COL)

# Ensure that TARGET_COL is the last column
df = df.select(df_columns + [TARGET_COL]).withColumn(TARGET_COL, F.col(TARGET_COL).cast("int"))

if IS_SAMPLE:
    df = df.limit(SAMPLE_ROWS)
Преобразуйте кадр данных Spark в кадр данных pandas для упрощения визуализации и обработки:
df_pd = df.toPandas()
Изучение распределения классов в наборе данных
Отображение распределения классов в наборе данных:
# The distribution of classes in the dataset
print('No Frauds', round(df_pd['Class'].value_counts()[0]/len(df_pd) * 100,2), '% of the dataset')
print('Frauds', round(df_pd['Class'].value_counts()[1]/len(df_pd) * 100,2), '% of the dataset')
Код возвращает распределение этого класса набора данных: 99.83%
No Fraudsи 0.17%Frauds. Это распределение классов показывает, что большинство транзакций являются нефрудулентными. Таким образом, перед обучением модели требуется предварительная обработка данных, чтобы избежать переобучения.Используйте график для отображения дисбаланса класса в наборе данных, просматривая распределение мошеннических и нефрудулентных транзакций:
import seaborn as sns
import matplotlib.pyplot as plt

colors = ["#0101DF", "#DF0101"]
sns.countplot(x='Class', data=df_pd, palette=colors)
plt.title('Class Distributions \n (0: No Fraud || 1: Fraud)', fontsize=10)
Отображение сводки с пятью числами (минимальная оценка, первая квартиль, медиана, третий квартиль и максимальная оценка) для суммы транзакции с графиками полей:
fig, (ax1, ax2) = plt.subplots(ncols=2, figsize=(12,5))
s = sns.boxplot(ax = ax1, x="Class", y="Amount", hue="Class",data=df_pd, palette="PRGn", showfliers=True) # Remove outliers from the plot
s = sns.boxplot(ax = ax2, x="Class", y="Amount", hue="Class",data=df_pd, palette="PRGn", showfliers=False) # Keep outliers from the plot
plt.show()
Для данных с высоким дисбалансом диаграммы полей могут не отображать точные аналитические сведения. Однако сначала можно решить проблему дисбаланса
Class, а затем создать те же графики для более точной аналитики.
Шаг 4. Обучение и оценка моделей
На этом шаге вы обучите модель LightGBM для классификации транзакций мошенничества. Вы обучаете модель LightGBM как на несбалансированном, так и на сбалансированном наборе данных. Затем вы сравниваете производительность обеих моделей.
Подготовка обучающих и тестовых наборов данных
Перед обучением разбиение данных на обучающие и тестовые наборы данных:
# Split the dataset into training and testing sets
from sklearn.model_selection import train_test_split

train, test = train_test_split(df_pd, test_size=0.15)
feature_cols = [c for c in df_pd.columns.tolist() if c not in [TARGET_COL]]
Применить SMOTE к обучающему набору данных
В библиотеке imblearn используется метод синтетического переумплинга меньшинства (SMOTE) для решения проблемы несбалансированной классификации. Несбалансированная классификация происходит, когда доступны слишком мало примеров класса меньшинства, для эффективного изучения границы принятия решений. SMOTE является наиболее широко используемым подходом для синтеза новых образцов для класса меньшинства.
Примените SMOTE только к набору обучающих данных вместо тестового набора данных. При оценке модели на тестовых данных необходимо оценить производительность модели на неизвестных данных в рабочей среде. Для допустимого приближения тестовые данные используют исходное несбалансированное распределение, чтобы представить рабочие данные как можно ближе.
# Apply SMOTE to the training data
import pandas as pd
from collections import Counter
from imblearn.over_sampling import SMOTE

X = train[feature_cols]
y = train[TARGET_COL]
print("Original dataset shape %s" % Counter(y))

sm = SMOTE(random_state=42)
X_res, y_res = sm.fit_resample(X, y)
print("Resampled dataset shape %s" % Counter(y_res))

new_train = pd.concat([X_res, y_res], axis=1)
Обучение моделей machine learning и запуск экспериментов
Apache Spark в Microsoft Fabric позволяет машинному обучению использовать большие данные. С помощью Apache Spark можно получить ценные аналитические сведения из больших объемов структурированных, неструктурированных и быстро перемещаемых данных.
Вы можете обучать модели машинного обучения с помощью Apache Spark в Microsoft Fabric: Apache Spark MLlib, SynapseML и других библиотек с открытым кодом. Дополнительные сведения см. в статье Train machine learning models in Microsoft Fabric.
Эксперимент машинного обучения служит основной единицей организации и управления для всех связанных запусков машинного обучения. запуск соответствует одному запуску кода модели. Machine learning отслеживание экспериментов включает управление всеми экспериментами и их компонентами, такими как параметры, метрики, модели и другие артефакты.
Для отслеживания экспериментов можно упорядочить все необходимые компоненты конкретного machine learning эксперимента. Кроме того, можно легко воспроизвести прошлые результаты с сохраненными экспериментами. Дополнительные сведения о экспериментах машинного обучения см. в статье Machine learning experiments in Microsoft Fabric.
Чтобы отслеживать дополнительные метрики, параметры и файлы, задайте
exclusive=False, чтобы обновить конфигурацию автологирования MLflow:mlflow.autolog(exclusive=False)Обучение двух моделей с помощью LightGBM. Одна модель обрабатывает несбалансированный набор данных, а другая модель обрабатывает сбалансированный набор данных (через SMOTE). Затем сравните производительность двух моделей.
import lightgbm as lgb

model = lgb.LGBMClassifier(objective="binary") # Imbalanced dataset
smote_model = lgb.LGBMClassifier(objective="binary") # Balanced dataset
# Train LightGBM for both imbalanced and balanced datasets and define the evaluation metrics print("Start training with imbalanced data:\n") with mlflow.start_run(run_name="raw_data") as raw_run: model = model.fit( train[feature_cols], train[TARGET_COL], eval_set=[(test[feature_cols], test[TARGET_COL])], eval_metric="auc", callbacks=[ lgb.log_evaluation(10), ], ) print(f"\n\nStart training with balanced data:\n") with mlflow.start_run(run_name="smote_data") as smote_run: smote_model = smote_model.fit( new_train[feature_cols], new_train[TARGET_COL], eval_set=[(test[feature_cols], test[TARGET_COL])], eval_metric="auc", callbacks=[ lgb.log_evaluation(10), ], )
Определение важности признаков для обучения
Определите важность признаков для модели, обученной в несбалансированном наборе данных:
with mlflow.start_run(run_id=raw_run.info.run_id):
    importance = lgb.plot_importance(
        model, title="Feature importance for imbalanced data"
    )
    importance.figure.savefig("feauture_importance.png")
    mlflow.log_figure(importance.figure, "feature_importance.png")
Определите важность признаков для модели, обученной на балансированных данных. SMOTE создал сбалансированные данные:
with mlflow.start_run(run_id=smote_run.info.run_id):
    smote_importance = lgb.plot_importance(
        smote_model, title="Feature importance for balanced (via SMOTE) data"
    )
    smote_importance.figure.savefig("feauture_importance_smote.png")
    mlflow.log_figure(smote_importance.figure, "feauture_importance_smote.png")
При обучении модели с несбалансированным набором данных важные функции показывают значительные различия по сравнению с моделью, обученной с сбалансированным набором данных.
Оценка моделей
Здесь вы оцениваете две обученные модели:
-
modelобучается на необработанных, несбалансированных данных -
smote_modelобученный на сбалансированных данных
Вычислить метрики модели
Определите
prediction_to_sparkфункцию, которая осуществляет прогнозирование и преобразует результаты прогнозирования в фрейм данных Spark. Затем вы можете вычислить статистику модели по результатам прогнозирования с помощью SynapseML.from pyspark.sql.functions import col from pyspark.sql.types import IntegerType, DoubleType def prediction_to_spark(model, test): predictions = model.predict(test[feature_cols], num_iteration=model.best_iteration_) predictions = tuple(zip(test[TARGET_COL].tolist(), predictions.tolist())) dataColumns = [TARGET_COL, "prediction"] predictions = ( spark.createDataFrame(data=predictions, schema=dataColumns) .withColumn(TARGET_COL, col(TARGET_COL).cast(IntegerType())) .withColumn("prediction", col("prediction").cast(DoubleType())) ) return predictionsИспользуйте функцию
prediction_to_sparkдля прогнозирования с использованием двух моделей:modelиsmote_model.predictions = prediction_to_spark(model, test) smote_predictions = prediction_to_spark(smote_model, test) predictions.limit(10).toPandas()Метрики вычислений для двух моделей:
from synapse.ml.train import ComputeModelStatistics

metrics = ComputeModelStatistics(
    evaluationMetric="classification", labelCol=TARGET_COL, scoredLabelsCol="prediction"
).transform(predictions)

smote_metrics = ComputeModelStatistics(
    evaluationMetric="classification", labelCol=TARGET_COL, scoredLabelsCol="prediction"
).transform(smote_predictions)
display(metrics)
Оценка производительности модели с помощью матрицы путаницы
Матрица ошибок отображает количество
- истинно положительные (TP)
- истинные отрицательные значения (TN)
- ложные срабатывания (FP)
- ложные отрицания (FN)
модель генерирует при тестировании с использованием тестовых данных. Для двоичной классификации модель возвращает матрицу путаницы 2x2. Для многоклассовой классификации модель возвращает матрицу путаницы nxn, где n — это количество классов.
Используйте матрицу ошибок, чтобы суммировать производительность обученных моделей машинного обучения на тестовых данных.
# Collect confusion matrix values
cm = metrics.select("confusion_matrix").collect()[0][0].toArray()
smote_cm = smote_metrics.select("confusion_matrix").collect()[0][0].toArray()
print(cm)
Настроите матрицу путаницы для прогнозов
smote_model(обученных на сбалансированных данных):# Plot the confusion matrix import seaborn as sns def plot(cm): """ Plot the confusion matrix. """ sns.set(rc={"figure.figsize": (5, 3.5)}) ax = sns.heatmap(cm, annot=True, fmt=".20g") ax.set_title("Confusion Matrix") ax.set_xlabel("Predicted label") ax.set_ylabel("True label") return ax with mlflow.start_run(run_id=smote_run.info.run_id): ax = plot(smote_cm) mlflow.log_figure(ax.figure, "ConfusionMatrix.png")Постройте матрицу ошибок для прогнозов модели
model(обученной на необработанных, несбалансированных данных):with mlflow.start_run(run_id=raw_run.info.run_id): ax = plot(cm) mlflow.log_figure(ax.figure, "ConfusionMatrix.png")
Оцените производительность модели с помощью показателей AUC-ROC и AUPRC
Область под операционной характеристикой приемника кривой (AUC-ROC) оценивает производительность двоичных классификаторов. Диаграмма AUC-ROC визуализирует компромисс между истинной положительной скоростью (TPR) и ложноположительной скоростью (FPR).
В некоторых случаях лучше оценивать классификатор на основе области под кривой Precision-Recall (AUPRC). Кривая AUPRC объединяет следующие ставки:
- Точность или положительное прогнозное значение (PPV)
- Отзыв продукции, или TPR
Чтобы оценить производительность с помощью мер AUC-ROC и AUPRC:
Определите функцию, которая возвращает меры AUC-ROC и AUPRC:
from pyspark.ml.evaluation import BinaryClassificationEvaluator

def evaluate(predictions):
    """
    Evaluate the model by computing AUROC and AUPRC with the predictions.
    """

    # Initialize the binary evaluator
    evaluator = BinaryClassificationEvaluator(rawPredictionCol="prediction", labelCol=TARGET_COL)

    _evaluator = lambda metric: evaluator.setMetricName(metric).evaluate(predictions)

    # Calculate AUROC, baseline 0.5
    auroc = _evaluator("areaUnderROC")
    print(f"The AUROC is: {auroc:.4f}")

    # Calculate AUPRC, baseline positive rate (0.172% in the data)
    auprc = _evaluator("areaUnderPR")
    print(f"The AUPRC is: {auprc:.4f}")

    return auroc, auprc
Запишите показатели метрик "AUC-ROC" и "AUPRC" для модели, обученной вами на несбалансированных данных.
with mlflow.start_run(run_id=raw_run.info.run_id):
    auroc, auprc = evaluate(predictions)
    mlflow.log_metrics({"AUPRC": auprc, "AUROC": auroc})
    mlflow.log_params({"Data_Enhancement": "None", "DATA_FILE": DATA_FILE})
Регистрируйте метрики AUC-ROC и AUPRC для модели, обученной на сбалансированных данных:
with mlflow.start_run(run_id=smote_run.info.run_id):
    auroc, auprc = evaluate(smote_predictions)
    mlflow.log_metrics({"AUPRC": auprc, "AUROC": auroc})
    mlflow.log_params({"Data_Enhancement": "SMOTE", "DATA_FILE": DATA_FILE})
Модель, обученная на балансированных данных, возвращает более высокие AUC-ROC и значения AUPRC по сравнению с моделью, обученной на несбалансированных данных. На основе этих мер SMOTE представляется эффективным способом повышения производительности модели при работе с несбалансированными данными.
Как показано на следующем рисунке, система регистрирует каждый эксперимент с его соответствующим именем. Вы можете отслеживать параметры эксперимента и метрики производительности в рабочей области.

На следующем рисунке показаны метрики производительности для модели, обученной в сбалансированном наборе данных ( в версии 2):

Выберите версию 1 , чтобы просмотреть метрики для модели, обученной в несбалансированном наборе данных. При сравнении метрик вы увидите, что AUROC выше для модели, обученной с сбалансированным набором данных. Эти результаты показывают, что эта модель лучше правильно прогнозировать классы 0 как 0, а также прогнозировать классы 1 как 1.
Шаг 5. Регистрация моделей
Используйте MLflow для регистрации двух моделей:
# Register the model
registered_model_name = f"{EXPERIMENT_NAME}-lightgbm"

raw_model_uri = "runs:/{}/model".format(raw_run.info.run_id)
mlflow.register_model(raw_model_uri, registered_model_name)

smote_model_uri = "runs:/{}/model".format(smote_run.info.run_id)
mlflow.register_model(smote_model_uri, registered_model_name)
Шаг 6. Сохранение результатов прогнозирования
Пользователи Microsoft Fabric могут приводить в действие модели машинного обучения, используя масштабируемую функцию PREDICT. Эта функция поддерживает пакетную оценку (или пакетный вывод) на любом вычислительном движке.
Вы можете создавать пакетные прогнозы непосредственно из записной книжки Microsoft Fabric или со страницы модели. Дополнительные сведения о PREDICT см. в разделе Модель оценки с помощью PREDICT в Microsoft Fabric.
Загрузите более эффективную модель (версии 2) для пакетной оценки и создайте результаты прогнозирования:
from synapse.ml.predict import MLFlowTransformer

spark.conf.set("spark.synapse.ml.predict.enabled", "true")

model = MLFlowTransformer(
    inputCols=feature_cols,
    outputCol="prediction",
    modelName=f"{EXPERIMENT_NAME}-lightgbm",
    modelVersion=2,
)

test_spark = spark.createDataFrame(data=test, schema=test.columns.to_list())

batch_predictions = model.transform(test_spark)
Сохраните прогнозы в lakehouse:
# Save the predictions to the lakehouse
batch_predictions.write.format("delta").mode("overwrite").save(f"{DATA_FOLDER}/predictions/batch_predictions")
Связанное содержимое
- Как использовать записные книжки Microsoft Fabric
- модель машинного обучения в Microsoft Fabric
- Обучение моделей машинного обучения
- Эксперименты по машинному обучению в Microsoft Fabric