Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
В этой статье показано, как создать модель машинного обучения с помощью SynapseML в записной книжке Microsoft Fabric. Вы создаете обучающий конвейер, использующий извлечение признаков из текста и регрессию LightGBM для прогнозирования рейтингов книг по тексту рецензий. Вы также узнаете, как использовать инструменты Foundry для готового анализа тональности.
- Создать блокнот Fabric и подключить Lakehouse
- Импорт библиотек и загрузка данных
- Создание и обучение конвейера преобразования текста в признаки и регрессии LightGBM
- Создание прогнозов
- (Необязательно) Запустить анализ тональности в Foundry Tools
Предварительные требования
Оформите подписку Microsoft Fabric. Или зарегистрируйте бесплатную пробную версию Microsoft Fabric.
Войдите в Microsoft Fabric.
Перейдите в Fabric с помощью переключателя интерфейса в левой нижней части домашней страницы.
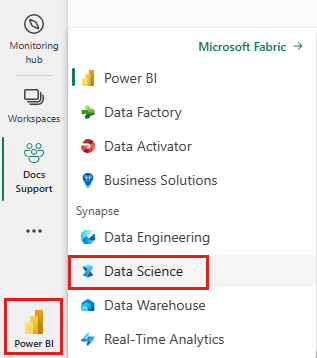
- Создайте новый блокнот в рабочей области Fabric.
- Подключите лейкхаус к блокноту. В области обозревателя разверните Lakehouses и нажмите кнопку "Добавить".
- (Необязательно) Чтобы выполнить шаг анализа тональности, вам потребуется:
- Ключ средств Foundry. Следуйте инструкциям в кратком руководстве: Создание ресурса с несколькими службами для Foundry Tools.
- Экземпляр Azure Key Vault с ключом Foundry Tools, сохранённым как секрет.
Настройка среды
В записной книжке импортируйте библиотеки SynapseML и инициализируйте сеанс Spark.
from pyspark.sql import SparkSession
from synapse.ml.core.platform import *

spark = SparkSession.builder.getOrCreate()
Проверка: Запустите следующую ячейку, чтобы убедиться, что Spark запущен:
print(f"Spark version: {spark.version}")
В выходных данных отображается номер версии Spark. Ожидается любая версия 3.4 или более поздняя. Точная версия зависит от среды выполнения Fabric.
Загрузка набора данных
Загрузите набор данных с рецензиями на книги и разделите его на обучающую и тестовую выборки. Набор данных содержит два столбца: rating (целое число 1–5) и text (просмотр содержимого).
train, test = (
    spark.read.parquet(
        "wasbs://publicwasb@mmlspark.blob.core.windows.net/BookReviewsFromAmazon10K.parquet"
    )
    .limit(1000)
    .cache()
    .randomSplit([0.8, 0.2])
)

display(train)
Проверка: Выполните следующую ячейку, чтобы убедиться, что данные загружены правильно:
print(f"Training rows: {train.count()}, Test rows: {test.count()}")
print(f"Columns: {train.columns}")
train.printSchema()
В выходных данных показаны примерно 800 строк обучения и 200 тестовых строк с двумя столбцами: rating (целое число) и text (строка). Точное количество строк различается, поскольку randomSplit недетерминирован.
Создание конвейера обучения
Создайте конвейер, который извлекает признаки из текста отзыва с помощью TextFeaturizer и предсказывает оценку с помощью LightGBMRegressor.
from pyspark.ml import Pipeline
from synapse.ml.featurize.text import TextFeaturizer
from synapse.ml.lightgbm import LightGBMRegressor

model = Pipeline(
    stages=[
        TextFeaturizer(inputCol="text", outputCol="features"),
        LightGBMRegressor(featuresCol="features", labelCol="rating", dataTransferMode="bulk")
    ]
).fit(train)
Проверка: Выполните следующую ячейку, чтобы убедиться, что конвейер обучен:
print(f"Pipeline stages: {len(model.stages)}")
print(f"Stage 1: {type(model.stages[0]).__name__}")
print(f"Stage 2: {type(model.stages[1]).__name__}")
В выходных данных показаны два этапа конвейера: TextFeaturizerModel и LightGBMRegressionModel.
Прогнозирование выходных данных теста
Вызовите метод transform у модели, чтобы спрогнозировать рейтинги на тестовых данных и вывести результаты.
predictions = model.transform(test)
display(predictions)
Проверка: Выполните следующую ячейку, чтобы убедиться, что прогнозы были сгенерированы:
print(f"Prediction columns: {predictions.columns}")
print(f"Prediction count: {predictions.count()}")
predictions.select("rating", "prediction").show(5)
В выходных данных перечислены четыре столбца (rating, text, features, prediction) и примерно 200 строк. Столбец prediction содержит прогнозируемую оценку модели как плавающую. Сравните его с фактическим rating столбцом для оценки производительности модели.
(Необязательно) Использование средств Foundry для анализа тональности
Если вы хотите проанализировать тональность отзывов книг, можно использовать интеграцию SynapseML с Средствами Foundry. На этом шаге используется готовая модель TextSentiment для классификации тональности текста; это задача, отличная от прогнозирования оценок на предыдущих шагах.
Important
Для этого шага требуется ключ средств Foundry, хранящийся в Azure Key Vault. Если вы пропустили эти предварительные требования, выполните их сначала или пропустите этот раздел.
Выполните следующий код с этими заменами:
- Замените
<your-secret-name>на имя секрета ключа Foundry Tools в Key Vault. - Замените
<your-key-vault-name>именем экземпляра Azure Key Vault.
from synapse.ml.services import TextSentiment
from synapse.ml.core.platform import find_secret

sentiment_model = TextSentiment(
    textCol="text",
    outputCol="sentiment",
    subscriptionKey=find_secret("<your-secret-name>", "<your-key-vault-name>")
).setLocation("eastus")

sentiment_results = sentiment_model.transform(test)
display(sentiment_results)
Note
Обновите значение setLocation, если ресурс Foundry Tools находится в другом регионе Azure (например, "westus2" или "westeurope").
Проверка: Выполните следующую ячейку, чтобы убедиться, что анализ тональности завершён:
print(f"Sentiment columns: {sentiment_results.columns}")
sentiment_results.select("text", "sentiment").show(3, truncate=50)
В выходных данных показаны три столбца (rating, text, sentiment). Столбец sentiment содержит структурированные результаты с такими метками, как positive, negativeneutralили mixed для каждой проверки.
Troubleshooting
| Проблема | Причина | Решение |
|---|---|---|
JAVA_GATEWAY_EXITED ошибка при создании SparkSession |
Выполнение кода за пределами записной книжки Fabric | Запустите этот код в записной книжке Fabric, в которой Spark предварительно настроена. Не запускайте локально без установки Spark. |
Could not find <secret> in keyvault <vault> |
Имя Key Vault или имя секрета указано неверно, или у удостоверения блокнота нет доступа | Проверьте точное соответствие имен. На портале Azure убедитесь, что удостоверение рабочей области Fabric имеет разрешение Get на доступ к секретам Key Vault. |
TextFeaturizer возвращает пустые функции |
Входной текстовый столбец имеет значение NULL или пуст | Проверьте наличие значений NULL: train.filter(train.text.isNull()).count() — удалите значения NULL перед обучением. |
randomSplit возвращает непредвиденное число строк |
Случайное разделение Spark является недетерминированным | Это ожидаемое поведение. Задайте зерно для воспроизводимости: .randomSplit([0.8, 0.2], seed=42) |
AnalysisException: Path does not exist |
Сетевая ошибка при доступе к образцу большого двоичного объекта данных | Проверьте сетевое подключение. В Fabric убедитесь, что рабочая область может получить доступ к внешним url-адресам Хранилище BLOB-объектов Azure. |
| Foundry Tools возвращают 401 или 403 | Недействительный или просроченный ключ подписки | Создайте новый ключ на портале Azure в разделе Keys and Endpoint ресурса Foundry Tools. Обновите секрет Key Vault. |
setLocation возвращает 404 |
Несоответствие региона | Задайте расположение, соответствующее региону Azure, в котором вы создали ресурс Foundry Tools. |
Очистите ресурсы
Если вы создали ресурсы Azure для необязательного шага «Инструменты Foundry» и они вам больше не нужны, удалите их, чтобы избежать расходов:
- На портале Azure удалите многосервисный ресурс Foundry Tools.
- В портале Azure удалите экземпляр хранилища ключей Key Vault.
- В рабочей области Fabric удалите тестовую записную книжку, если она больше не нужна.