Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Область применения: ✅ хранилище в Microsoft Fabric
В этой статье описываются методы миграции с Azure Synapse Analytics выделенных SQL-пулов в Microsoft Fabric Data Warehouse.
Подсказка
Для получения дополнительной информации о стратегии и планировании миграции см. раздел «Планирование миграции: Azure Synapse Analytics выделенные SQL-пулы для Fabric Data Warehouse».
Автоматизированная возможность для миграции из выделенных пулов SQL Azure Synapse Analytics доступна с использованием помощника по миграции Fabric для хранилища данных. Остальная часть этой статьи содержит дополнительные действия по миграции вручную.
В следующей таблице приведены методы миграции схемы данных (DDL), кода базы данных (DML) и данных. Столбец «Опция» ссылается на детали для каждого сценария.
| Номер опции | Вариант | Что он делает | Навык или предпочтения | Сценарий |
|---|---|---|---|---|
| 1 | Фабрика данных | Конвертация схемы (DDL) Извлечение данных Прием данных |
ADF/Пайплайн | Упрощена единая схема (DDL) и миграция данных. Рекомендуется для таблиц измерений. |
| 2 | Фабрика данных с разбивкой на разделы | Конвертация схемы (DDL) Извлечение данных Прием данных |
ADF/Пайплайн | Использование параметров секционирования для увеличения параллелизма чтения и записи, обеспечивающего в десять раз большую пропускную способность по сравнению с вариантом 1, рекомендуется для таблиц фактов . |
| 3 | Фабрика данных с ускоренным кодом | Конвертация схемы (DDL) | ADF/Пайплайн | Сначала преобразуйте и перенесите схему (DDL), затем используйте CETAS для извлечения, а COPY/Data Factory для загрузки данных для оптимальной общей производительности их обработки. |
| 4 | Ускоренный код хранимых процедур | Конвертация схемы (DDL) Извлечение данных Оценка кода |
T-SQL | Пользователь SQL, работающий в интегрированной среде разработки, имеет более детальный контроль над выбором задач, над которыми они хотят работать. Используйте COPY/Data Factory для поглощения данных. |
| 5 | Расширение проекта базы данных SQL для Visual Studio Code | Конвертация схемы (DDL) Извлечение данных Оценка кода |
Проект SQL | Проект базы данных SQL для развертывания с интеграцией варианта 4. Используйте COPY или Фабрику данных для приема данных. |
| 6 | Создать внешнюю таблицу как SELECT (CETAS) | Извлечение данных | T-SQL | Экономичное и высокопроизводительное извлечение данных в Azure Data Lake Storage (ADLS) поколения Gen2. Используйте COPY/Data Factory для поглощения данных. |
| 7 | Выполните миграцию с использованием dbt | Конвертация схемы (DDL) Преобразование кода базы данных (DML) |
dbt | Существующие пользователи dbt могут использовать адаптер dbt Fabric для преобразования DDL и DML. Затем необходимо перенести данные с помощью других параметров в этой таблице. |
Выбор рабочей нагрузки для начальной миграции
Решая, с чего начать в проекте миграции с выделенного пула SQL Synapse в Fabric Data Warehouse, выберите область рабочей нагрузки, в которой можно:
- Докажите жизнеспособность миграции на Fabric Data Warehouse, быстро реализуя преимущества новой среды. Начните с малого и простого и готовьтесь к нескольким небольшим миграциям.
- Разрешите вашему техническому персоналу получить соответствующий опыт работы с процессами и инструментами, которые они используют при миграции в другие области.
- Создайте шаблон для дальнейших миграций, относящихся к исходной среде Synapse, а также средства и процессы, которые помогут вам.
Подсказка
Создайте инвентарь объектов для миграции и задокументируйте процесс миграции от начала до конца, чтобы повторять его для других выделенных SQL-пулов или рабочих нагрузок.
Объём мигрированных данных при начальной миграции должен быть достаточно большим, чтобы продемонстрировать возможности и преимущества среды Fabric Data Warehouse, но не слишком большим, чтобы быстро продемонстрировать ценность. Как правило, такой объем составляет от 1 до 10 терабайт.
Миграция при помощи Fabric Data Factory
В этом разделе описаны опции Data Factory для пользователей, знакомых с конвейерами Фабрика данных Azure и Synapse. Интерфейс перетаскивания обеспечивает простой способ преобразования DDL и миграции данных.
Фабрика данных Fabric может выполнять следующие задачи:
- Преобразуйте схему (DDL) в синтаксис Fabric Data Warehouse.
- Создайте схему (DDL) на Fabric Data Warehouse.
- Перенесите данные в Fabric Data Warehouse.
Вариант 1. Схема и миграция данных — Copy data assistant и ForEach Copy Activity
Этот метод использует Data Factory Copy Data Assistant для подключения к исходному выделенному SQL-пулу, преобразования синтаксиса DDL выделенного SQL-пула в Fabric и копирования данных в Fabric Data Warehouse. Вы можете выбрать одну или несколько целевых таблиц (для набора данных TPC-DS есть 22 таблицы). Он генерирует ForEach для обхода списка таблиц, выбранных через пользовательский интерфейс, и запускает 22 параллельных потока для действия копирования.
- 22
SELECTзапроса (по одному для каждой выбранной таблицы) генерируются и выполняются в выделенном SQL-пуле. - Убедитесь, что у вас есть соответствующий DWU и класс ресурсов, чтобы сгенерированные запросы могли выполняться. В этом случае требуется минимум DWU1000 с
staticrc10, чтобы разрешить до 32 запросов для обработки 22 отправленных запросов. - Копирование данных напрямую из выделенного пула SQL в Fabric Data Warehouse с помощью Data Factory требует использования промежуточного хранилища. Процесс приема состоит из двух этапов:
- Первый этап извлекает данные из выделенного SQL-пула в ADLS. Эта фаза называется стадированием.
- Вторая фаза загружает подготовленные данные в Fabric Data Warehouse. Основная часть времени загрузки данных приходится на этап подготовки, поэтому этот этап существенно влияет на производительность.
Рекомендуемое использование
Использование помощника Copy для создания действия ForEach предоставляет простой интерфейс для преобразования DDL и загрузки выбранных таблиц из выделенного пула SQL в Fabric Data Warehouse за один шаг.
Однако этот вариант не обеспечивает оптимальную общую пропускную способность. Основными источниками задержки являются стадия и необходимость параллелизации чтения и записи на этапе от источника к этапу. Используйте эту опцию только для таблиц размеров.
Вариант 2. Миграция DDL/Data — конвейер с опцией раздела
Чтобы повысить пропускную способность при загрузке больших таблиц фактов с помощью конвейера Fabric, используйте действие "Копирование" для каждой таблицы фактов и включите секционирование. Эта конфигурация обеспечивает наилучшую производительность действие Copy.
Используйте физические разделы исходной таблицы, когда они доступны. Если таблица физически не разделена, укажите столбец раздела и минимальные и максимальные значения для динамического разбиения. На следующем снимке экрана параметры Source в конвейере задают динамический диапазон секционирования на основе столбца ws_sold_date_sk.
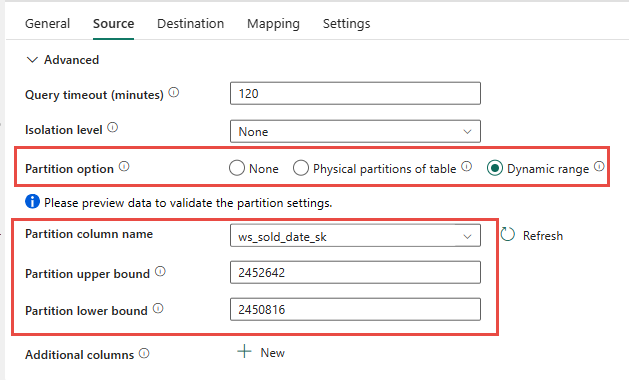
Разделение может увеличить пропускную способность на этапе подготовки. Учитывайте следующие рекомендации при настройке:
- В зависимости от диапазона разделов операция может генерировать более 128 запросов и использовать все слоты параллелизма в выделенном SQL-пуле.
- Необходимо увеличить масштаб как минимум до DWU6000, чтобы можно было выполнить все запросы.
- Например, для таблицы TPC-DS
web_sales163 запросы были отправлены в выделенный пул SQL. При DWU6000 было выполнено 128 запросов, а 35 запросов находились в очереди. - Динамическая секция автоматически выбирает секцию диапазона. В этом случае диапазон 11 дней для каждого запроса SELECT, отправленного в выделенный пул SQL. Например:
WHERE [ws_sold_date_sk] > '2451069' AND [ws_sold_date_sk] <= '2451080')
...
WHERE [ws_sold_date_sk] > '2451333' AND [ws_sold_date_sk] <= '2451344')
Рекомендуемое использование
Для таблиц фактов используйте Data Factory с опцией разбивания для увеличения пропускной способности.
Однако параллельные чтения требуют масштабирования выделенного SQL-пула до более высокого DWU, чтобы он мог выполнять запросы по извлечению. Разделение увеличивает скорость в десять раз по сравнению с отсутствием секционирования. Вы можете увеличить DWU для большей пропускной способности, но выделенный SQL-пул позволяет максимально использовать 128 активных запросов.
Для получения дополнительной информации о сопоставлении Synapse DWU и Fabric см. Блог: сопоставление выделенных пулов SQL Azure Synapse с вычислительными ресурсами Fabric Data Warehouse.
Вариант 3. Миграция DDL — Копирование помощника данных для каждой активности копирования
Два предыдущих варианта подходят для небольших баз данных. Если вам нужна большая пропускная способность, используйте следующую альтернативу:
- Извлекайте данные из выделенного пула SQL в ADLS, чтобы снизить накладные расходы на промежуточную обработку.
- Используйте либо Data Factory, либо команду COPY, чтобы загрузить данные в хранилище.
Рекомендуемое использование
Вы можете продолжать использовать фабрику данных для преобразования схемы (DDL). Используя Copy Data Assistant, вы можете выбрать конкретную таблицу или все таблицы. По своей конструкции этот метод переносит схему за один шаг, извлекая её без каких-либо строк с помощью ложного условия TOP 0 в операторе запроса.
В следующем примере кода рассматривается миграция схемы (DDL) с использованием Data Factory.
Пример кода: миграция схемы (DDL) с помощью Data Factory
Вы можете использовать Fabric Pipelines для лёгкой миграции ваших DDL (схем) на объекты таблиц из любого исходного База данных SQL Azure или выделенного SQL-пула. Этот конвейер переносит схему (DDL) таблиц исходного выделенного пула SQL в Fabric Data Warehouse.
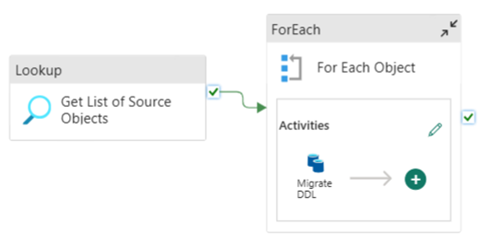
Проектирование конвейера: параметры
Этот конвейер принимает параметр SchemaName, который используется для указания схем миграции. Стандартная схема — dbo.
В поле "Значение по умолчанию" введите список с разделителями-запятыми таблицы, указывающий, какие схемы следует перенести: 'dbo','tpch' для предоставления двух схем dbo и tpch.
Снимок экрана из Data Factory, показывающий вкладку "Параметры" конвейера. В поле "Имя" указано 'SchemaName'. В поле "Значение по умолчанию" — 'dbo', 'tpch', указывая на то, что эти две схемы должны быть перенесены.
Проектирование конвейера: операция поиска
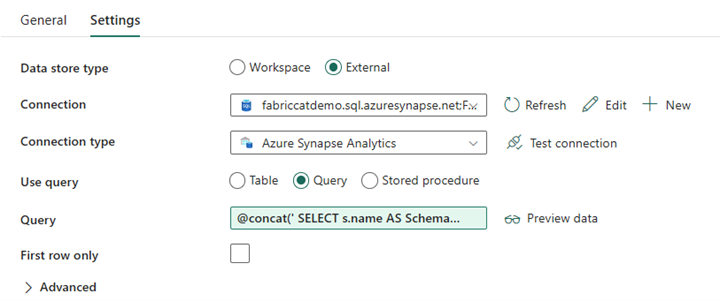
Создайте действие поиска и установите подключение к вашей исходной базе данных.
На вкладке Параметры сделайте следующее:
Установите тип хранилища данных на Внешний.
Соединение — это ваш выделенный пул SQL в Azure Synapse. Тип подключения — Azure Synapse Analytics.
Использование запроса установлено на Запрос.
Постройте поле Query , используя динамическое выражение, чтобы
SchemaNameиспользовать этот параметр в запросе, который возвращает список целевых исходных таблиц. Выберите «Запрос», затем выберите «Добавить динамический контент».Это выражение в действии LookUp создает инструкцию SQL для запроса системных представлений для получения списка схем и таблиц. Он ссылается на этот
SchemaNameпараметр для фильтрации по схемам SQL. Выход этого выражения — это массив SQL-схем и таблиц, которые используется в ForEach Activity в качестве входа.Используйте следующий код, чтобы вернуть список всех пользовательских таблиц с именем схемы.
@concat('
SELECT s.name AS SchemaName,
t.name  AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')
Проектирование конвейера: ForEach Loop
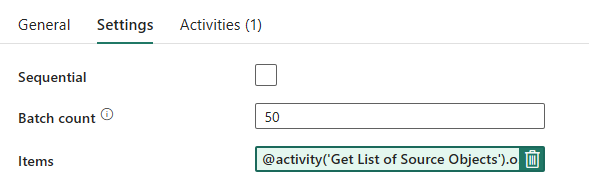
Для цикла ForEach настройте следующие параметры на вкладке "Параметры ".
- Отключите Sequential , чтобы несколько итераций выполнялись одновременно.
- Установите число пакетов на
50для ограничения максимального числа одновременных итераций. - Используйте динамический контент в поле Items для ссылки на результат активности LookUp. Используйте следующий фрагмент кода:
@activity('Get List of Source Objects').output.value
Проектирование конвейера: операция копирования внутри цикла ForEach
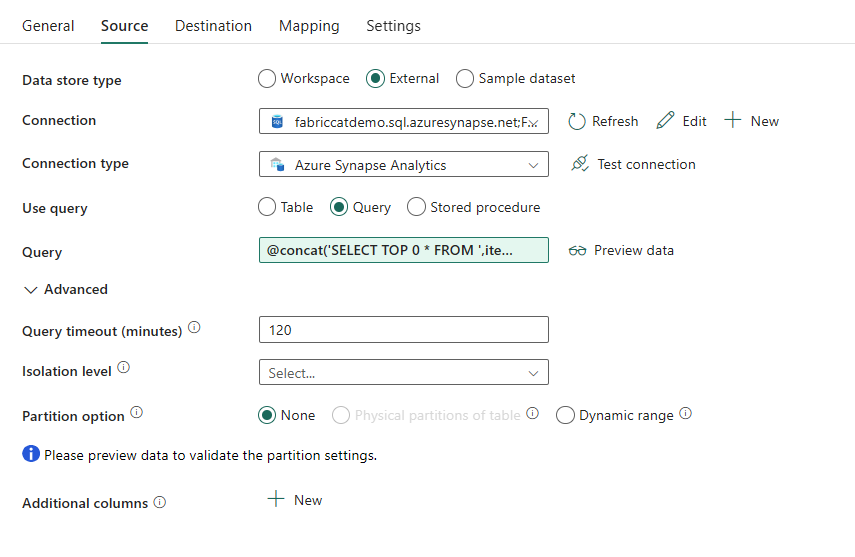
В действии ForEach добавьте действие копирования. Этот метод использует язык динамических выражений в конвейерах для создания оператора SELECT TOP 0 * FROM <TABLE> для переноса в хранилище данных только схемы, без данных.
На вкладке "Источник":
- Установите тип хранилища данных на Внешний.
- Соединение — это ваш выделенный пул SQL в Azure Synapse. Тип подключения — Azure Synapse Analytics.
- Установите Использовать запрос на Запрос.
- В поле «Запрос » вставьте динамический запрос по содержанию и используйте это выражение, которое не возвращает ни одной строки, но включает схему таблицы:
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)
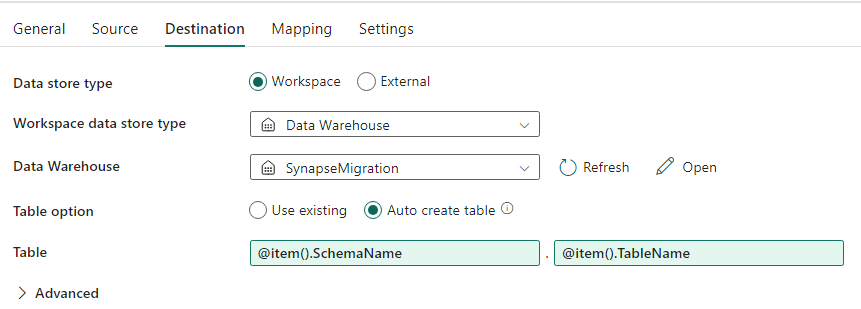
На вкладке "Назначение ":
- Установите тип хранилища данных на «Рабочая область».
- Установите для типа хранилища данных рабочей области значение Хранилище данных и укажите в поле Хранилище данных хранилище.
-
Схема целевой таблицы и имя таблицы определяются с помощью динамического содержимого.
- Схема относится к полю текущей итерации,
SchemaNameс фрагментом:@item().SchemaName - Ссылки на таблицу
TableNameс фрагментом:@item().TableName
- Схема относится к полю текущей итерации,
Конструктор конвейера: точка сбора
Для приемника укажите ваше хранилище и укажите исходные схему и имя таблицы.
Когда вы запускаете этот конвейер, вы видите, что в вашем хранилище данных появляются все таблицы из источника с корректной схемой.
Миграция с помощью хранящихся процедур в выделенном SQL-пуле Synapse
Эта опция использует сохранённые процедуры для выполнения миграции в Fabric Data Warehouse.
Примеры кода можно получить на GitHub.com microsoft/fabric-migration. Этот код предоставляется как открытый код, поэтому вы можете внести свой вклад в совместную работу и помочь сообществу.
Что могут делать процедуры, сохранённые в Fabric Migration:
- Преобразуйте схему (DDL) в синтаксис Fabric Data Warehouse.
- Создайте схему (DDL) на Fabric Data Warehouse.
- Извлеките данные из выделенного пула SQL Synapse в ADLS.
- Пометьте неподдерживаемый синтаксис Fabric для кодов T-SQL (хранимые процедуры, функции, представления).
Рекомендуемое использование
Этот вариант отлично подойдёт, если вы:
- Знакомы с T-SQL.
- Хочу использовать интегрированную среду разработки для T-SQL.
- Хотите более детальный контроль над тем, какие задачи выполнять.
Для преобразования схемы (DDL), извлечения данных или оценки кода T-SQL можно выполнить определенную хранимую процедуру.
Для миграции данных используйте либо COPY INTO, либо Fabric Data Factory для загрузки данных в ваш склад.
Миграция с помощью проектов базы данных SQL
Fabric Data Warehouse поддерживает расширение SQL Database Projects, доступное внутри Visual Studio Code.
Это расширение доступно в Visual Studio Code. Эта функция позволяет использовать возможности для управления версиями, тестирования баз данных и проверки схемы.
Для получения дополнительной информации о контроле версий см. обзор разработки и развертывания.
Рекомендуемое использование
Используйте этот вариант, если предпочитаете использовать SQL Database Project для своего развертывания. Эта опция интегрирует сохранённые процедуры Fabric Migration в проект базы данных SQL, обеспечивая бесшовный опыт миграции.
Проект База данных SQL может:
- Преобразуйте схему (DDL) в синтаксис Fabric Data Warehouse.
- Создайте схему (DDL) на Fabric Data Warehouse.
- Извлеките данные из выделенного пула SQL Synapse в ADLS.
- Пометка неподдерживаемого синтаксиса для кодов T-SQL (хранимые процедуры, функции, представления).
Для миграции данных используйте либо COPY INTO , либо Data Factory, чтобы ввести данные в ваш склад.
Команда Microsoft Fabric CAT предоставляет скрипты PowerShell для извлечения, создания и развертывания схемы (DDL) и кода базы данных (DML) через проект базы данных SQL. Пошаговое руководство см. в microsoft/fabric-migration на GitHub.
Дополнительные сведения о проектах базы данных SQL см. в статье "Начало работы с расширением "Проекты базы данных SQL " и создание проекта базы данных из командной строки.
Перенос данных с помощью CETAS
Команда T-SQL CREATE EXTERNAL TABLE AS SELECT (CETAS) предоставляет наиболее экономичный и оптимальный способ извлечения данных из выделенных SQL-пулов Azure Synapse в Azure Data Lake Storage (ADLS) Gen2.
Что может сделать CETAS:
- Извлечение данных в ADLS.
- Эта опция требует создания схемы (DDL) в вашем хранилище перед загрузкой данных. Рассмотрите варианты, приведенные в этой статье, для переноса схем (DDL).
Преимущества этого варианта:
- Миграция отправляет только один запрос на каждую таблицу в исходный выделенный SQL-пул Synapse. Этот запрос не занимает все слоты параллельного выполнения и не блокирует параллельно выполняющиеся ETL-процессы или запросы в рабочей среде клиента.
- Нет необходимости масштабировать до DWU6000, так как для каждой таблицы используется только один слот параллелизма, поэтому можно использовать меньшие значения DWU.
- Извлечение работает параллельно на всех вычислительных узлах, что повышает производительность.
Рекомендуемое использование
Используйте CETAS для извлечения данных в ADLS в виде файлов Parquet. Parquet-файлы обеспечивают преимущество эффективного хранения данных с столбцевым сжатием, что требует меньшей пропускной способности для перемещения по сети. Поскольку Fabric хранит данные в формате Delta Parquet, загрузка данных выполняется в 2,5 раза быстрее по сравнению с форматом текстовых файлов, так как при загрузке не требуется дополнительное преобразование в формат Delta.
Чтобы увеличить пропускную способность CETAS, выполните приведенные действия.
- Добавьте параллельные операции CETAS, увеличивая использование слотов параллельности, одновременно обеспечивая большую пропускную способность.
- Масштабируйте DWU в выделенном SQL-пуле Synapse.
Миграция с помощью dbt
В этом разделе описывается опция DBT для клиентов, которые уже используют DBT в своей среде выделенного SQL-пула Synapse.
Что может сделать dbt:
- Преобразуйте схему (DDL) в синтаксис Fabric Data Warehouse.
- Создайте схему (DDL) на Fabric Data Warehouse.
- Преобразуйте код базы данных (DML) в синтаксис Fabric.
Платформа dbt создает DDL и DML (скрипты SQL) на лету с каждым выполнением. Используя файлы моделей, описанные с помощью операторов SELECT, dbt мгновенно преобразует DDL/DML для любой целевой платформы — достаточно изменить профиль (строку подключения) и тип адаптера.
Рекомендуемое использование
Фреймворк DBT использует подход, ориентированный на код. Мигрируйте данные, используя опции, указанные в этом документе, такие как CETAS или COPY/Data Factory.
Используя адаптер dbt для Microsoft Fabric Data Warehouse, вы можете мигрировать существующие проекты DBT, ориентированные на разные платформы, такие как Azure Synapse выделенные SQL-пулы, Snowflake, Databricks, Google BigQuery или Amazon Redshift, на склад с простым изменением конфигурации.
Чтобы начать работу над проектом по dbt, ориентированным на Fabric Data Warehouse, см. раздел Tutorial: Set up dbt for Fabric Data Warehouse. В этом документе также указана опция перемещения между разными складами и платформами.
Прием данных в Fabric Data Warehouse
Для загрузки данных в Fabric Data Warehouse используйте COPY INTO или Fabric Data Factory, в зависимости от предпочтений. Оба метода являются рекомендуемыми и наиболее эффективными, поскольку они имеют эквивалентную пропускную способность при условии, что файлы уже извлечены в Azure Data Lake Storage (ADLS) Gen2.
Спроектируйте свой процесс с максимальной эффективностью, учитывая следующие факторы:
- С Fabric нет конкуренции за ресурсы при одновременной загрузке нескольких таблиц из ADLS в Fabric Data Warehouse. В результате при загрузке параллельных потоков нет снижения производительности. Максимальная пропускная способность приема данных ограничена только вычислительной мощностью вашей емкости Fabric.
- Управление рабочей нагрузкой Fabric обеспечивает разделение ресурсов, выделенных для загрузки и запроса. Нет борьбы за ресурсы, пока одновременно выполняются запросы и загрузка данных.
Связанный контент
- Ассистент по миграции Fabric для хранилищ данных
- Создание хранилища в Microsoft Fabric
- Рекомендации по производительности хранилища данных Fabric
- Безопасность в Fabric Data Warehouse
- Блог: Сопоставление выделенных SQL-пулов Azure Synapse с вычислительными ресурсами Fabric Data Warehouse
- Обзор миграции Microsoft Fabric