Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Организации обычно используют несколько отключенных служб для приема, хранения, преобразования, анализа и визуализации данных. Эта фрагментация создает фрагменты данных, увеличивает затраты на интеграцию и замедляет время для анализа. Microsoft Fabric решает эти проблемы, объединяя каждый этап жизненного цикла данных в одну платформу, созданную на основе общего фундамента.
В центре этой архитектуры является OneLake, одно корпоративное озеро данных, которое хранит все данные в открытом формате Delta Parquet. OneLake подготавливается автоматически для каждого клиента Fabric. Так как каждая нагрузка Fabric читает и записывает данные в OneLake, данные не перемещаются между движками. Набор данных, обработанный конвейером, уточненный в записной книжке и визуализированный в отчете Power BI, остается в одном месте на протяжении всего своего пути.
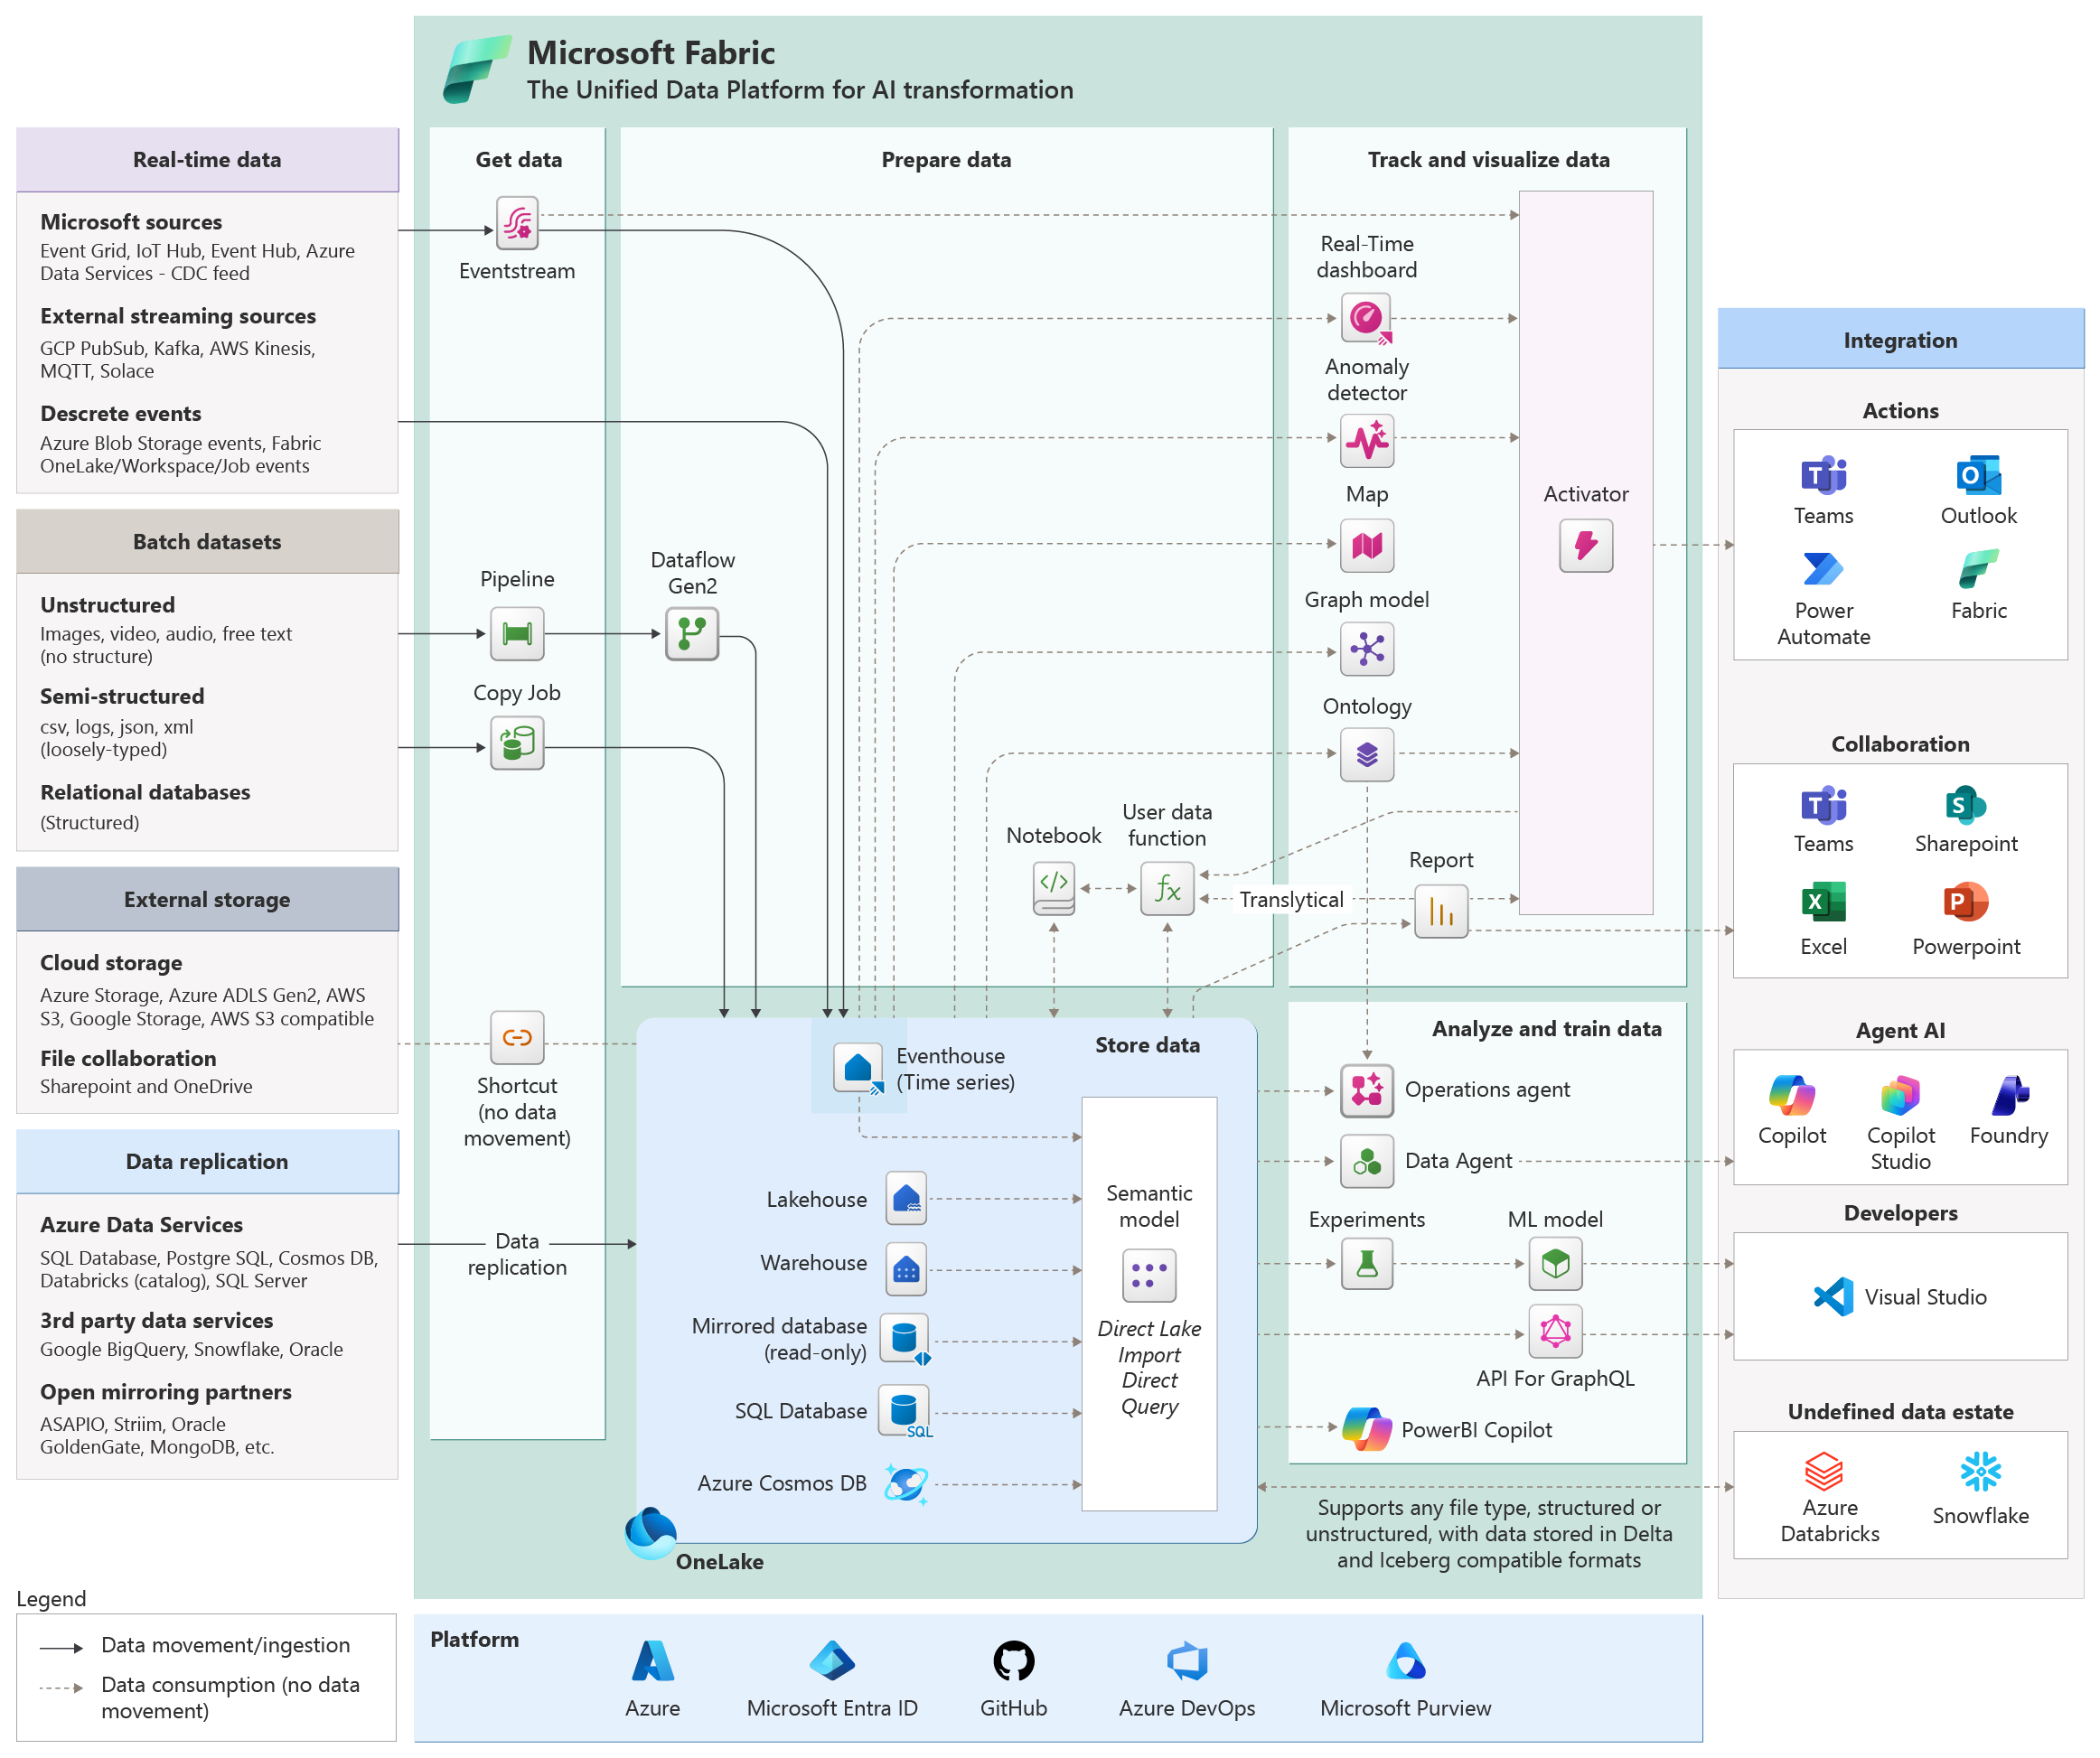
Жизненный цикл данных состоит из шести этапов, и Структура предоставляет специально созданные средства для каждого из них:
Получение данных: перенос данных в OneLake из сотен источников в режиме реального времени, по расписанию, с помощью непрерывной репликации базы данных или путем ссылки на внешнее хранилище.
Хранение данных: сохраняйте данные в форматах хранилища, оптимизированных для рабочей нагрузки, будь то гибкая аналитика больших данных, структурированные запросы SQL, анализ событий в режиме реального времени, обработка транзакций или управляемые бизнес-отчеты.
Подготовка и преобразование: очистка, перепечатка и обогащение данных с помощью визуальных преобразований с низким кодом или записных книжек и повторно используемых функций без перемещения данных из OneLake.
Анализ и обучение: создание и эксплуатация моделей машинного обучения, выполнение расширенной аналитики, выполнение данных запросов программным способом и изучение аналитических сведений с помощью агентов искусственного интеллекта на естественном языке.
Отслеживание и визуализация: Извлечение инсайтов с помощью интерактивных отчетов, мониторинг потоков данных на дашбордах в режиме реального времени и активация автоматических действий при выполнении условий.
Внешняя интеграция. Безопасное подключение к внешним службам для автоматизации, совместной работы, управления, средств разработчика и CI/CD.
На следующей схеме показано, как эти этапы подключаются и какие элементы Fabric участвуют на каждом этапе. Каждый этап подробно рассматривается в выделенной статье. Используйте ссылки в каждом разделе для изучения возможностей и инструментов, доступных на этом этапе.
Получение данных
Различные типы наборов данных получены из широкого разнообразия источников данных в различных сценариях, включая репликацию данных, ссылки на внешние хранилища, пакетные наборы данных и потоки в реальном времени. Вы выполняете прием и преобразование этих наборов данных с помощью средств интеграции Fabric. Данные попадают в OneLake, централизованное хранилище данных для всей платформы. К ключевым методам приема относятся:
- Потоки событий для приема и маршрутизации событий в режиме реального времени.
- Конвейеры данных для пакетного и запланированного перемещения данных с более чем 200 соединителями.
- Зеркальное отображение для непрерывной репликации из операционных баз данных без создания конвейеров ETL.
- Сочетания клавиш для виртуализации данных без копирования из внешнего хранилища, например Azure Data Lake, Amazon S3 или Google Cloud Storage. Ярлыки также могут ссылаться на данные, общие для других рабочих областей Fabric или арендаторов.
- Общий доступ к данным OneLake для межтенантного доступа к динамическим наборам данных без копирования данных через границы организации.
Дополнительные сведения см. в статье "Получение данных в Microsoft Fabric".
Хранение данных
После загрузки все данные сохраняются в OneLake в открытом формате Delta Parquet. OneLake предоставляет одно озеро данных для всей организации без отдельной подготовки. Так как OneLake поддерживает одну копию данных, вы можете совместно использовать управляемые наборы данных между клиентами, используя общий доступ к данным OneLake без дублирования хранилища. Fabric предлагает несколько элементов хранилища, оптимизированных для различных рабочих нагрузок:
- Lakehouse — гибкое хранение больших данных, объединяющее файлы и управляемые таблицы Delta с автоматической точкой аналитики SQL.
- Хранилище для структурированной, реляционной аналитики с полной поддержкой T-SQL, хранимыми процедурами и транзакциями ACID.
- Eventhouse для аналитики потоковых и телеметрических данных в режиме реального времени с использованием языка запросов Kusto (KQL).
- База данных SQL для транзакционных рабочих нагрузок и операционной аналитики.
- Семантические модели для курированной бизнес-логики, мер и иерархий, которые поддерживают отчеты и ИИ.
Дополнительные сведения см. в разделе "Хранение данных в Microsoft Fabric".
Подготовка и преобразование данных
Когда данные находятся в OneLake, их можно дополнительно преобразовать с помощью кодоориентированных движков или инструментов с низким уровнем кодирования, все это в среде Fabric без перемещения данных между движками.
- Поток данных 2-го поколения предоставляет интерфейс Power Query с низким кодом для очистки данных, преобразования и обогащения.
- Записные книжки предлагают среду Jupyter, например для Python, T-SQL и разработки данных на основе Scala.
- Пользовательские функции данных позволяют внедрять повторно используемые пользовательские логики Python, которые можно вызывать из конвейеров, записных книжек и правил активации.
Дополнительные сведения см. в разделе "Подготовка и преобразование данных".
Анализ данных и обучение моделей
Используйте подготовленные данные для обучения моделей машинного обучения и выполнения расширенной аналитики. Рабочая нагрузка обработки и анализа данных Fabric предоставляет среду для создания, обучения и эксплуатации моделей машинного обучения:
- Эксперименты MLflow отслеживают выполнения обучения модели с автоматическим ведением журнала гиперпараметров, метрик и элементов.
- Модели машинного обучения регистрируются в реестре MLflow, основанном на управлении версиями, отслеживании метаданных и воспроизводимости.
- Агенты данных и агенты операций позволяют взаимодействовать с данными с помощью естественного языка и работать с условиями и шаблонами.
- API GraphQL предоставляют гибкий уровень доступа к данным разработчикам для запроса нескольких источников данных Fabric через одну конечную точку.
- Copilot для Power BI использует генеративный ИИ для нерегламентированного анализа, генерации DAX и исследования данных на естественном языке.
Дополнительные сведения см. в статье "Анализ и обучение данных в Microsoft Fabric".
Отслеживание и визуализация данных
Используйте подготовленные и моделиированные данные для создания отчетов, панелей мониторинга и оповещений в режиме реального времени:
- Отчеты Power BI предоставляют интерактивные визуализации данных, созданные на основе семантических моделей, с распространением в приложениях Microsoft 365, таких как Teams, SharePoint, PowerPoint и Excel.
- Транслитические потоки задач позволяют пользователям выполнять действия непосредственно из отчетов Power BI путем вызова функций данных пользователей.
- Панели мониторинга аналитики в реальном времени отслеживают потоковую передачу данных с задержкой менее секунды с помощью запросов KQL и визуального создания.
- Активатор обнаруживает условия потоковой передачи данных и активирует автоматизированные действия, такие как оповещения Teams, сообщения электронной почты или потоки Power Automate.
- Fabric IQ сопоставляет корпоративные данные с общей бизнес-онтологией и позволяет агентам ИИ анализировать данные в полном бизнес-контексте.
Дополнительные сведения см. в разделе "Отслеживание и визуализация данных".
Внешняя интеграция
Структура интегрируется с внешними системами для приема данных и доставки аналитических сведений:
- Power Automate и Активация данных обеспечивают автоматизацию рабочих процессов в режиме реального времени на основе условий данных.
- Интеграция Microsoft 365 обеспечивает аналитические данные в Teams, SharePoint, PowerPoint и Excel.
- Интерфейсы REST API и клиентские библиотеки предоставляют программный доступ к ресурсам Fabric.
- Microsoft Entra ID обрабатывает проверку подлинности, условный доступ и поддержку служебных главных объектов.
- Интеграция Git с Azure DevOps и GitHub обеспечивает управление версиями и CI/CD для элементов Fabric.
- Microsoft Purview обеспечивает унифицированное управление данными, каталогизацию и соответствие требованиям в пространстве данных Fabric, включая общий доступ к данным между клиентами через общий доступ к данным OneLake.
Дополнительные сведения см. в статье о подключении к внешней интеграции и платформе.
Поддержка естественного языка и искусственного интеллекта
Поддержка естественного языка включает Power BI Copilot, агентами данных и агентами операций, которые могут анализировать корпоративные данные в OneLake и предоставлять ответы на основе элементов данных, к которым пользователи имеют доступ. Агенты данных можно интегрировать в Microsoft 365 Copilot, Microsoft Foundry и Copilot Studio, чтобы пользователи могли получать аналитические сведения от OneLake в существующих рабочих процессах в разных приложениях.