Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
API запросов — это экспериментальный веб-API, позволяющий запрашивать небольшую языковую модель (SLM), встроенную в Microsoft Edge, из кода JavaScript вашего веб-сайта или расширения браузера. Используйте API запросов для генерации и анализа текста или создания логики приложения на основе вводимых пользователем данных и открывайте для себя инновационные способы интеграции инженерных возможностей запросов в ваше веб-приложение.
Подробное содержание:
- Доступность API запросов
- Альтернативы и преимущества API запросов
- Небольшие языковые модели, встроенные в Microsoft Edge
- Модель Phi-4-mini
- Модель Aion-1.0-Instruct
- Включить API запросов
- См. рабочий пример
- Использование API запросов
- Обратная связь
- См. также
Доступность API запросов
API запроса доступен в качестве предварительной версии для разработчиков в каналах Microsoft Edge Canary и Edge Dev, начиная с версии 138.0.3309.2.
API запросов предназначен для поиска вариантов использования и понимания проблем, с которыми сталкиваются встроенные SLM. Ожидается, что этот API будет заменен другими экспериментальными API для конкретных задач на базе искусственного интеллекта, таких как помощь при письме и перевод текста. Дополнительные сведения об этих других API см. в разделе:
- Резюмирование, написание и переписывание текста с помощью API помощи при письме
- Перевод текста с помощью API переводчика
- Определение языков с помощью API-интерфейса средства обнаружения языков
Альтернативы и преимущества API запросов
Чтобы использовать возможности ИИ на веб-сайтах и в расширениях браузера, вы также можете использовать следующие методы:
Отправляйте сетевые запросы в облачные службы ИИ, такие как решения ИИ Azure.
Запускайте локальные модели ИИ с помощью API нейронной веб-сети (WebNN) или среды выполнения ONNX для Интернета.
API запросов использует SLM, работающий на том же устройстве, где используются входы и выходы модели (то есть локально). Это дает следующие преимущества по сравнению с облачными решениями:
Сниженная стоимость: Использование облачной службы ИИ не требует затрат.
Независимость сети: Помимо начальной загрузки модели отсутствует задержка сети при запросе модели, а также может использоваться, когда устройство находится в автономном режиме.
Улучшенная конфиденциальность: Данные, поступающие в модель, никогда не покидают устройство и не собираются для обучения моделей ИИ.
API запросов использует модель, предоставляемую Microsoft Edge и встроенную в браузер, которая обеспечивает дополнительные преимущества по сравнению с пользовательскими локальными решениями, например на основе WebGPU, WebNN или WebAssembly:
Общие единовременные затраты: Предоставляемая браузером модель загружается при первом вызове API и распространяется на всех веб-сайтах, работающих в браузере, что снижает сетевые издержки для пользователя и разработчика.
Упрощенное использование для веб-разработчиков: Встроенная модель может быть запущена с помощью простых веб-API и не требует опыта работы с ИИ/ML или использования сторонних платформ.
Небольшие языковые модели, встроенные в Microsoft Edge
В каналах Microsoft Edge Canary и Dev, начиная с версии 138.0.3309.2, API запросов использует модель Phi-4-mini, встроенную в Microsoft Edge.
Начиная с версии 150.0.4070, API запросов также можно использовать с предварительной моделью Aion-1.0-Instruct, которая также встроена в Microsoft Edge. Aion-1.0-Instruct — это меньшая, быстрая и более эффективная модель, чем Phi-4-mini, и поддерживается на устройствах с менее мощными графическими процессорами или без них через вывод ЦП. Если класс производительности вашего устройства недостаточно высок для поддержки Phi-4-mini, вы можете протестировать предварительную версию модели Aion-1.0-Instruct.
Чтобы узнать больше об обеих моделях и о том, как включить Aion-1.0-Instruct, прочитайте разделы ниже.
Модель Phi-4-mini
API запросов позволяет запрашивать Phi-4-mini, встроенный в Microsoft Edge. Phi-4-mini — это мощная небольшая языковая модель, которая превосходно справляется с текстовыми задачами. Чтобы узнать больше о Phi-4-mini и его возможностях, см. карту модели по адресу microsoft/Phi-4-mini-instruct.
Заявление об отказе от ответственности
Как и другие языковые модели, семейство моделей Phi потенциально может вести себя несправедливым, ненадежным или оскорбительным образом. Дополнительные сведения о подходах модели к ИИ см. в разделе Соображения по ответственному использованию ИИ.
Требования к оборудованию
Предварительная версия API запросов для разработчиков предназначена для работы на устройствах с аппаратными возможностями, которые выдают выходные данные SLM с предсказуемым качеством и задержкой. В настоящее время API запросов ограничен:
Операционная система: Windows 10 или 11 и macOS 13.3 или более поздней версии.
Хранение: На томе, содержащем профиль Microsoft Edge, доступно не менее 20 ГБ. Если объем доступного хранилища упадет ниже 10 ГБ, модель будет удалена, чтобы обеспечить достаточное количество места для работы других компонентов браузера.
Графический процессор: 5,5 ГБ видеопамяти или больше.
Сеть: Безлимитный тарифный план или безлимитное подключение. Модель не скачивается при использовании лимитного подключения.
Чтобы проверить, поддерживает ли ваше устройство предварительную проверку API запроса для разработчиков, перейдите в раздел «Включение API запроса» ниже и проверьте, насколько проверено класс производительности вашего устройства.
Из-за экспериментального характера API запроса вы можете наблюдать проблемы в определенных конфигурациях оборудования. Если вы видите проблемы в определенных конфигурациях оборудования, оставьте отзыв, открыв новую проблему в репозитории MSEdgeExplainers.
Доступность модели Phi-4-mini
Первоначальная загрузка модели Phi-4-mini требуется при первом вызове веб-сайтом API, требующего модель на устройстве. Вы можете отслеживать загрузку модели Phi-4-mini с помощью параметра монитора при создании нового сеанса API запросов. Дополнительные сведения см. в разделе Мониторинг хода загрузки модели ниже.
Модель Aion-1.0-Instruct
В Microsoft Edge Canary или Edge Dev, начиная с версии 150.0.4070, API запросов также можно использовать с предварительной моделью Aion-1.0-Instruct, встроенной в Microsoft Edge.
Эта модель Aion-1.0-Instruct значительно меньше, быстрее и эффективнее, чем Phi-4-mini, и поддерживается на устройствах с менее мощными графическими процессорами или без них через вывод ЦП.
Ожидается, что Aion-1.0-Instruct будет доступен в качестве модели с открытым кодом в июле 2026 года.
Включите Aion-1.0-Instruct для API запроса
По умолчанию API запросов использует модель Phi-4-mini. Чтобы использовать Aion-1.0-Instruct в Microsoft Edge Canary или Edge Dev, включите флаг "Включить предварительную версию языковой модели на устройстве", как описано в шагах ниже. Если этот флаг включен, Aion-1.0-Instruct переопределяет Phi-4-mini в качестве модели по умолчанию для API запросов.
Убедитесь, что вы используете последнюю версию Edge Canary или Edge Dev (версия 150.0.4070 или более поздняя). См. Станьте участником программы предварительной оценки Microsoft Edge.
В Edge Canary или Edge Dev откройте новую вкладку или окно и перейдите в
edge://flags.В поле поиска в верхней части страницы введите "Включить предварительную языковую модель на устройстве".
В раскрывающемся списке "Включить предварительную языковую модель на устройстве " выберите "Включено", а затем нажмите кнопку "Перезапустить ":
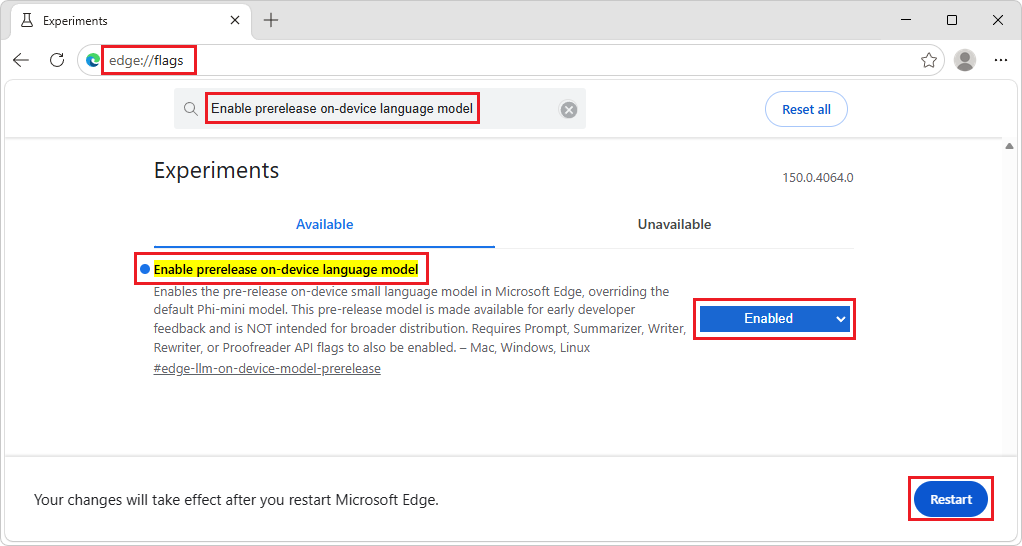
Чтобы проверка, что Aion-1.0-Instruct используется в качестве языковой модели на устройстве, перейдите в раздел
edge://on-device-internals, щелкните «Состояние модели» и проверка для имени модели установлено значение Aion-1.0-Instruct.
Заявление об отказе от ответственности
Модель Aion-1.0-Instruct доступна в Microsoft Edge для раннего тестирования и отзывов разработчиков. В дополнение к соображениям ответственного применения ИИ, перечисленным выше, обратите внимание, что с учетом предрелизной версии модели поведение и возможности могут быть изменены.
Доступность модели Aion-1.0-Instruct
Первоначальная загрузка модели Aion-1.0-Instruct требуется при первом вызове веб-сайтом API, для которого требуется модель на устройстве. Вы можете отслеживать загрузку модели Aion-1.0-Instruct с помощью параметра монитора при создании нового сеанса API запросов. Дополнительные сведения см. в разделе Мониторинг хода загрузки модели ниже.
Включить API запросов
Чтобы использовать API запросов в Microsoft Edge:
Убедитесь, что вы используете последнюю версию Microsoft Edge Canary или Edge Dev (версия 138.0.3309.2 или более поздняя). См. Станьте участником программы предварительной оценки Microsoft Edge.
В Edge Canary или Edge Dev откройте новую вкладку или окно и перейдите в
edge://flags/.В поле поиска в верхней части страницы введите API запросов для языковой модели на устройстве.
Страница будет отфильтрована для отображения соответствующего флага.
В разделе API запросов для языковой модели на устройстве выберите Включено:
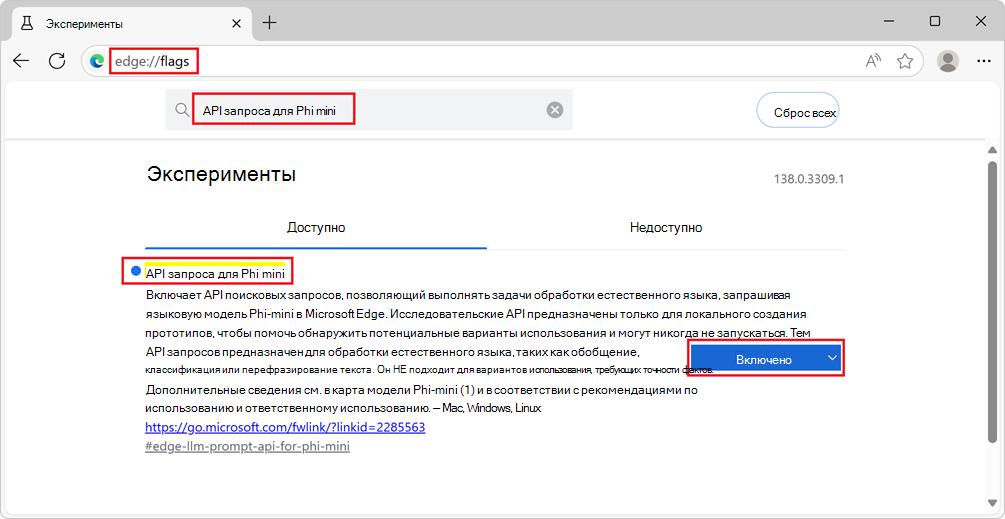
Дополнительно, чтобы локально регистрировать сведения, которые могут быть полезны для отладки, также включите флаг " Включить на устройстве журналы отладки модели ИИ ".
Перезапустите Edge Canary или Edge Dev.
Чтобы проверка, соответствует ли ваше устройство требованиям к оборудованию для предварительного просмотра API запросов для разработчиков, откройте новую вкладку, перейдите в
edge://on-device-internalsраздел и проверьте, проверка ли значение класса производительности устройства.Если ваш класс производительности устройства «Высокий » или выше, API запросов должен поддерживаться на вашем устройстве.
Если ваш класс производительности устройства является средним или низким, API запроса поддерживается только до предварительной версии модели Aion-1.0-Instruct, которая доступна, начиная с Edge версии 150.0.4070. Чтобы протестировать модель Aion-1.0-Instruct, см. раздел Включение Aion-1.0-Instruct для API запросов выше.
Если вы обнаружите проблемы с этими моделями, создайте новую проблему в репозитории MSEdgeExplainers.
См. рабочий пример
Чтобы увидеть API запросов в действии и просмотреть существующий код, использующий API, выполните следующие действия.
Включите API запроса, как описано выше.
В Edge Canary или Edge Dev откройте вкладку или окно и перейдите на песочницу API запросов.
В навигации по встроенным ИИ-песочницам слева выбран пункт "Запрос ".
В информационном баннере вверху проверьте состояние: изначально он гласит "Загрузка модели". Подождите:
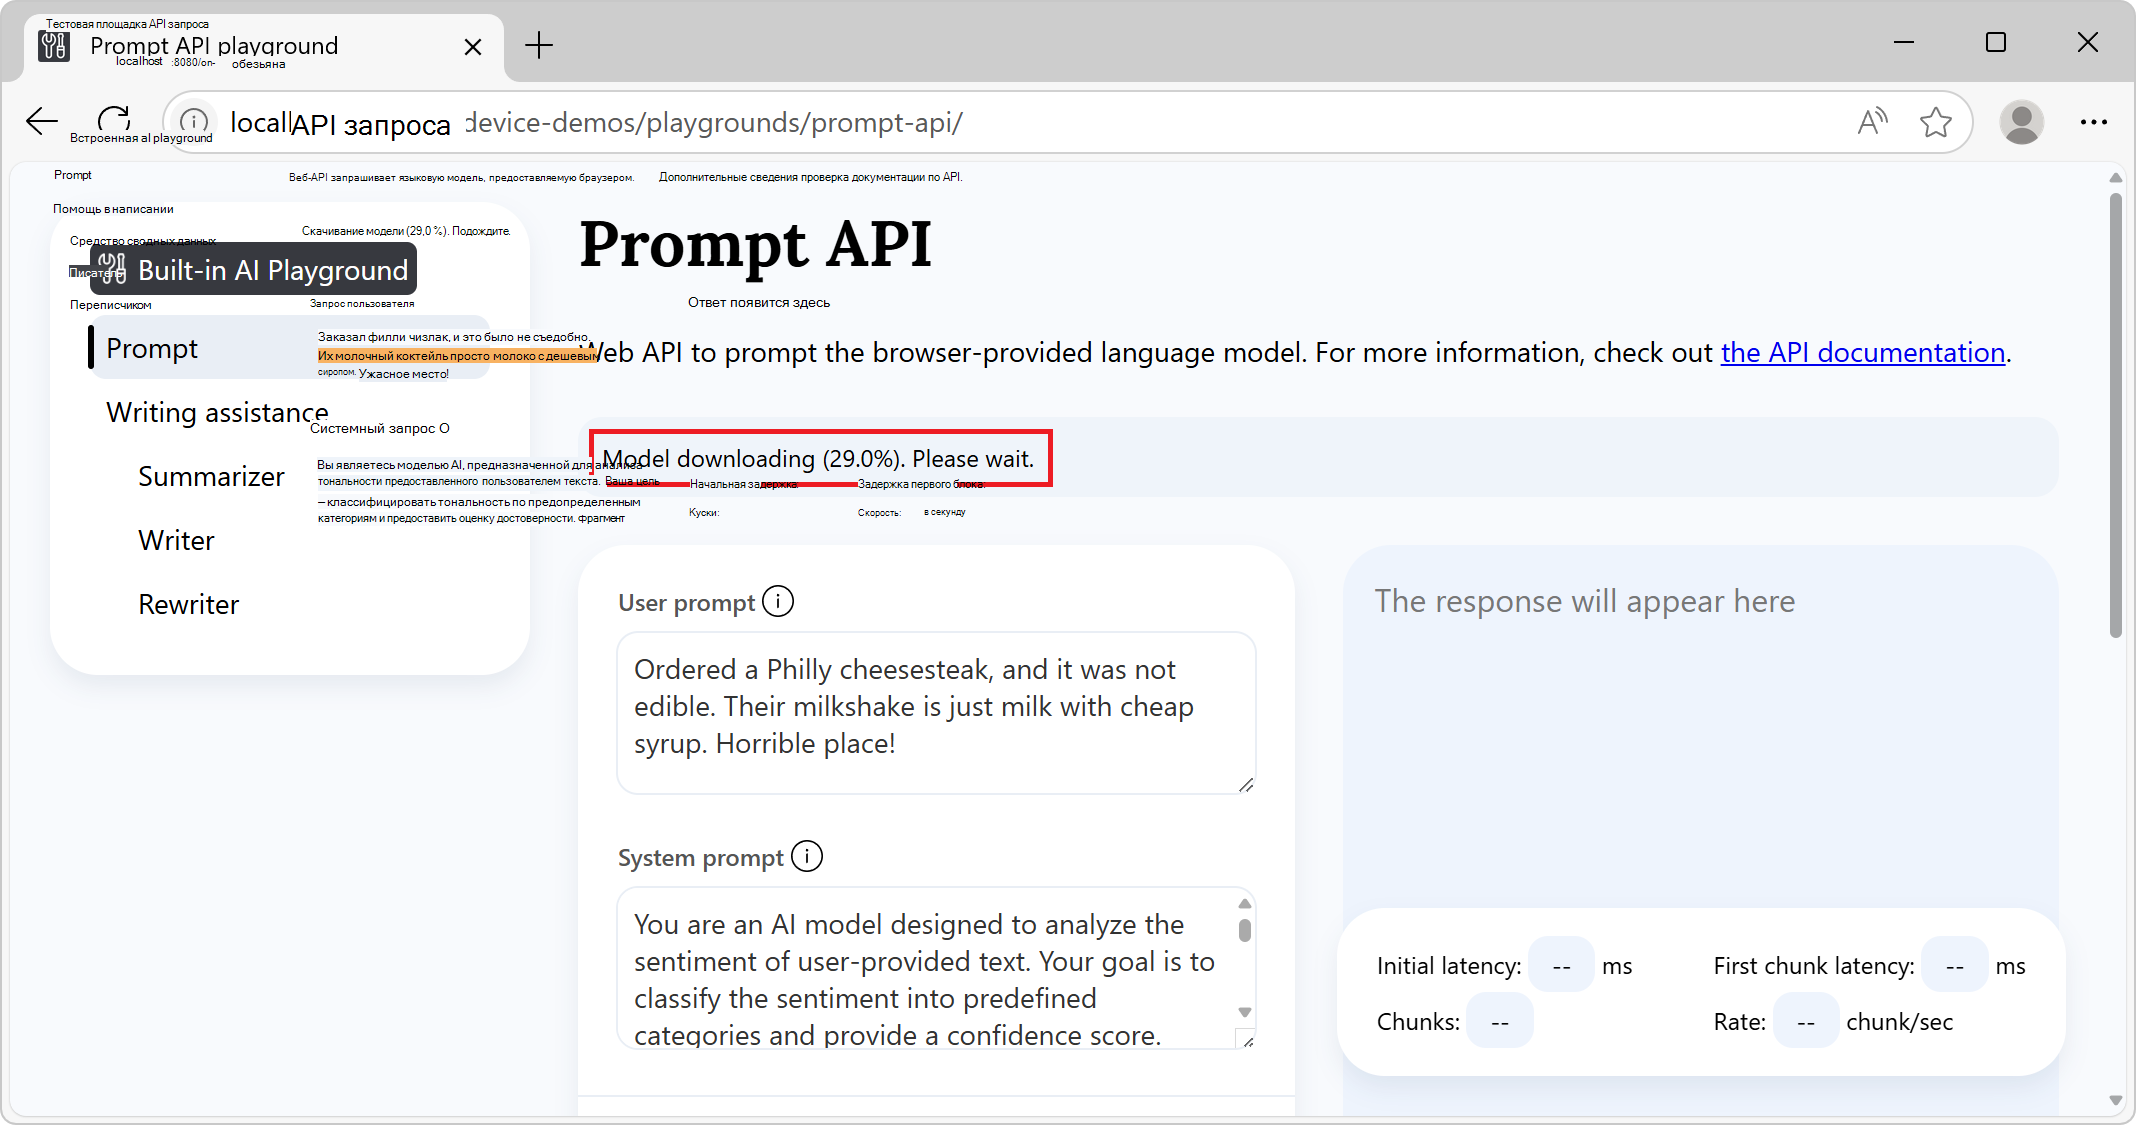
После загрузки модели на информационном баннере будет написано API и модель готова, что указывает на то, что API и модель можно использовать:
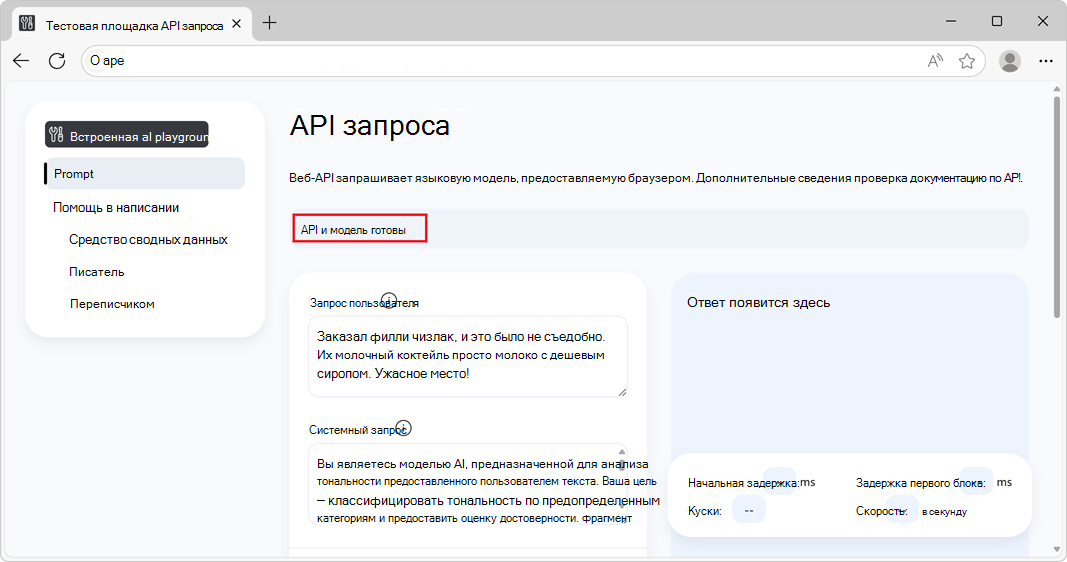
Если загрузка модели не начинается, перезапустите Microsoft Edge и повторите попытку.
API запросов поддерживается только на устройствах, которые соответствуют определенным требованиям к оборудованию. Дополнительные сведения см. в разделе "Требования к оборудованию" выше.
При необходимости измените значения параметров запроса, такие как:
- Запрос пользователя
- Системный запрос
- Схема ограничения отклика
- Дополнительные параметры>Инструкции по N-shot
Нажмите кнопку "Запрос " в нижней части страницы.
Ответ будет создан в разделе ответов на этой странице:
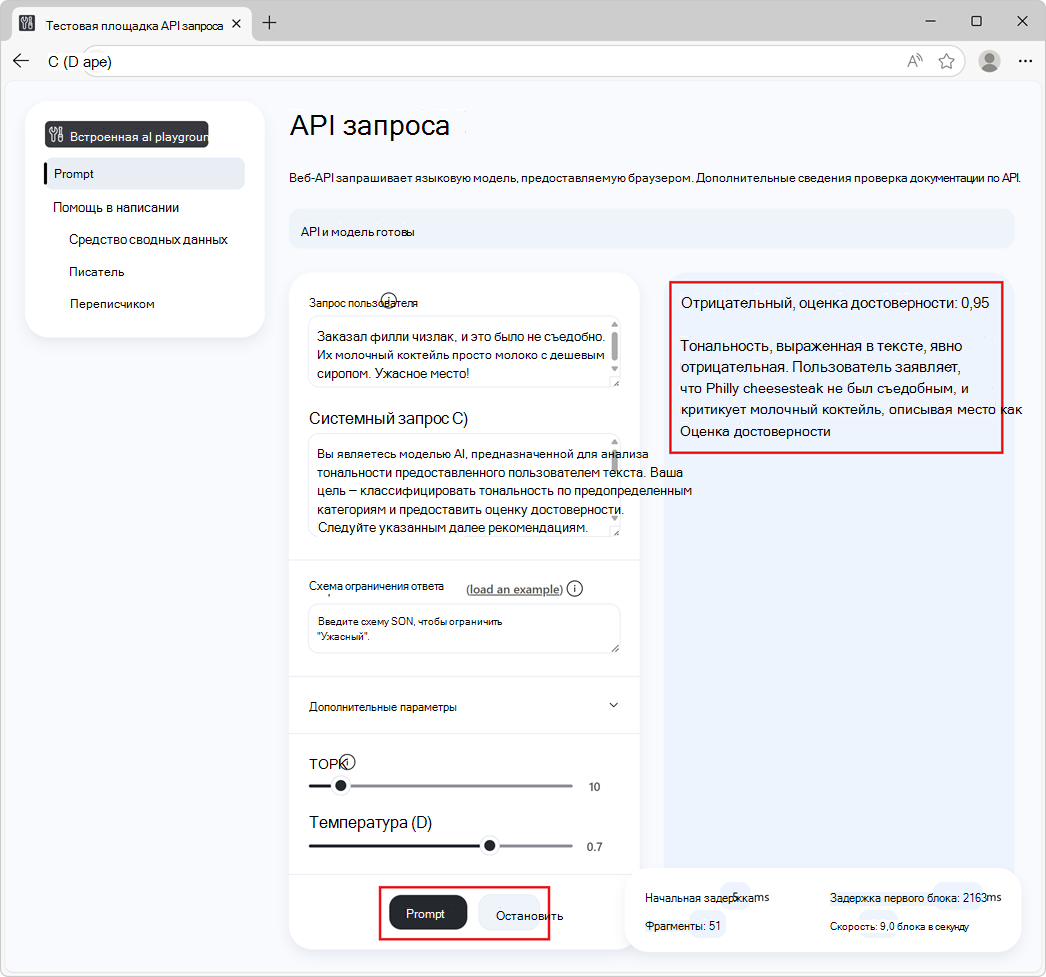
Чтобы остановить создание ответа, в любое время нажмите кнопку Стоп .
См. также:
- /built-in-ai/ — исходный код и файл сведений для встроенных игровых площадок с ИИ, включая игровую площадку API запросов.
Использование API запросов
Проверка включения API
Перед использованием API в коде веб-сайта или расширения проверка, что API включен, проверив LanguageModel наличие объекта:
if (!LanguageModel) {
  // The Prompt API is not available.
} else {
  // The Prompt API is available.
}
Проверьте, можно ли использовать модель
API запросов можно использовать только в том случае, если устройство поддерживает запуск модели, а также после загрузки языковой модели и среды выполнения модели браузером Microsoft Edge.
Чтобы проверка, можно ли использовать API, используйте метод:LanguageModel.availability()
const availability = await LanguageModel.availability();

if (availability == "unavailable") {
  // The model is not available.
}

if (availability == "downloadable" || availability == "downloading") {
  // The model can be used, but it needs to be downloaded first.
}

if (availability == "available") {
  // The model is available and can be used.
}
Создание сеанса
При создании сеанса браузеру предписывается загрузить языковую модель в память, чтобы ее можно было использовать. Прежде чем запрашивать языковую модель, создайте новый сеанс с create() помощью следующего способа:
// Create a LanguageModel session.
const session = await LanguageModel.create();
Для настройки сеанса модели вы можете передать варианты методу create() :
// Create a LanguageModel session with options.
const session = await LanguageModel.create(options);
Доступны следующие параметры:
monitor, чтобы следить за ходом загрузки модели.initialPrompts, чтобы предоставить модели контекст о подсказках, которые будут отправлены модели, и установить шаблон взаимодействия пользователя / помощника, которому модель должна следовать для будущих запросов.
Эти параметры описаны ниже.
Отслеживание хода загрузки модели
Вы можете следить за ходом загрузки модели с помощью monitor этой опции. Это полезно, если модель еще не полностью загружена на устройство, на котором она будет использоваться, чтобы сообщить пользователям вашего сайта, что им следует подождать.
// Create a LanguageModel session with the monitor option to monitor the model
// download.
const session = await LanguageModel.create({
  monitor: m => {
    // Use the monitor object argument to add an listener for the
    // downloadprogress event.
    m.addEventListener("downloadprogress", event => {
      // The event is an object with the loaded and total properties.
      if (event.loaded == event.total) {
        // The model is fully downloaded.
      } else {
        // The model is still downloading.
        const percentageComplete = (event.loaded / event.total) * 100;
      }
    });
  }
});
Предоставьте модели системный запрос
Чтобы определить системную подсказку, которая является способом предоставления инструкций модели для использования при создании текста в ответ на подсказку, используйте эту initialPrompts опцию.
Системный запрос, предоставленный при создании нового сеанса, сохраняется в течение всего сеанса, даже если окно контекста переполнено из-за слишком большого количества запросов.
// Create a LanguageModel session with a system prompt.
const session = await LanguageModel.create({
  initialPrompts: [{
    role: "system",
    content: "You are a helpful assistant."
  }]
});
Размещение { role: "system", content: "You are a helpful assistant." } запроса в любом месте за пределами 0-й позиции в initialPrompts отклонится с TypeError.
N-shot prompting with initialPrompts
Этот initialPrompts параметр также позволяет предоставлять примеры взаимодействия пользователя и помощника, которые вы хотите, чтобы модель продолжала использовать при появлении соответствующего запроса.
Этот метод также известен как N-shot prompting и полезен для того, чтобы сделать ответы, генерируемые моделью, более детерминированными.
// Create a LanguageModel session with multiple initial prompts, for N-shot
// prompting.
const session = await LanguageModel.create({
  initialPrompts: [
    { role: "system", content: "Classify the following product reviews as either OK or Not OK." },
    { role: "user", content: "Great shoes! I was surprised at how comfortable these boots are for the price. They fit well and are very lightweight." },
    { role: "assistant", content: "OK" },
    { role: "user", content: "Terrible product. The manufacturer must be completely incompetent." },
    { role: "assistant", content: "Not OK" },
    { role: "user", content: "Could be better. Nice quality overall, but for the price I was expecting something more waterproof" },
    { role: "assistant", content: "OK" }
  ]
});
Клонирование сеанса для повторного начала беседы с теми же параметрами
Клонируйте существующий сеанс для запроса модели без знаний о предыдущих взаимодействиях, но с теми же параметрами сеанса.
Клонирование сеанса полезно, когда вы хотите использовать параметры из предыдущего сеанса, не влияя на модель предыдущими ответами.
// Create a first LanguageModel session.
const firstSession = await LanguageModel.create({
  initialPrompts: [
    role: "system",
    content: "You are a helpful assistant."
  ]
});

// Later, create a new session by cloning the first session to start a new
// conversation with the model, but preserve the first session's settings.
const secondSession = await firstSession.clone();
Запрос для модели
Чтобы вызвать модель, после создания сеанса session.prompt() модели используйте методы ИЛИ session.promptStreaming() .
Дождитесь окончательного ответа
Метод prompt возвращает обещание, которое разрешается после завершения создания текста моделью в ответ на ваш запрос:
// Create a LanguageModel session.
const session = await LanguageModel.create();

// Prompt the model and wait for the response to be generated.
const result = await session.prompt(promptString);

// Use the generated text.
console.log(result);
Отображение маркеров по мере их создания
Метод promptStreaming сразу же возвращает объект потока. Используйте поток для отображения маркеров отклика по мере их создания:
// Create a LanguageModel session.
 const session = await LanguageModel.create();

// Prompt the model.
 const stream = session.promptStreaming(myPromptString);

// Use the stream object to display tokens that are generated by the model, as
// they are being generated.
for await (const chunk of stream) {
  console.log(chunk);
}
Можно вызывать методы and promptpromptStreaming несколько раз внутри одного объекта сеанса, чтобы продолжить создание текста на основе предыдущих взаимодействий с моделью в рамках этого сеанса.
Ограничьте выходные данные модели с помощью схемы JSON или регулярного выражения
Чтобы сделать формат ответов модели более детерминированным и простым в использовании программным способом, используйте соответствующий responseConstraint параметр при запросе модели.
Параметр responseConstraint принимает схему JSON или регулярное выражение:
Чтобы модель отвечала строковым объектом JSON, который следует заданной схеме, выберите
responseConstraintсхему JSON, которую нужно использовать.Чтобы модель отвечала строкой, соответствующей регулярному выражению, установите
responseConstraintэто регулярное выражение.
В следующем примере показано, как заставить модель реагировать на запрос с помощью объекта JSON, следующего заданной схеме:
// Create a LanguageModel session.
const session = await LanguageModel.create();

// Define a JSON schema for the Prompt API to constrain the generated response.
const schema = {
  "type": "object",
  "required": ["sentiment", "confidence"],
  "additionalProperties": false,
  "properties": {
    "sentiment": {
      "type": "string",
      "enum": ["positive", "negative", "neutral"],
      "description": "The sentiment classification of the input text."
    },
    "confidence": {
      "type": "number",
      "minimum": 0,
      "maximum": 1,
      "description": "A confidence score indicating certainty of the sentiment classification."
    }
  }
}
;

// Prompt the model, by providing a system prompt and the JSON schema in the
// responseConstraints option.
const response = await session.prompt(
  "Ordered a Philly cheesesteak, and it was not edible. Their milkshake is just milk with cheap syrup. Horrible place!",
  {
    initialPrompts: [
      {
        role: "system",
        content: "You are an AI model designed to analyze the sentiment of user-provided text. Your goal is to classify the sentiment into predefined categories and provide a confidence score. Follow these guidelines:\n\n- Identify whether the sentiment is positive, negative, or neutral.\n- Provide a confidence score (0-1) reflecting the certainty of the classification.\n- Ensure the sentiment classification is contextually accurate.\n- If the sentiment is unclear or highly ambiguous, default to neutral.\n\nYour responses should be structured and concise, adhering to the defined output schema."
      },
    ],
    responseConstraint: schema
  }
);
Выполнение приведенного выше кода возвращает ответ, содержащий строковый объект JSON, например:
{"sentiment": "negative", "confidence": 0.95}
Затем вы можете использовать ответ в логике кода, проанализировав его с помощью JSON.parse() функции:
// Parse the JSON string generated by the model and extract the sentiment and
// confidence values.
const { sentiment, confidence } = JSON.parse(response);

// Use the values.
console.log(`Sentiment: ${sentiment}`);
console.log(`Confidence: ${confidence}`);
Отправка нескольких сообщений в одном запросе
Помимо строк, методы and promptStreaming также принимают массив объектов, prompt который используется для отправки нескольких сообщений с пользовательскими ролями. Отправляемые объекты должны иметь форму { role, content }, где role is or user or , assistantи content является сообщением.
Например, чтобы предоставить несколько сообщений пользователя и сообщение помощника в одном запросе:
// Create a LanguageModel session.
const session = await LanguageModel.create();

// Prompt the model by sending multiple messages at once.
const result = await session.prompt([
  { role: "user", content: "First user message" },
  { role: "user", content: "Second user message" },
  { role: "assistant", content: "The assistant message" }
]);
Остановка создания текста
Чтобы прервать запрос до того, как обещание, возвращенноеsession.prompt(), будет разрешено, или до того, как закончится потокsession.promptStreaming(), возвращенный пользователем, используйте сигнал:AbortController
// Create a LanguageModel session.
const session = await LanguageModel.create();

// Create an AbortController object.
const abortController = new AbortController();

// Prompt the model by passing the AbortController object by using the signal
// option.
const stream = session.promptStreaming(myPromptString , {
  signal: abortController.signal
});

// Later, perhaps when the user presses a "Stop" button, call the abort()
// method on the AbortController object to stop generating text.
abortController.abort();
Уничтожение сеанса
Удалите сеанс, чтобы браузер знал, что языковая модель больше не нужна, чтобы модель можно было выгрузить из памяти.
Вы можете уничтожить сеанс двумя способами:
- С помощью
destroy()метода. - С помощью файла
AbortController.
Уничтожение сеанса с помощью метода destroy()
// Create a LanguageModel session.
const session = await LanguageModel.create();

// Later, destroy the session by using the destroy method.
session.destroy();
Уничтожение сеанса с помощью AbortController
// Create an AbortController object.
const controller = new AbortController();

// Create a LanguageModel session and pass the AbortController object by using
// the signal option.
const session = await LanguageModel.create({ signal: controller.signal });

// Later, perhaps when the user interacts with the UI, destroy the session by
// calling the abort() function of the AbortController object.
controller.abort();
Отправка отзывов
Предварительная версия API запросов для разработчиков предназначена для помощи в поиске вариантов использования языковых моделей, предоставляемых браузером.
Мы заинтересованы в том, чтобы узнать следующие темы:
- Диапазон сценариев, для которых вы собираетесь использовать API запросов.
- Любые проблемы с API запросов.
- Любые проблемы с языковыми моделями.
- Будут ли полезны новые API для конкретных задач.
Чтобы отправить отзыв о сценариях и задачах, которые вы хотите выполнить, добавьте комментарий к проблеме отзыва об API запросов.
Если вы обнаружите какие-либо проблемы при использовании API вместо этого, сообщите об этом в репозитории.
Вы также можете принять участие в обсуждении дизайна API запросов в репозитории W3C Web Машинное обучение Working Group.
См. также
- Запрос API черновик спецификации
- Репозиторий GitHub webmachinelearning/prompt-api
- Пишите, переписывайте и резюмируйте текст с помощью API помощи при письме
- Исправляйте грамматические, орфографические и пунктуационные ошибки в тексте с помощью API корректора
- Перевод текста с помощью API переводчика
- /built-in-ai/ — исходный код и файл сведений для встроенных игровых площадок с ИИ, включая игровую площадку API запросов.