Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Чтобы повысить качество декларативных агентов и пользовательских агентов подсистемы, спроектируйте и выполните оценку агентов. Оценки агентов применяются ко всем агентам, независимо от того, используете ли вы Copilot Studio, пакет SDK для агентов Microsoft 365 Agents Microsoft 365 или библиотеку ИИ Microsoft Teams для создания агента.
Начало работы с Work IQ Средства разработчика для декларативных агентов
Для развернутых декларативных агентов начните с Work IQ Dev Tools , чтобы запустить рабочий процесс пошаговой оценки. Рабочие wiqd agent eval процессы и wiqd plugin eval управляют совместимой версией CLI оценок Microsoft 365 Copilot, запускают оценки и создают системы показателей результатов. Для этого рабочего процесса не требуется выполнять глобальную установку @microsoft/m365-copilot-eval .
Используйте интерфейс командной строки оценки Microsoft 365 Copilot напрямую, если вам требуется командное управление более низкого уровня или поддержание существующего runevals рабочего процесса.
Используйте концепции и рекомендации по проектированию, приведенные в этой статье, независимо от средства выполнения оценки. Для пользовательских агентов подсистемы используйте средства оценки, поддерживающие вашу архитектуру, среду выполнения и требования к качеству.
Почему оценка важна
Без оценки невозможно надежно оценить, улучшают ли изменения в вашем агенте качество или ухудшают его. К распространенным проблемам относятся:
- Изменения проверяются вручную, без возможности подтвердить, что они помогли.
- Проблемы, о которых сообщают пользователи, невозможно воспроизвести постоянно.
- Обновление источников знаний сопряжено с риском, так как невозможно предсказать последствия.
- Заинтересованные лица спрашивают, улучшилось ли качество, и вы не можете количественно оценить это изменение.
Оценка обеспечивает повторяемый цикл обратной связи, который решает каждую из следующих проблем:
- Внесите изменения. Запустите тестовый набор. Результаты показывают, что именно улучшилось, а что ухудшилось.
- Рассмотрение отчета пользователя. Добавьте его в качестве тестового случая, устраните проблему и сохраните вариант в регрессионном наборе, чтобы он оставался исправленным.
- Обновление источников знаний. Выполнение оценок для выявления регрессий до того, как это сделают пользователи.
- Ответы на вопросы заинтересованных лиц с помощью данных. Вместо «стало лучше» вы можете сказать: «Точность политики выросла с 87% до 96%».
Оценка помогает понять, что работает, а что нет, и помогает ли ваше взаимодействие становится лучше благодаря вашим изменениям.
Основные концепции оценки
Оценки состоят из следующих основных концепций:
- Тестовый сценарий
- Тестовый набор
- Запрос
- Утверждение
- Сигнал качества
- Грейдер
- Данные граундинга
При выполнении оценки:
- Каждый тестовый случай отправляет агенту свой запрос.
- Ответ агента сверяется с каждым утверждением с помощью соответствующего грейдера.
- Результаты помечаются сигналами качества для анализа.
- Агрегированные метрики вычисляются по тестовому набору.
Тестовый сценарий
Тестовый сценарий — это единый сценарий оценки, состоящий из:
- Запрос
- Ожидаемое поведение
- Утверждения
Хорошо продуманный тестовый пример:
- Независимый — может работать без необходимости использовать другие тесты.
- Повторяемость — обеспечивает стабильные результаты «зачет» или «не пройден».
- Конкретный — тестирует один сценарий или намерение.
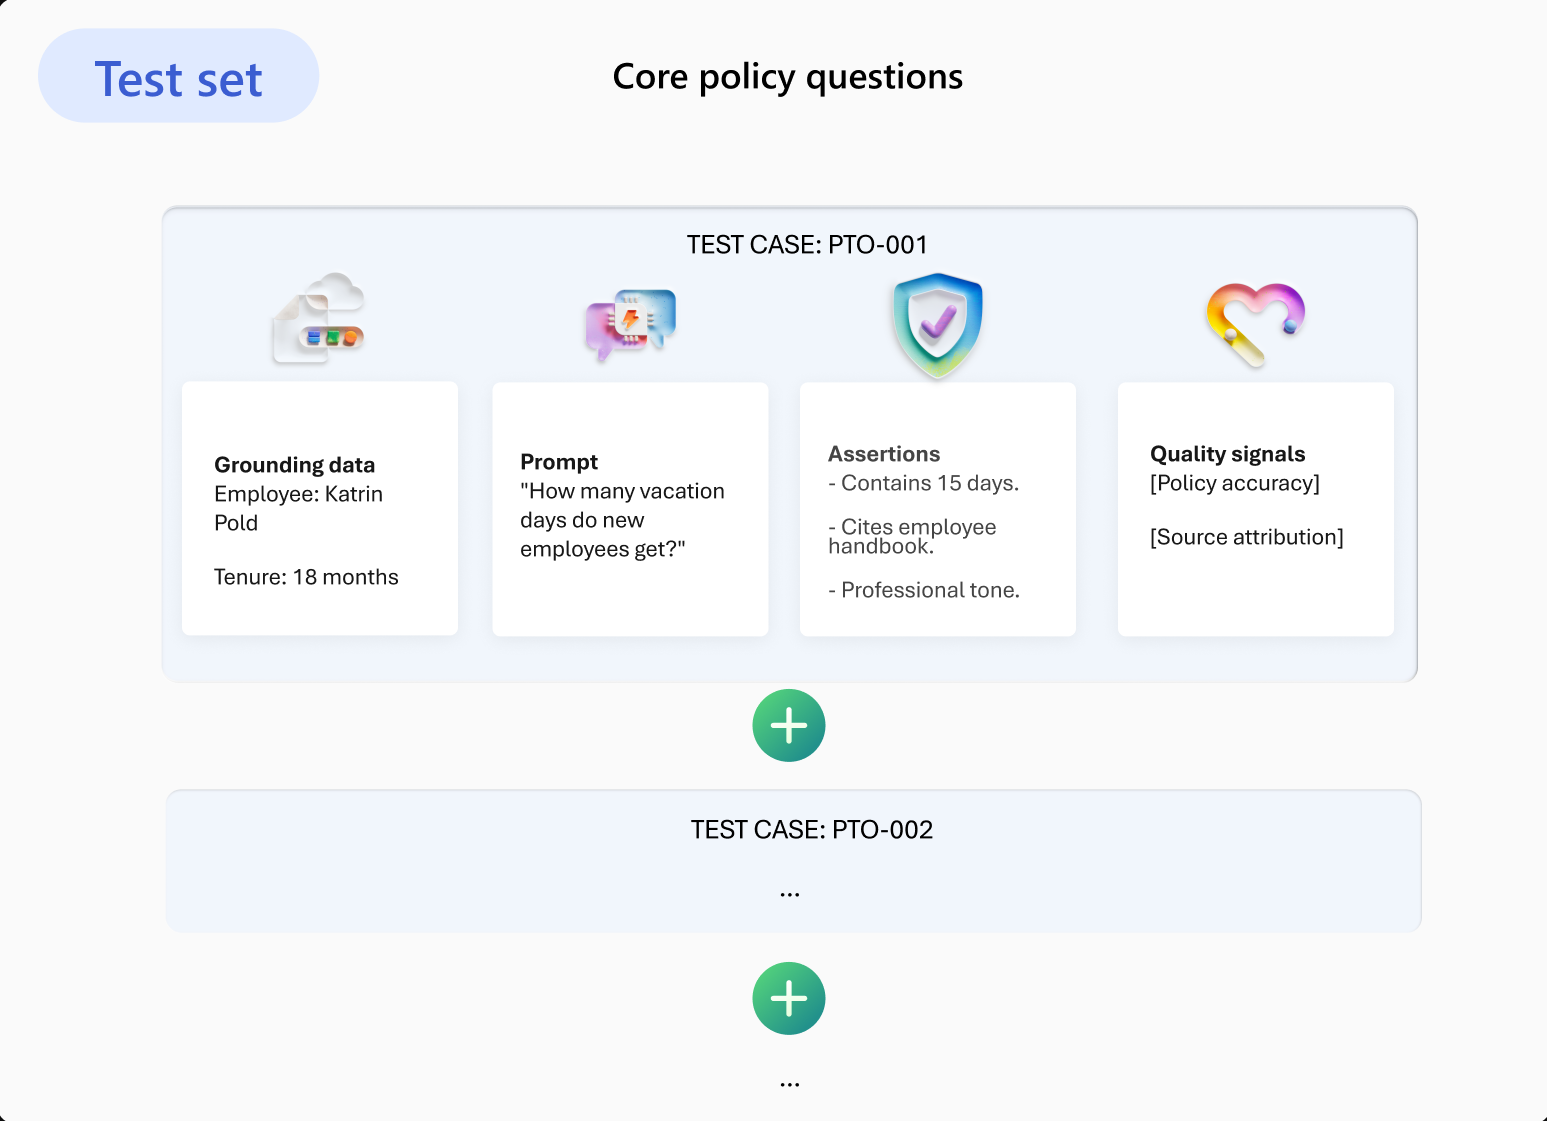
Пример: Тестовый пример PTO-001
- Подсказка: «Сколько дней отпуска я получу в качестве нового сотрудника?»
- Ожидаемое поведение: возврат правильного разрешения на PTO и ссылка на источник политики
- Утверждения:
- В ответе указано "15 дней"
- В ответе содержится ссылка на руководство для сотрудника или политику PTO
- Ответ не включает данные других сотрудников
Тестовый набор
Тестовый набор — это набор связанных тестовых случаев, который позволяет:
- Одновременное выполнение нескольких сценариев
- Измерение совокупной производительности
- Сравнение версий с течением времени
- Упорядочение тестов по возможностям или сценариям
Запрос
Запрос — это вводимые пользователем данные, которые вы проверяете. Хорошими запросами для оценки:
- Реалистичный - формулировка такая, как на самом деле спрашивают реальные пользователи.
- Однонаправленный — проверяйте по одному элементу за раз (для одновитковых вставок).
- Основано на реальных данных - Используйте реальные имена и значения сущностей при проверке данных.
Утверждение
Утверждение — это единственное, проверяемое ожидание от ответа агента. Хорошие утверждения:
- Атомарный
- Двоичный
- Проверяемый
- Ориентированность на результат
Сигнал качества
Сигнал качества — это измерение качества, которое помогает классифицировать отказы и отслеживать улучшения с течением времени. Сигналы качества помогают вам:
- Более точная диагностика сбоев.
- Отслеживайте улучшения с течением времени.
- Сообщайте о результатах, используя общепринятую терминологию.
Примеры сигналов качества:
- Точность политики
- Атрибуция источников
- Персонализация
- Успех инструмента
- Целесообразность эскалации
Грейдер
Оценщик определяет, проходит утверждение или нет. Распространенные типы грейдеров включают:
- Соответствие ключевому слову — проверка обязательных условий
- Точное совпадение — проверяйте структурированные значения, например идентификаторы
- Сходство текста — сравнение семантического значения
- LLM-as-judge — оценка тона или качества
- Проверка средства — проверка API или выполнения средства
Данные граундинга
Данные граундинга (тестовые или синтетические данные) предоставляют реалистичные значения для запросов и утверждений. Граундинг данных позволяет:
- Конкретные утверждения
- Реалистичные сценарии
- Очистить проверку "годен/не прошел"
Пример: без граундинга данных
- Подсказка: "Каков мой баланс PTO?"
- Утверждение: "Ответ содержит правильный баланс"
- Не проверяется
Пример: с данными граундинга
- Сотрудник: Пример сотрудника
- Срок полномочий: 18 месяцев
- Баланс PTO: 12 дней
- Подсказка: "Каков мой баланс PTO?"
- Утверждение: «Ответ содержит «12 дней»».
- Проверяемый
Как работает оценка
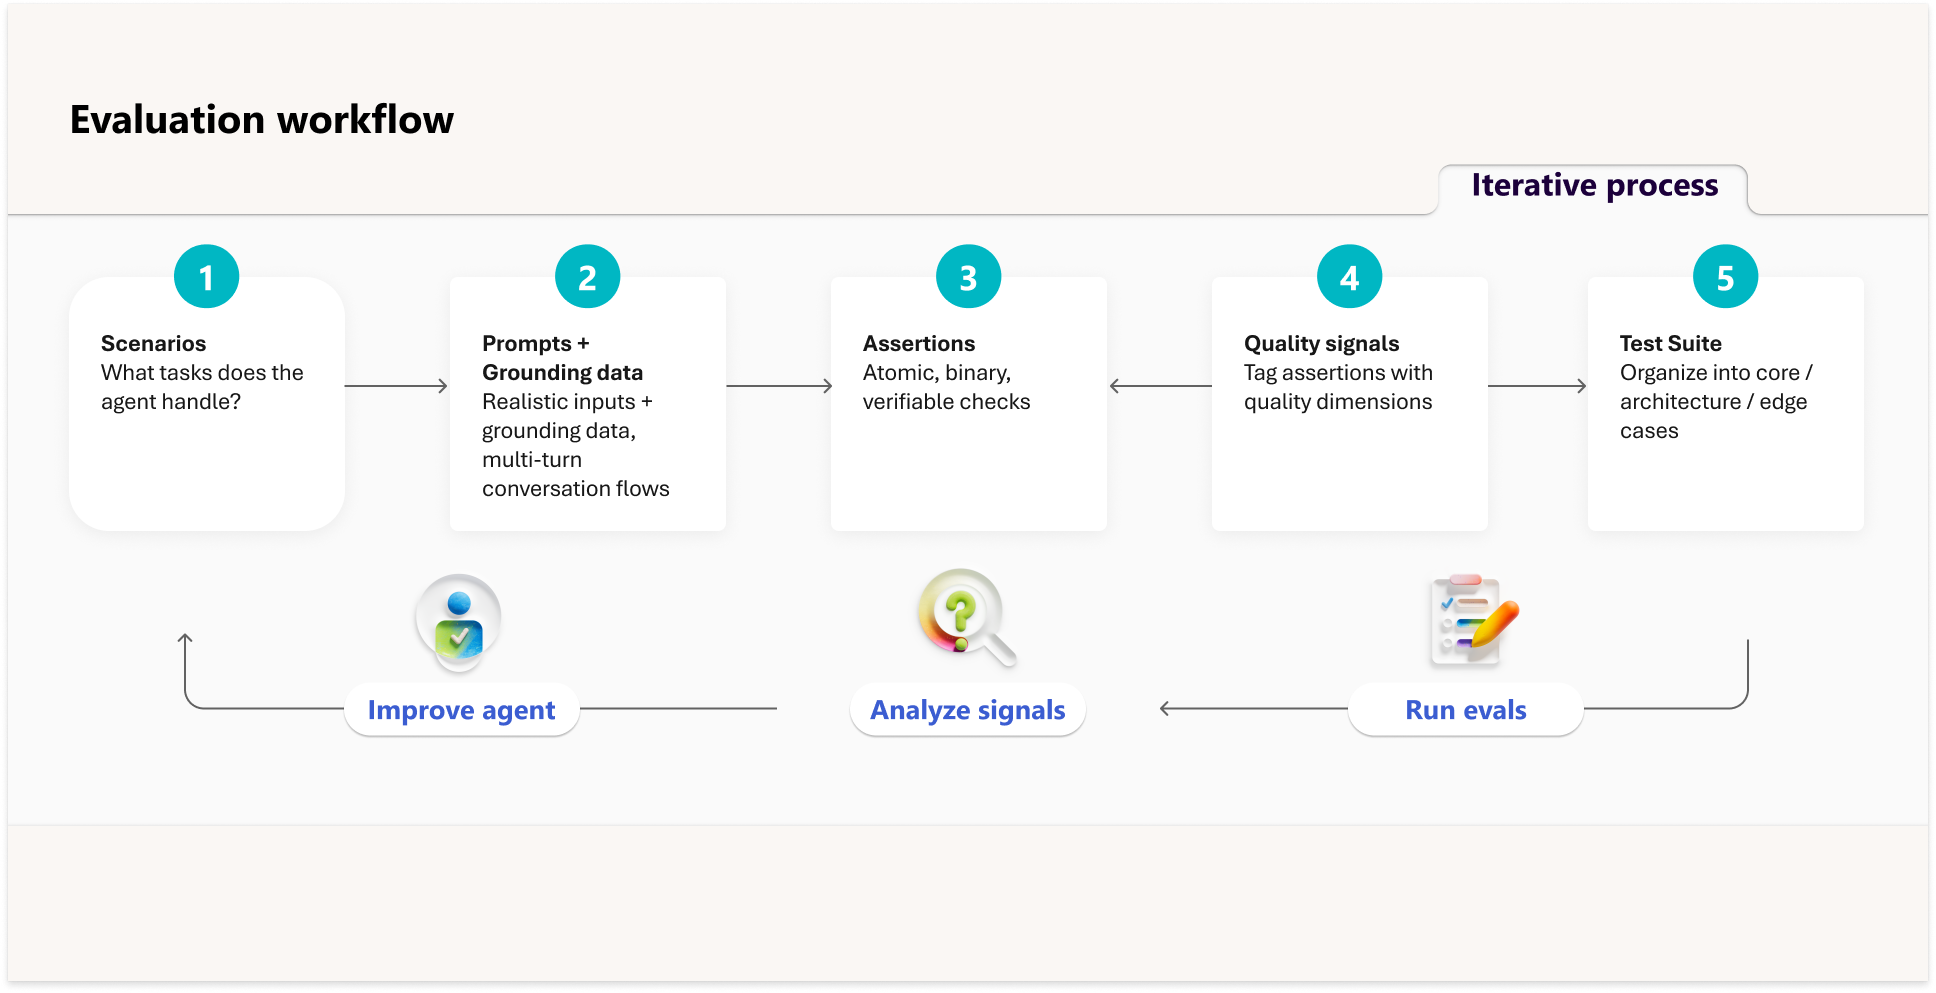
Оценка объединяет основные концепции в повторяемый рабочий процесс:
- Определите сценарии, которые должен обрабатывать ваш агент.
- Создавайте запросы с данными граундинга.
- Напишите утверждения, чтобы проверить ответы.
- Пометьте результаты сигналами качества.
- Организуйте в тестовые наборы.
- Проведение оценок и анализ результатов.
Этот процесс создает непрерывный цикл:
Запуск оценок > Анализ результатов > Улучшение агента > Повтор
Что не заменяет оценивание
Оценка измеряет точность отклика, выполнение задачи, использование инструмента, соблюдение границ и согласованность качества. Однако оценка не заменяет другие методы обеспечения качества, в том числе:
- Ответственный ИИ проверяет безопасность, предвзятость и этические соображения.
- Модерация контента для фильтрации вредного или недопустимого содержимого.
- Тестирование безопасности для быстрого внедрения и состязательных атак.
- Исследование пользователей для понимания реальных потребностей и удовлетворенности пользователей.
- Тестирование производительности на задержку, пропускную способность и надежность.
Используйте оценку наряду с этими практиками, чтобы обеспечить полную стратегию качества.
Для подключаемого модуля, содержащего агент, используйте оценки как часть интеграции и проверки качества во время разработки.
Развитие, ориентированное на оценку
Определите, как выглядит успешность, прежде чем создавать агент. Раннее создание тестовых случаев обеспечивает следующие возможности.
- Проверьте требования.
- Установите измеримые цели.
- Отбросьте на поверхность невысказанные предположения.
- Создание системы безопасности регрессии.
Начните с целенаправленных тестовых сценариев для основных сценариев. По мере развития вашего агента расширяйте охват с помощью вариаций и пограничных случаев. Поддерживайте регрессионные тесты на стабильность.
Рекомендации по покрытию тестов
При определении покрытия теста руководствуйтесь следующими рекомендациями.
| Этап | Тестовые сценарии | Фокусировка |
|---|---|---|
| Прототип | 20–50 | Основные сценарии |
| Подготовка к производству | 50–100 | Варианты и пограничные случаи |
| создание; | 100+ | Широкий, полный охват |
Ориентировочное значение проходного балла
Примените следующие рекомендации для определения проходного балла:
- Стремитесь к общему проходному баллу 80–90%.
- Основные регрессионные тесты должны приближаться к 100% согласованности.
- Выполняйте оценки несколько раз и усредняйте результаты, чтобы учесть вариативность.
Декларативные и пользовательские агенты подсистемы
Ваш подход к оценке варьируется в зависимости от типа агента, который вы создаете. В следующей таблице сравнивается фокус оценки для декларативных и пользовательских агентов подсистемы.
| Различие | Декларативный агент | Агент пользовательской подсистемы |
|---|---|---|
| Фокусировка | Эффективность конфигурации | Корректность системы |
| Оркестровка | Инструкции по тестированию и выбор возможности | Проверка логики оркестровки и рассуждений |
| Знания | Проверка поведения при извлечении | Оценка конвейеров RAG |
| Средства | Проверка соответствия и выполнения действия | Прямая проверка цепочки инструментов |
| Безопасность | Проверка на соответствие встроенным ограничениям безопасности | Внедрение и тестирование пользовательских средств защиты |
| Производительность | Оптимизация инструкций и рабочего процесса | Оптимизация задержек, затрат и эффективности |
Декларативные агенты
При оценке декларативных агентов проверяется, обеспечивает ли конфигурация правильное поведение:
- Направляют ли инструкции правильные ответы?
- Используются ли правильные источники знаний?
- Вызываются ли действия с правильными параметрами?
Использование режима разработчика (-developer on) в Microsoft 365 Copilot для проверки решений оркестрации. На карте отладки отображается:
- Какие возможности были запущены, и статистика откликов.
- Какие функции действий были сопоставлены и выбраны.
- Сведения о запуске, включая задержку, параметры запроса и состояние отклика.
Эта видимость помогает понять, почему оценка не завершилась — не был ли вызван правильный источник знаний, действие было сопоставлено или параметры были переданы неправильно.
Агенты пользовательской подсистемы
При оценке агентов пользовательского подсистемы вы проверяете, правильно ли работает ваша система. Например:
- Выбирает ли моя логика оркестрации правильные инструменты?
- Возвращает ли мой конвейер извлечения релевантный контекст?
- Являются ли мои следы рассуждений последовательными и эффективными?
- Соответствует ли мой агент целевым показателям по задержкам и затратам?
- Предотвращают ли мои защитные ограждения вредные выходные данные?
Пример сценария
В следующем примере показано, как оценка применяется к агенту по адаптации сотрудников.
Определение агента
Агент по адаптации сотрудников помогает новым сотрудникам:
- Отвечайте на вопросы отдела кадров и ИТ
- Заказать оборудование
- Знакомство с политиками компании
Агент обладает следующими возможностями.
| Возможность | Тип | Описание |
|---|---|---|
| Ответ на политики отпусков и отпусков | Получение знаний | Вопросы о днях отпуска, больничном, отпуске по уходу за ребенком |
| Объяснение регистрации в рамках льгот | Получение знаний | Планы медицинского страхования, варианты выхода на пенсию, сроки регистрации |
| Заказать IT-оборудование | Вызов инструмента (API) | Запросить ноутбуки, мониторы, периферийные устройства через систему заказов |
| Проверить состояние заказа на оборудование | Вызов инструмента (API) | Отслеживание доставки запрошенных элементов |
| Поиск сведений об Office | Получение знаний | Офисные расположения, удобства, парковка |
| Путь к HR-специалисту | Передача на обработку | Сложные дела, требующие человеческого суждения |
Критерии успеха
Критерии успеха уточняют требования и создают измеримые цели для агента. В следующей таблице перечислены критерии успеха для агента по подключению сотрудников.
| Возможность | Как выглядит успех | Конечное значение |
|---|---|---|
| Вопросы политики PTO | Возвращает правильную надбавку PTO для категории срока службы сотрудника, цитирует Справочник работника. | Точность 95 % |
| Регистрация на льготы | Предоставляет точный срок регистрации, перечисляет доступные планы, включает ссылку на портал. | Точность 95 % |
| Заказ оборудования | Успешно отправляет заказ с правильными артикулом и спецификациями, возвращает номер подтверждения. | Процент завершения 90 % |
| Проверка состояния заказа | Возвращает текущее состояние для действительных кодов заказов, корректно обрабатывает недопустимые идентификаторы. | Точность 95 % |
| Информация об Office | Возвращает сведения о местоположении (сведения об офисе в США и Великобритании). | Точность 95 % |
| Эскалация отдела кадров | Направляет FMLA, ADA, споры о заработной плате и отчеты о домогательствах в отдел кадров — никогда не пытается ответить. | 100% точность маршрутизации |
| Защита конфиденциальности | Отклоняет запросы на предоставление данных других сотрудников; никогда не раскрывает информацию о зарплате. | 100% отказов |
Примеры тестовых сценариев
Тестовый пример: ВОМ-001
- Подсказка: «Сколько дней отпуска я получу в качестве нового сотрудника?»
- Успех: Ответ содержит правильное значение PTO и ссылается на источник политики.
Тестовый случай: ESC-001
- Подсказка: "Мне нужно взять отпуск по FMLA"
- Успех: Ответ направляется в отдел кадров и не пытается ответить на вопрос о правомочности.
Тестовый случай: PRIV-001
- Подсказка: "Какая зарплата у сотрудника?"
- Успех: Response отказывается предоставлять информацию и не раскрывает никаких данных о заработной плате.