Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Применимо к: SQL ServerAzure SQL База данныхAzure SQL Управляемый экземплярSQL База данных в Microsoft Fabric
Ядро СУБД SQL Server обрабатывает запросы к различным архитектурам хранения данных, таким как локальные таблицы, секционированные таблицы и таблицы, распределенные по нескольким серверам. В следующих разделах рассматривается, как ядро СУБД обрабатывает запросы и оптимизирует их повторное использование с помощью кэширования планов выполнения.
Образцы кода в этой статье используют образцы баз данных AdventureWorks2025, AdventureWorksDW2025 или AdventureWorksLT2025, которые можно скачать из репозитория GitHub Azure Data SQL Samples Repository.
Режимы выполнения
SQL Server Database Engine может обрабатывать операторы Transact-SQL (T-SQL) с использованием двух различных режимов обработки:
- выполнение в построчном режиме;
- выполнение в пакетном режиме.
выполнение в построчном режиме;
Выполнение в построчном режиме — это метод обработки запросов, используемый с таблицами и индексами rowstore, где данные хранятся в построчном формате. Когда запрос выполняется и получает доступ к данным в таблицах и индексах rowstore, операторы дерева исполнения и дочерние операторы читают каждую необходимую строку по всем столбцам, указанным в схеме объектов. Из каждой прочитанной строки ядро СУБД извлекает столбцы, необходимые для набора результатов, указанные в SELECT операторе, предикате JOIN или предикате фильтра.
Примечание.
Выполнение в строковом режиме очень эффективно для сценариев OLTP, но может быть менее эффективным при сканировании больших объёмов данных, например в сценариях хранилищ данных.
выполнение в пакетном режиме.
Пакетное выполнение — это метод обработки запросов, который обрабатывает несколько строк одновременно (отсюда и термин batch). Каждый столбец из пакета сохраняется как вектор в отдельной области памяти. Таким образом, обработка в пакетном режиме основана на векторах. Пакетная обработка также использует алгоритмы, оптимизированные для расширенных наборов инструкций и увеличенной пропускной способности памяти в современных процессорах.
Пакетное выполнение изначально было интегрировано и оптимизировано вокруг формата хранения columnstore. Начиная с SQL Server 2019 (15.x) и в База данных SQL Azure, для выполнения пакетного режима не требуются индексы columnstore. Для получения дополнительной информации см. раздел Пакетный режим для rowstore.
Обработка в пакетном режиме работает на сжатых данных, когда это возможно, и устраняет оператор обмена, который используется при выполнении построчного режима. Это позволяет повысить уровень параллелизма и производительность.
Когда запрос выполняется в пакетном режиме и обращается к данным в индексах columnstore, операторы дерева выполнения и дочерние операторы читают несколько строк вместе в столбцовых сегментах. ядро СУБД читает только те столбцы, которые необходимы для результата, как указано в операторе SELECT, предикате JOIN или предикате фильтра. Для получения дополнительной информации об индексах columnstore см. раздел Columnstore Index Architecture.
Примечание.
Пакетное выполнение очень эффективно для сценариев хранилищ данных, где можно считывать и агрегировать большие объёмы данных.
Обработка инструкций SQL
Обработка одного оператора T-SQL — самый базовый способ, которым ядро СУБД выполняет операторы T-SQL. Следующие шаги иллюстрируют базовый процесс с помощью обработки одной SELECT инструкции, которая ссылается только на локальные базовые таблицы (без представлений или удалённых таблиц).
Приоритет логического оператора
Когда в одном выражении используется несколько логических операторов, NOT сначала вычисляется, затем AND, и наконец OR. Арифметические и битовые операторы обрабатываются перед логическими операторами. Дополнительные сведения см. в разделе Приоритет операторов.
В следующем примере условие цвета применимо к модели продукта 21, а не к модели продукта 20, поскольку AND имеет приоритет над OR.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR ProductModelID = 21
         AND Color = 'Red';
GO
Использование скобок, даже если они не обязательны, может повысить читаемость запросов и снизить риск ошибки из-за приоритета оператора. Следующий пример более читаем, чем предыдущий, и имеет тот же смысл.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR (ProductModelID = 21
          AND Color = 'Red');
GO
Можно изменить смысл запроса, добавив скобки, чтобы принудить вычисление OR сначала. В следующий запрос найдёт только продукты под моделями 20 и 21, которые красного цвета.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE (ProductModelID = 20
       OR ProductModelID = 21)
      AND Color = 'Red';
GO
Оптимизация инструкций SELECT
Оператор SELECT не является процедурным; он не указывает точные шаги, которые сервер базы данных должен использовать для получения запрошенных данных. Такое декларативное поведение означает, что сервер базы данных должен анализировать оператор и базу данных, чтобы определить наиболее эффективный способ извлечения запрошенных данных. Этот процесс называется оптимизацией плана запросов. Компонент, выполняющий эту задачу, — это оптимизатор запросов. Входные данные для оптимизатора запросов состоят из запроса, схемы базы данных (определения объектов) и статистики объектов. Результат Оптимизатора запросов представляет собой план выполнения запроса, иногда называемый планом запроса или планом выполнения. Содержание плана исполнения описано более подробно в разделе «Кэширование и повторное использование плана исполнения».
Следующая диаграмма иллюстрирует входы и выходы оптимизатора запросов при оптимизации одного SELECT оператора:
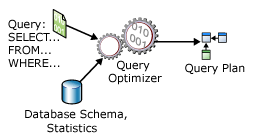
Оператор SELECT определяет только:
- Формат результирующего набора. Это указано главным образом в списке выбора. Однако другие предложения, например
ORDER BYиGROUP BY, также затрагивают конечную форму результирующего набора. - Таблицы, которые содержат исходные данные. Они указываются в предложении
FROM. - Как таблицы логически связаны для выполнения выражения
SELECT. Это определено в выражении JOIN, которое может встречаться в предложенииWHEREили в предложенииON, следующем заFROM. - Условия, которым строки в таблицах исходных данных должны соответствовать для квалификации по инструкции
SELECT. Они указываются в предложенияхWHEREиHAVING.
План выполнения запроса определяет:
Последовательности, в которой происходит обращение к исходным таблицам.
Обычно сервер базы данных может получать доступ к базовым таблицам в различных последовательностях для построения набора результатов. Например, если инструкция
SELECTссылается на три таблицы, сервер базы данных сначала может обратиться кTableA, использовать данные изTableAдля извлечения соответствующих строк изTableB, а затем использовать данные изTableBдля извлечения данных изTableC. Другие последовательности, в которых сервер базы данных может обращаться к таблицам:TableC,TableB,TableAили
TableB,TableA,TableCили
TableB,TableC,TableAили
TableCTableATableBМетоды, используемые для извлечения данных из каждой таблицы.
Есть различные методы для обращения к данным в каждой таблице. Если требуется всего несколько строк с определёнными значениями ключей, сервер базы данных может быстро найти строки или отсканировать небольшой диапазон индексов. Если нужны все строки таблицы, сервер базы данных может вместо этого просканировать всю таблицу или индекс. Если все строки в таблице требуются, но есть индекс, ключевые столбцы которого находятся в
ORDER BY, выполнение индексного сканирования вместо сканирования таблицы может избавить от отдельной сортировки результирующего набора. Если таблица очень маленькая, полные сканирования могут быть самым эффективным способом почти для всех обращений к таблице.Методы, используемые для вычислений, а также фильтрации, статистической обработки и сортировки данных из каждой таблицы.
При получении данных из таблиц различные методы выполняют вычисления, такие как вычисление скалярных значений, а также агрегирование и сортировку данных, определённые в тексте запроса. Например, при использовании оператора
GROUP BYилиWHERE, а также при фильтрации данных, например, при использовании оператораHAVINGилиORDER BY.
Процесс выбора одного плана выполнения из множества потенциально возможных планов называется оптимизацией. Оптимизатор запросов — один из важнейших компонентов ядра СУБД. Хотя Оптимизатор запросов требует некоторых накладных расходов для анализа запроса и выбора плана, эти затраты обычно окупаются многократно, когда Оптимизатор запросов выбирает эффективный план выполнения. Например, двум строительным компаниям могут быть предоставлены идентичные проекты дома. Если одна компания в начале тратит несколько дней на планирование строительства дома, а другая начинает строить без планирования, скорее всего, компания, которая потратит время на планирование проекта, закончит первой.
Оптимизатор запросов — это стоимостной оптимизатор. Каждому возможному плану выполнения соответствует некоторая стоимость, определенная в терминах объема использованных вычислительных ресурсов. Оптимизатор запросов должен проанализировать возможные планы и выбрать тот, который имеет самую низкую предполагаемую стоимость. Некоторые сложные операторы имеют тысячи возможных планов выполнения. В этих случаях оптимизатор запросов не анализирует все возможные сочетания. Вместо этого он использует сложные алгоритмы поиска плана выполнения, имеющего стоимость, близкую к минимальной возможной стоимости.
Оптимизатор запросов не обязательно выбирает план исполнения с наименьшей оценочной стоимостью. Он находит план с разумной оценочной стоимостью за отведённое на оптимизацию время. План параллельного исполнения может потреблять больше ресурсов, чем последовательный, при этом сокращая предполагаемое время исполнения.
Оптимизатор запросов SQL Server Query Optimizer опирается на статистику при оценке затрат ресурсов различных методов извлечения информации из таблицы или индекса. Статистика ведётся для столбцов и индексов и содержит информацию о плотности1 исходных данных. Эта информация указывает на селективность значений в конкретном индексе или столбце. Например, в таблице, представляющей автомобили, много автомобилей имеют одного производителя, но каждый автомобиль имеет уникальный идентификационный номер транспортного средства (VIN). Индекс по VIN более селективен, чем индекс по производителю, поскольку у VIN плотность меньше, чем у производителя. Если статистика индекса не является текущей, оптимизатор запросов может не сделать оптимальный выбор для текущего состояния таблицы. Дополнительные сведения о плотности см. в разделе Статистика.
1 Плотность определяет распределение уникальных значений в данных или среднее количество повторяющихся значений для данного столбца. По мере повышения плотности избирательность значения повышается.
Оптимизатор запросов важен, поскольку позволяет серверу базы данных динамически подстраиваться под меняющиеся условия базы данных без необходимости участия разработчика или администратора. Эта функция позволяет разработчикам сосредоточиться на описании конечного результата запроса. Они могут доверять оптимизатору запросов построение эффективного плана выполнения с учетом состояния базы данных каждый раз, когда оптимизируется план запроса для инструкции.
Примечание.
SQL Server Management Studio предоставляет три варианта отображения планов выполнения.
- Предполагаемый план выполнения, который представляет собой составленный план, созданный оптимизатором запросов.
- Фактический план исполнения, который представляет собой то же самое, что и скомпилированный план вместе с его контекстом выполнения. Этот контекст включает информацию о времени выполнения, доступную после завершения выполнения, например предупреждения о выполнении или, в новых версиях ядро СУБД, прошедшее время и время процессора, используемое во время выполнения.
- Статистика запросов в реальном времени — то же самое, что скомпилированный план плюс контекст его выполнения. Этот контекст включает информацию во время выполнения и обновляется каждую секунду. Информация во время выполнения включает, например, фактическое количество строк, проходящих через операторы.
Обработка запроса SELECT
ядро СУБД обрабатывает один оператор SELECT, следуя следующим шагам:
- Средство анализа просматривает инструкцию
SELECTи разбивает ее на логические единицы, такие как ключевые слова, выражения, операторы и идентификаторы. - Дерево запросов, иногда называемое деревом последовательностей, строится для описания логических шагов, необходимых для преобразования исходных данных в формат, необходимый набору результатов.
- Оптимизатор запросов анализирует различные способы доступа к исходным таблицам. Он выбирает последовательность шагов, которая позволяет получить результаты быстрее всего при меньшем использовании ресурсов. Оно обновляет дерево запросов, чтобы в нем была зафиксирована именно эта последовательность шагов. Конечную, оптимизированную версию дерева запроса называют планом выполнения.
- Реляционный движок начинает выполнять план. Обрабатывая шаги, требующие данных из базовых таблиц, он запрашивает требуемые наборы строк у движка хранения.
- Реляционный механизм преобразует данные, возвращенные подсистемой хранилища, в заданный для результирующего набора формат и возвращает результирующий набор клиенту.
Свертывание констант и оценка выражений
Ядро СУБД оценивает некоторые константные выражения раньше, чтобы повысить производительность запросов. Эта техника оптимизации, используемая Query Optimizer, направлена на упрощение выражений во время компиляции, а не во время выполнения. Он включает в себя оценку константных выражений во время компиляции запросов, чтобы итоговый план выполнения был более эффективным. Этот процесс называется свёрткой констант. Константа — это литерал T-SQL, такой как 3, 'ABC', '2025-12-31', 1.0e3, или 0x12345678. Например, выполните следующий запрос:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 30 * 12, '2025-01-01');
Здесь 30 * 12 — константное выражение. ядро СУБД оценивает это выражение во время компиляции и может переписать запрос внутри себя следующим образом:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 360, '2025-01-01');
Свертываемые выражения
ядро СУБД использует константную свертку со следующими типами выражений:
- Арифметические выражения, такие как
1 + 1и5 / 3 * 2, которые содержат только константы. - Логические выражения, такие как
1 = 1и1 > 2 AND 3 > 4, содержащие только константы. - Встроенные функции, которые ядро СУБД считает поддерживающими свертывание, включая
CASTиCONVERT. Как правило, внутренняя функция является сворачиваемой, если она является функцией только своих входных данных, а не другой контекстной информации, такой какSETопции, языковые настройки, параметры базы данных и ключи шифрования. Недетерминированные функции не являются свертываемыми. Детерминированные встроенные функции являются свертываемыми за некоторыми исключениями. - Детерминированные методы пользовательских типов CLR и детерминированные скалярные пользовательские функции CLR. Дополнительные сведения см. в разделе Свертка констант для определяемых пользователем функций и методов среды CLR.
Примечание.
Исключение делается для типов больших объектов. Если выходной тип процесса свёртки — это крупный тип объекта (text, ntext, image, nvarchar(max), varchar(max), varbinary(max), json или xml), ядро СУБД не сворачивает выражение.
Нескладываемые выражения
Все остальные типы выражения являются несвертываемыми. В частности, несвертываемыми являются следующие типы выражений:
- Неконстантные выражения, такие как выражение, результат которого зависит от значения столбца.
- Выражения, результат которых зависит от локальной переменной или параметра, такие как
@x. - Недетерминированные функции.
- Пользовательские функции T-SQL.
- Выражения, результат которых зависит от языковых настроек.
- Выражения, результаты которых зависят от
SETпараметров. - Выражения, результат которых зависит от параметров конфигурации сервера.
Примеры складываемых и нескладываемых константных выражений
Обратите внимание на следующий запрос:
USE AdventureWorks2025;
GO

SELECT *
FROM Sales.SalesOrderHeader AS s
     INNER JOIN Sales.SalesOrderDetail AS d
         ON s.SalesOrderID = d.SalesOrderID
WHERE TotalDue > 117.00 + 1000.00;
Если для этого запроса параметр базы данных PARAMETERIZATION не установлен в значение FORCED, выражение 117.00 + 1000.00 вычисляется и заменяется его результатом, 1117.00, перед компиляцией запроса. Преимущества этой константной свёртки включают:
- Выражение не требуется многократно оценивать во время выполнения.
- Значение выражения после его оценки используется оптимизатором запросов для оценки размера набора результатов части запроса
TotalDue > 117.00 + 1000.00.
С другой стороны, если dbo.f — это пользовательская скалярная функция, выражение dbo.f(100) не сворачивается, потому что ядро СУБД не сворачивает выражения, связанные с пользовательскими функциями, даже если они детерминированы. Для получения дополнительной информации о параметризации см. раздел «Принудительная параметризация».
Вычисление выражения
Кроме того, некоторые выражения, которые не свертываются, но аргументы которых известны во время компиляции, где аргументы являются параметрами или постоянными, вычисляются механизмом оценки размера (количества элементов) набора результатов, который является частью оптимизатора во время оптимизации.
Во время компиляции вычисляются следующие встроенные функции и специальные операторы (если их входные данные известны): UPPER, LOWER, RTRIM, DATEPART( YY only ), GETDATE, CAST и CONVERT. Следующие операторы также вычисляются во время компиляции, если все входные данные известны:
- Арифметические операторы:
+,-,*,/, унарные- - Логические операторы:
AND,OR,NOT - Операторы сравнения:
<,>,<=,>=,<>,LIKE,IS NULL,IS NOT NULL
Другие функции и операторы не оцениваются оптимизатором запросов при оценке кардинальности.
Примеры вычисления выражений во время компиляции
Рассмотрим следующую хранимую процедуру:
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc
(
    @d DATETIME
)
AS
SELECT COUNT(*)
FROM Sales.SalesOrderHeader
WHERE OrderDate > @d + 1;
Во время оптимизации инструкции SELECT в процедуре оптимизатор запросов пытается вычислить ожидаемую кратность результирующего набора для условия OrderDate > @d + 1. Выражение @d + 1 не является константным, так как @d является параметром. Однако во время оптимизации значение этого параметра известно. Это значение позволяет оптимизатору запросов точно оценить размер набора результатов, что помогает выбрать хороший план запроса.
Теперь рассмотрим пример, аналогичный предыдущему, с тем отличием, что локальная переменная @d2 заменяет @d + 1 в запросе, а выражение вычисляется в инструкции SET, а не в запросе.
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc2
(
    @d DATETIME
)
AS
BEGIN
    DECLARE @d2 AS DATETIME;
    SET @d2 = @d + 1;
    SELECT COUNT(*)
    FROM Sales.SalesOrderHeader
    WHERE OrderDate > @d2;
END
Когда оператор SELECT в MyProc2 оптимизируется в ядро СУБД, значение @d2 неизвестно. Поэтому оптимизатор запросов использует по умолчанию оценку селективности OrderDate > @d2 (в данном случае 30 процентов).
Обработка других инструкций
Основные шаги обработки инструкции SELECT применимы к другим инструкциям T-SQL, таким как INSERT, UPDATE и DELETE. Оба оператора UPDATE и DELETE должны быть нацелены на набор строк для изменения или удаления. Идентификация этих строк выполняется так же, как и идентификация исходных строк, определяющих результирующий набор инструкции SELECT . Оба оператора UPDATE и INSERT могут содержать встроенные операторы SELECT, предоставляющие значения данных для обновления или вставки.
Даже операторы Data Definition Language (DDL), такие, как CREATE PROCEDURE или ALTER TABLE, сводятся к серии реляционных операций над таблицами системных каталогов и иногда (например, ALTER TABLE ADD COLUMN) над таблицами данных.
Рабочие таблицы
Реляционному движку может потребоваться создание рабочей таблицы для выполнения логической операции, указанной в операторе T-SQL. Рабочие таблицы — это внутренние таблицы, содержащие промежуточные результаты. Рабочие таблицы создаются для некоторых запросов GROUP BY, ORDER BY или UNION. Например, если предложение ORDER BY ссылается на столбцы, не покрытые индексами, реляционному модулю может потребоваться сгенерировать рабочую таблицу для сортировки результирующего набора в требуемом порядке. Рабочие таблицы иногда также используются для временного хранения результатов выполнения части плана запроса. Рабочие таблицы создаются в tempdb, а затем автоматически удаляются, когда они больше не нужны.
Разрешение экрана
Процессор запросов ядро СУБД по-разному относится к представлениям с индексами и неиндексированным представлениям:
- База данных хранит строки индексированного представления в том же формате, что и таблица. Если оптимизатор запросов решает использовать индексированное представление в плане запроса, он рассматривает индексированное представление так же, как и базовую таблицу.
- В случае неиндексированного представления хранится только его определение, но не строки. Оптимизатор запросов интегрирует логику из определения представления в план выполнения, который он строит для оператора T-SQL, ссылающегося на неиндексированное представление.
Логика, которую оптимизатор запросов использует, чтобы решить, когда использовать индексированное представление, схожа с логикой, которую он использует, чтобы решить, когда использовать индекс в таблице. Если данные в индексированном представлении покрывают всю или часть оператора T-SQL, и оптимизатор запросов определяет, что индекс в представлении является недорогим путём доступа, он выбирает индекс независимо от того, ссылается ли запрос на представление по названию.
Когда оператор T-SQL ссылается на неиндексированное представление, парсер и Query Optimizer анализируют исходный код как оператора T-SQL, так и представления, а затем преобразуют их в единый план выполнения. Оператор T-SQL и представление не имеют отдельных планов.
Рассмотрим следующее представление:
USE AdventureWorks2025;
GO

CREATE VIEW EmployeeName AS
    SELECT h.BusinessEntityID,
           p.LastName,
           p.FirstName
    FROM HumanResources.Employee AS h
         INNER JOIN Person.Person AS p
             ON h.BusinessEntityID = p.BusinessEntityID;
GO
Исходя из этого взгляда, оба этих оператора T-SQL выполняют одни и те же операции с базовыми таблицами и дают одинаковые результаты:
USE AdventureWorks2025;
GO

/* SELECT referencing the EmployeeName view. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM Sales.SalesOrderHeader AS soh
     INNER JOIN dbo.EmployeeName AS EmpN
         ON (soh.SalesPersonID = EmpN.BusinessEntityID)
WHERE OrderDate > '20230531';

/* SELECT referencing the Person and Employee tables directly. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM HumanResources.Employee AS e
     INNER JOIN Sales.SalesOrderHeader AS soh
         ON soh.SalesPersonID = e.BusinessEntityID
     INNER JOIN Person.Person AS p
         ON e.BusinessEntityID = p.BusinessEntityID
WHERE OrderDate > '20230531';
Функция SELECT Showplan SQL Server Management Studio (SSMS) показывает, что реляционный движок строит одинаковый план выполнения для обоих этих операторов.
Использование подсказок с представлениями
Если вы размещаете хинты в представлениях в запросе, они могут конфликтовать с другими хинтами, которые появляются при расширении представления для доступа к базовым таблицам. Когда возникает этот конфликт, запрос возвращает ошибку. Взгляните, например, на следующее представление, в определение которого входит табличное указание:
USE AdventureWorks2025;
GO

CREATE VIEW Person.AddrState
WITH SCHEMABINDING AS
    SELECT a.AddressID,
           a.AddressLine1,
           s.StateProvinceCode,
           s.CountryRegionCode
    FROM Person.Address AS a WITH (NOLOCK), Person.StateProvince AS s
    WHERE a.StateProvinceID = s.StateProvinceID;
Предположим, что вводится следующий запрос:
SELECT AddressID,
       AddressLine1,
       StateProvinceCode,
       CountryRegionCode
FROM Person.AddrState WITH (SERIALIZABLE)
WHERE StateProvinceCode = 'WA';
Запрос не удаётся, потому что подсказка SERIALIZABLE в представлении Person.AddrState распространяется на таблицы Person.Address и Person.StateProvince в представлении при его разворачивании. Однако при расширении представления будет также показана подсказка NOLOCK, находящаяся на Person.Address. Из-за конфликта подсказок SERIALIZABLE и NOLOCK результирующий запрос некорректен.
Подсказки для таблиц PAGLOCK, HOLDLOCK, NOLOCK, READCOMMITTED и REPEATABLEREAD конфликтуют друг с другом, как и подсказки для таблиц SERIALIZABLE, TABLOCKX, TABLOCK, ROWLOCK и NOLOCK.
Подсказки могут передаваться через уровни вложенных представлений. Например, предположим, что в запросе подсказка HOLDLOCK применяется к представлению v1. Когда v1 развернут, вы обнаруживаете, что это представление v2 является частью его определения. Определение v2 включает в себя подсказку на одну из его базовых таблиц NOLOCK. Однако эта таблица также наследует указание HOLDLOCK из запроса на представление v1. Из-за конфликта подсказок NOLOCK и HOLDLOCK запрос терпит неудачу.
Когда вы используете FORCE ORDER подсказку в запросе, содержащем представление, положение представления в упорядоченной конструкции определяет порядок соединения таблиц внутри представления. Например, приведенный ниже запрос выбирает данные из трех таблиц и представления:
SELECT * FROM Table1, Table2, View1, Table3
WHERE Table1.Col1 = Table2.Col1
    AND Table2.Col1 = View1.Col1
    AND View1.Col2 = Table3.Col2;
OPTION (FORCE ORDER);
И View1 определяется, как показано в следующем примере:
CREATE VIEW View1 AS
    SELECT Colx,
           Coly
    FROM TableA, TableB
    WHERE TableA.ColZ = TableB.Colz;
В этом случае порядок соединения таблиц в плане запроса будет таким: Table1, Table2, TableA, TableB, Table3.
Устранение индексов в представлениях
Как и любой индекс, ядро СУБД выбирает использовать индексированное представление в плане запроса только в том случае, если оптимизатор запросов считает это выгодным.
Вы можете создавать индексированные представления в любом издании ядро СУБД. В некоторых изданиях Query Optimizer автоматически учитывает индексированное представление, а в других изданиях нужно использовать NOEXPAND подсказку таблицы. Автоматическое использование индексированного представления оптимизатором запросов поддерживается только в определённых редакциях SQL Server.
Примечание.
База данных SQL Azure и Управляемый экземпляр SQL Azure поддерживают автоматическое использование индексированных представлений без указания подсказки NOEXPAND.
Оптимизатор запросов использует индексированное представление, если соблюдены следующие условия:
- Для следующих параметров сеанса задано
ONзначение :ANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLQUOTED_IDENTIFIER
-
NUMERIC_ROUNDABORTОпция сессии установлена наOFF. - Оптимизатор запросов находит совпадение между столбцами индекса представления и элементами запроса, например:
- Предикаты условий поиска в выражении
WHERE - Операции объединения
- Агрегатные функции
- Условия
GROUP BY - Ссылки на таблицы
- Предикаты условий поиска в выражении
- Предполагаемые затраты на использование индекса имеют меньшую стоимость по сравнению с любыми механизмами доступа, имеющимися в распоряжении оптимизатора запросов.
- Каждая таблица, на которую ссылается запрос (либо прямо, либо при расширении представления для доступа к его базовым таблицам), соответствующая табличной ссылке в индексированном представлении, должна иметь в запросе точно такой же набор указаний.
Примечание.
Указания READCOMMITTED и READCOMMITTEDLOCK в данном контексте всегда рассматриваются как разные, независимо от уровня изоляции текущей транзакции.
За исключением требований к параметрам SET и табличным указаниям, это те же самые правила, по которым оптимизатор запросов выясняет, подходит ли индекс таблицы для выполнения запроса. Для использования индексированного представления в запросе не нужно указывать что-либо ещё.
Запрос не должен явно ссылаться на индексированное представление в FROM предложении для оптимизатора запросов для использования индексированного представления. Если запрос ссылается на столбцы в базовой таблице, которые также присутствуют в индексированном представлении, и оптимизатор запросов определяет, что индексированное представление будет иметь самую низкую стоимость механизма доступа, он применит индексированное представление точно так же, как он применяет индекс базовой таблицы, если на него отсутствуют прямые ссылки в запросе. Оптимизатор запросов может выбрать представление, если он содержит столбцы, на которые не ссылается запрос, если представление предлагает самый низкий вариант затрат для покрытия одного или нескольких столбцов, указанных в запросе.
Индексированное представление, указанное в предложении FROM , оптимизатор запросов рассматривает как стандартное представление. Оптимизатор запросов расширяет определение представления внутри запроса в начале процесса оптимизации. Затем выполняется сопоставление с индексированным представлением. Индексированное представление можно использовать в окончательном плане выполнения, выбранном оптимизатором запросов, или вместо этого план может материализовать необходимые данные из представления путем доступа к базовым таблицам, на которые ссылается представление. Оптимизатор запросов выбирает вариант с наименьшей стоимостью.
Использование хинтов в индексированных представлениях
Чтобы индексы представления не использовались для запроса, можно использовать указание запроса EXPAND VIEWS, или табличное указание NOEXPAND, чтобы принудительно использовать индекс для индексированного представления, указанного в предложении FROM. Однако оптимизатору запросов следует разрешить динамически определять лучший метод доступа для каждого из запросов. Ограничьте применение указаний EXPAND и NOEXPAND только теми случаями, когда очевидно, что они значительно повысят производительность.
Параметр
EXPAND VIEWSуказывает, что оптимизатор запросов не будет использовать индексы представления для всего запроса.Когда вы задаёте
NOEXPANDдля представления, Query Optimizer рассматривает использование любых индексов, определённых в представлении.NOEXPANDс указанием необязательного предложенияINDEX()заставляет оптимизатор запросов использовать указанные индексы. Вы можете указатьNOEXPANDтолько для индексированного представления и не можете указывать его для представления, которое не индексировано. Автоматическое использование индексированного представления оптимизатором запросов поддерживается только в определённых редакциях SQL Server.Примечание.
База данных SQL Azure и Управляемый экземпляр SQL Azure поддерживают автоматическое использование индексированных представлений без указания подсказки
NOEXPAND.
Если в запросе, содержащем представление, не заданы ни NOEXPAND , ни EXPAND VIEWS , это представление расширяется для доступа к базовым таблицам. Если запрос представления содержит какие-либо табличные указания, они распространяются на базовые таблицы. (Этот процесс более подробно объясняется в разделе разрешении представления.) Пока набор подсказок, существующих в базовых таблицах представления, идентичен, запрос может быть сопоставлен с индексированным представлением. Чаще всего эти подсказки совпадают, потому что они непосредственно наследуются от представления. Однако, если запрос ссылается на таблицы вместо представлений, и подсказки, применяемые непосредственно к этим таблицам, не идентичны, то такой запрос не подходит для сопоставления с индексированными представлениями. Если подсказки INDEX, PAGLOCK, ROWLOCK, TABLOCKX, UPDLOCK или XLOCK применимы к таблицам, на которые ссылается запрос после расширения представления, то запрос не подходит для сопоставления с индексированным представлением.
Если подсказка в виде INDEX ( index_val [ ,...n] ) ссылается на представление в запросе и вы также не указываете подсказку NOEXPAND, то подсказка индекса игнорируется. Для указания конкретного индекса используйте NOEXPAND.
Обычно, когда оптимизатор запросов сопоставляет индексированное представление с запросом, он применяет любые подсказки, указанные в таблицах или представлениях запроса, непосредственно к индексированному представлению. Если оптимизатор запросов решает не использовать индексированное представление, он передает любые подсказки непосредственно таблицам, используемым в представлении. Для получения дополнительной информации см. раздел «Разрешение экрана». Это распространение не применяется к указаниям на присоединение. Они применяются только в той исходной позиции запроса, где они указаны. Оптимизатор запросов не учитывает подсказки join при сопоставлении запросов с индексированными представлениями. Если план запроса использует индексированное представление, совпадающее с частью запроса, содержащего подсказку соединения, то подсказка соединения не используется в плане.
В определениях индексированных представлений указания не допускаются. ядро СУБД игнорирует подсказки внутри определений индексированных представлений при их поддержании или при выполнении запросов с индексированными представлениями.
Дополнительные сведения см. в разделе Подсказки таблиц.
Разрешение распределенных секционированных представлений
Процессор запросов ядро СУБД оптимизирует производительность распределённых секционированных представлений. Наиболее важным аспектом производительности распределённого секционированного представления является минимизация объёма данных, передаваемых между серверами-членами.
ядро СУБД создаёт интеллектуальные динамические планы, которые эффективно используют распределённые запросы для доступа к данным из удалённых таблиц узлов:
- Обработчик запросов сначала использует OLE DB для получения определений ограничений CHECK для каждой таблицы-элемента. Этот метод позволяет процессору запросов отображать распределение значений ключей между таблицами-участниками.
- Процессор запросов сравнивает диапазоны ключей, указанные в предложении
WHEREоператора T-SQL, с картой, которая показывает, как строки распределены в таблицах участников. Затем процессор запросов строит план выполнения запроса, который использует распределённые запросы для получения только тех удалённых строк, необходимых для выполнения оператора T-SQL. План выполнения также построен таким образом, что любой доступ к удалённым таблицам участников, будь то для данных или метаданных, откладывается до тех пор, пока информация не потребуется.
Например, рассмотрим систему, в Customers которой таблица секционируется по серверу1 (от 1 до 3299999), Server2 (CustomerIDот 3300000 до 6599999) и Server3 (CustomerIDCustomerIDот 6600000 до 9999999).
Допустим, план выполнения, созданный для этого запроса, выполняется на сервере Server1:
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID BETWEEN 3200000 AND 3400000;
План выполнения этого запроса извлекает строки со значениями ключей CustomerID от 3200000 до 3299999 из локальной таблицы-элемента и вызывает распределенный запрос для получения строк со значениями ключей от 3300000 до 3400000 с сервера Server2.
Обработчик запросов компонента ядро СУБД также может встраивать динамическую логику в планы выполнения запросов для операторов T-SQL, для которых ключевые значения неизвестны на момент построения плана. Рассмотрим следующую хранимую процедуру:
CREATE PROCEDURE GetCustomer
(
    @CustomerIDParameter INT
)
AS
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID = @CustomerIDParameter;
ядро СУБД не может предсказать, какое значение ключа передаётся параметром @CustomerIDParameter каждый раз при выполнении процедуры. Поскольку значение ключа нельзя предсказать, процессор запросов также не может предсказать, к какой таблице-члену ему нужно обратиться. Для решения этого случая ядро СУБД строит план выполнения с условной логикой, называемой динамическими фильтрами, чтобы контролировать, к какой таблице-члену обращаться на основе значения входного параметра. При условии, что хранимая GetCustomer процедура была выполнена на Server1, логика плана выполнения может быть представлена так, как показано в следующем выводе:
IF @CustomerIDParameter BETWEEN 1 and 3299999
   Retrieve row from local table CustomerData.dbo.Customer_33
ELSE IF @CustomerIDParameter BETWEEN 3300000 and 6599999
   Retrieve row from linked table Server2.CustomerData.dbo.Customer_66
ELSE IF @CustomerIDParameter BETWEEN 6600000 and 9999999
   Retrieve row from linked table Server3.CustomerData.dbo.Customer_99
ядро СУБД иногда строит такие динамические планы выполнения даже для запросов, которые не параметризированы. Оптимизатор запросов может параметризировать запрос, чтобы план выполнения можно было повторно использовать. Если Query Optimizer параметризирует запрос, ссылающийся на секционированное представление, Query Optimizer больше не может считать, что необходимые строки взяты из заданной базовой таблицы. Затем необходимо использовать динамические фильтры в плане выполнения.
Хранимая процедура и выполнение триггера
ядро СУБД хранит только исходный текст хранимых процедур и триггеров. При выполнении хранимой процедуры или триггера в первый раз исходный код компилируется в план выполнения. Если очередной вызов хранимой процедуры или триггера будет инициирован до устаревания плана выполнения, реляционный механизм обнаружит существующий план и использует его повторно. Если план вытесняется из памяти, строится новый план. Этот процесс похож на процесс, который ядро СУБД применяет для всех операторов T-SQL. Главное преимущество в производительности хранимых процедур и триггеров в ядро СУБД по сравнению с партиями динамического T-SQL заключается в том, что их операторы T-SQL всегда одинаковы. Благодаря этому реляционный механизм может с легкостью сопоставлять их с любыми существующими планами выполнения. Это облегчает повторное использование планов хранимых процедур и триггеров.
Планы выполнения хранимых процедур и триггеров обрабатываются отдельно от плана выполнения пакета, вызвавшего хранимую процедуру или приведшего к срабатыванию триггера. Такое разделение обеспечивает более широкое повторное использование планов выполнения хранимых процедур и триггеров.
Кэширование и повторное использование плана выполнения
ядро СУБД использует память для хранения как планов исполнения, так и буферов данных. Процент памяти, выделенной для планов выполнения или буферов данных, динамически корректируется в зависимости от состояния системы. Часть памяти, которая хранит планы выполнения, называется кэшом планов.
Хранилища планов
В кэше планов есть два хранилища для всех скомпилированных планов:
- Хранилище кэша планов объектов (OBJCP) для планов, связанных с постоянно хранимыми объектами, такими как хранимые процедуры, функции и триггеры.
- Хранилище кеша SQL Plans (SQLCP) для планов, связанных с автопараметризованными, динамическими или подготовленными запросами.
Следующий запрос предоставляет информацию об использовании памяти для этих двух хранилищ кэша:
SELECT *
FROM sys.dm_os_memory_clerks
WHERE name LIKE '%plans%';
В кэше планов есть два дополнительных хранилища, которые не хранят планы:
- Кэш-хранилище Bound Trees (PHDR) — для структур данных, используемых при компиляции планов для представлений, ограничений и значений по умолчанию. Эти структуры известны как bound trees или алгебризерные деревья.
- Расширенное хранилище кэша расширенных хранимых процедур (XPROC) для предопределённых системных процедур, таких как sp_executesql или xp_cmdshell. Эти хранящиеся процедуры используют DLL вместо T-SQL операторов. Кэшированная структура содержит только имя функции и имя DLL, где реализована процедура.
Компоненты плана исполнения
Планы выполнения ядро СУБД включают следующие основные компоненты:
Скомпилированный план (или план запроса)
План запроса, создаваемый в результате компиляции, является, как правило, реентерабельной структурой данных только для чтения, которую могут использовать любое число пользователей. В нем хранятся следующие сведения:
Физические операторы, реализующие операцию, описанную логическими операторами.
порядок этих операторов, определяющий очередность доступа к данным, их фильтрации и агрегирования;
предполагаемое количество строк, передаваемых через операторы.
Примечание.
План запроса также хранит информацию о статистических объектах, используемых для оценки кратности.
Какие объекты поддержки необходимо создать, например рабочие таблицы или рабочие файлы.
tempdb
План запроса не хранит пользовательский контекст или информацию о среде выполнения. ядро СУБД определяет количество рабочих потоков каждый раз, когда получает план из кэша планов. Кэшированный параллельный план также может выполняться в последовательном режиме.
Контекст выполнения
Каждый пользователь, который в данный момент выполняет запрос, имеет структуру данных, содержащую данные, специфичные для его выполнения, например, значения параметров. Эта структура данных называется контекстом выполнения. Структуры данных контекста выполнения используются повторно, но их содержимое не используется повторно. Если другой пользователь выполняет тот же запрос, структуры данных инициализируются повторно контекстом нового пользователя.
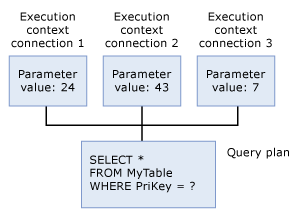
Планы повторного использования для одинаковых операторов
Когда ядро СУБД выполняет любой оператор T-SQL, он сначала просматривает кэш плана, чтобы убедиться, что существует существующий план выполнения того же оператора T-SQL. Оператор T-SQL считается идентичным существующему, если он буквально совпадает с ранее выполненным оператором T-SQL с кэшированным планом, символ за символом. ядро СУБД повторно использует любой найденный план, экономя расходы на перекомпиляцию оператора T-SQL. Если плана выполнения нет, ядро СУБД генерирует новый план выполнения запроса.
Примечание.
Кэш планов не сохраняет планы выполнения некоторых операторов T-SQL, таких как операторы массовых операций, выполняющиеся в хранилище строк, или операторы, содержащие крупные строковые литералы. Эти планы существуют только во время выполнения запроса.
ядро СУБД использует эффективный алгоритм для поиска существующих планов выполнения для любой конкретной инструкции T-SQL. В большинстве систем минимальные ресурсы, которые используются для этого сканирования, меньше, чем ресурсы, которые экономятся при повторном использовании существующих планов вместо компиляции каждого оператора T-SQL.
Алгоритмы, сопоставляющие новые операторы T-SQL с существующими, неиспользуемыми планами выполнения в кэше планов, требуют, чтобы все ссылки на объекты были полностью квалифицированы. Например, предположим, что Person — схема по умолчанию для пользователя, выполняющего следующие SELECT операторы. Хотя в этом примере не требуется, чтобы для выполнения указывать полное имя таблицы Person, это означает, что второе утверждение не совпадает с существующим планом, но третье утверждение совпадает:
USE AdventureWorks2025;
GO

SELECT *
FROM Person;
GO

SELECT *
FROM Person.Person;
GO

SELECT *
FROM Person.Person;
GO
Изменение любой из следующих SET опций для конкретного выполнения влияет на возможность повторного использования планов, поскольку ядро СУБД выполняет константную свертку, и эти параметры влияют на результаты таких выражений:
ANSI_DEFAULTSANSI_NULL_DFLT_OFFANSI_NULL_DFLT_ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLDATEFIRSTDATEFORMATFORCEPLANLANGUAGENO_BROWSETABLENUMERIC_ROUNDABORTQUOTED_IDENTIFIER
Кэширование нескольких планов для одного запроса
Запросы и планы выполнения однозначно идентифицируются в базе данных, аналогично отпечаткам пальцев.
- Хэш-значение плана запроса — это двоичное хэш-значение, вычисленное для плана выполнения данного запроса и используемое для уникальной идентификации планов выполнения со сходной логикой.
- Хэш запроса — это бинарное хеш-значение, вычисляемое на T-SQL тексте запроса, и используется для уникальной идентификации запросов.
Вы можете получить скомпилированный план из кэша планов, используя дескриптор плана. Этот временный идентификатор остаётся постоянным только пока план находится в кэше. Дескриптор плана — это хэш-значение, которое выводится из скомпилированного плана целого пакета. Дескриптор плана для скомпилированного плана остаётся прежним, даже если одна или несколько инструкций в пакете будут перекомпилированы.
Примечание.
Если вы скомпилируете план для пакета вместо одного оператора, можно использовать дескриптор плана и смещения операторов, чтобы получить план для отдельных операторов в пакете.
sys.dm_exec_requests DMV содержит столбцы statement_start_offset и statement_end_offset для каждой записи. Эти столбцы относятся к текущей выполняемой инструкции текущего выполняемого пакета или сохраненного объекта. Дополнительные сведения см. в sys.dm_exec_requests.
sys.dm_exec_query_stats DMV также содержит эти столбцы для каждой записи. Эти столбцы указывают на положение инструкции внутри пакетного или сохраненного объекта. Дополнительные сведения см. в sys.dm_exec_query_stats.
Фактический T-SQL текст пакета хранится в отдельном пространстве памяти от кэша плана, называемом кэшем SQL Manager (SQLMGR). Вы можете получить текст T-SQL для скомпилированного плана из кэша SQL Manager, используя дескриптор SQL. Этот временный идентификатор остаётся постоянным только пока в кэше планов остаётся как минимум один план, который на него ссылается. SQL-хэндл — это хеш-значение, полученное из всего текста пакета, и гарантированно уникально для каждого пакета.
Примечание.
Как и скомпилированный план, текст T-SQL хранится для каждого пакета, включая комментарии. Дескриптор SQL содержит MD5-хэш всего текста пакета и гарантированно уникален для каждого пакета.
Следующий запрос предоставляет информацию об использовании памяти для кэша SQL Manager:
SELECT *
FROM sys.dm_os_memory_objects
WHERE type = 'MEMOBJ_SQLMGR';
Между SQL-хэндлом и хэндлами плана существует связь один ко многим. Это условие возникает, когда ключ кэша для скомпилированных планов отличается. Эта разница может возникать из-за изменения SET опций между двумя выполнениями одной партии.
Рассмотрим следующую хранимую процедуру:
USE WideWorldImporters;
GO

CREATE PROCEDURE usp_SalesByCustomer
(
    @CID INT
)
AS
SELECT *
FROM Sales.Customers
WHERE CustomerID = @CID;
GO

SET ANSI_DEFAULTS ON;
GO

EXECUTE usp_SalesByCustomer 10;
GO
Проверьте, что можно найти в кэше планов, используя следующий запрос:
SELECT cp.memory_object_address,
       cp.objtype,
       refcounts,
       usecounts,
       qs.query_plan_hash,
       qs.query_hash,
       qs.plan_handle,
       qs.sql_handle
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle)
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle)
     INNER JOIN sys.dm_exec_query_stats AS qs
         ON qs.plan_handle = cp.plan_handle
WHERE text LIKE '%usp_SalesByCustomer%';
GO
Вот результаты.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Теперь выполните сохранённую процедуру с другим параметром, без изменений контекста выполнения:
EXECUTE usp_SalesByCustomer 8;
GO
Ещё раз проверьте, что можно найти в кэше плана. Вот результаты.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Обратите внимание, что значение usecounts увеличивается до 2, что означает, что тот же кэшированный план повторно используется без изменений, поскольку структуры данных контекста выполнения также используются повторно. Теперь измените SET ANSI_DEFAULTS опцию и выполните хранимую процедуру, используя тот же параметр.
SET ANSI_DEFAULTS OFF;
GO

EXECUTE usp_SalesByCustomer 8;
GO
Ещё раз проверьте, что можно найти в кэше плана. Вот результаты.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CD01DEC060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02B031F111CD01000001000000000000000000000000000000000000000000000000000000
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Обратите внимание, что в выходных данных динамического административного представления sys.dm_exec_cached_plans теперь есть две записи.
- Столбец
usecountsпоказывает значение1в первой записи. Это значение означает план, выполненный один раз сSET ANSI_DEFAULTS OFF. - Столбец
usecountsпоказывает значение2во второй записи. Это значение обозначает план, выполненный с использованиемSET ANSI_DEFAULTS ON, поскольку он был выполнен дважды. - Разные значения
memory_object_addressуказывают на разные записи планов выполнения в кэше планов. Однако значениеsql_handleодинаково для обеих записей, так как они ссылаются на один и тот же пакет.- Выполнение с
ANSI_DEFAULTS, установленным вOFF, имеет новыйplan_handle, и он доступен для повторного использования для вызовов с тем же набором опцийSET. Новый дескриптор плана необходим, так как контекст выполнения был инициализирован повторно из-за изменения параметровSET. Но это изменение не приводит к повторной компиляции: обе записи ссылаются на один и тот же план и запрос, что подтверждается одинаковымиquery_plan_hashзначениями иquery_hashзначениями.
- Выполнение с
В этой ситуации у вас есть две записи плана в кэше, соответствующие одному пакету. Это подчёркивает важность того, чтобы опции, влияющие на кэш планов SET, были одинаковыми при повторном выполнении одних и тех же запросов. Такой подход оптимизирует повторное использование плана и сдерживает размер кэша плана на минимальном уровне.
Совет
Распространенная ошибка заключается в том, что разные клиенты могут иметь разные значения по умолчанию для SET параметров. Например, соединение, установленное через SQL Server Management Studio, автоматически устанавливает QUOTED_IDENTIFIER в ON, а SQLCMD устанавливает QUOTED_IDENTIFIER в OFF. Выполнение одних и тех же запросов в этих двух клиентах приводит к нескольким планам (как описано в предыдущем примере).
Удаление планов выполнения из кэша планов
Планы исполнения остаются в кэше планов, пока достаточно памяти для их хранения. Когда существует давление на память, SQL Server Database Engine использует подход, основанный на затратах, чтобы определить, какие планы исполнения удалить из кэша плана. Для принятия решения, основанного на затратах, компонент Database Engine SQL Server увеличивает и уменьшает текущую переменную стоимости для каждого плана выполнения на основе следующих факторов.
Когда пользовательский процесс вставляет план выполнения в кэш, он устанавливает текущую стоимость, равную первоначальной стоимости компиляции запроса. Для планов выполнения ad hoc пользовательский процесс устанавливает текущую стоимость равной нулю. После этого каждый раз, когда пользовательский процесс обращается к плану выполнения, текущая стоимость сбрасывается до исходной стоимости компиляции. Для ad hoc планов выполнения пользовательский процесс увеличивает текущую стоимость. Для всех планов максимальное значение текущей стоимости равно исходной стоимости компиляции.
При нехватке памяти компонент Database Engine SQL Server удаляет планы выполнения из кэша планов. Чтобы определить, какие планы следует удалить, SQL Server ядро СУБД неоднократно проверяет состояние каждого плана выполнения и удаляет планы, когда их текущая стоимость равна нулю. План исполнения с нулевой текущей стоимостью не удаляется автоматически при наличии давления памяти. Он удаляется только тогда, когда SQL Server Database Engine проверяет план, и текущая стоимость равна нулю. При проверке плана выполнения ядро базы данных SQL Server снижает стоимость до нуля, если запрос в настоящее время не использует план.
SQL Server Database Engine продолжает анализировать планы выполнения, пока не уберёт достаточно планов для удовлетворения требований к памяти. При наблюдении давления на память, стоимость плана выполнения может увеличиваться и уменьшаться неоднократно. Когда нехватка памяти больше не наблюдается, SQL Server Database Engine перестаёт снижать текущую стоимость неиспользуемых планов выполнения. Все планы исполнения остаются в кэше планов, даже если их стоимость равна нулю.
Sql Server ядро СУБД использует монитор ресурсов и рабочие потоки пользователей для освобождения памяти от кэша планов в ответ на давление памяти. Потоки мониторинга ресурсов и пользовательского рабочего процесса могут одновременно анализировать планы, чтобы снизить текущие затраты для каждого неиспользуемого плана выполнения. Монитор ресурсов удаляет планы выполнения из кэша планов при глобальной нехватке памяти. Он освобождает память для принудительного выполнения политик для системной памяти, памяти процессов, памяти пула ресурсов и максимального размера всех кэшей.
Максимальный размер всех кэшей — это функция размера буферного пула и не может превышать максимальный объем памяти сервера. Для получения дополнительной информации о настройке максимальной памяти сервера смотрите параметр max server memory в sp_configure.
Пользовательские рабочие потоки удаляют планы выполнения из кэша планов при нехватке памяти в одиночном кэше. Они обеспечивают выполнение политик для максимального размера кэша и максимума записей одиночного кэша.
В следующих примерах показано, какие планы выполнения удаляются из кэша планов.
- План выполнения часто используется, поэтому его стоимость никогда не принимает значение ноль. План остаётся в кэше планов и не удаляется, если только не возникает нехватка памяти и текущая стоимость равна нулю.
- Специальный план выполнения вставляется и не упоминается снова до появления давления на память. Поскольку ad hoc планы инициализируются с текущей стоимостью нуля, когда SQL Server Database Engine анализирует план выполнения, он видит нулевую текущую стоимость и удаляет план из кэша плана. Ad hoc план выполнения остаётся в кэше плана с нулевой текущей стоимостью, когда нехватка памяти отсутствует.
Чтобы вручную удалить отдельный план выполнения или все планы выполнения из кеша, используйте команду DBCC FREEPROCCACHE. Вы также можете использовать DBCC FREESYSTEMCACHE для очистки любого кэша, включая кэш плана. В SQL Server 2016 (13.x) и более поздних версиях используйте ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE для очистки кэша процедур (плана) для текущей базы данных.
Изменение некоторых настроек конфигурации через sp_configure и reconfigure также приводит к удалению планов из кэша планов. Список этих параметров конфигурации можно найти в разделе "Примечания" статьи DBCC FREEPROCCACHE. При внесении этого изменения конфигурации в журнал ошибок записывается следующее информационное сообщение:
SQL Server has encountered %d occurrence(s) of cachestore flush for the '%s' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
Переустановка планов выполнения
Определённые изменения в базе данных могут сделать план выполнения неэффективным или недействительным. ядро СУБД обнаруживает эти изменения и отмечает план как недействительный. Для следующего подключения, при котором выполняется данный запрос, необходимо перекомпилировать план. Условия, которые делают план недействительным, включают:
- Изменения в таблице или представлении, на которые ссылается запрос (
ALTER TABLEиALTER VIEW). - Изменения в одной процедуре, которые приведут к удалению всех планов этой процедуры из кэша (
ALTER PROCEDURE). - Изменения индексов, используемых планом выполнения.
- Обновления статистики, используемой планом исполнения, независимо от того, явно ли они сгенерированы таким оператором, как
UPDATE STATISTICS, или автоматически. - Удаление индекса, используемого в плане выполнения.
- Явный вызов
sp_recompile. - Частое изменение ключей (инструкциями
INSERTилиDELETEот пользователей, изменяющих таблицу, на которую ссылается запрос). - Если в таблицах inserted или deleted происходит значительный рост числа строк, это особенно важно для таблиц с триггерами.
- Выполнение сохранённой процедуры с помощью параметра
WITH RECOMPILE.
Большинство перекомпиляций требуются либо для корректности операторов, либо для получения потенциально более быстрых планов выполнения запросов.
Когда оператор внутри пакета запускает перекомпиляцию, перекомпилируется только этот оператор, а не весь пакет. Это правило применимо, независимо от того, отправляется ли пакет через сохранённую процедуру, триггер, специальный пакет или подготовленное выражение.
Рекомпиляция на уровне операторов повышает производительность, поскольку в большинстве случаев небольшое количество операторов вызывает перекомпиляцию и связанные с ней издержки с точки зрения времени работы процессора и блокировок. Таким образом, эти штрафы избегаются для других инструкций пакета, которые не требуют перекомпиляции.
Расширенное sql_statement_recompile событие (XEvent) сообщает о перекомпилации уровня инструкций. Это XEvent возникает, когда рекомпиляция на уровне инструкций требуется любым пакетом. Это требование включает хранимые процедуры, триггеры, ad hoc пакеты и запросы. Пакеты могут отправляться через несколько интерфейсов, включая sp_executesql, динамический SQL, методы Prepare или методы Execute.
Столбец recompile_causesql_statement_recompile XEvent содержит целый код, указывающий причину повторной компиляции. Следующий список содержит возможные причины:
- Изменение параметров курсора
- Отложенная компиляция
- Разрешение изменено
FOR BROWSE -
OPTION (RECOMPILE)запрошено - Очистка параметризованного плана
- Изменение секционированного представления
- Изменение плана из-за изменения версии базы данных.
- Изменение среды уведомлений о запросах
- Отсутствие плана для хранилища запросов
- Сбой форсирования плана для хранилища запросов
- Изменение политики форсирования плана для хранилища запросов
- Изменение удаленного набора строк
- Изменение схемы
-
SETИзменен параметр - Изменение статистики
- Временная таблица изменена
Примечание.
Когда вы устанавливаете опцию AUTO_UPDATE_STATISTICS базы данных на ON, запросы перекомпилируются, когда они нацелены на таблицы или индексированные представления, статистика которых обновляется или чья кардинальность значительно меняется с момента последнего выполнения. Это поведение распространяется на стандартные пользовательские определяемые таблицы, временные таблицы, а также таблицы inserted и deleted, создаваемые триггерами DML.
Установка для AUTO_UPDATE_STATISTICS значения OFF прекращает эти перекомпиляции, но устаревшая статистика обычно ухудшает производительность запросов больше, чем перекомпиляции. Для получения дополнительной информации см. опцию AUTO_UPDATE_STATISTICS. Вставленные и удалённые таблицы триггеров DML INSTEAD OF создаются в tempdb, поэтому они используют настройку AUTO_UPDATE_STATISTICStempdb.
Используйте явные параметры для повторного использования плана
Использование параметров, включая именованные параметры в приложениях ADO.NET и маркеров параметров в OLE DB и ODBC, может увеличить повторное использование планов выполнения.
Предупреждение
Всегда проверяйте все данные, вводимые пользователем, выполняя проверку типа, длины, формата и диапазона данных. Дополнительные сведения см. в статье о внедрении SQL.
Единственная разница между следующими двумя инструкциями SELECT — в значениях, сравниваемых в предложении WHERE :
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Единственная разница между планами выполнения для этих запросов — в значении, хранимом для сравнения со столбцом ProductSubcategoryID . Цель в том, чтобы ядро СУБД всегда распознавал, что инструкции генерируют по сути один и тот же план, и повторно использовал планы, однако ядро СУБД иногда не обнаруживает такого сходства в сложных T-SQL инструкциях.
Разделение констант от оператора T-SQL с помощью параметров помогает реляционному движку распознавать дублирующиеся планы. Используйте параметры следующим образом:
В T-SQL используйте
sp_executesql:DECLARE @MyIntParm AS INT; SET @MyIntParm = 1; EXECUTE sp_executesql N'SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = @Parm', N'@Parm INT', @MyIntParm;Этот метод рекомендуется для скриптов T-SQL, хранимых процедур или триггеров, которые динамически генерируют SQL-операторы.
ADO.NET с
SqlClientиспользует именованные параметры, такие как@Parm. OLE DB и ODBC используют маркеры параметров. Параметрические маркеры — это вопросительные знаки (?), которые заменяют константу в SQL-операторе и связаны с программной переменной. Например, в приложении ODBC можно сделать следующее:Используется
SQLBindParameterдля привязки целочисленной переменной к первому маркеру параметра в инструкции SQL.поместить целочисленное значение в переменную;
Выполните инструкцию, указав маркер параметра (
?):SQLExecDirect(hstmt, "SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = ?", SQL_NTS);
Поставщик SQL Server Native Client OLE DB и драйвер SQL Server Native Client ODBC используют
sp_executesqlдля отправки операторов в SQL Server, когда в приложениях используются маркеры параметров.Пишите хранимые процедуры, в которых параметры предусмотрены изначально.
Если вы явно не внедряете параметры в дизайн приложений, вы также можете положиться на Query Optimizer, который автоматически параметризирует определённые запросы, используя стандартное поведение простой параметризации. В качестве альтернативы можно настроить принудительный учет параметризации всех запросов к базе данных в оптимизаторе запросов, установив для параметра PARAMETERIZATION инструкции ALTER DATABASE значение FORCED.
Простая параметризация
В ядро СУБД использование параметров или маркеров параметров в операторах T-SQL увеличивает способность реляционного движка сопоставлять новые операторы T-SQL с уже скомпилированными планами выполнения.
Предупреждение
Всегда проверяйте все данные, вводимые пользователем, выполняя проверку типа, длины, формата и диапазона данных. Дополнительные сведения см. в статье о внедрении SQL.
Если оператор T-SQL выполняется без параметров, ядро СУБД параметризирует этот оператор внутри, чтобы повысить вероятность сопоставления с существующим планом выполнения. Этот процесс называется параметризацией. По умолчанию параметризация простая, и вы можете включить принудительную параметризацию для базы данных.
Рассмотрим следующее утверждение.
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
Вы можете указать значение 1 в конце инструкции как параметр. Реляционный движок строит план выполнения этой партии так, будто вы указали параметр вместо значения 1. Благодаря этой простой параметризации ядро СУБД распознаёт, что следующие два оператора генерируют по сути одинаковый план выполнения и повторно использует первый план для второго оператора:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
При обработке сложных операторов T-SQL реляционный движок может испытывать трудности с определением того, какие выражения можно параметризировать. Чтобы повысить способность реляционного движка сопоставлять сложные T-SQL операторы с существующими, неиспользуемыми планами выполнения, явно указывайте параметры с помощью либо sp_executesql, либо маркеров параметров.
Примечание.
Когда вы используете арифметические операторы +, -, *, / или % для выполнения неявного или явного преобразования констант int, smallint, tinyint или bigint в типы данных float, real, decimal или numeric, ядро СУБД применяет специальные правила для вычисления типа и точности результатов выражения. Эти правила различаются в зависимости от того, параметризован ли запрос. Таким образом, одинаковые выражения в запросах могут в некоторых случаях давать отличающиеся результаты.
При стандартном поведении простой параметризации ядро СУБД параметризирует относительно небольшой класс запросов. Однако можно указать, чтобы все запросы в базе данных были параметризованы в соответствии с определенными ограничениями, настроив параметр PARAMETERIZATION команды ALTER DATABASE на FORCED. Это изменение может повысить производительность баз данных, которые сталкиваются с большим объёмом одновременных запросов, снижая частоту компиляции запросов.
Иначе можно указать параметризацию одного запроса и других, синтаксически равных, но отличающихся значениями параметра, запросов.
Совет
Когда вы используете объектно-реляционное отображение (ORM), такое как Entity Framework (EF), запросы приложений, например ручные LINQ запросы или некоторые сырые SQL-запросы, могут не быть параметризованы. Это ограничение влияет на повторное использование плана и возможность отслеживать запросы в хранилище запросов. Дополнительные сведения см. в статьях Кэширование и параметризация запросов EF и Необработанные запросы SQL EF.
Принудительная параметризация
Вы можете переопределить стандартное поведение простой параметризации ядро СУБД, указав, что все SELECT, INSERT, UPDATE и DELETE операторы в базе данных параметризируются с определёнными ограничениями. Включите принудительную параметризацию, установив для параметра PARAMETERIZATION значение ALTER DATABASE в операторе FORCED. Принудительное параметризация может повысить производительность определенных баз данных, уменьшая частоту компиляций запросов и перекомпиляций. Базы данных, которые могут воспользоваться принудительной параметризацией, обычно являются теми, которые испытывают большие объемы параллельных запросов из источников, таких как приложения точки продажи.
Когда вы устанавливаете для параметра PARAMETERIZATION значение FORCED, любое литеральное значение, появляющееся в операторе SELECT, INSERT, UPDATE или DELETE, заданном в любой форме, преобразуется в параметр при компиляции запроса. Исключениями являются литералы, представленные в следующих конструкциях запроса.
- Инструкции
INSERT...EXECUTE. - Инструкции в теле хранимых процедур, триггеров или определяемых пользователем функций. ядро СУБД уже повторно использует планы запросов для этих процедур.
- Подготовленные выражения, уже параметризированные в клиентском приложении.
- Инструкции, содержащие вызовы метода XQuery, где метод представлен в контексте, в котором его аргументы обычно параметризуются, например в предложении
WHERE. Если метод отображается в контексте, где его аргументы не будут параметризованы, остальная часть инструкции параметризуется. - Операторы внутри курсора T-SQL. (Инструкции
SELECTвнутри курсоров API-интерфейса параметризуются.) - Устаревшие конструкции запроса.
- Любое утверждение, выполненное в контексте
ANSI_PADDINGилиANSI_NULLS, если для них установлено значениеOFF. - Инструкции, содержащие более 2 097 литералов, пригодных для параметризации.
- Инструкции, ссылающиеся на переменные, такие как
WHERE T.col2 >= @bb. - Утверждения, содержащие подсказку запроса
RECOMPILE. - Утверждения, содержащие пункт
COMPUTE. - Утверждения, содержащие пункт
WHERE CURRENT OF.
Следующие условия запроса не параметризованы. В таких случаях только предложения не параметризируются. Другие предложения в том же запросе могут быть допустимыми для принудительной параметризации.
- Часть любого оператора
<select_list>SELECT. Этот список включаетSELECTсписки подзапросов иSELECTсписки внутри операторовINSERT. - Инструкции
SELECTво вложенных запросах, представленные внутри инструкцииIF. - Предложения запроса
TOP,TABLESAMPLE,HAVING,GROUP BY,ORDER BY,OUTPUT...INTOилиFOR XML. - Аргументы, прямые или в качестве подвыражений, для
OPENROWSET,OPENQUERY,OPENDATASOURCE,OPENXMLили для любого оператораFULLTEXT. - Аргументы pattern и escape_character в предложении
LIKE. - Аргумент стиля в конструкции
CONVERT. - Целочисленные константы внутри предложения
IDENTITY. - Константы, указанные использованием синтаксиса расширения ODBC.
- Свертываемые константные выражения, являющиеся аргументами операторов
+,-,*,/и%. При рассмотрении допустимости принудительной параметризации ядро СУБД рассматривает выражение как допускающее константную свертку, когда выполняется одно из следующих условий:- В выражении не представлены столбцы, переменные или вложенные запросы.
- Выражение содержит предложение
CASE.
- Аргументы к запросным подсказкам, включая аргумент number_of_rows подсказки
FASTзапроса, аргумент number_of_processors подсказкиMAXDOPзапроса и аргумент number подсказкиMAXRECURSIONзапроса.
Параметризация происходит на уровне отдельных операторов T-SQL. Иными словами, параметризуются отдельные инструкции в пакете. После компиляции параметризованный запрос выполняется в контексте того пакета, в котором он был изначально отправлен. Если план выполнения запроса кэширован, можно определить, был ли запрос параметризован, ссылаясь на столбец sql динамического административного представления sys.syscacheobjects. Если запрос параметризирован, имена и типы параметров данных идут перед текстом отправленной партии в этом столбце, (@1 TINYINT)например .
Примечание.
Имена параметров произвольны. Пользователи или приложения не должны полагаться на определённый порядок имен. Кроме того, следующие элементы могут меняться между версиями SQL Server и обновлениями cumulative update (CU): имена параметров, выбор параметризованных литералов и интервалы в параметризованном тексте.
Типы данных параметров
Когда ядро СУБД параметризирует литералы, параметры преобразуются в следующие типы данных:
- Целочисленные литералы, размер которых в противном случае вписывался бы в тип данных int, параметризуются как int. Крупные целочисленные литералы, являющиеся частями предикатов, включающих любой оператор сравнения (включая
<,>,=,!=,>=,<=,!<,ALL,<>,!>,SOME,BETWEEN,ANYиIN), параметризуются как numeric(38,0). Крупные литералы, не являющиеся частью предикатов, включающих операторы сравнения, параметризуются в тип numeric, чья точность достаточно высока, чтобы поддерживать их размер, а масштаб равен 0. - Числовые литералы с фиксированной точкой, являющиеся частями предикатов, включающих операторы сравнения, получают тип numeric с точностью 38 и масштабом, который достаточно велик, чтобы поддерживать их размер. Числовые литералы с фиксированной точкой, не являющиеся частью предикатов, включающих операторы сравнения, параметризуются как numeric, точность и разрядность которых достаточно велики, чтобы поддерживать их размер.
- Числовые литералы с плавающей запятой приводятся к типу float(53).
- Литералы строк, не относящиеся к Unicode, параметризируются в varchar(8000), если литерал помещается в пределах 8 000 символов, и varchar(max), если он больше 8 000 символов.
- Литералы строк Unicode параметризируются в nvarchar(4000), если литерал помещается в 4 000 символов Unicode, и в nvarchar(max), если литерал больше 4 000 символов.
- Бинарные литералы параметризуются в varbinary(8000), если литерал помещается в пределах 8 000 байт. Если он больше 8 000 байт, он преобразуется в varbinary(max).
- Денежные литералы параметризуются как money.
Рекомендации по использованию принудительной параметризации
Учитывайте следующие моменты при установке для параметра PARAMETERIZATION значения FORCED:
- Принудительная параметризация превращает литеральные константы в запросе в параметры при компиляции запроса. Поэтому оптимизатор запросов может выбирать неоптимальные планы для запросов. В частности, уменьшается вероятность того, что оптимизатор запросов сопоставит запрос с индексированным представлением или индексом по вычисляемому столбцу. Он также может выбрать неоптимальные планы для запросов, создаваемых в секционированных таблицах и распределенных секционированных представлениях. Не используйте принудительную параметризацию для сред, сильно зависящих от индексированных представлений и индексов по вычисляемым столбцам. В целом, только опытные специалисты по базам данных должны использовать эту опцию
PARAMETERIZATION FORCED, убедившись, что она не влияет на производительность. - Распределенные запросы, ссылающиеся на более чем одну базу данных, пригодны для принудительной параметризации, если для параметра
PARAMETERIZATIONзадано значениеFORCEDв базе данных, в контексте которой выполняется запрос. - Установка параметра
PARAMETERIZATIONв значениеFORCEDочищает все планы запросов из кэша планов базы данных, кроме тех, которые в данный момент компилируются, перекомпилируются или выполняются. Планы запросов, которые компилируются или выполняются во время изменения настройки, параметризируются при следующем выполнении запроса. - Настройка
PARAMETERIZATIONэтой опции — это онлайн-операция, не требующая эксклюзивных блокировок на уровне базы данных. - Текущая настройка параметра
PARAMETERIZATIONсохраняется при повторном присоединении или восстановлении базы данных.
Вы можете переопределить поведение принудительной параметризации, указав, что для отдельного запроса будет предпринята попытка простой параметризации, а также для любых других запросов, которые синтаксически эквивалентны, но отличаются только значениями параметров. Справедливо и обратное: можно потребовать выполнения попытки принудительной параметризации для отдельного набора синтаксически эквивалентных запросов, даже если принудительная параметризация в базе данных отключена. Используйте plan guides для этой цели.
Примечание.
PARAMETERIZATION Если задан FORCED параметр, отчет о сообщениях об ошибках может отличаться от того, когда задан PARAMETERIZATIONSIMPLE параметр: при принудительной параметризации можно получать несколько сообщений об ошибках, где при простой параметризации сообщений об ошибках будет меньше, а также номера строк, в которых происходят ошибки, могут быть указаны неверно.
При включенной принудительной параметризации может также иметь место и простая параметризация. Например, следующий запрос не может быть параметризован в соответствии с правилами принудительной параметризации:
SELECT *
FROM Person.Address
WHERE AddressID = 1 + 2;
Однако он может быть параметризован согласно правилам простой параметризации. В случае неуспешной попытки принудительной параметризации впоследствии производятся попытки использования простой параметризации.
Подготовка инструкций SQL
ядро СУБД поддерживает подготовку операторов T-SQL перед выполнением. Если приложению необходимо выполнить оператор T-SQL несколько раз, оно может использовать API базы данных для:
- Однократная подготовка заявления. Этот этап компилирует оператор T-SQL в план выполнения.
- Выполняйте заранее скомпилированный план выполнения каждый раз, когда требуется выполнить этот оператор. Этот подход предотвращает повторную компиляцию оператора T-SQL при каждом выполнении после первого раза. Подготовка и выполнение инструкций контролируется функциями и методами API. Native Client OLE DB Provider SQL Server и SQL Server Native Client ODBC драйвер поддерживают модель подготовки/выполнения операторов T-SQL. При запросе на подготовку поставщик или драйвер отправляет в SQL Server инструкцию с запросом на подготовку инструкции. ядро СУБД компилирует план выполнения и возвращает дескриптор этого плана провайдеру или драйверу. При запросе на выполнение поставщик или драйвер отправляет на сервер запрос на выполнение плана, связанного с этим дескриптором.
Подготовленные выражения не могут создавать временные объекты в ядро СУБД. Подготовленные инструкции не могут ссылаться на системные хранимые процедуры, которые создают временные объекты, такие как временные таблицы. Эти процедуры следует выполнять напрямую.
Чрезмерное использование модели подготовки/исполнения может снизить производительность. Если оператор выполняется только один раз, прямое выполнение требует всего одного сетевого обмена с сервером. Подготовка и выполнение оператора T-SQL, если он выполняется только один раз, требует дополнительного сетевого перехода туда-обратно: один раз для подготовки оператора и один раз для его выполнения.
Подготовка инструкции эффективнее, если использовать маркеры параметров. Предположим, что приложение случайно запросило сведения о продукте из образца базы данных AdventureWorksLT2025 . Существует два способа, которыми приложение может выполнять эту задачу.
Используя первый подход, приложение может выполнить отдельный запрос для каждого запрошенного продукта:
SELECT *
FROM Production.Product
WHERE ProductID = 63;
Используя второй подход, приложение выполняет следующие операции:
Подготовляет инструкцию, содержащую маркер параметра (
?).SELECT * FROM Production.Product WHERE ProductID = ?;Затем оно связывает переменную программы с этим маркером.
Каждый раз, когда требуются сведения о продукте, приложение присваивает связанной переменной ключевое значение и выполняет инструкцию.
Второй подход более эффективен, если оператор выполняется более трёх раз.
В компоненте ядро СУБД модель prepare/execute не имеет значительного преимущества по производительности перед прямым выполнением из-за того, как компонент ядро СУБД повторно использует планы выполнения. ядро СУБД обладает эффективными алгоритмами для сопоставления текущих операторов T-SQL с планами выполнения, созданными при предыдущих выполнениях того же оператора T-SQL. Если приложение выполняет оператор T-SQL с маркерами параметров несколько раз, ядро СУБД повторно использует план выполнения из первого выполнения для второго и последующих выполнений (если только план не будет вытеснен из кэша планов). Впрочем, у модели подготовки и выполнения есть следующие достоинства:
- Поиск плана выполнения по идентифицирующему дескриптору эффективнее, чем поиск существующих планов выполнения путем сопоставления оператора T-SQL.
- Приложение может контролировать, когда будет создан план выполнения и когда он будет использован повторно.
- Модель подготовки и выполнения можно переносить в другие базы данных, включая более ранние версии SQL Server.
Чувствительность параметров
Чувствительность к параметрам, также известная как анализ параметров, относится к процессу, при котором компонент ядро СУБД анализирует текущие значения параметров во время компиляции или перекомпиляции и передаёт их оптимизатору запросов, чтобы потенциально помочь создать более эффективные планы выполнения запросов.
Значения параметров сканируются во время компиляции или перекомпиляции для следующих типов пакетов:
- Хранимые процедуры
- Запросы, отправленные командой
sp_executesql - Подготовленные запросы
Для получения дополнительной информации об устранении проблем с parameter sniffing см.:
- Изучение и устранение проблем с учетом параметров
- Используйте явные параметры для повторного использования плана
- Оптимизация плана выполнения, чувствительного к параметрам
- Устранение неполадок с запросами, связанными с планом выполнения с учетом параметров, в База данных SQL Azure
- Устранение неполадок запросов, чувствительных к параметрам, с проблемами планов выполнения в Управляемый экземпляр SQL Azure
Когда запрос в ядро СУБД использует подсказкуOPTION (RECOMPILE), оптимизатор запросов превращает параметры и локальные переменные в константы по времени компиляции, которые можно свернуть и свести к литералам. Во время компиляции оптимизатор знает и может использовать текущие значения параметров и локальных переменных непосредственно перед этим оператором. Хинт OPTION (RECOMPILE) позволяет оптимизатору создать более оптимальный план запросов, адаптированный под конкретные значения, и использовать наиболее подходящие индексы во время выполнения. Для параметров этот процесс относится не к значениям, первоначально переданным пакету или хранимой процедуре, но к их значениям во время повторной компиляции. Эти значения могут быть изменены в ходе процедуры до достижения оператора, включающего RECOMPILE. Такое поведение может повысить производительность запросов с очень изменчивыми или неоднородными входными данными ценой компиляции запроса при каждом выполнении. Эта стоимость может быть высокой. Избегайте использования RECOMPILE подсказки, не оценив её влияние на всю рабочую нагрузку.
Локальные переменные и оценки кардинальности
Когда запрос использует локальные переменные, ядро СУБД не может определить их значения во время компиляции, поэтому он оценивает кардинальность с использованием доступной статистики или эвристик. Если статистика существует, обычно используется значение All Density (также известное как средняя плотность) из статистической гистограммы для оценки количества строк, соответствующих предикату. Однако если статистики для столбца отсутствуют, ядро СУБД опирается на эвристические оценки, например, предполагая 10% селективности для предикатов равенства и 30% для неравенств и диапазонов. Эти оценки могут привести к менее точным планам исполнения. Ниже приведен пример запроса, использующего локальную переменную.
DECLARE @ProductId AS INT = 100;

SELECT *
FROM Products
WHERE ProductId = @ProductId;
В этом случае ядро СУБД не использует значение 100 для оптимизации запроса. В нем используется общая оценка.
Параллельная обработка запросов
ядро СУБД предоставляет параллельные запросы для оптимизации выполнения запросов и операций индексирования для компьютеров с несколькими микропроцессорами (CPU). Поскольку ядро СУБД может выполнять операцию запроса или индекса параллельно, используя несколько рабочих потоков операционной системы, операция завершается быстро и эффективно.
Во время оптимизации запросов ядро СУБД ищет запросы или операции с индексом, которые могут выиграть от параллельного выполнения. Для этих запросов ядро СУБД вставляет операторы обмена в план выполнения запроса, чтобы подготовить запрос к параллельному выполнению. Оператор обмена — это оператор в плане выполнения запроса, который обеспечивает управление процессом, перераспределение данных и управление потоком. Оператор обмена включает логические операторы Distribute Streams, Repartition Streams и Gather Streams в качестве подтипов, один или несколько из которых могут появляться в выводе Showplan плана запроса для параллельного запроса.
Внимание
Определённые конструкции мешают ядро СУБД использовать параллелизм на всём плане исполнения или его частях.
Конструкции, которые блокируют параллелизм, включают перечисленные ниже.
| Строить | Описание |
|---|---|
| Скалярные UDF | Для получения дополнительной информации о скалярных пользовательских функциях см. раздел «Создание пользовательских функций». Начиная с SQL Server 2019 (15.x), SQL Server Database Engine может встраивать эти функции и разрешать использование параллелизма при обработке запросов. Для получения дополнительной информации о встраивании скалярных UDF см. раздел «Интеллектуальная обработка запросов в базах данных SQL». |
| Удаленный запрос | Дополнительные сведения о Remote Query см. в разделе Справочник по логическим и физическим операторам showplan. |
| Динамические курсоры | Для получения дополнительной информации о курсорах см. DECLARE CURSOR. |
| Рекурсивные запросы | Для получения дополнительной информации о рекурсии см. Руководство по определению и использованию рекурсивных общих табличных выражений и Рекурсии в T-SQL. |
| Функции с табличным значением с несколькими инструкциями (MSTVF) | Для получения дополнительной информации о MSTVFs см. раздел Create User-defined Functions (ядро СУБД). |
Ключевое слово TOP |
Дополнительные сведения см. в разделе TOP. |
План выполнения запроса может содержать атрибут NonParallelPlanReason в элементе QueryPlan , который описывает, почему параллелизм не использовался. Значения этого атрибута:
| Значение NonParallelPlanReason | Описание |
|---|---|
MaxDOPSetToOne |
Максимальная степень параллелизма установлена на 1. |
EstimatedDOPIsOne |
Расчётная степень параллелизма равна 1. |
NoParallelWithRemoteQuery |
Параллелизм не поддерживается для удаленных запросов. |
NoParallelDynamicCursor |
Параллельные планы не поддерживаются для динамических курсоров. |
NoParallelFastForwardCursor |
Курсоры ускоренной перемотки вперед не поддерживают параллельные планы выполнения. |
NoParallelCursorFetchByBookmark |
Параллельные планы не поддерживаются курсорами, которые извлекают данные по закладкам. |
NoParallelCreateIndexInNonEnterpriseEdition |
Параллельное создание индексов не поддерживается в выпусках, отличных от Enterprise. |
NoParallelPlansInDesktopOrExpressEdition |
Выпуски Desktop и Express не поддерживают параллельные планы. |
NonParallelizableIntrinsicFunction |
Запрос ссылается на встроенную функцию, которая не поддерживает параллелизм. |
CLRUserDefinedFunctionRequiresDataAccess |
Параллелизм не поддерживается для функции CLR, которая требует доступа к данным. |
TSQLUserDefinedFunctionsNotParallelizable |
Запрос ссылается на определяемую пользователем функцию T-SQL, которая не была параллелизируемой. |
TableVariableTransactionsDoNotSupportParallelNestedTransaction |
Транзакции табличных переменных не поддерживают параллельные вложенные транзакции. |
DMLQueryReturnsOutputToClient |
Запрос DML возвращает выходные данные клиенту и не параллелизуется. |
MixedSerialAndParallelOnlineIndexBuildNotSupported |
Неподдерживаемый набор последовательных и параллельных планов для одной сборки индекса в сети. |
CouldNotGenerateValidParallelPlan |
Сбой проверки параллельного плана, возврат к последовательному плану. |
NoParallelForMemoryOptimizedTables |
Таблицы OLTP в памяти, на которые ссылаются, не поддерживают параллелизм. |
NoParallelForDmlOnMemoryOptimizedTable |
DML-операции на таблице In-Memory OLTP не поддерживают параллелизм. |
NoParallelForNativelyCompiledModule |
Нативно скомпилированные модули, на которые имеются ссылки, не поддерживают параллелизм. |
NoRangesResumableCreate |
Ошибка создания диапазона для возобновляемой операции. |
После вставки операторов обмена получается план параллельного выполнения запроса. План параллельного выполнения запроса может использовать несколько рабочих потоков. План последовательного выполнения, который используется для обработки непараллельных (серийных) запросов, использует только один рабочий поток. Фактическое количество рабочих потоков, используемых параллельным запросом, определяется при инициализации выполнения плана запроса и зависит от сложности плана и степени параллелизма.
Степень параллелизма (DOP) определяет максимальное количество процессоров, которые могут использоваться для выполнения параллельной задачи. DOP не указывает общее количество рабочих потоков, используемых запросом. Ограничение DOP задается для каждой задачи. Это не ограничение на один запрос или один запрос к базе данных. Это значит, что во время параллельного выполнения один запрос может порождать несколько задач, назначаемых планировщику. Одновременно может использоваться больше процессоров, чем указано в MAXDOP, в любой момент выполнения запроса, когда разные задачи выполняются одновременно. Дополнительные сведения см. в руководстве по архитектуре потоков и задач.
Оптимизатор запросов не использует план параллельного выполнения запроса, если выполняется любое из следующих условий:
План последовательного выполнения тривиален или не превышает пороговое значение стоимости для параллелизма.
План последовательного выполнения имеет более низкую общую стоимость поддерев, чем любой параллельный план выполнения, исследуемый оптимизатором.
Запрос содержит скалярные или реляционные операторы, которые не могут выполняться параллельно. Определенные операторы могут привести к выполнению участка запроса или всего плана целиком в последовательном режиме.
Примечание.
Общая предполагаемая стоимость поддерев параллельного плана может быть ниже порогового значения затрат для параметра параллелизма. Другими словами, общая оценочная стоимость поддерева серийного плана превышала этот показатель, и был выбран план запроса с более низкой общей оценочной стоимостью поддерева.
Степень параллелизма (DOP)
ядро СУБД автоматически определяет наилучшую степень параллелизма для каждого экземпляра параллельного выполнения запросов или операции языка определения данных (DDL) для индекса. Он определяет это значение на основе следующих критериев:
Работает ли SQL Server на компьютере с несколькими микропроцессорами или ЦП, например симметричным многопроцессорным компьютером (SMP). Использовать параллельные запросы могут только компьютеры, имеющие более одного ЦП.
Достаточно ли доступных рабочих потоков. Каждый запрос или операция с индексами требуют определенного числа рабочих потоков. Для выполнения параллельного плана требуется больше рабочих потоков, чем для выполнения последовательного плана, и по мере увеличения степени параллелизма число необходимых рабочих потоков возрастает. Когда требование рабочего потока параллельного плана для определённой степени параллелизма не может быть выполнено, SQL Server Database Engine автоматически уменьшает степень параллелизма или запускает параллельный план последовательно.
Тип выполняемого запроса или операции с индексами. Операции с индексами, которые создают или перестраивают индекс или удаляют кластеризованный индекс и запросы, интенсивно использующие циклы ЦП, являются лучшими кандидатами для параллельного плана. Например, хорошими кандидатами являются соединения больших таблиц, агрегация больших данных и сортировка больших результирующих наборов. Для базовых запросов, часто встречающихся в приложениях для обработки транзакций, оказывается, что дополнительная координация, необходимая для параллельного выполнения запроса, перевешивает потенциальный прирост производительности. Чтобы отличить запросы, которые пользуются параллелизмом и теми, которые не получают преимущества, SQL Server ядро СУБД сравнивает предполагаемые затраты на выполнение операции запроса или индекса с пороговым значением параллелизма. Пользователи могут изменить значение по умолчанию
5, используя sp_configure , если правильное тестирование покажет, что другое значение лучше подходит для текущей нагрузки.Достаточно ли количество строк, подлежащих обработке. Если оптимизатор запросов определяет, что количество строк слишком низко, он не вводит операторы обмена для распределения строк. Таким образом, операторы выполняются последовательно. Обработка операторов в последовательном плане позволяет избежать сценариев, когда стоимость запуска, распределения и координации превышает преимущества, достигнутые параллельной обработкой оператора.
Доступна ли актуальная статистика. Если самая высокая степень параллелизма невозможна, рассматриваются более низкие уровни, прежде чем отказаться от параллельного плана. Например, когда вы создаёте кластерный индекс на представлении, статистику нельзя оценить, потому что кластерный индекс ещё не существует. В этом случае SQL Server ядро СУБД не может обеспечить самую высокую степень параллелизма для операции индекса. Однако некоторые операторы, такие как сортировка и сканирование, по-прежнему могут выигрывать от параллельной обработки.
Примечание.
Параллельные операции с индексами доступны только в выпусках SQL Server Developer Edition, Evaluation Edition и Enterprise Edition.
Во время выполнения Ядро базы данных SQL Server определяет, позволяют ли текущая системная рабочая нагрузка и сведения о конфигурации, описанные ранее, параллельное выполнение. Если параллельное выполнение оправдано, SQL Server ядро СУБД определяет оптимальное количество рабочих потоков и распределяет выполнение параллельного плана по этим рабочим потокам. Если запрос или операция с индексами начинает параллельно выполняться в нескольких рабочих потоках, это же число рабочих потоков используется до тех пор, пока операция не будет завершена. SQL Server ядро СУБД повторно проверяет оптимальное количество решений рабочего потока каждый раз, когда план выполнения извлекается из кэша планов. Например, одно выполнение кэшированного параллельного плана может выполняться последовательно, позднее выполнение того же плана может использовать три рабочих потока, а третье — четыре рабочих потока.
Операторы обновления и удаления в параллельном плане выполнения запросов выполняются последовательно, но предложение WHERE инструкции UPDATE или DELETE может выполняться параллельно. В таком случае изменения фактических данных последовательно применяются к базе данных.
Начиная с уровня совместимости базы данных 110, оператор SELECT ... INTO может выполняться параллельно. Другие формы операторов вставки работают так же, как описано в предыдущих версиях.
Начиная с уровня совместимости базы данных 130, оператор INSERT ... SELECT может выполняться параллельно при вставке в кучи или кластерные индексы columnstore (CCI) и при использовании TABLOCK подсказки. Вставки в локальные временные таблицы (обозначаемые # префиксом) и глобальные временные таблицы (идентифицируемые префиксами ## ) также включаются для параллелизма с помощью подсказки TABLOCK . Дополнительные сведения см. в разделе INSERT.
Статические курсоры и курсоры, управляемые набором ключей, могут быть заполнены параллельными планами выполнения. Однако поведение динамических курсоров может поддерживаться только последовательным выполнением. Оптимизатор запросов всегда формирует последовательный план выполнения для запроса, являющегося частью динамического курсора.
Переопределение степеней параллелизма
Максимальная степень параллелизма задает количество процессоров, используемых при одновременном исполнении планов. Эту конфигурацию можно настроить на разных уровнях:
На уровне сервера, используя параметр конфигурации сервера max degree of parallelism (
MAXDOP).Применяется к: SQL Server
В SQL Server 2019 (15.x) были добавлены автоматические рекомендации по настройке параметра конфигурации сервера
MAXDOPво время установки. Пользовательский интерфейс программы установки позволяет либо принять рекомендуемые параметры, либо задать свое значение. Дополнительные сведения см. в разделе Конфигурация ядра СУБД — страница MaxDOP.Уровень рабочей нагрузки задается с помощью
MAX_DOPпараметра конфигурации группы рабочей нагрузки Resource Governor.Применяется к: SQL Server
На уровне базы данных, используя конфигурацию
MAXDOPуровня базы данных.Применимо к: SQL Server, База данных SQL Azure и Управляемый экземпляр SQL Azure
На уровне оператора запроса или индекса, используя
MAXDOPподсказку запроса илиMAXDOPпараметр индекса. Например, вы можете использовать параметрMAXDOPдля управления количеством процессоров, выделенных для онлайн-операции индекса, увеличивая или уменьшая его. Таким образом, можно сбалансировать ресурсы, используемые при выполнении операции индексирования, с ресурсами параллельных пользователей.Применимо к: SQL Server, База данных SQL Azure и Управляемый экземпляр SQL Azure
Установка для параметра max degree of parallelism значения 0 (по умолчанию) позволяет ядро СУБД использовать все доступные процессоры, максимум до 64 процессоров, при параллельном выполнении плана. Хотя ядро СУБД задает целевое значение времени выполнения — 64 логических процессора, если для параметра MAXDOP задано значение 0, при необходимости вы можете вручную установить другое значение. Установка значения MAXDOP на 0 для запросов и индексов позволяет компоненту ядро СУБД использовать все доступные процессоры, вплоть до 64, для указанных запросов или индексов при параллельном выполнении плана.
MAXDOP не является обязательным значением для всех параллельных запросов, а скорее предварительной целью для всех запросов, подходящих для параллелизма. Это означает, что если в момент выполнения доступно недостаточно рабочих потоков, запрос может выполняться с меньшей степенью параллелизма, чем задано параметром конфигурации сервера MAXDOP.
Совет
Для получения дополнительной информации смотрите рекомендации MAXDOP для рекомендаций по настройке MAXDOP на уровне сервера, базы данных, запроса или инструкций hints.
Пример параллельного запроса
Следующий запрос подсчитывает количество заказов, сделанных в конкретном квартале, начиная с 1 апреля 2024 года, и в котором хотя бы одна позиция заказа была получена клиентом позже установленной даты. В этом запросе представлен подсчет таких заказов, сгруппированных в соответствии со срочностью каждого заказа и отсортированных в возрастающем порядке.
В этом примере используются теоретические имена таблицы и столбцов.
SELECT o_orderpriority,
       COUNT(*) AS Order_Count
FROM orders
WHERE o_orderdate >= '2024/04/01'
      AND o_orderdate < DATEADD(mm, 3, '2024/04/01')
      AND EXISTS (SELECT *
                  FROM lineitem
                  WHERE l_orderkey = o_orderkey
                        AND l_commitdate < l_receiptdate)
GROUP BY o_orderpriority
ORDER BY o_orderpriority;
Предположим, что в таблицах lineitem и orders определены следующие индексы:
CREATE INDEX l_order_dates_idx
    ON lineitem(l_orderkey, l_receiptdate, l_commitdate, l_shipdate);

CREATE UNIQUE INDEX o_datkeyopr_idx
    ON ORDERS(o_orderdate, o_orderkey, o_custkey, o_orderpriority);
Вот один из возможных параллельных планов, созданный для запроса, показанного выше:
|--Stream Aggregate(GROUP BY:([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=COUNT(*)))
    |--Parallelism(Gather Streams, ORDER BY:
                  ([ORDERS].[o_orderpriority] ASC))
         |--Stream Aggregate(GROUP BY:
                  ([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=Count(*)))
              |--Sort(ORDER BY:([ORDERS].[o_orderpriority] ASC))
                   |--Merge Join(Left Semi Join, MERGE:
                  ([ORDERS].[o_orderkey])=
                        ([LINEITEM].[l_orderkey]),
                  RESIDUAL:([ORDERS].[o_orderkey]=
                        [LINEITEM].[l_orderkey]))
                        |--Sort(ORDER BY:([ORDERS].[o_orderkey] ASC))
                        |    |--Parallelism(Repartition Streams,
                           PARTITION COLUMNS:
                           ([ORDERS].[o_orderkey]))
                        |         |--Index Seek(OBJECT:
                     ([tpcd1G].[dbo].[ORDERS].[O_DATKEYOPR_IDX]),
                     SEEK:([ORDERS].[o_orderdate] >=
                           Apr  1 2024 12:00AM AND
                           [ORDERS].[o_orderdate] <
                           Jul  1 2024 12:00AM) ORDERED)
                        |--Parallelism(Repartition Streams,
                     PARTITION COLUMNS:
                     ([LINEITEM].[l_orderkey]),
                     ORDER BY:([LINEITEM].[l_orderkey] ASC))
                             |--Filter(WHERE:
                           ([LINEITEM].[l_commitdate]<
                           [LINEITEM].[l_receiptdate]))
                                  |--Index Scan(OBJECT:
         ([tpcd1G].[dbo].[LINEITEM].[L_ORDER_DATES_IDX]), ORDERED)
Следующая иллюстрация показывает план запроса, выполненный с степенью параллелизма, равной 4 и включающей объединение из двух таблиц.
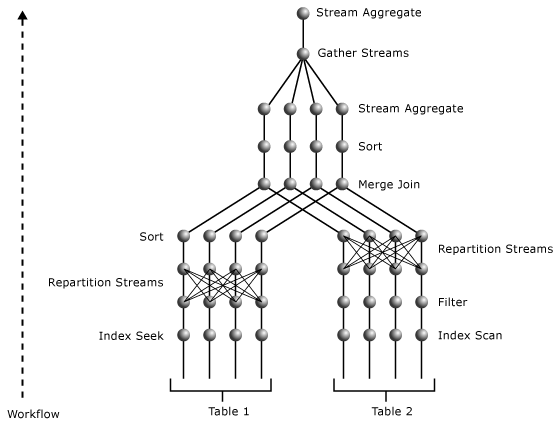
Параллельный план содержит три оператора параллелизма. Оба оператора, Index Seek для индекса o_datkey_ptr и Index Scan для индекса l_order_dates_idx, выполняются параллельно. Этот процесс генерирует несколько эксклюзивных потоков, которые можно определить по ближайшим операторам Parallelism над операторами Index Scan и Index Seek соответственно. Оба оператора перераспределяют тип обмена. Они перетасовывают данные между потоками и производят столько же потоков на своих выходах, сколько и на входе. Количество потоков равно степени параллелизма.
Оператор параллелизма над оператором сканирования индекса l_order_dates_idx переразбивает свои входные потоки, используя значение L_ORDERKEY в качестве ключа. В этом случае те же значения L_ORDERKEY оказываются в том же выходном потоке. Одновременно в выходных потоках сохраняется порядок в столбце L_ORDERKEY для соответствия требованиям оператора Merge Join к входным данным.
Оператор параллелизма над оператором Index Seek переразбиляет входные потоки с использованием значения O_ORDERKEY. Поскольку его входные данные не сортируются по значениям столбца O_ORDERKEY, а этот столбец является столбцом соединения в операторе Merge Join, оператор Sort между оператором параллелизма и оператором Merge Join обеспечивает сортировку входных данных для оператора Merge Join по столбцам соединения. Оператор Sort, как и оператор Merge Join, выполняется параллельно.
Первый оператор параллелизма объединяет результаты из нескольких потоков в один. Результаты частичной статистической обработки, выполняемой оператором Stream Aggregate под оператором параллелизма, затем собираются в единое значение SUM для каждого отдельного значения O_ORDERPRIORITY в операторе Stream Aggregate над оператором параллелизма. Поскольку этот план состоит из двух обменных сегментов, при степени параллелизма, равной 4, он использует восемь рабочих потоков.
Для получения дополнительной информации об операторах, используемых в этом примере, см. Справочник по операторам логического и физического плана выполнения.
Параллельные операции с индексами
Планы выполнения запросов для операций с индексами, которые создают или перестраивают индекс либо удаляют кластеризованный индекс, могут поддерживать параллельные многопоточные операции на компьютерах с несколькими процессорами.
Примечание.
Параллельные индексные операции доступны только в версии Enterprise.
ядро СУБД использует те же алгоритмы для определения степени параллелизма (общее количество отдельных рабочих потоков, используемых для выполнения) для операций с индексом, что и для других запросов. Параметр конфигурации сервера max degree of parallelism задает максимальную степень параллелизма для операции индекса. Вы можете переопределить max degree of parallelism значение для отдельных операций с индексом, установив MAXDOP опцию индекса в CREATE INDEX, ALTER INDEX, DROP INDEX, и ALTER TABLE операторах.
Когда SQL Server Database Engine строит план выполнения для индекса, количество параллельных операций устанавливается на минимальное из этих значений:
- Количество процессоров, или ЦП, в компьютере.
- Число, указанное в параметре конфигурации сервера
max degree of parallelism. - Количество процессоров, которые ещё не превысили определённый порог объёма выполненной работы для рабочих потоков SQL Server.
Например, на компьютере с восемью процессорами, но если max degree of parallelism установлено на 6, операция индексирования использует не более шести параллельных рабочих потоков. Если пять процессоров на компьютере превышают пороговое значение SQL Server при построении плана выполнения для индекса, план выполнения указывает только три параллельных рабочих потока.
Основные фазы параллельной индексной операции включают:
- Координирующий рабочий поток быстро и случайным образом просматривает таблицу для оценки распределения ключей индекса. Координирующий рабочий поток устанавливает границы ключей, которые создают количество диапазонов ключей, равное степени параллелизма, при этом предполагается, что каждый диапазон ключей охватывает примерно одинаковое количество строк. Например, если в таблице четыре миллиона строк и степень параллелизма равна 4, координирующая рабочая нить, определяет ключевые значения, разделяющие четыре набора строк с 1 миллионом строк в каждом наборе. Если координирующий рабочий поток не может определить достаточное количество диапазонов ключей для использования всех процессоров, он соответственно снижает степень параллелизма.
- Координирующий рабочий поток запускает рабочие потоки, количество которых равно степени параллелизма операций, и ожидает завершения этих потоков. Каждый из рабочих потоков просматривает базовую таблицу с использованием фильтра, который отделяет только строки со значениями ключей в диапазоне, назначенном этому рабочему потоку. Каждый рабочий поток создает структуру индекса для строк в своем диапазоне ключей. В случае секционированного индекса каждый из рабочих потоков создает заданное число секций. Разделы не разделяются между рабочими потоками.
- После завершения всех параллельных исполняющих потоков координирующий исполняющий поток соединяет индексные подединицы в единый индекс. Эта фаза применяется только для операций с индексами оффлайн.
Отдельные CREATE TABLE или ALTER TABLE инструкции могут иметь множество ограничений, требующих создания индекса. Эти операции создания индекса выполняются последовательно, хотя каждая отдельная операция создания индекса может быть параллельной операцией на компьютере с несколькими ЦП.
Архитектура распределенных запросов
ядро СУБД поддерживает два метода ссылки на гетерогенные источники данных OLE DB в операторах T-SQL:
Имена связанных серверов
Используйте системные хранимые процедуры
sp_addlinkedserverиsp_addlinkedsrvlogin, чтобы назначить источнику данных OLE DB имя сервера. Вы можете обращаться к объектам в этих связанных серверах в инструкциях T-SQL с помощью четырёхчастных имён. Например, если имя связанного сервераDeptSQLSrvrопределено для другого экземпляра SQL Server, для обращения к таблице на таком сервере используется следующая инструкция:SELECT JobTitle, HireDate FROM DeptSQLSrvr.AdventureWorks2025.HumanResources.Employee;Вы также можете указать имя связанного сервера в операторе
OPENQUERY, чтобы открыть набор строк из источника данных OLE DB. Затем вы можете ссылаться на этот набор строк как на таблицу в операторах T-SQL.Имена специальных коннекторов
Для редких ссылок на источник данных укажите функции
OPENROWSETилиOPENDATASOURCEс информацией, необходимой для подключения к связанному серверу. Затем вы можете ссылаться на набор строк так же, как вы ссылаетесь на таблицу в операторах T-SQL:SELECT a.* FROM OPENROWSET ( 'Microsoft.Jet.OLEDB.4.0', 'MSOffice\Access\Samples\Northwind.mdb'; 'Admin'; '', Employees ) AS a;
ядро СУБД использует OLE DB для связи между реляционным движком и движком хранения. Реляционный движок разбивает каждый оператор T-SQL на серию операций на базовых наборах строк OLE DB, которые движок хранения открывает из базовых таблиц. Это означает, что реляционный движок также может открывать базовые наборы строк OLE DB на любом источнике данных OLE DB.
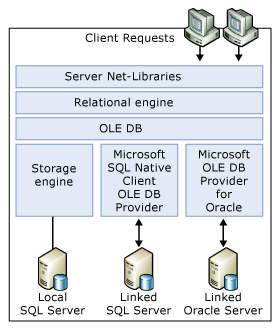
В реляционном механизме используется прикладной программный интерфейс (API) OLE DB для открытия наборов строк на связанных серверах, выборки строк и управления транзакциями.
Для каждого источника данных OLE DB, к которому вы обращаетесь как к связанному серверу, сервер, на котором выполняется SQL Server, должен иметь провайдера OLE DB. Набор операций T-SQL, которые можно использовать против конкретного источника данных OLE DB, зависит от возможностей поставщика OLE DB.
Для каждого экземпляра SQL Server члены фиксированной серверной роли sysadmin могут включать или отключать использование ad hoc имён коннекторов для провайдера OLE DB с помощью свойства SQL Server DisallowAdhocAccess. Когда вы включите ad hoc доступ, любой пользователь, вошедший в этот экземпляр, может выполнять T-SQL операторы, содержащие имена ad hoc коннекторов, ссылаясь на любой источник данных в сети, к которому может получить доступ провайдер OLE DB. Для контроля доступа к источникам данных члены фиксированной серверной роли sysadmin могут отключать нерегламентированный доступ для этого поставщика OLE DB, ограничивая пользователей только теми источниками данных, на которые ссылаются имена связанных серверов, определённые администраторами. По умолчанию для поставщика OLE DB SQL Server включен специальный доступ и отключен для всех других поставщиков OLE DB.
Распределённые запросы позволяют пользователям получать доступ к другим источникам данных (например, файлам, нереляционным источникам данных, таким как Active Directory и т.д.), используя контекст безопасности аккаунта Windows, под которым работает сервис SQL Server. SQL Server правильно выполняет олицетворение учетной записи для входа Windows. Однако такое олицетворение невозможно для входа в SQL Server. Это ограничение потенциально может позволить пользователю распределенного запроса получить доступ к другому источнику данных, для которого у него нет разрешений, но учетная запись, под которой работает служба SQL Server, имеет права. Для указания конкретных имен входа, которым будет разрешен доступ к соответствующему связанному серверу, используется процедура sp_addlinkedsrvlogin . Этот элемент управления недоступен для специальных имен, поэтому будьте осторожны при включении поставщика OLE DB для специального доступа.
По возможности ядро СУБД передает выполнение реляционных операций, таких как объединения, ограничения, проекции, сортировки и операции GROUP BY, источнику данных OLE DB. По умолчанию компонент ядро СУБД не выполняет сканирование базовой таблицы в SQL Server и не выполняет реляционные операции самостоятельно. ядро СУБД запрашивает провайдера OLE DB для определения поддерживаемого уровня SQL-грамматики и, основываясь на этой информации, отправляет провайдеру как можно больше реляционных операций.
ядро СУБД определяет механизм, позволяющий провайдеру OLE DB возвращать статистику, указывающую на распределение ключевых значений внутри источника данных OLE DB. Этот механизм позволяет оптимизатору запросов компонента ядро СУБД лучше анализировать характер распределения данных в источнике данных в соответствии с требованиями каждого оператора T-SQL, увеличивая возможности оптимизатора запросов по созданию оптимальных планов выполнения.
Обработка запросов к разбитым таблицам и индексам
ядро СУБД поддерживает обработку запросов с учётом разделов для разделённых таблиц и индексов. В этом разделе описывается, как процессор запросов обрабатывает разбитые объекты, как интерпретировать планы выполнения, связанные с разбиением, а также лучшие практики по улучшению производительности запросов на разбитых объектах.
Примечание.
Разделённые таблицы и индексы поддерживаются в стандартном издании SQL Server, начиная с SQL Server 2016 (13.x) с Service Pack 1.
Новая операция поиска с поддержкой разбиения на разделы
В ядро СУБД процессор запросов внутри рассматривает разделённую таблицу как многостолбочный индекс с PartitionID ведущим столбцом.
PartitionID представляет собой скрытый внутренний вычисляемый столбец для представления ID секции, содержащей определенную строку. Например, предположим, что таблица T, определённая как T(a, b, c), секционирована по столбцу a и имеет кластерный индекс по столбцу b. Эта разделённая таблица рассматривается как неразделённая таблица со схемой T(PartitionID, a, b, c) и кластеризованным индексом по составному ключу (PartitionID, b). Это представление позволяет оптимизатору запросов выполнять операции поиска на основе PartitionID в любой разделённой таблице или индексе.
Устранение разделов теперь осуществляется в этом процессе поиска.
Кроме того, оптимизатор запросов был расширен так, что операция поиска или сканирования с одним условием может выполняться на PartitionID (как логический ведущий столбец) и, возможно, на других столбцах индексных ключей. Затем процессор запросов выполняет поиск второго уровня с другим условием по одному или нескольким дополнительным столбцам для каждого отдельного значения, соответствующего требованиям операции поиска первого уровня. Эта операция, называемая сканированием с пропуском разделов, позволяет оптимизатору запросов выполнять операцию поиска или сканирования на основе одного условия для определения разделов для доступа, а также операцию индексного поиска второго уровня внутри этого оператора для возврата строк из этих разделов, соответствующих другому условию. Например, рассмотрим следующий запрос.
SELECT *
FROM T
WHERE a < 10
      AND b = 2;
Для этого примера предположим, что таблица T, определённая как T(a, b, c), разделена по столбцу a и имеет кластерный индекс по столбцу b. Следующая функция разбиения определяет границы разделов для таблицы T:
CREATE PARTITION FUNCTION myRangePF1(INT)
    AS RANGE LEFT
    FOR VALUES (3, 7, 10);
Для разрешения запроса обработчик запросов выполняет операцию поиска первого уровня для нахождения каждой секции, содержащей строки, удовлетворяющие условию T.a < 10. Эта операция определяет разделы, к которым нужно получить доступ. Внутри каждого идентифицированного раздела процессор затем выполняет вторичный поиск по кластеризованному индексу в столбце b, чтобы найти строки, соответствующие условиям T.b = 2 и T.a < 10.
Следующая иллюстрация является логическим представлением операции сканирования с пропуском разделов. На нем изображена таблица T с данными в столбцах a и b. Секции пронумерованы от 1 до 4, а границы секций показаны вертикальными штриховыми линиями. Операция поиска первого уровня по разбиениям (не показана на иллюстрации) определяет, что разбиения 1, 2 и 3 соответствуют условию поиска, подразумеваемому разбиением, определённым для таблицы, и предикатом на столбце a (T.a < 10). Путь, по которому проходит перемещение второго уровня, иллюстрируется изогнутой линией. По сути, операция выполняет поиск в каждом из этих разбиений строк, соответствующих условию b = 2. Общая стоимость операции равна стоимости трёх отдельных индексных поисков.
Отображение сведений о секционированиях в планах выполнения запросов
Изучайте планы выполнения для запросов к секционированным таблицам и индексам с помощью операторов T-SQL SET SHOWPLAN_XMLSET или SET STATISTICS XML, либо с помощью графического плана выполнения в SSMS. Например, вы можете отобразить план выполнения во время компиляции, выбрав Display Estimated Execution Plan на панели Редактор запросов, а план времени выполнения — выбрав Include Actual Execution Plan.
Используя эти инструменты, вы можете найти следующую информацию:
- Операции, такие как сканирование, поиск, вставка, обновление, слияние и удаление, которые обращаются к разделённым таблицам или индексам.
- разделы, к которым запрос получает доступ Например, планы выполнения во время выполнения включают общее количество разделов, к которым обращались, и диапазоны смежных разделов, к которым обращаются.
- Когда операция сканирования с пропуском разделов используется в операции поиска или сканирования для извлечения данных из одного или нескольких разделов.
Улучшения сведений о разделах
ядро СУБД предоставляет расширенную информацию о разбиении как для планов выполнения, создаваемых во время компиляции, так и для планов выполнения во время выполнения. Планы выполнения теперь содержат следующую информацию.
- Необязательный
Partitionedатрибут, указывающий на то, что оператор, такой как поиск, сканирование, вставка, обновление, слияние или удаление, выполняется над секционированной таблицей. - Новый элемент
SeekPredicateNewс вложенным элементомSeekKeys, который включаетPartitionIDв роли ведущего столбца индекса и условия фильтра, определяющие диапазонные поисковые запросы вPartitionID. Наличие двухSeekKeysподэлементов указывает на сканирование с пропуском разделов наPartitionID. - Сводные данные об общем числе секций, к которым получен доступ. Эта информация доступна только в планах выполнения.
Для демонстрации отображения этой информации как в графическом плане выполнения, так и в отчете XML Showplan рассмотрим следующий запрос в секционированной таблице fact_sales. Этот запрос обновляет данные в двух секциях.
UPDATE fact_sales
    SET quantity = quantity - 2
WHERE date_id BETWEEN 20190802 AND 20190902;
На следующем рисунке показаны свойства оператора Clustered Index Seek в плане выполнения этого запроса в среде выполнения. Для просмотра определения fact_sales таблицы и определения разбиения см. Пример.
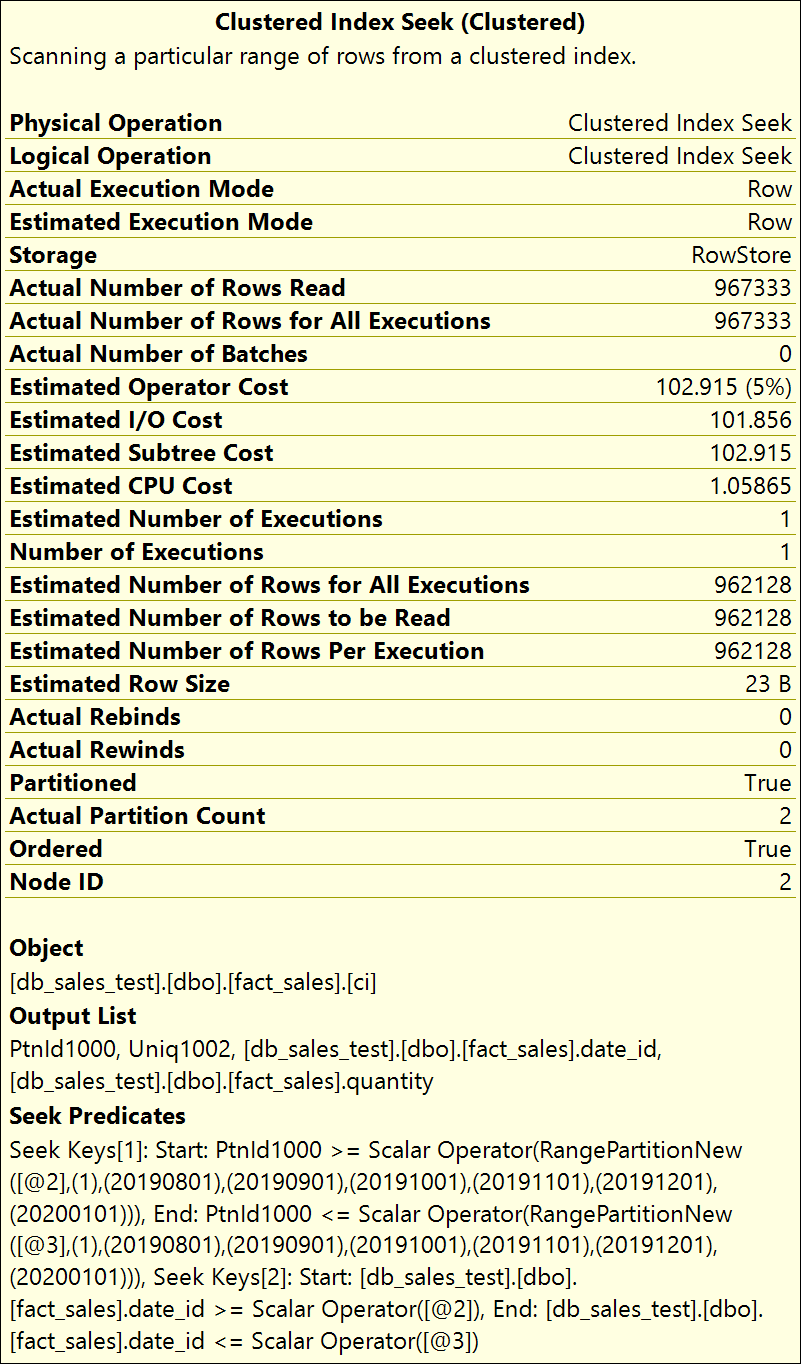
Разделённый атрибут
Если оператор, такой как поиск индекса, выполняется в секционированной таблице или индексе, Partitioned атрибут отображается в плане времени компиляции и времени выполнения и имеет True значение (1). Атрибут не отображается, если атрибут имеет значение False (0).
Атрибут Partitioned может встречаться в следующих физических и логических операторах:
- Сканирование таблиц
- Сканирование индекса
- Поиск в индексе
- Вставить
- Обновить
- Удалить
- Слияние
Как показано на предыдущей иллюстрации, этот атрибут присутствует в свойствах оператора, в котором он определяется. В выходе XML Showplan этот атрибут отображается как Partitioned="1" в RelOp узле оператора, в котором он определен.
Новый предикат поиска
В выводе XML Showplan элемент SeekPredicateNew появляется в операторе, в котором он определен. Он может содержать до двух экземпляров подэлемента SeekKeys. Первый элемент SeekKeys определяет операцию поиска первого уровня на уровне идентификатора секции логического индекса. То есть эта операция поиска определяет разделы, к которым необходимо получить доступ для выполнения условий запроса. Второй SeekKeys пункт определяет позиционирование второго уровня, которое происходит внутри каждого раздела, идентифицированного при позиционировании первого уровня.
Сводная информация о разделе
В планах времени выполнения сводка по секциям содержит данные о числе секций, к которым осуществлен доступ, и фактический перечень секций, к которым осуществлен доступ. С помощью этих данных можно проверить, к правильным ли секциям обращается запрос и исключены ли из рассмотрения остальные секции.
Предоставляется следующая информация: Actual Partition Countи Partitions Accessed.
Actual Partition Count — это общее число секций, к которым запрос получает доступ.
Partitions Accessed, в выводе XML Showplan — это информация о сводке раздела, которая появляется в новом элементе RuntimePartitionSummary в узле RelOp оператора, в котором она определена. В следующем примере показано содержимое элемента RuntimePartitionSummary , указывающее, что получен доступ только к двум секциям (секции 2 и 3).
<RunTimePartitionSummary>
    <PartitionsAccessed PartitionCount="2" >
        <PartitionRange Start="2" End="3" />
    </PartitionsAccessed>
</RunTimePartitionSummary>
Отображение информации о секции с помощью других методов Showplan
Методы SHOWPLAN_ALL, SHOWPLAN_TEXT, и STATISTICS PROFILE Showplan не сообщают информацию о разделах, описанную в этой статье, кроме одного исключения. Как часть предиката SEEK , секции, к которым необходимо получить доступ, обозначаются предикатом по диапазону в вычисляемом столбце, представляющем идентификатор секций. В следующем примере показан предикат SEEK для оператора Clustered Index Seek . К секциям 2 и 3 происходит обращение, и оператор поиска производит фильтрацию по строкам, удовлетворяющим условию date_id BETWEEN 20190802 AND 20190902.
|--Clustered Index Seek(OBJECT:([db_sales_test].[dbo].[fact_sales].[ci]),
        SEEK:([PtnId1000] >= (2) AND [PtnId1000] <= (3)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] >= (20190802)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] <= (20190902))
                ORDERED FORWARD)
Интерпретация планов выполнения для секционированных куч
Секционированная куча обрабатывается как логический индекс по идентификатору секции. В плане исполнения исключение разделов на разделённой куче представлено как оператор Table Scan с предикатом SEEK по идентификатору раздела. Следующий пример отображает сведения Showplan:
|-- Table Scan (OBJECT: ([db].[dbo].[T]), SEEK: ([PtnId1001]=[Expr1011]) ORDERED FORWARD)
Интерпретация планов выполнения для коллокированных соединений
Выравнивание соединений может происходить, когда две таблицы разбиваются по одной и той же или эквивалентной функции секционирования, и столбцы секционирования с обеих сторон соединения указаны в условии соединения запроса. Оптимизатор запросов может сформировать план, в котором секции каждой таблицы, имеющие равные идентификаторы, соединяются отдельно. Коллокированные соединения могут выполняться быстрее, чем неколлокированные, поскольку они могут требовать меньшего объёма памяти и времени обработки. Оптимизатор запросов выбирает план без выравнивания или план с выравниванием на основе оценок стоимости.
В распределенных планах соединение Nested Loops считывает одну или более секций для объединяемых таблиц или индексов с внутренней стороны соединения. Цифры в операторах Constant Scan представляют собой номера секций.
Если для секционированных таблиц или индексов формируются параллельные планы для совместных соединений, то между операторами соединения Constant Scan и Nested Loops появляется оператор Parallelism. В этом случае несколько рабочих потоков на внешней стороне операции соединения считывают разные разделы и работают с разными разделами.
Следующий рисунок демонстрирует план параллельного запроса для совмещенных соединений.
Стратегия параллельного выполнения запросов для секционированных объектов
Обработчик запросов использует стратегию параллельного выполнения для запросов, производящих выборку из секционированных объектов. В рамках стратегии выполнения обработчик запросов определяет секции таблиц, необходимые для запроса, и долю рабочих потоков, выделяемых для каждой секции. В большинстве случаев обработчик запросов выделяет равное или почти равное количество рабочих потоков для каждой секции, а затем выполняет запрос параллельно на всех секциях. В следующих параграфах более подробно объясняется выделение рабочих потоков.
Если число рабочих потоков меньше числа секций, обработчик запросов назначает каждому рабочему потоку отдельную секцию, первоначально оставляя одну или несколько секций без назначенного рабочего потока. Когда рабочий поток завершает выполнение на разделе, процессор запросов назначает его на следующий раздел, пока каждому разделу не будет назначен один рабочий поток. Это распределение — единственный случай, когда процессор запросов перераспределяет рабочие потоки между другими разделами.
Отображает рабочий поток, повторно назначенный после завершения. Если число рабочих потоков равно числу секций, обработчик запросов назначает каждой секции по одному рабочему потоку. Когда рабочий поток завершится, он не будет перераспределирован в другую секцию.
Если число рабочих потоков больше числа секций, обработчик запросов назначает каждой секции одинаковое число рабочих потоков. Если количество рабочих потоков не является точным кратным числу разделов, процессор запросов выделяет один дополнительный рабочий поток для некоторых разделов, чтобы использовать все доступные рабочие потоки. Если раздел только один, все рабочие потоки назначаются этому разделу. На следующей диаграмме четыре раздела и 14 рабочих потоков. Каждому разделу назначены три рабочих потока, а для двух разделов назначен дополнительный рабочий поток, всего 14 назначений рабочих потоков. Когда рабочий поток завершится, он не переназначется другому разделу.
Хотя предыдущие примеры предлагают простой способ распределения рабочих потоков, сама стратегия более сложна и учитывает другие переменные, возникающие при выполнении запросов. Например, если таблица разбита на части и имеет кластерный индекс на столбце A, а запрос содержит условие-предикат WHERE A IN (13, 17, 25), процессор запросов выделяет один или несколько рабочих потоков для каждого из этих трёх значений поиска (A = 13, A = 17 и A = 25) вместо каждого раздела таблицы. Достаточно выполнить запрос в разделах, содержащих эти значения, и если все эти предикаты поиска находятся в одном разделе таблицы, все рабочие потоки назначаются одному и тому же разделу таблицы.
Возьмём другой пример: предположим, что в таблице четыре разбиения по столбцу A с граничными точками (10, 20, 30), индекс по столбцу B, а запрос содержит предикатное выражение WHERE B IN (50, 100, 150). Поскольку разбиения таблицы основаны на значениях A, значения B могут встречаться в любом из разбиений таблицы. Таким образом, процессор запросов ищет каждое из трёх значений B (50, 100, 150) в каждом из четырёх разделов таблицы. Процессор запросов пропорционально назначает рабочие потоки, чтобы выполнять каждое из этих 12 сканирований запросов параллельно.
Разбиения таблиц на основе столбца A |
Ищет столбец B в каждой партиции таблицы |
|---|---|
Секция таблицы 1: A < 10 |
B = 50
B = 100
B = 150
|
Секция таблицы 2: A >= 10 AND A < 20 |
B = 50
B = 100
B = 150
|
Раздел таблицы 3: A >= 20 AND A < 30 |
B = 50
B = 100
B = 150
|
Секция таблицы 4: A >= 30 |
B = 50
B = 100
B = 150
|
Лучшие практики
Для повышения производительности запросов, получающих доступ к большому объёму данных из больших разбитых таблиц и индексов, следуйте следующим лучшим практикам:
Распределяйте каждую секцию по нескольким дискам. Этот подход особенно актуален при использовании вращающихся дисков.
По возможности используйте сервер с достаточной основной памятью, чтобы соответствовать часто используемым секциям или всем секциям в памяти, чтобы сократить затраты на ввод-вывод.
Если запрашиваемые данные не помещаются в память, сжимайте таблицы и индексы, чтобы снизить затраты на ввод-вывод.
Чтобы в полной мере реализовать возможности параллельной обработки запросов, используйте сервер с быстрыми процессорами и как можно большим числом процессорных ядер.
Обеспечьте достаточную пропускную способность контроллера ввода-вывода для сервера.
Чтобы воспользоваться оптимизациями сканирования B-дерева, создайте кластеризованный индекс по каждой большой секционированной таблице.
При массовой загрузке данных в разделённые таблицы следуйте рекомендациям лучших практик из белого документа «Руководство по производительности загрузки данных».
Пример
В следующем примере показано создание тестовой базы данных, состоящей из одной таблицы с семью секциями. Чтобы просмотреть информацию о разбиении как для планов компиляции, так и для планов выполнения, используйте инструменты, описанные в Отображение информации о разбиении в планах выполнения запросов, при выполнении запросов в этом примере.
Примечание.
В данном примере в таблицу вставляется более 1 миллиона строк. Выполнение этого примера может занять несколько минут в зависимости от оборудования. Перед выполнением этого примера следует убедиться, что на диске 1,5 ГБ свободного места.
USE master;
GO

IF DB_ID(N'db_sales_test') IS NOT NULL
    DROP DATABASE db_sales_test;
GO

CREATE DATABASE db_sales_test;
GO

USE db_sales_test;
GO

CREATE PARTITION FUNCTION pf_range_fact(INT)
    AS RANGE RIGHT
    FOR VALUES (20190801, 20190901, 20191001, 20191101, 20191201, 20200101);
GO

CREATE PARTITION SCHEME ps_fact_sales
    AS PARTITION pf_range_fact
    ALL TO ([PRIMARY]);
GO

CREATE TABLE fact_sales
(
    date_id INT,
    product_id INT,
    store_id INT,
    quantity INT,
    unit_price NUMERIC (7, 2),
    other_data CHAR (1000)
) ON ps_fact_sales (date_id);
GO

CREATE CLUSTERED INDEX ci
    ON fact_sales(date_id);
GO

PRINT 'Loading...';

SET NOCOUNT ON;

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 1000000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190800 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END
GO

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 10000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190900 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END

PRINT 'Done.';
GO

-- Two-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190802 AND 20190902
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO

-- Single-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190801 AND 20190831
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO
Связанный контент
- справочник по оператору Логический и физический оператор showplan
- Обзор расширенных событий
- Рекомендации по мониторингу рабочих нагрузок с помощью Хранилища запросов
- Оценка кардинальности (SQL Server)
- Интеллектуальная обработка запросов в базах данных SQL
- Приоритет операторов (Transact-SQL)
- Обзор плана выполнения
- Центр производительности для базы данных SQL Azure и ядра СУБД SQL Server