Описание нормализации
Нормализация базы данных — это процесс проектирования, используемый для упорядочивания данных в таблицах и столбцах в базе данных. Каждая таблица должна содержать данные, связанные с определенной сущностью, и включать только сведения, поддерживающие это сущность. Основной целью нормализации является минимизация повторяющихся данных в базе данных, что помогает предотвратить снижение производительности во время вставок и обновлений. Например, если необходимо обновить адрес клиента, проще реализовать изменение, если адрес хранится в одном расположении, например Customers в таблице.
Наиболее распространенными формами нормализации являются первая, вторая и третья нормальные формы.
Первая обычная форма
Первая обычная форма имеет следующие спецификации:
- Создание отдельной таблицы для каждого набора связанных данных
- Устранение повторяющихся групп в отдельных таблицах
- Определение каждого набора связанных данных с первичным ключом
В этой модели следует избегать использования нескольких столбцов в одной таблице для хранения аналогичных данных. Например, если продукт может находиться в нескольких цветах, у вас не должно быть нескольких столбцов в одной строке, содержащей разные значения цвета. Первая следующая таблица, не является первой обычной формой, ProductColorsтак как она имеет повторяющиеся значения для цвета. Для продуктов с одним цветом есть пустое пространство. Кроме того, если продукт поставляется более чем в трех цветах, он становится непрактичным, чтобы задать максимальное количество столбцов. Вместо этого можно создать таблицу, как показано во второй таблице ProductColor.
Для первой обычной формы также требуется уникальный ключ для таблицы, который является столбцом (или столбцами), значение которого однозначно идентифицирует каждую строку. Во второй таблице ни один из столбцов не является уникальным, но вместе сочетание ProductID и Color формирует уникальный ключ. Если для создания уникального ключа требуется несколько столбцов, он называется составным ключом.
ProductColorsстол:ProductID Цвет1 Цвет2 Цвет3 1 Красный Зеленый Жёлтый 2 Жёлтый 3 Синий Красный 4 Синий 5 Красный ProductColorстол:ProductID Цвет 1 Красный 1 Зеленый 1 Жёлтый 2 Жёлтый 3 Синий 3 Красный 4 Синий 5 Красный
Третья таблица , ProductInfoнаходится в первой обычной форме, так как каждая строка ссылается на определенный продукт, нет повторяющихся групп, и у нас есть столбец ProductID для использования в качестве первичного ключа.
| ProductID | ProductName | Цена | ProductionCountry | ShortLocation |
|---|---|---|---|---|
| 1 | Виджет | 15.95 | Соединенные Штаты | США |
| 2 | Foop | 41.95 | Соединенное Королевство | ВЕЛИКОБРИТАНИЯ |
| 3 | Гломбит | 49.95 | Соединенное Королевство | ВЕЛИКОБРИТАНИЯ |
| 4 | Sorfin | 99.99 | Республика Филиппины | RepPhil |
| 5 | Стебля Болт | 29.95 | Соединенные Штаты | США |
Вторая обычная форма
Вторая обычная форма имеет следующую спецификацию, помимо тех, которые требуются первой нормальной формой:
- Если в таблице есть составной ключ, все атрибуты должны зависеть от полного ключа, а не только от части.
Вторая обычная форма относится только к таблицам с составными ключами, как в таблице ProductColor, которая является второй таблицей. Рассмотрим случай, когда ProductColor таблица также включает цену продукта. Эта таблица содержит составной ключ ProductID и Color, так как только при использовании обоих значений столбцов можно однозначно определить строку. Если цена продукта не изменяется с цветом, мы можем увидеть данные, как показано в этой таблице.
| ProductID | Цвет | Цена |
|---|---|---|
| 1 | Красный | 15.95 |
| 1 | Зеленый | 15.95 |
| 1 | Жёлтый | 15.95 |
| 2 | Жёлтый | 41.95 |
| 3 | Синий | 49.95 |
| 3 | Красный | 49.95 |
| 4 | Синий | 99,95 % |
| 5 | Красный | 29.95 |
Эта таблица не является второй обычной формой. Цена зависит от ProductID стоимости, но не от Color. Есть три строки для ProductID 1, поэтому цена на этот продукт повторяется три раза. Проблема с нарушением второй нормальной формы заключается в том, что если нам нужно обновить цену, мы должны убедиться, что она обновляется везде. Если мы обновим цену в первой строке, но не во второй или третьей, мы столкнулись бы с аномалией обновления. После обновления мы не сможем определить фактическую цену за ProductID 1. Решение заключается в перемещении Price столбца в таблицу с ProductID одним ключом столбца, так как это единственный столбец, от него Price зависит. Например, можно использовать таблицу 3 для хранения Price.
Если цена на продукт была другой на основе его цвета, четвертая таблица будет в второй нормальной форме, так как цена будет зависеть от обеих частей ключа: ProductID и .Color
Третья обычная форма
Третья обычная форма обычно является целью большинства баз данных OLTP. Третья обычная форма имеет следующую спецификацию, помимо тех, которые требуются второй нормальной форме:
- Все неключевые столбцы не зависят от первичного ключа.
Транзитивная связь подразумевает, что один столбец в таблице связан с другими столбцами через второй столбец. Зависимость означает, что столбец может получить его значение от другого в результате этой связи. Например, возраст можно определить с даты рождения, что зависит от даты рождения. Вернитесь к третьей таблице. ProductInfo Эта таблица находится во второй обычной форме, но не в третьей. Столбец ShortLocation зависит от столбца ProductionCountry , который не является ключом. Как и вторая нормальная форма, нарушение третьей нормальной формы может привести к обновлению аномалий. В конечном итоге мы будем несогласованными данными, если мы обновили ShortLocation одну строку, но не обновили его во всех строках, где произошло это расположение. Чтобы предотвратить это, можно создать отдельную таблицу для хранения имен стран или регионов и их сокращенных форм.
Денормализация
Хотя третья нормальная форма теоретически желательна, это не всегда возможно для всех данных. Кроме того, нормализованная база данных не всегда дает оптимальную производительность. Нормализованные данные часто требуют нескольких операций соединения для получения всех необходимых данных, возвращаемых в одном запросе. Существует компромисс между нормализацией данных, когда количество соединений, необходимых для возврата результатов запроса, имеет высокую загрузку ЦП и денормализованные данные, которые имеют меньше соединений и меньше ЦП, но открывает возможность обновления аномалий.
Денормализованные данные могут быть более эффективными для запроса, особенно для чтения тяжелых рабочих нагрузок, таких как хранилище данных. В таких случаях наличие дополнительных столбцов может предложить лучшие шаблоны запросов и (или) более упрощенные запросы.
Схема "Звезда"
Хотя большая часть нормализации направлена на рабочие нагрузки OLTP, хранилища данных имеют собственную структуру моделирования, которая обычно является денормализованной моделью. Эта структура использует таблицы фактов для записи измерений или метрик для определенных событий, таких как продажи, и объединяет их с таблицами измерений. Таблицы измерений меньше с точки зрения количества строк, но могут иметь большое количество столбцов для описания данных фактов. Примеры измерений включают инвентаризацию, время и географию. Этот шаблон проектирования упрощает запрос к базе данных и обеспечивает повышение производительности для рабочих нагрузок чтения.
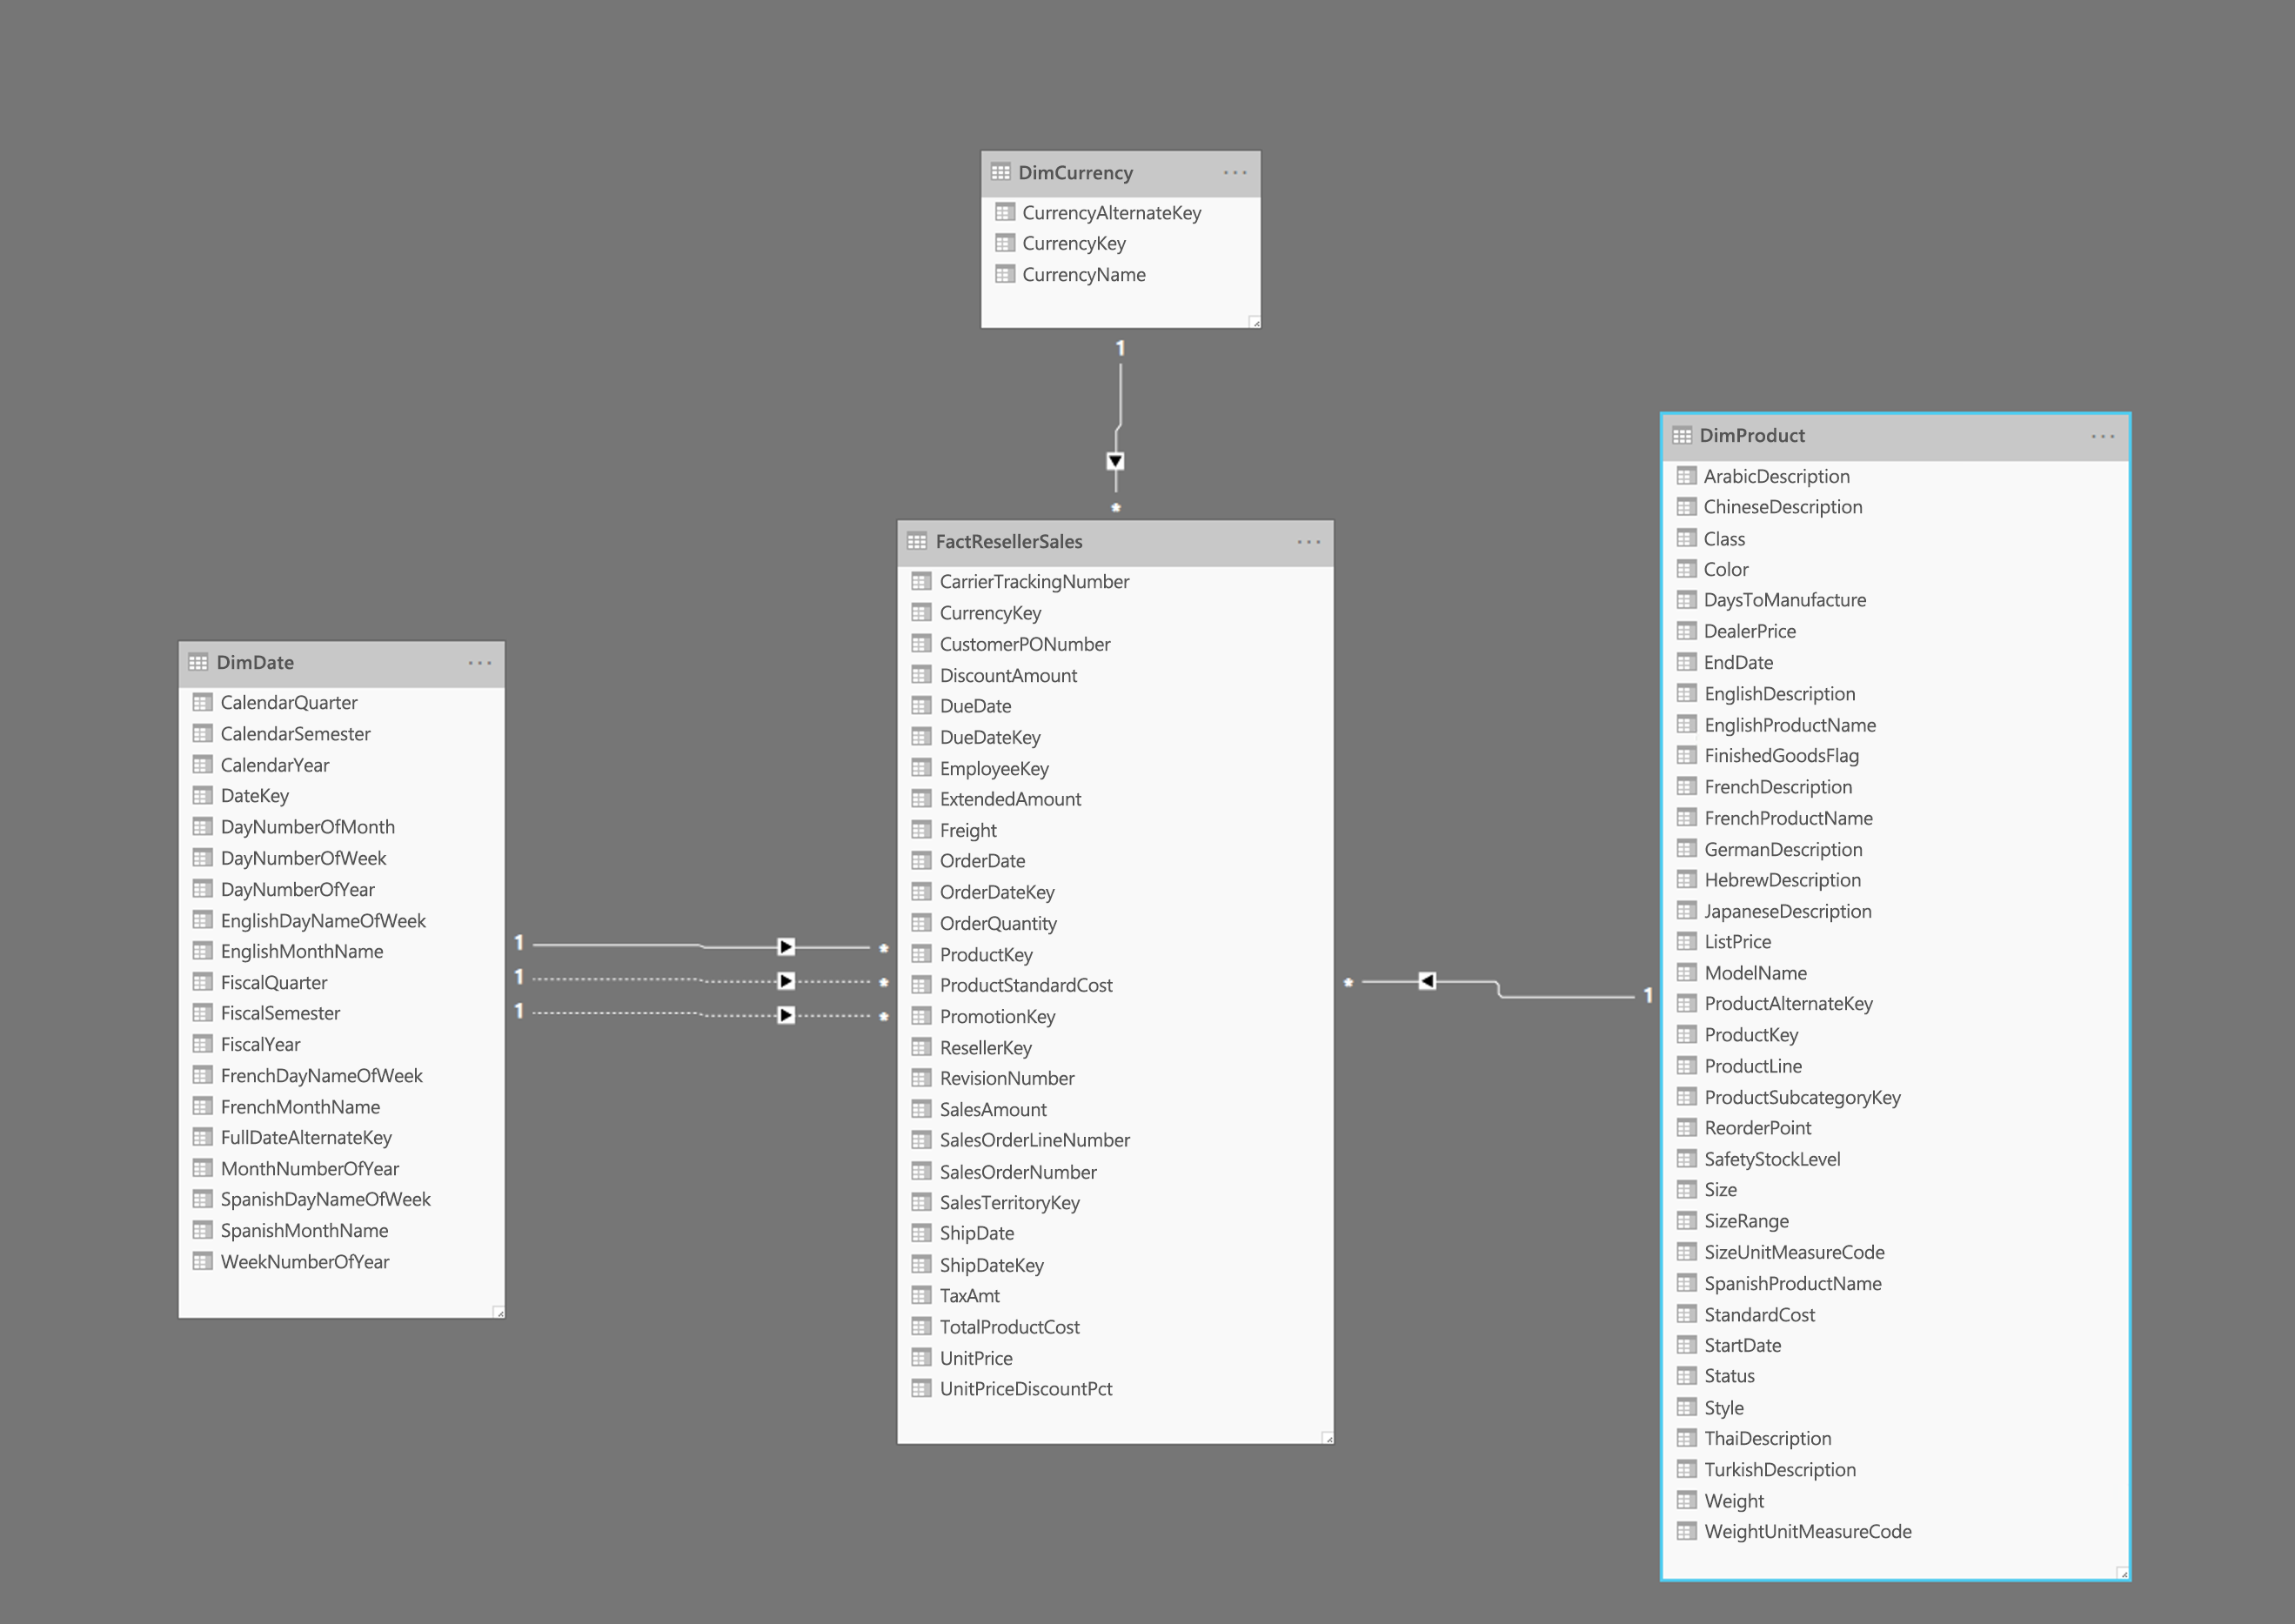
На изображении показан пример схемы звезды, в которой представлена FactResellerSales таблица фактов и измерения для даты, валюты и продуктов. Таблица фактов содержит данные, связанные с транзакциями продаж, а измерения содержат только данные, связанные с определенными элементами данных о продажах. Например, таблица FactResellerSales содержит только то ProductKey , какой продукт был продан. Все сведения о каждом продукте хранятся в DimProduct таблице и связаны с таблицей фактов с помощью столбца ProductKey .
Связанная с схемой звездочки — это схема snowflake, которая использует набор более нормализованных таблиц для одной бизнес-сущности. На следующем рисунке показан пример одного измерения в схеме snowflake. Измерение "Продукты" нормализуется и сохраняется в трех таблицах: DimProductCategory, DimProductSubcategoryи DimProduct.
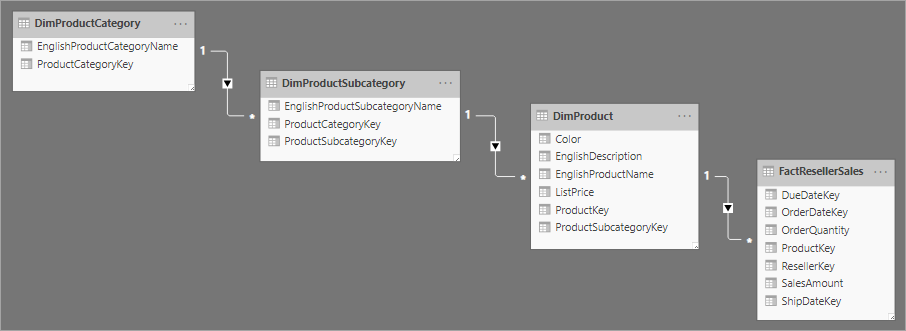
Основное различие между схемами star и snowflake заключается в том, что измерения в схеме snowflake нормализуются для уменьшения избыточности, что экономит место в хранилище. Компромисс заключается в том, что запросы требуют больше соединений, что может повысить сложность и снизить производительность.