Введение в данные изображений
- 10 мин
В компьютерном зрении мы обычно решаем одну из следующих проблем:
- Классификация изображений является самой простой задачей, когда нам нужно классифицировать изображение в одну из многих предопределенных категорий, например отличить кота от собаки на фотографии или распознать рукописную цифру.
- Обнаружение объектов является немного более сложной задачей, в которой необходимо найти известные объекты на рисунке и локализовать их, то есть вернуть ограничивающий прямоугольник для каждого распознанного объекта.
- Сегментация аналогична обнаружению объектов, но вместо предоставления ограничивающей рамки нам нужно вернуть точную пиксельную карту, выстраивая контуры каждого из распознанных объектов.
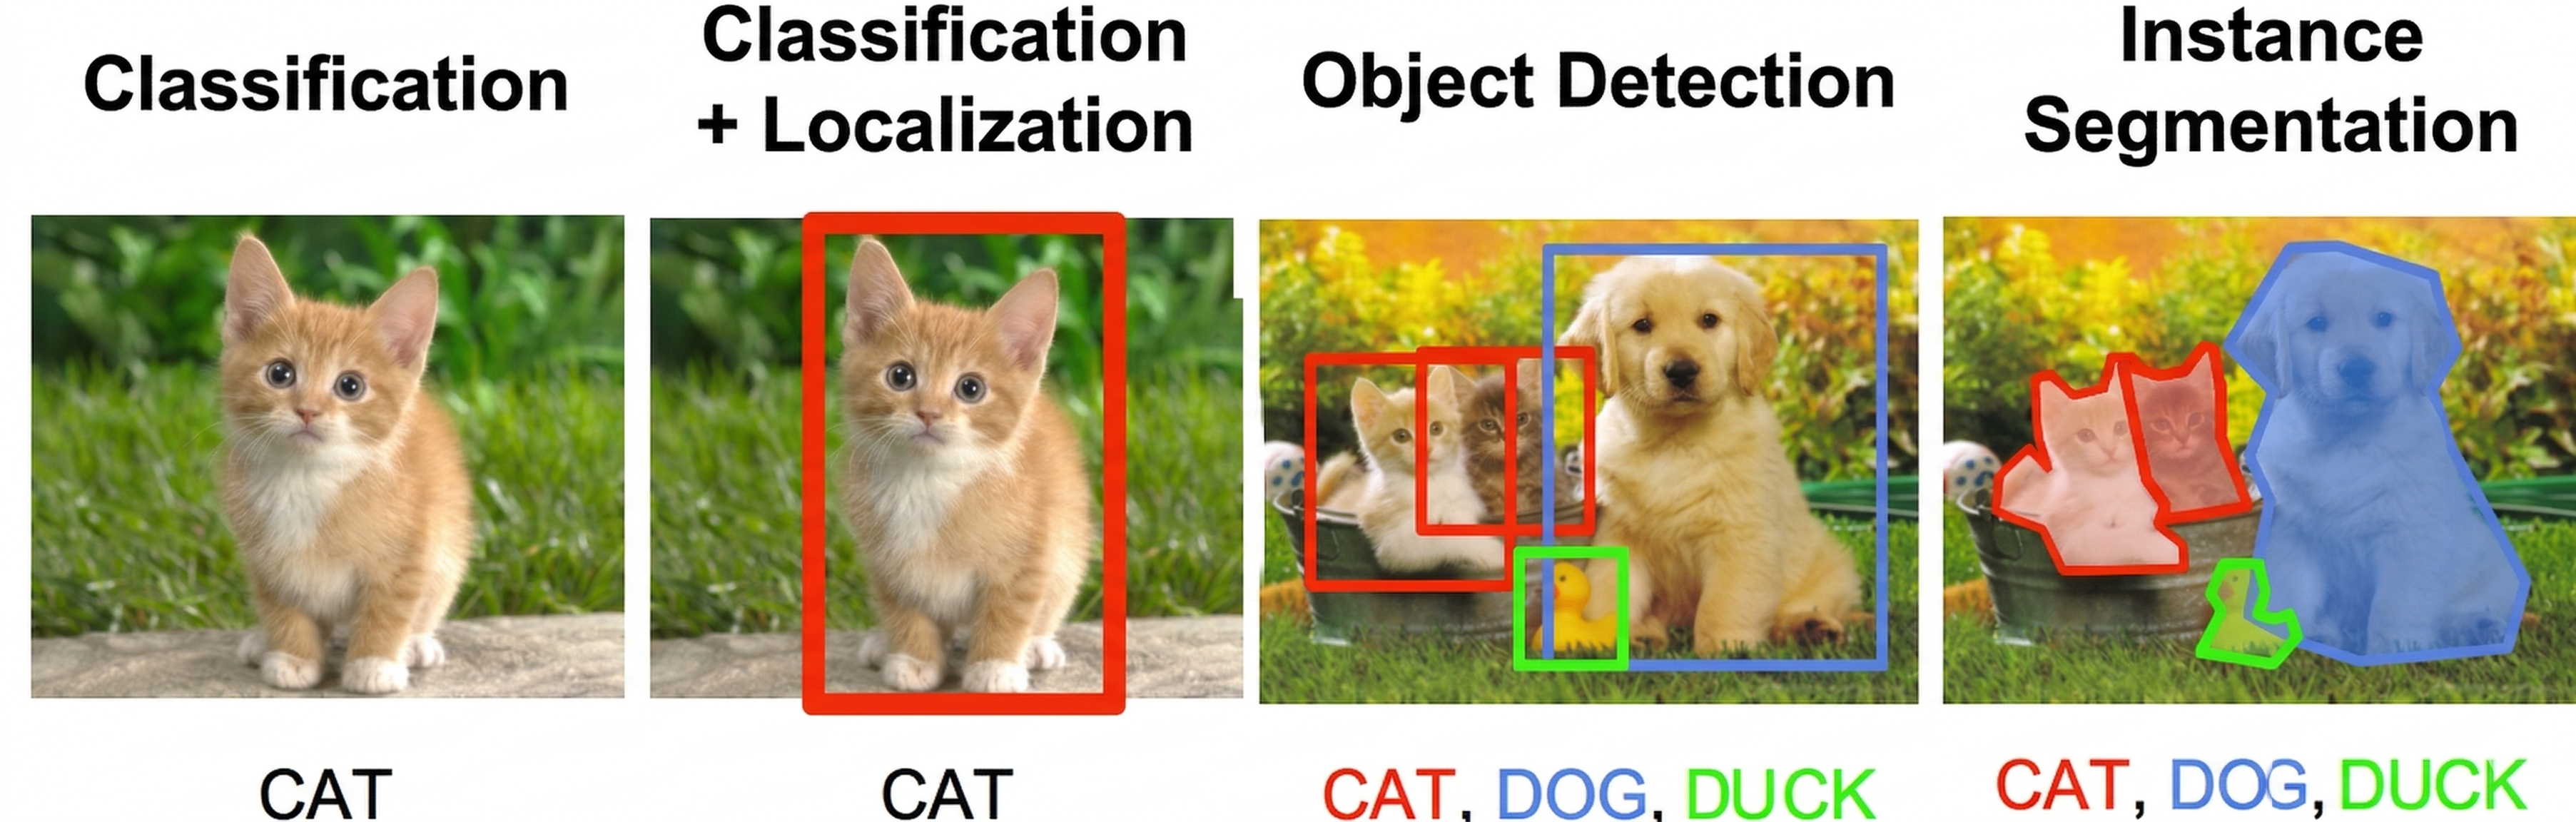
Изображение из курса CS231n Стэнфордского университета
Изображения в виде тензоров
Компьютерное зрение работает с изображениями. Как вы, вероятно, знаете, изображения состоят из пикселей, поэтому их можно рассматривать как прямоугольную коллекцию (массив) пикселей.
В первой части этого модуля мы рассмотрим рукописное распознавание цифр. Мы будем использовать набор данных MNIST, состоящий из изображений серого масштаба рукописных цифр, 28x28 пикселей. Каждое изображение может быть представлено как массив 28x28, а элементы этого массива будут обозначать интенсивность соответствующего пикселя — либо в масштабе диапазона 0 до 1 (в этом случае используются числа с плавающей запятой), либо от 0 до 255 (целые числа). Популярная библиотека numpy Python часто используется с задачами компьютерного зрения, так как она позволяет эффективно работать с многомерными массивами.
Чтобы справиться с цветными изображениями, нам нужен какой-то способ представления цветов. В большинстве случаев мы представляем каждый пиксель на 3 значения интенсивности, соответствующие компонентам Red (R), Зеленый (G) и Синий (B). Эта кодировка цвета называется RGB, поэтому цветное изображение размера W×H будет представлено в виде массива размера H×W×3 (иногда порядок компонентов может отличаться, но идея совпадает). В представлении массива высота (число строк) предшествует ширине (число столбцов), что противоположно общему стандарту изображения W×H.
Многомерные массивы также называются тензорами. Использование тензоров для представления изображений также имеет преимущество, так как мы можем использовать дополнительное измерение для хранения последовательности изображений. Например, чтобы представить фрагмент видео, состоящий из 200 кадров с измерением 800x600 (ширина × высота), можно использовать тензор размером 200x600x800x3. Помните, что размеры тензоров используют в порядке H×W (row-major), а не соглашение W×H, как это обычно бывает в редакторах изображений. Порядок измерений: кадры × высота (600) × ширина (800) × каналы. Это упорядочение называется channels_last и используется по умолчанию в TensorFlow; в некоторых других фреймворках каналы размещаются перед высотой и шириной (channels_first).
import tensorflow as tf
import keras
import matplotlib.pyplot as plt
import numpy as np

# Prints the installed TensorFlow version
print(tf.__version__)
Мы будем использовать платформу Keras для наших экспериментов. В этом модуле мы используем import keras (стиль импорта Keras 3), для которого требуется TensorFlow 2.16 или более поздняя версия (или автономная установка через pip install keras>=3.0). Если вы используете старую версию TensorFlow 2.x, замените import keras на from tensorflow import keras.
(x_train, y_train), (x_test, y_test) = keras.datasets.mnist.load_data()

# Output: (60000, 28, 28) (60000,)
print(x_train.shape, y_train.shape)
# Output: (10000, 28, 28) (10000,)
print(x_test.shape, y_test.shape)
Визуализация набора данных цифр
Теперь, когда мы скачали набор данных, можно визуализировать некоторые цифры:
fig, ax = plt.subplots(1, 7)
for i in range(7):
    ax[i].imshow(x_train[i])
    ax[i].set_title(y_train[i])
    ax[i].axis('off')
# Displays a row of seven handwritten digit images with their labels
Структура набора данных
У нас есть 60 000 обучающих изображений и 10 000 тестовых изображений, и каждый образ имеет размер 28×28 пикселей:
print('Training samples:', len(x_train))
print('Test samples:', len(x_test))
print('Tensor size:', x_train[0].shape)
print('First 10 digits are:', y_train[:10])
print('Type of data is ', type(x_train))
# Output:
# Training samples: 60000
# Test samples: 10000
# Tensor size: (28, 28)
# First 10 digits are: [5 0 4 1 9 2 1 3 1 4]
# Type of data is  <class 'numpy.ndarray'>
Как видно, тип данных — массив numpy . Каждая интенсивность пикселей представлена целым числом от 0 до 255:
print('Min intensity value: ', x_train.min())
print('Max intensity value: ', x_train.max())
# Output:
# Min intensity value:  0
# Max intensity value:  255
Причина в диапазоне от 0 до 255 заключается в том, что каждый пиксель представлен 8-разрядным целым числом. Во многих случаях, особенно при работе с нейронными сетями, удобнее масштабировать все значения в диапазоне [0, 1], разделив на 255. Этот процесс называется нормализацией:
x_train = x_train.astype(np.float32) / 255.0
x_test = x_test.astype(np.float32) / 255.0
# Pixel values are now floating point numbers in the range [0, 1]
Теперь у нас есть данные, и мы готовы начать обучение нашей первой нейронной сети!
Проверьте свои знания
Обратная связь
Были ли сведения на этой странице полезными?
Нет
Нужна помощь с этой темой?
Хотите попробовать использовать Ask Learn для уточнения или руководства по этой теме?