Прием данных с помощью Azure Databricks
Прежде чем работать с данными в Azure Databricks, необходимо принять данные на платформу. После использования платформы облачные вычислительные ресурсы позволяют эффективно обрабатывать большие объемы данных.
Данные в Azure Databricks хранятся с помощью Apache Delta Lake, системы с открытым исходным кодом для управления файлами данных, в которых можно определить и запросить реляционные таблицы. Фактическое расположение хранилища для файлов разностного озера может отличаться. Azure Databricks поддерживает подключение к облачным службам хранилища данных, таким как служба хранилища Azure и Azure Data Lake. Azure Databricks также предоставляет каталог Unity в качестве решения для управления доступом к данным и отслеживания их происхождения в нескольких подключенных хранилищах данных.
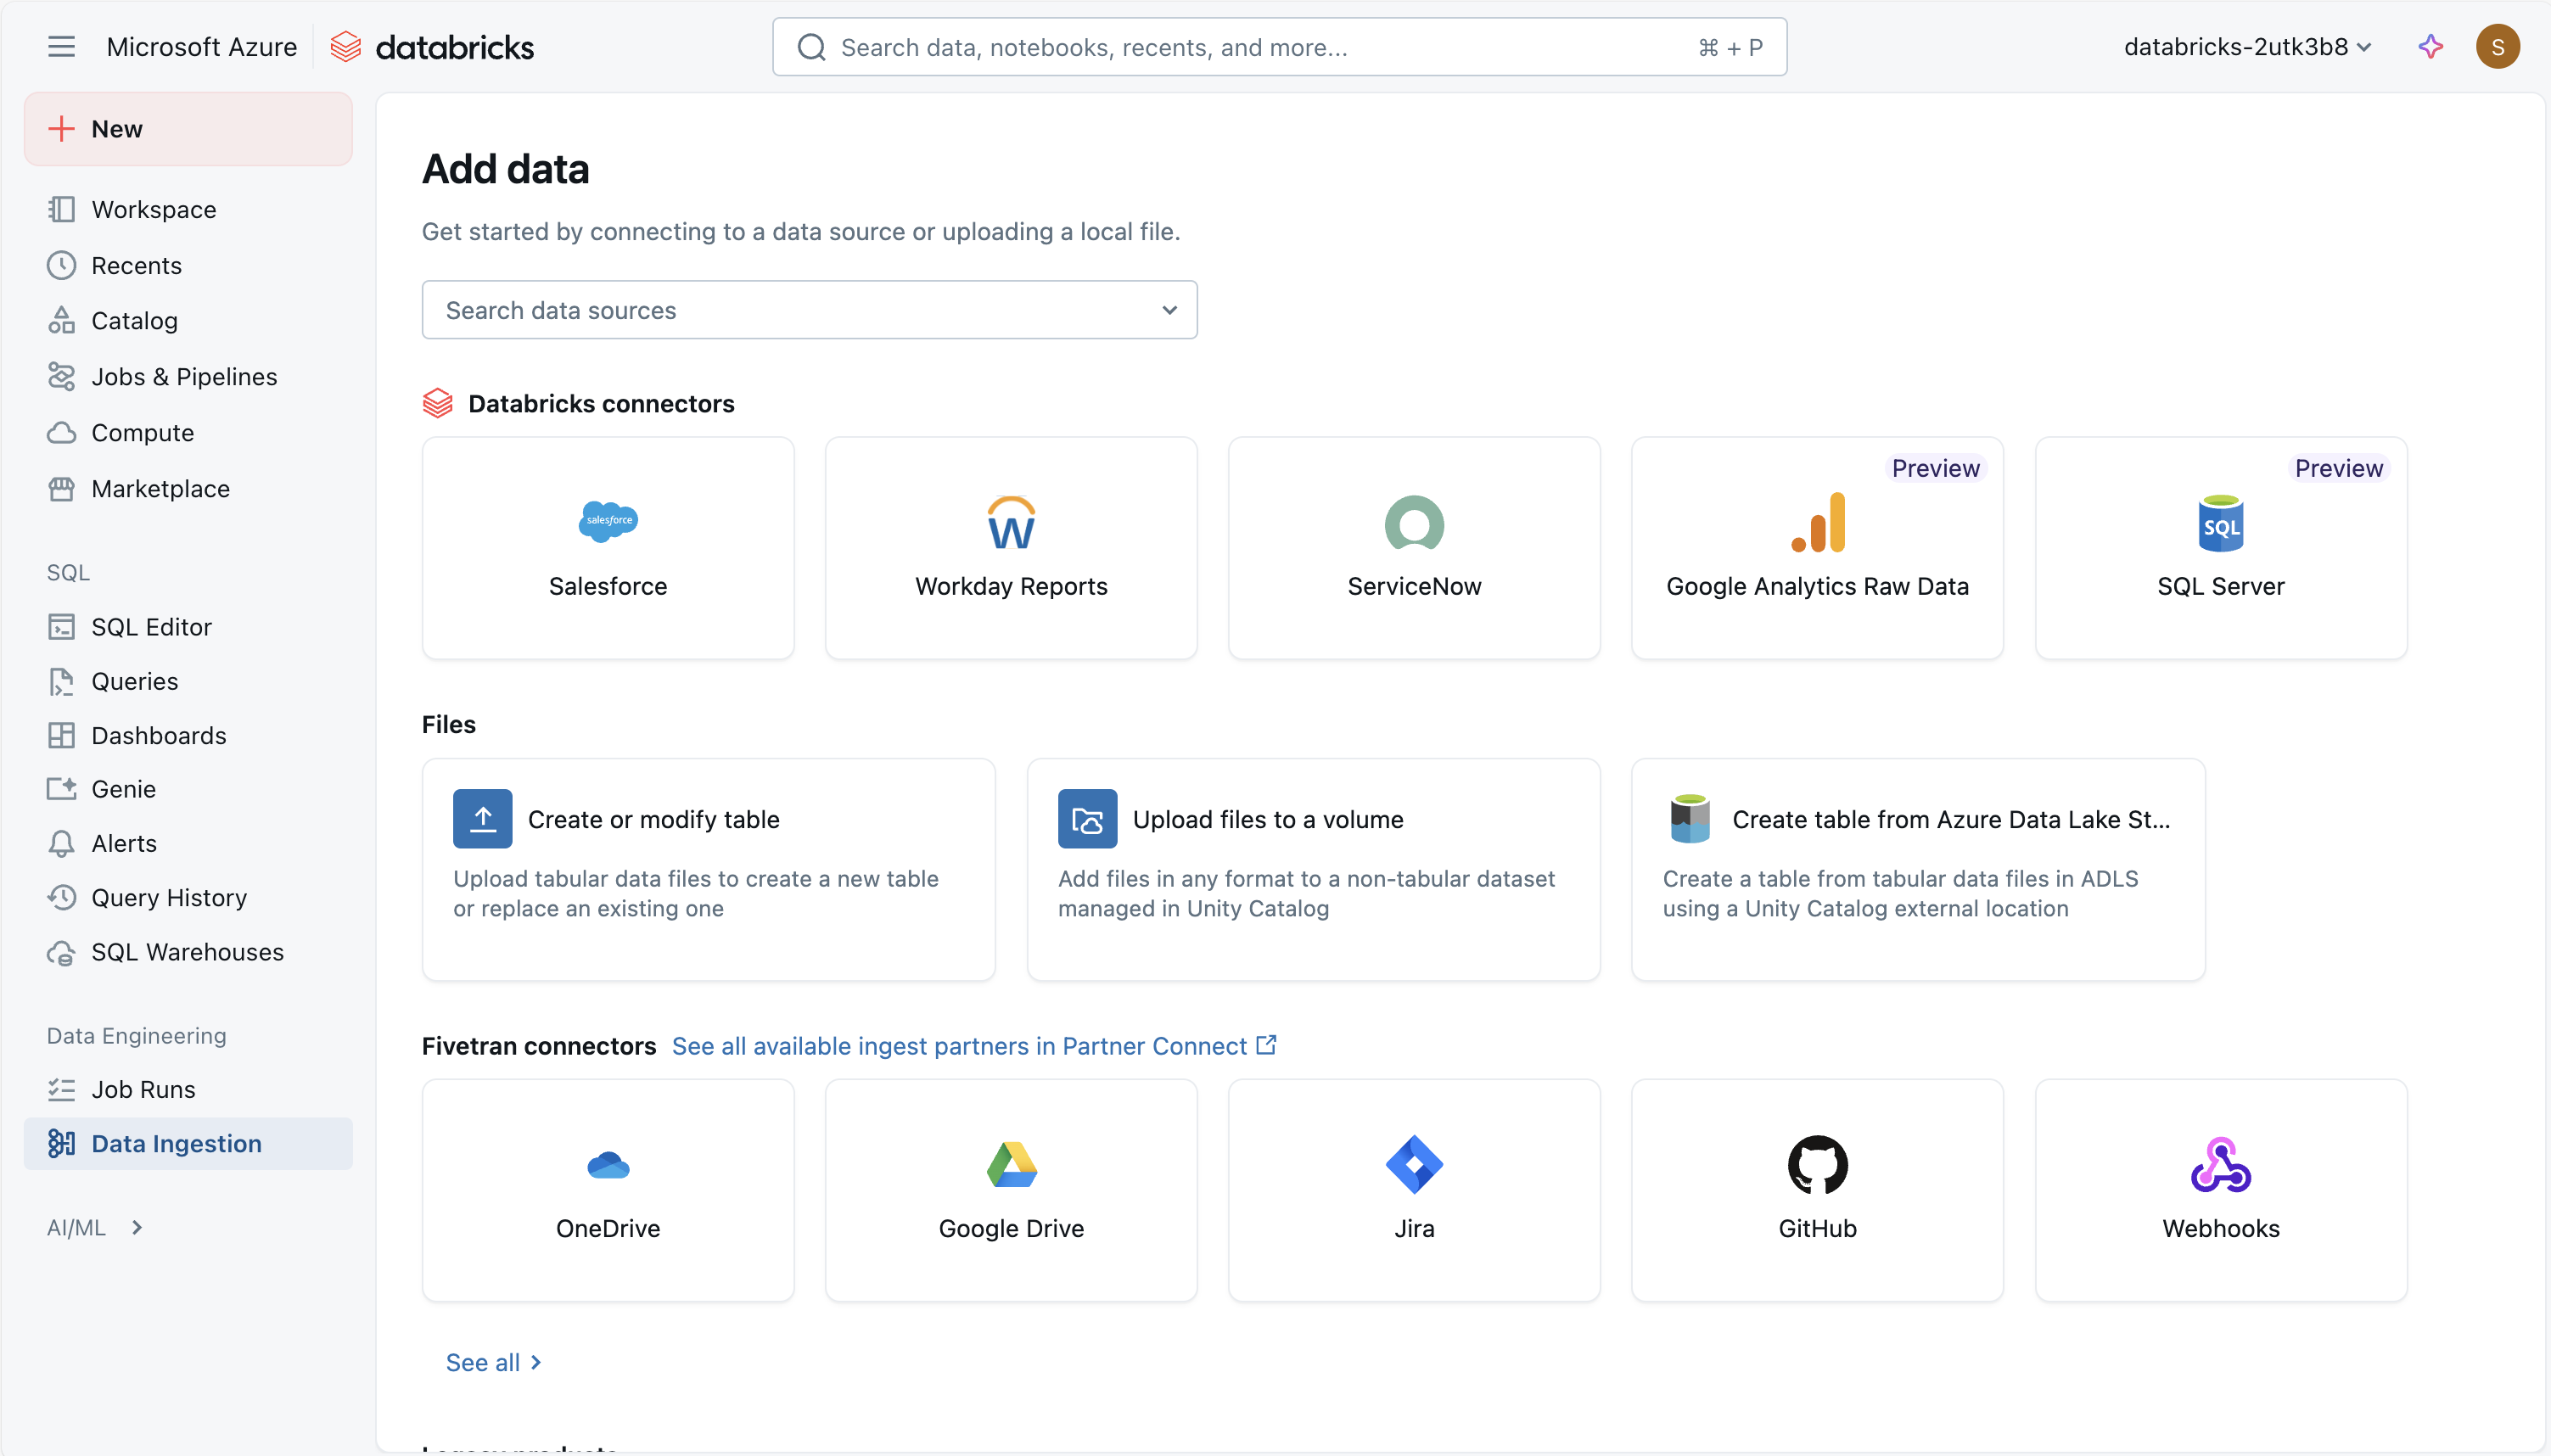
Существует несколько способов приема данных в Azure Databricks, что делает его универсальным и мощным инструментом для анализа данных, в том числе:
Использование управляемого соединителя Databricks в Lakeflow Connect
Azure Databricks Lakeflow Connect предоставляет платформу для приема данных из приложений SaaS, баз данных и других источников в lakehouse с помощью управляемых соединителей. Эти соединители определяют, как настраиваются и поддерживаются аутентификация, конвейеры и целевые таблицы. Для источников SaaS основными частями являются подключение (для проверки подлинности), бессерверный конвейер приема данных и таблицы Delta, которые хранят принятые данные. Соединители базы данных включают те же компоненты, но также полагаются на шлюз загрузки, который работает на классических вычислительных ресурсах и временную область хранения в каталоге Unity для временного размещения извлеченных данных. Оркестрация обрабатывается с помощью заданий Databricks, а управление доступом и аудит осуществляется с помощью каталога Unity.
Использование управляемых соединителей позволяет планировать, перезапускать и масштабировать конвейеры данных без необходимости писать пользовательский код ингестирования. Поддерживается инкрементальная загрузка, что позволяет уменьшить нагрузку на источники данных при сохранении актуальности таблиц. Этот подход подчеркивает согласованное управление, обработку схем и мониторинг в разных источниках данных.
Доступны следующие управляемые соединители:
- Google Analytics
- Salesforce
- Отчёты системы Workday
- SQL Server
- ServiceNow
- SharePoint
Отправка файлов в Azure Databricks
Вы можете импортировать локальные CSV-файлы, TSV, JSON, XML, Avro, Parquet или обычные текстовые файлы в Databricks, чтобы создать таблицу Delta. Этот подход предназначен для небольших файлов (менее 2 ГБ), передаваемых непосредственно с компьютера. Сжатые архивы, такие как ZIP или TAR, не поддерживаются. Во время отправки Databricks предоставляет предварительную версию до 50 строк, и вы можете настроить параметры форматирования, чтобы гарантировать правильность распознавания столбцов и типов данных в CSV-файлах или JSON.
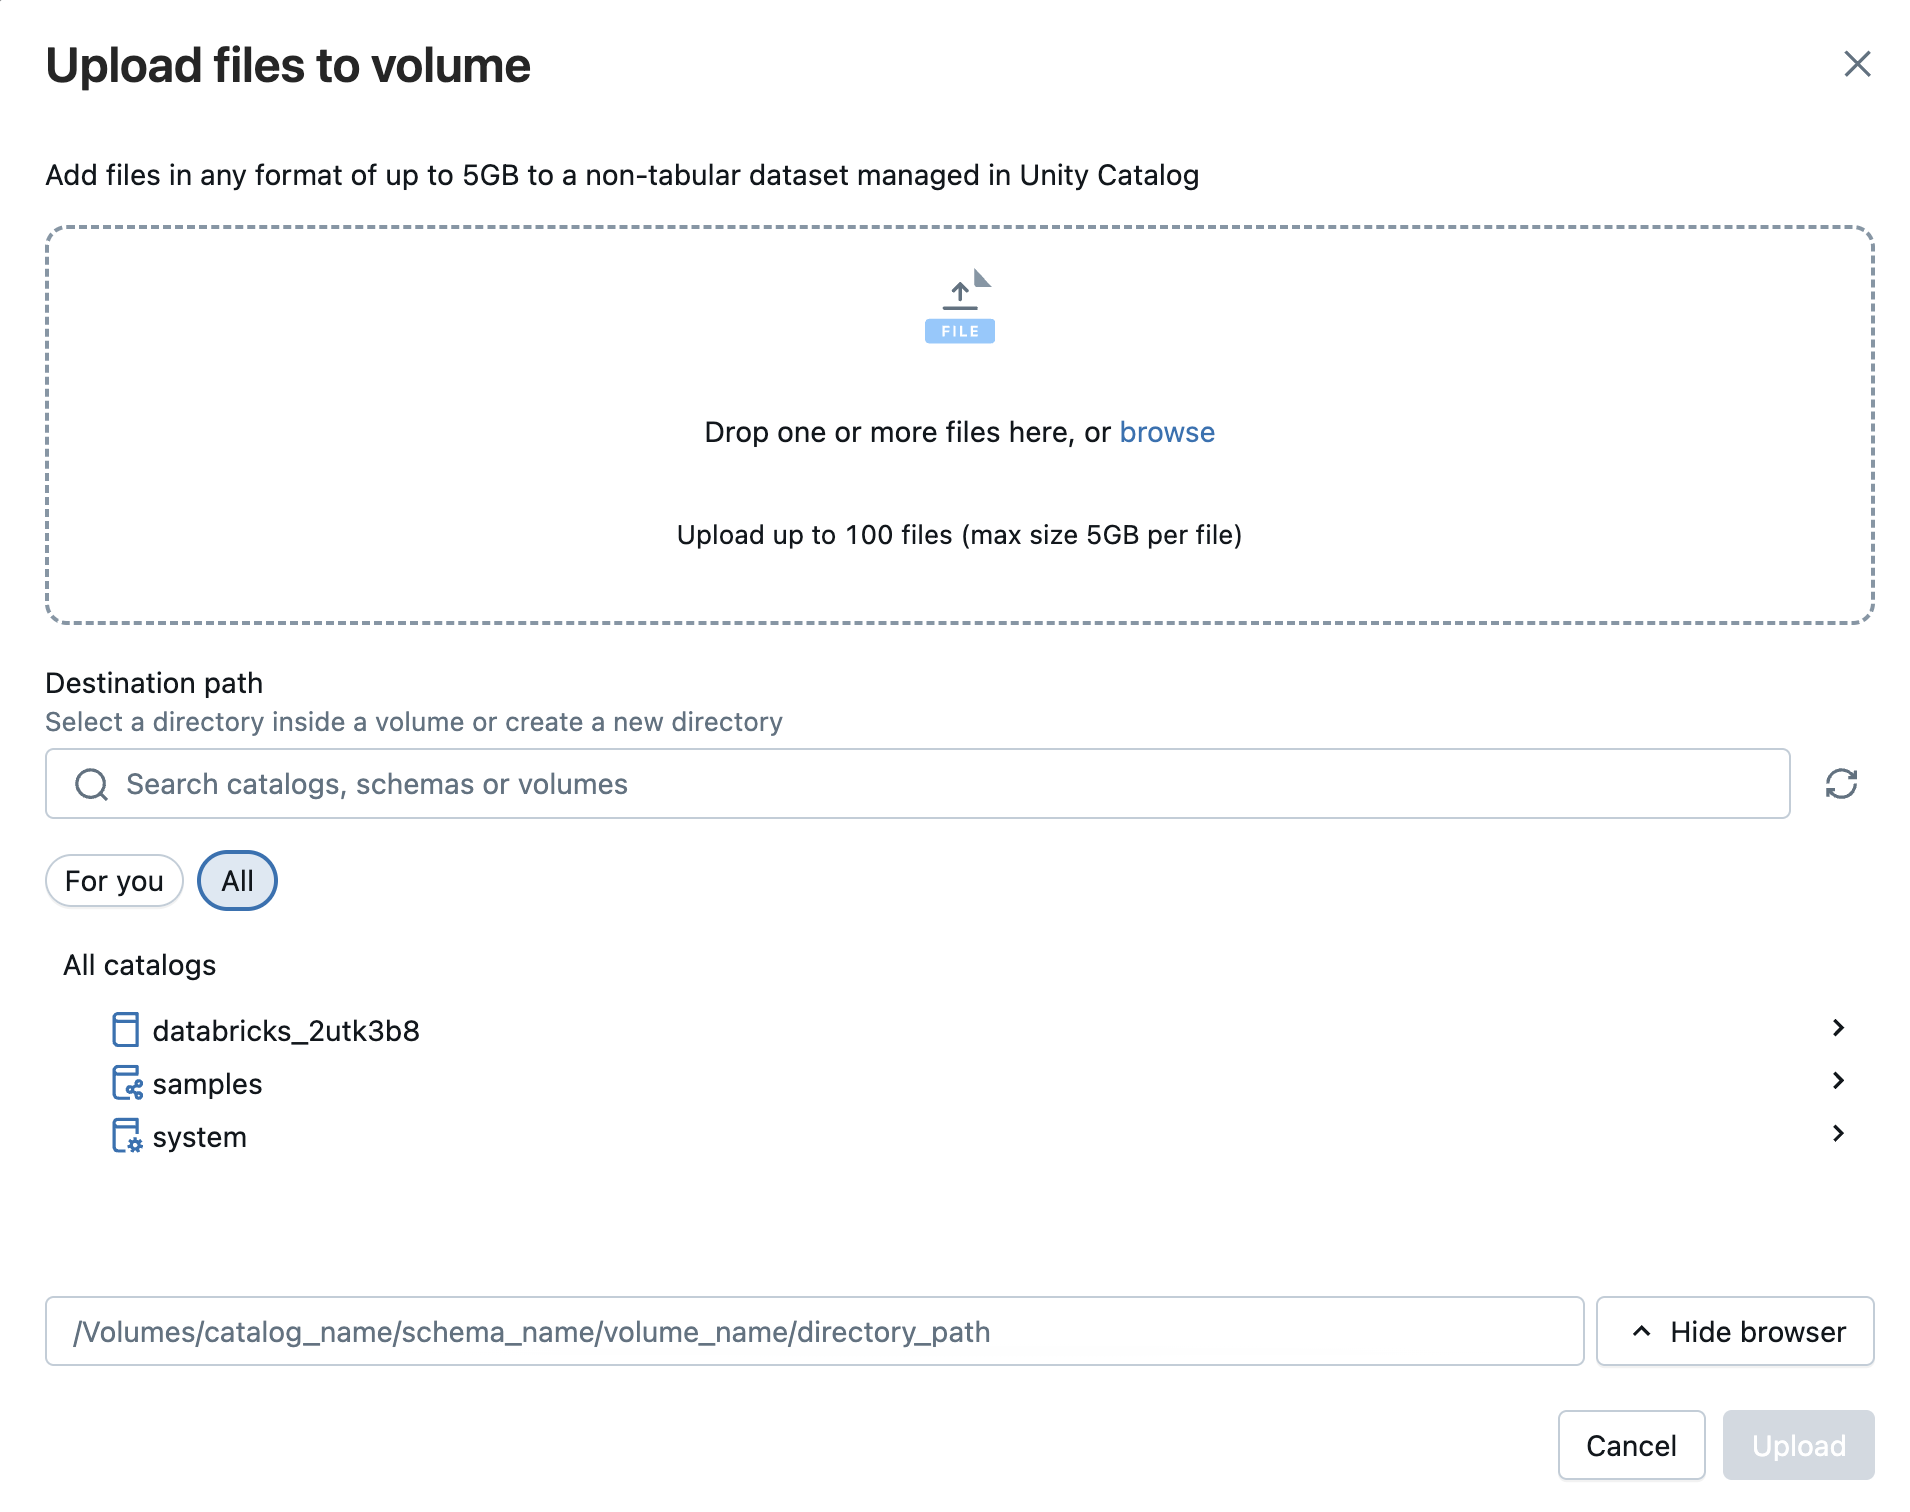
Вы также можете загружать файлы любого формата (структурированные, полуструктурированные или неструктурированные) в том. Том — это объект каталога Unity Catalog, который обеспечивает управление для нетабличных наборов данных и представляет логическое пространство в облачном объектном хранилище. Тома позволяют получать доступ, хранить, упорядочивать и вводить правила управления для файлов. Существует два типа томов:
- Управляемые дисковые пространства: управляемое компанией Databricks хранилище для простых случаев использования.
- Внешние тома: управление, применяемое к существующим расположениям облачного хранилища объектов.
Замечание
Параметр DBFS позволяет использовать классическую загрузку файлов в файловую систему Databricks. Это больше не поддерживается.
Прием файлов с помощью API Apache Spark
Apache Spark — это собственная платформа вычислений для Azure Databricks, и она поддерживает API для нескольких языков программирования, таких как Scala, Java, PySpark (оптимизированный для Spark вариант Python) и SQL. Для простого приема данных в удаленном хранилище можно написать код, который подключается к и импортирует необходимые данные.
Ниже приведен пример использования wget для извлечения удаленного файла в /tmp/ на узле драйвера, используйте Spark для чтения из локального пути, а затем сохраните его в виде таблицы Delta в Databricks:
# Step 1: Use wget to download the file (e.g., a CSV from a public URL)
# In Databricks, prefix shell commands with "!"
!wget https://<location>/airtravel.csv -O /tmp/airtravel.csv

# Step 2: Load the downloaded file into a Spark DataFrame
df = spark.read.format("csv") \
    .option("header", "true") \
    .option("inferSchema", "true") \
    .load("file:/tmp/airtravel.csv")

# Step 3: Preview the data
df.show(5)

# Step 4: Save as a Delta table
df.write.format("delta").mode("overwrite").saveAsTable("default.airtravel")
Загрузка данных с помощью COPY INTO с использованием учетной записи службы
Вы можете использовать команду COPY INTO для загрузки данных из контейнера Azure Data Lake Storage (ADLS) в таблицу в Databricks SQL в вашей учетной записи Azure.
COPY INTO my_json_data
FROM 'abfss://container@storageAccount.dfs.core.windows.net/jsonData'
FILEFORMAT = JSON;
Декларативные конвейеры Lakeflow
Декларативные конвейеры Lakeflow — это декларативная платформа для разработки и запуска конвейеров данных пакетной и потоковой передачи в SQL и Python. Она поддерживает автоматическую оркестрацию, повторные попытки, изоляцию ошибок, эволюцию схемы, добавочную обработку и запись измененных данных CDC типа 1 и 2.
Поток — это базовая концепция обработки данных в Декларативных конвейерах Lakeflow, которая поддерживает потоковую передачу и пакетную семантику. Поток считывает данные из источника, применяет определяемую пользователем логику обработки и записывает результат в целевой объект.
Вы также можете управлять качеством данных с ожиданиями конвейера, которые позволяют определять правила проверки, обеспечивающие соответствие данных необходимым стандартам, прежде чем они будут записаны в место назначения.
Ниже приведен пример декларативного конвейера:
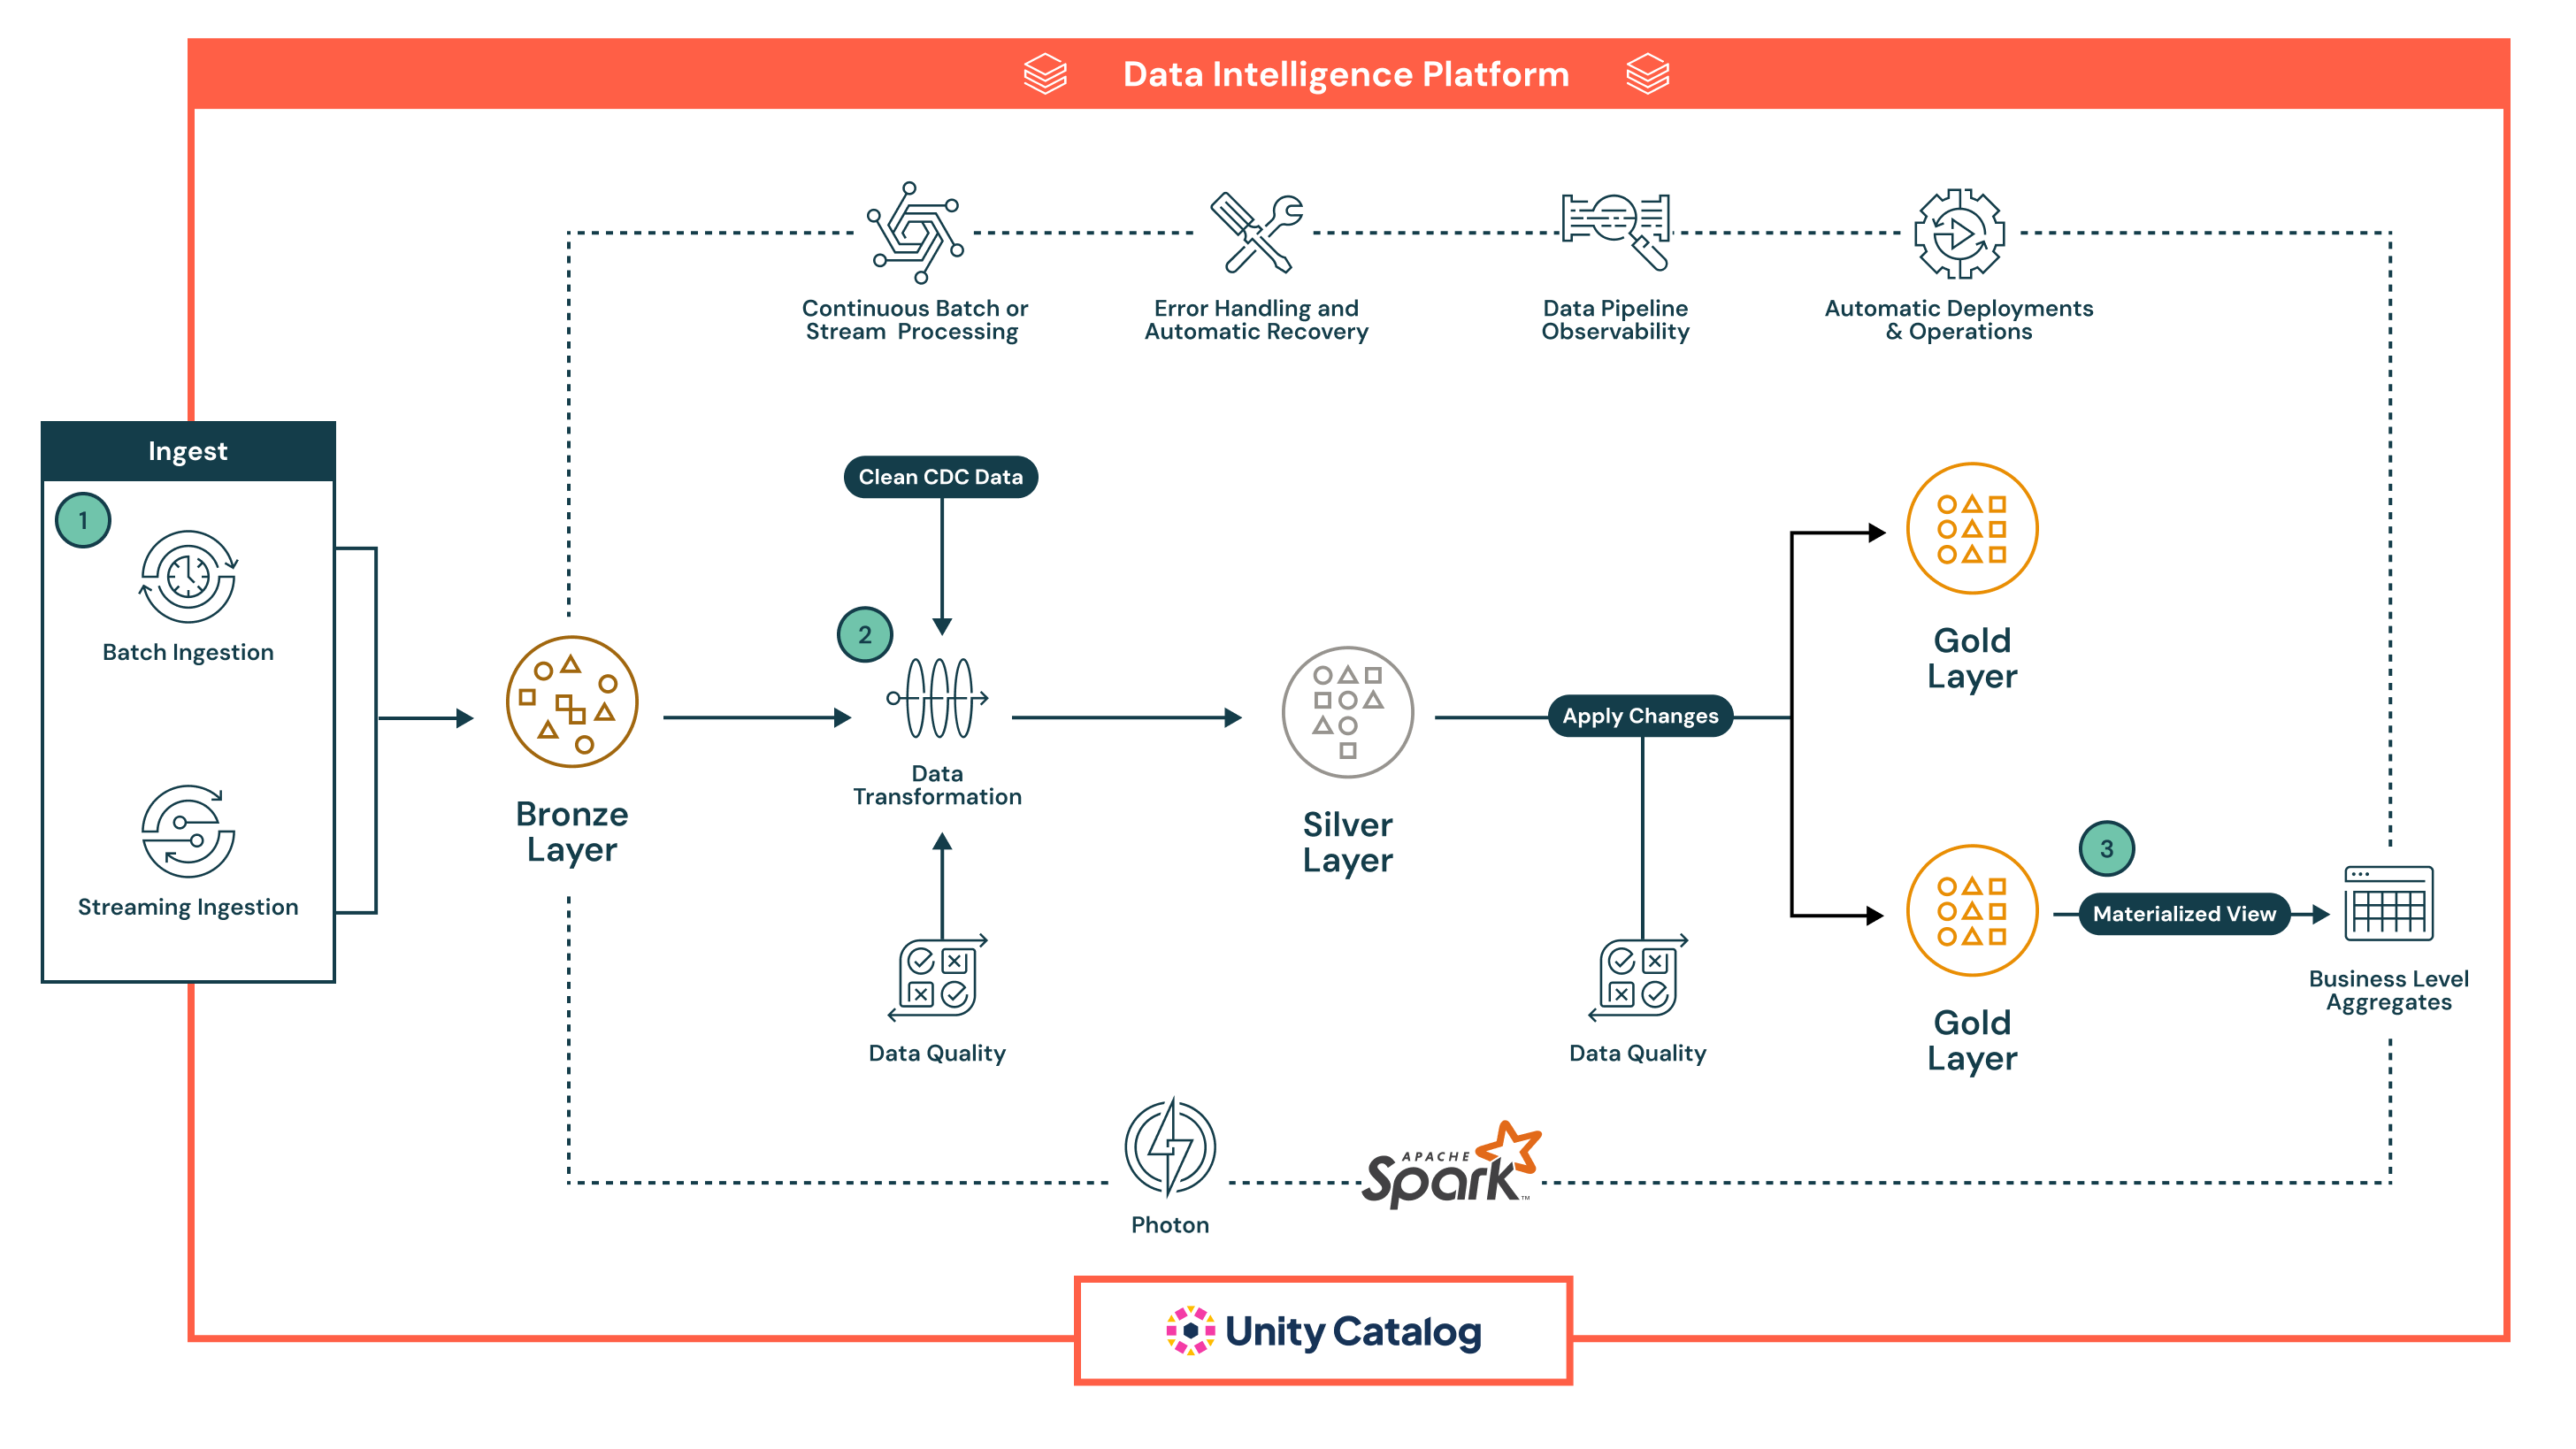
В этом примере данные сначала попадают в бронзовый слой в необработанном виде для получения родословной и безопасной повторной обработки, затем переходят в серебряный слой, где они очищаются, обогащаются, проверяются с помощью встроенных проверок качества и обрабатываются на масштабе с помощью Spark, прежде чем данные достигают золотого слоя, который предоставляет подготовленные наборы данных, готовые к бизнес-использованию для бизнес-аналитики, машинного обучения и расширенных вариантов использования, таких как отслеживание истории.
Фабрика данных Azure
Фабрика данных Azure (ADF) позволяет копировать данные в Azure Databricks Delta Lake и из нее с помощью встроенного действия копирования. Когда выступает в роли источника, ADF может извлекать данные из таблиц Delta в Databricks и перемещать их в поддерживаемые приемники; когда выступает в роли приемника, ADF может загружать данные в таблицы Delta Lake из поддерживаемых источников.
Перемещение данных осуществляется путем вызова кластера Databricks для обработки передачи, а ADF поддерживает как среды выполнения интеграции Azure, так и локальную среду выполнения интеграции в зависимости от среды.
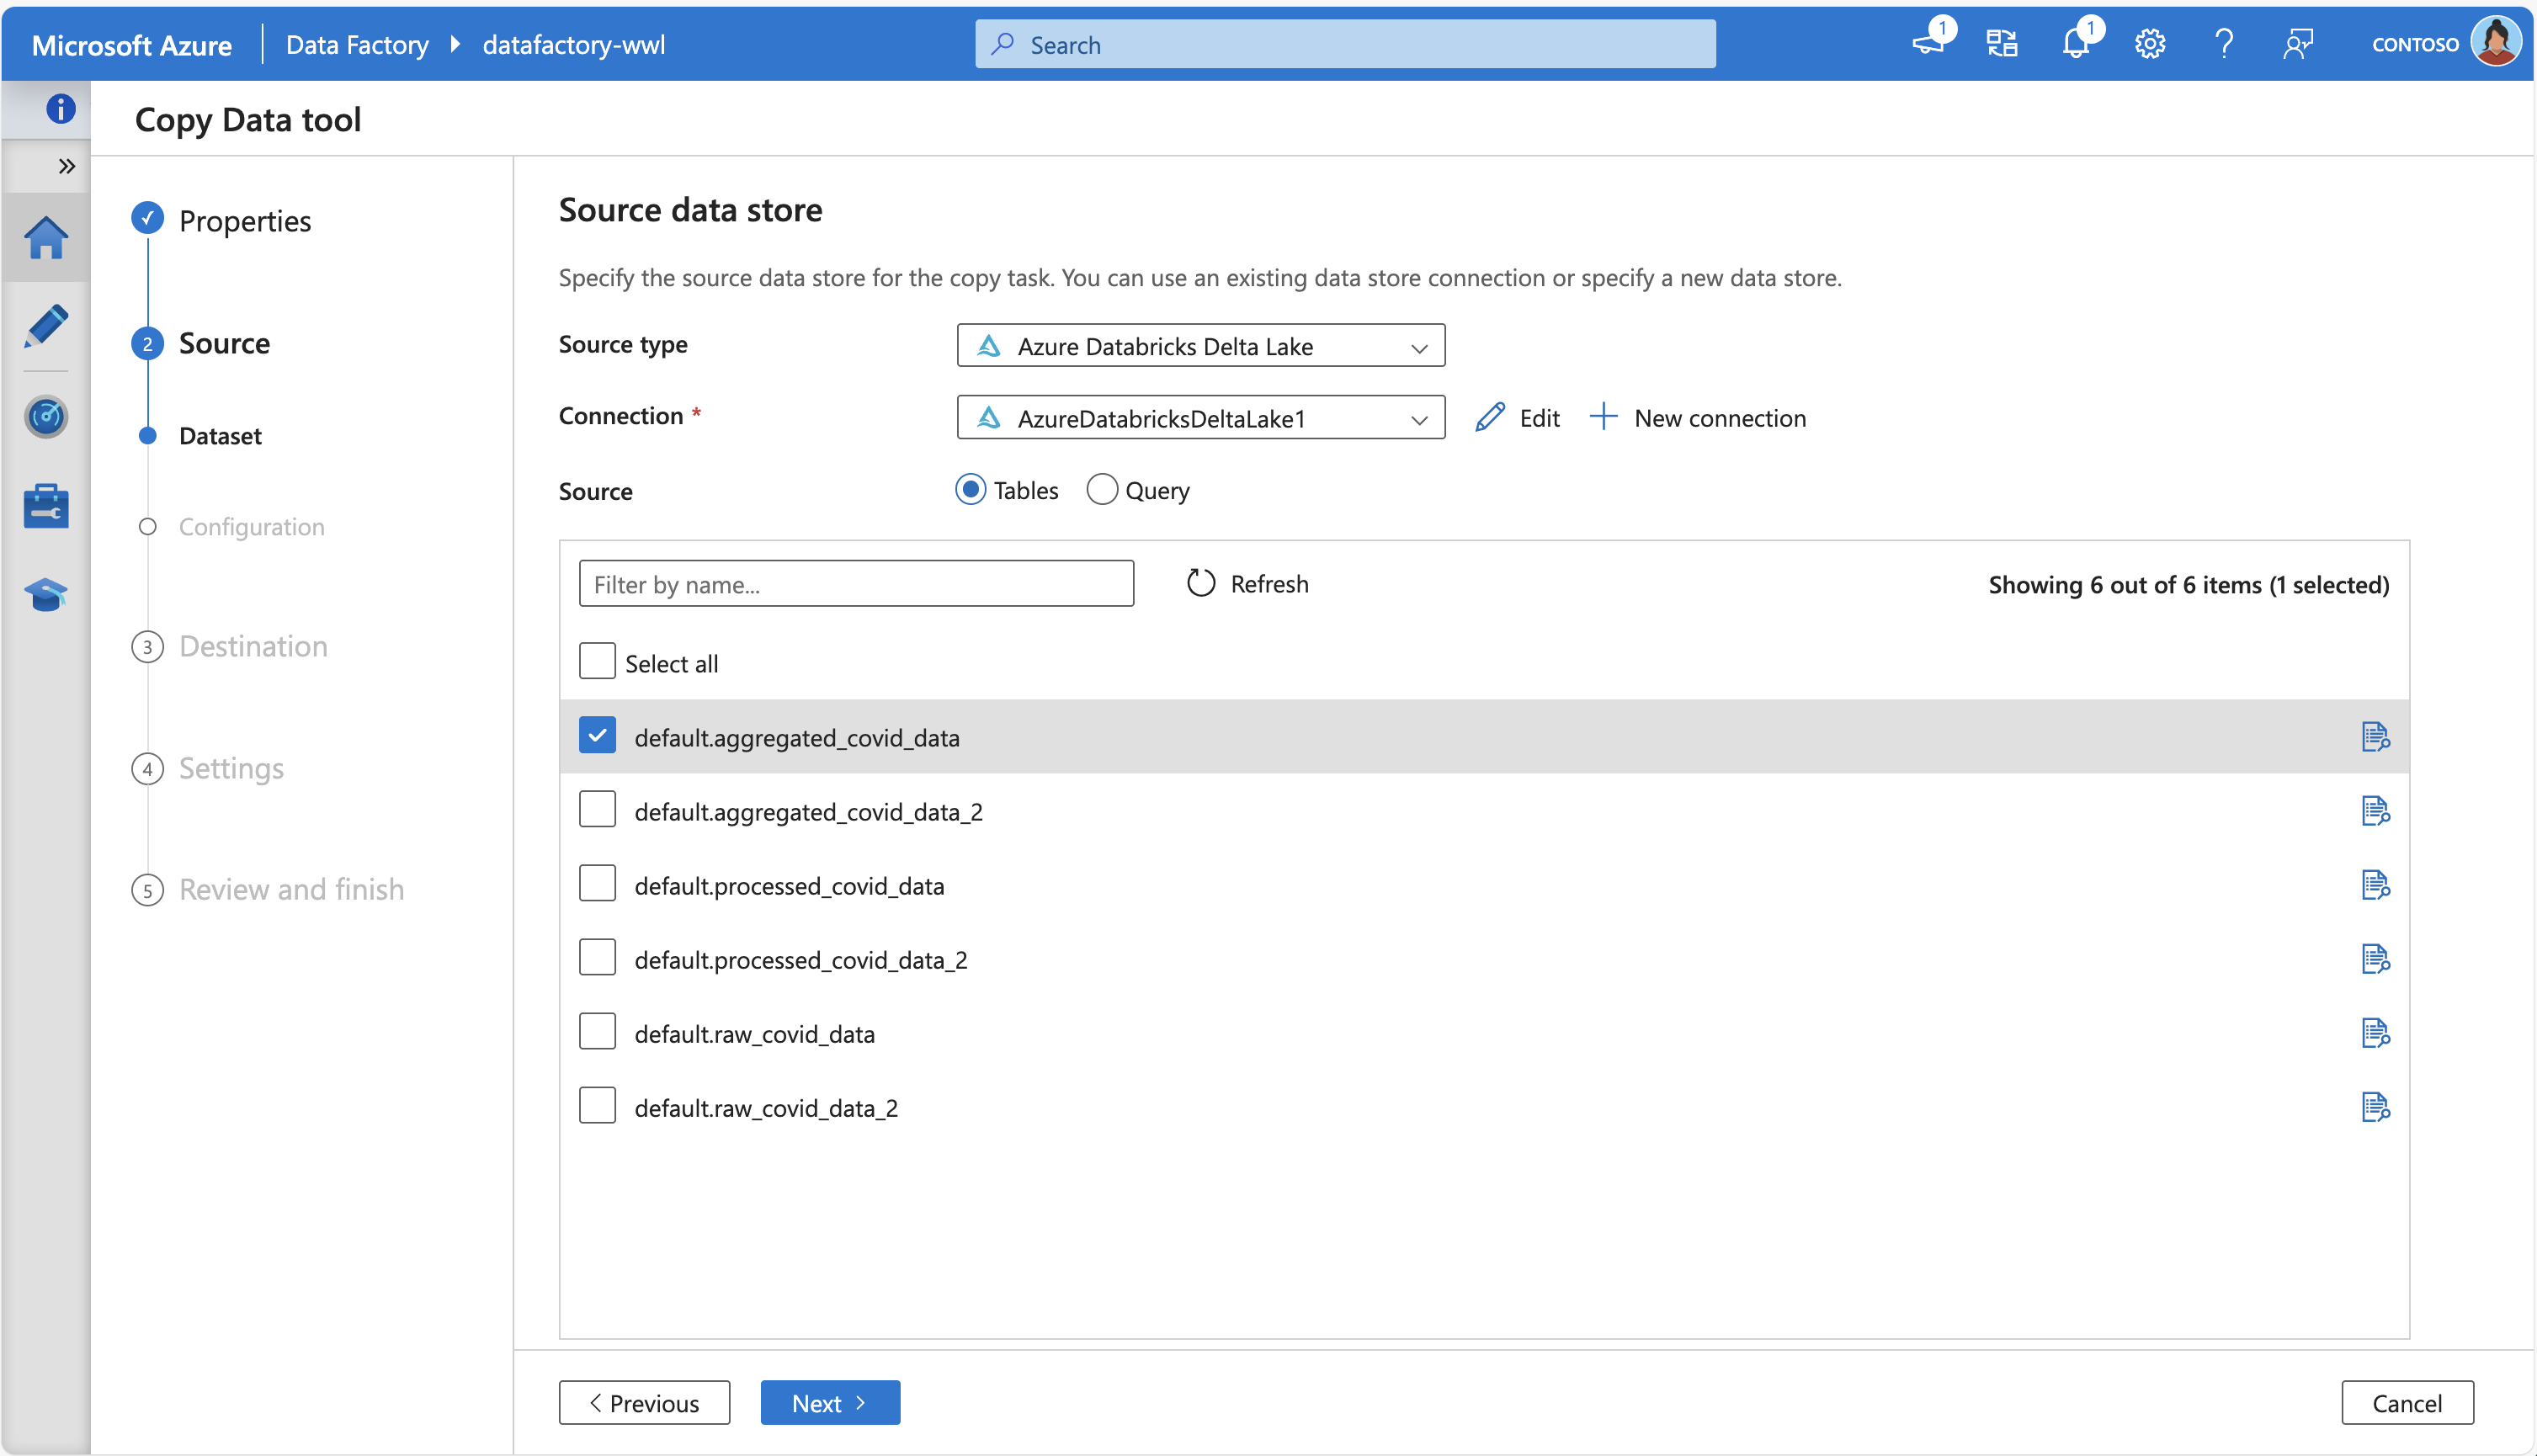
На следующем снимке экрана показан инструмент копирования данных фабрики данных Azure, подключающийся к Azure Databricks Delta Lake для получения некоторых исходных таблиц:
Кроме того, потоки данных сопоставления ADF предлагают интерфейс ETL без написания кода: они могут извлекать данные из и записывать данные в формат Delta в Azure Storage, позволяя выполнять преобразования без написания кода, в управляемой среде выполнения интеграции Azure.
Центры событий Azure и Центры Интернета вещей
Для приема данных в режиме реального времени центры событий Azure и Центры Интернета вещей являются наиболее подходящими вариантами. Они позволяют передавать данные непосредственно в Azure Databricks, позволяя обрабатывать и анализировать данные по мере поступления. Прием и анализ данных в режиме реального времени полезен для таких сценариев, как мониторинг событий в реальном времени или отслеживание данных устройств Интернета вещей (IoT).
Центры событий Azure имеют конечную точку, совместимую с Kafka, которая работает с соединителем Структурированной потоковой передачи Kafka в Databricks Runtime. Вы можете настроить декларативные конвейеры Lakeflow для подключения к экземпляру Event Hubs и использования событий из темы.