Not
Bu sayfaya erişim yetkilendirme gerektiriyor. Oturum açmayı veya dizinleri değiştirmeyi deneyebilirsiniz.
Bu sayfaya erişim yetkilendirme gerektiriyor. Dizinleri değiştirmeyi deneyebilirsiniz.
Genel Bakış
Azure Content Understanding analiz özellikleri yapılandırılmamış verileri yapılandırılmış, makine tarafından okunabilir bilgilere dönüştürmenize yardımcı olur. Yapısal ilişkilerini korurken öğeleri hassas bir şekilde tanımlayıp ayıklayarak, çok çeşitli uygulamalar için güçlü işleme iş akışları oluşturabilirsiniz.
contents türüne document sahip nesne, belge, resim, metin ve yapılandırılmış dosyalar gibi farklı giriş dosyaları aralığı için çıkışı destekler. Dosyalarınızdan anlamlı içerik ayıklamak, belge yapılarını korumak ve verilerinizin tüm potansiyelini ortaya çıkarmak için bu çıkışları kullanabilirsiniz.
Belge içerik türü, aşağıdaki gibi giriş dosyaları için çıkış içerir:
- Belgeler: PDF'ler, Word belgeleri, PowerPoint sunuları ve Excel elektronik tabloları
- Şekiller: Fotoğraflar, taranan belgeler, grafikler ve diyagramlar
- Metin dosyaları: Düz metin, HTML, Markdown ve RTF
- Yapılandırılmış içerik: XML, JSON, CSV ve TSV dosyaları
- E-posta: EML ve MSG ileti biçimleri
Desteklenen dosya türleri, dosya boyutu sınırları ve diğer kısıtlamalar hakkında daha fazla bilgi için bkz. Hizmet kotaları ve sınırları.
JSON yanıt yapısı
Content Understanding API'sinde analiz sonuçları yapılandırılmış bir JSON biçiminde döndürülüyor. İşte kap/yapıların genel yapısı:
{
  "id": "10a01d32-e21e-46e3-bb5c-361375f184de",
  "status": "Succeeded",
  "result": {
    "analyzerId": "my-analyzer",
    "apiVersion": "2025-11-01",
    "createdAt": "2025-06-18T22:50:34Z",
    "warnings": [],
    "contents": [
      {
        "markdown": "# Example Document\n\n...",
        "fields": { /* extracted field values */ },
        "kind": "document",
        "startPageNumber": 1,
        "endPageNumber": 2,
        "unit": "inch",
        "pages": [ /* page-level elements */ ],
        "paragraphs": [ /* paragraph elements */ ],
        "sections": [ /* section elements */ ],
        "tables": [ /* table elements */ ],
        "figures": [ /* figure elements */ ],
        "signatures": [ /* signature elements */ ],
        "hyperlinks": [ /* hyperlink elements */ ],
        "annotations": [ /* annotation elements */ ],
        "metadata": { /* document metadata */ }
      }
    ]
  }
}
Belge öğeleri
Belge analizi aracılığıyla aşağıdaki belge öğelerini ayıklayabilirsiniz:
- Markdown
- Sayfa nesneleri
- Belge yapısı
- Belge meta verileri
Tüm içerik ve düzen öğeleri geçerli değildir veya şu anda tüm belge dosyası türleri tarafından desteklenmez.
Markdown içerik öğeleri
Content Understanding, özgün belgenin yapısını koruyan zengin biçimlendirilmiş Markdown oluşturur. Bu nedenle, büyük dil modelleri yapay zeka destekli analiz ve oluşturma görevleri için belge bağlamı ve hiyerarşik ilişkileri daha iyi anlayabilir. Markdown, içerik olarak sözcüklere, seçim işaretlerine, barkodlara, formüllere ve görüntülere ek olarak hem görsel işleme hem de makine işleme için bölümler, tablolar ve sayfa meta verileri içerir. Content Understanding'in Markdown'daki içerik ve düzen öğelerini nasıl temsil ettiği hakkında daha fazla bilgi edinin.
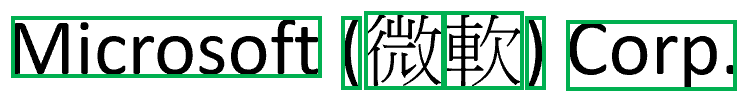
Kelime
Sözcük, bir dizi karakterden oluşan bir içerik öğesidir. Unicode Standart Ek #29 sözcük sınırlarını tanımlar. Latin dillerinde sözcükler, boşluklar araya girmeden bile noktalama işaretlerinden ayrılabilir. Çince gibi bazı dillerde, anlam sınırlarında sözcük kesmeyi etkinleştirmek için ek sözcük sözlükleri kullanılır. Daha fazla bilgi için bkz . Sınır analizi.
JSON örneği:
{
  "words": [
    {
      "content": "Example",
      "span": {
        "length": 7
      },
      "confidence": 0.992,
      "source": "D(1,1.265,1.0836,2.4972,1.0816,2.4964,1.4117,1.2645,1.4117)"
    }
  ]
}
Seçim işaretleri
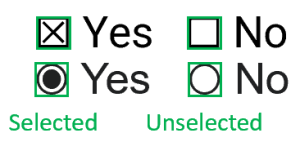
Seçim işareti, seçimin durumunu gösteren görsel bir karakteri temsil eden bir içerik öğesidir. Seçim işaretleri belgede onay kutuları, onay işaretleri veya düğmeler olarak görünebilir. Durumu belirtmek için farklı görsel gösterime sahip bir seçim işaretini seçebilir veya temizleyebilirsiniz. Seçim işaretleri, Unicode karakterleri ☒ (seçili) ve ☐ (temizlenmiş) kullanılarak belge çözümleme sonucunda sözcükler olarak kodlanır.
Content Understanding, tablo hücresi içindeki onay işaretlerini seçili durumda seçim işaretleri olarak algılar. Boş tablo hücrelerini temizlenmiş durumda seçim işaretleri olarak algılamaz.
JSON örneği:
{
  "words": [
    {
      "content": "☒",
      "span": {
        "length": 1
      },
      "confidence": 0.983,
      "source": "D(1,1.258,2.7952,1.3705,2.7949,1.371,2.9098,1.2575,2.9089)"
    }
  ]
}
Barkodlar
Barkod, hem doğrusal (ÖRNEĞIN, UPC veya EAN) hem de iki boyutlu (QR veya MaxiCode gibi) barkodları açıklayan bir içerik öğesidir. Content Understanding, algılanan türünü ve ayıklanan değerini kullanarak barkodları temsil eder. Şu anda aşağıdaki barkod biçimleri desteklenmektedir:
| Barkod türü | Açıklama |
|---|---|
QRCode |
ISO/IEC 18004:2015'te tanımlandığı gibi QR kodu |
PDF417 |
ISO 15438'de tanımlandığı gibi PDF417 |
UPCA |
GS1 12 basamaklı Evrensel Ürün Kodu |
UPCE |
GS1 6 basamaklı Evrensel Ürün Kodu |
Code39 |
ISO/IEC 16388:2007'de tanımlandığı gibi Kod 39 barkodu |
Code128 |
ISO/IEC 15417:2007'de tanımlandığı gibi Kod 128 barkodu |
EAN8 |
GS1 8 basamaklı Uluslararası Makale Numarası (Avrupa Makale Numarası) |
EAN13 |
GS1 13 basamaklı Uluslararası Makale Numarası (Avrupa Makale Numarası) |
DataBar |
GS1 DataBar barkodu |
Code93 |
ANSI/AIM BC5-1995'te tanımlandığı gibi Kod 93 barkodu |
Codabar |
ANSI/AIM BC3-1995'te tanımlandığı gibi Codabar barkodu |
DataBarExpanded |
GS1 DataBar Genişletilmiş barkod |
ITF |
ANSI/AIM BC2-1995'te tanımlandığı üzere "2/5 Birbirine Katlanmış Barkod (ITF)" |
MicroQRCode |
ISO/IEC 23941:2022'de tanımlanan mikro QR kodu |
Aztec |
ISO/IEC 24778:2008'de tanımlandığı gibi Aztec kodu |
DataMatrix |
ISO/IEC 16022:2006'da tanımlanan veri matrisi kodu |
MaxiCode |
Iso/IEC 16023:2000'de tanımlandığı gibi MaxiCode |
JSON örneği:
{
  "barcodes": [
    {
      "kind": "Code39",
      "value": "Hello World",
      "source": "D(1,2.5738,4.8186,3.8617,4.8153,3.8621,4.9894,2.5743,4.9928)",
      "span": {"offset": 192, "length": 10 },
      "confidence": 0.977
    }
  ]
}
Formüller
Formül, belgedeki matematiksel ifadeleri temsil eden bir içerik öğesidir. Diğer metinlerle eklenmiş bir satır içi formül veya bir satırın tamamını kaplayan bir görüntüleme formülü olabilir. Çok satırlı formüller, matematiksel ilişkileri korumak için paragraflar halinde gruplandırılmış birden çok görüntüleme formülü öğesi olarak temsil edilir.
Formül, belgedeki yerleşimine bağlı olarak inline veya display türünde olabilir.
JSON örneği:
{
  "formulas": [
    {
      "kind": "inline",
      "value": "x = \\frac { - b \\pm \\sqrt { b ^ { 2 } - 4 a c } } { 2 a }",
      "confidence": 0.708,
      "source": "D(1,3.4282,7.0195,4.0452,7.0307,4.0425,7.1803,3.4255,7.1691)",
      "span": {
        "offset": 394,
        "length": 51
      }
    }
  ]
}
Şekiller
Şekil, belgedeki eklenmiş bir görüntüyü, şekli veya grafiği temsil eden bir içerik öğesidir. Content Understanding, algılanan şekillerin özetini oluşturur, seçili görüntüleri chart.js gösterimine dönüştürür ve görüntülerden ekli metinleri ve ilişkili açıklamalı alt yazıları ve dipnotları ayıklar. Grafikler, şekil içeriğinde chart.js sözdizimi kullanılarak gösterilir ve diyagramlar ise şekil içeriğinde mermaid sözdizimindeki dizeler kullanılarak gösterilir. Bu, enableFigureAnalysis ve enableFigureDescription öğelerini true olarak ayarlayarak çözümleyici yapılandırmasında etkinleştirebileceğiniz isteğe bağlı bir özelliktir.
Şu anda aşağıdaki şekil türleri desteklenmektedir:
| Şekil türü | Temsil |
|---|---|
Bar chart |
Chart.js |
Line chart |
Chart.js |
Pie chart |
Chart.js |
Radar chart |
Chart.js |
Scatter chart |
Chart.js |
Bubble chart |
Chart.js |
Quadrant chart |
Chart.js |
Mixed chart (e.g. combined bar and line chart) |
Mermaid.js |
Flow chart |
Mermaid.js |
Sequence diagrams |
Mermaid.js |
Gantt chart |
Mermaid.js |
JSON örneği:
{
  "figures": [
     {
      // enableFigureDescription = True
      "description": "This figure illustrates the sales revenue over the year 2023.",

      // enableFigureAnalysis = True
      "kind": "chart",
      "content": {
        "type": "line",
        "data": {
          "labels": ["January", "February", "March", "April", "May", "June", "July"],
          "datasets": [
            {
              "label": "A",
              "data": [93, -29, -17, -8, 73, 98, 40]
            },
            {
              "label": "B",
              "data": [20, 85, -79, 93, 27, -81, -22]
            }
          ]
        },
        "options": {
          "title": { "text": "Title" }
        }
      }
    },
    {
      "kind": "mermaid",
      "content": "xychart-beta\n    title \"Sales Revenue\"\n    x-axis [jan, feb, mar, apr]..."
    },
  ]
}
İmzalar
İmza, belgede algılanan bir imzayı temsil eden bir içerik öğesidir. İmza algılama, imza bölgelerini bulmanız gereken sözleşmeleri, faturaları ve yasal veya İk belgelerini işlemenize yardımcı olur. Her imza belgedeki konumunu içerir ve imza bölgesinin içinde tanınan tüm metinler ilişkili öğeler aracılığıyla yakalanır.
JSON örneği:
{
  "signatures": [
    {
      "id": "1.1",
      "source": "D(1,5.4868,7.7451,6.9187,7.7397,6.9146,8.6099,5.491,8.6152)",
      "span": {
        "offset": 1498,
        "length": 20
      },
      "elements": [
        "/paragraphs/48"
      ]
    }
  ]
}
Bir imza, alt bilgi gibi tanınan bir sayfa bölgesinde göründüğünde, bu bölgeyi tanımlayan bir role özellik de içerebilir.
Hyperlinks
Köprü, belgedeki web sayfası gibi başka bir kaynağa bağlanan ekli bağlantıyı temsil eden bir içerik öğesidir. Content Understanding, gömülü bağlantısını kullanarak köprüleri temsil eder.
JSON örneği:
{
  "hyperlinks": [
        {
          "content": "Microsoft",
          "url": "https://www.microsoft.com",
          "span": {...},
          "source": "..."
        }
  ]
}
Açıklamalar
Ek açıklamalar , ana içeriğin kendisini değiştirmeden ek bilgi, açıklama veya geri bildirim sağlamak için belgedeki ek meta verilerdir. Başka bir deyişle, belirli içerik bölümlerini kapsayan ya da belirli sınırlayıcı kutulara başvurabilen birçok açıklama türü vardır. Aşağıda desteklediğimiz ek açıklama türlerinin listesi yer almaktadır.
Uyarı
Ek açıklamaların şu anda yalnızca dijital PDF girişlerinde desteklendiğini unutmayın.
| Açıklama türü |
|---|
highlight |
underline |
strikethrough |
rectangle |
circle |
drawing |
comments |
other |
JSON örneği:
{
  "annotations": [
    {
      "id": "underline-1",
      "kind": "underline",
      "spans": [...],
      "source": "D(pageNumber,l,t,w,h)",
      "comments": [
        {
          "message": "Hi",
          "author": "johndoe",
          "createdAt": "2023-10-01T12:00:00Z",
          "tags": ["approved"]
        }
      ]
      "author": "paulhsu",
      "createdAt": "2023-10-01T12:00:00Z",
      "lastModifiedAt": "2023-10-02T12:00:00Z",
      "tags": [ ... ],
    }
  ]
}
Düzen öğeleri
Belge düzeni öğeleri , içeriği yorumlamaya yardımcı olan sayfalar, tablolar, paragraflar, satırlar, tablolar, bölümler ve genel yapı gibi görsel ve yapısal bileşenlerdir. Bu öğelerin ayıklanması, araçların bilgi alma, anlamsal anlama ve veri yapısı gibi görevler için belgeleri verimli bir şekilde analiz etmelerini sağlar.
Sayfalar
Sayfa, genellikle bir kağıt sayfasının bir tarafına karşılık gelen bir içerik grubudur. İşlenen sayfa, belirtilen ünitedeki genişlik ve yükseklik ile karakterize edilir. Genel olarak görüntüler piksel kullanırken PDF'ler inç kullanır.
angle özelliği, döndürülebilecek sayfalar için genel metin açısını derece cinsinden açıklar.
Excel gibi elektronik tablolar için her sayfa bir sayfaya eşlenir. PowerPoint gibi sunularda her slayt bir sayfaya eşlenir. HTML veya Word belgeleri gibi işleme olmadan yerel sayfa kavramı olmayan dosya biçimleri için, ana içeriğin tamamı tek bir sayfa olarak değerlendirilir.
JSON örneği:
{
  "pages": [
    {
      "pageNumber": 1,
      "angle": 0.0739153,
      "width": 8.5,
      "height": 11,
      "spans": [
        {
          "offset": 0,
          "length": 620
        }
      ],
      "words": [ /* array of word objects */ ],
      "barcodes": [ /* details of barcodes */ ],
      "lines": [ /* array of line objects */ ],
      "formulas": [ /* array of formula objects */ ]
    }
  ]
}
Paragraflar
Paragraf, mantıksal birim oluşturan sıralı bir satır dizisidir. Genellikle, çizgiler arasındaki ortak hizalamayı ve aralığı paylaşır. Paragraflar genellikle girintileme, eklenen aralık veya madde işaretleri/numaralandırma yoluyla sınırlandırılır. Bazı paragrafların belgede özel işlevsel rolleri vardır. Şu anda desteklenen roller sayfa üst bilgisi, sayfa alt bilgisi, sayfa numarası, başlık, bölüm başlığı, dipnot ve formül bloğunu içerir.
JSON örneği:
{
  "paragraphs": [
    {
      "role": "title",
      "content": "Example Document",
      "source": "D(1,1.264,1.0836,4.1584,1.0795,4.1589,1.4083,1.2644,1.4124)",
      "span": {
        "offset": 0,
        "length": 18
      }
    }
  ]
}
Satır
Satır, genellikle görsel boşluklarla ayrılmış ardışık içerik öğelerinin sıralı dizisidir. Aynı yatay düzlemde (satır) bulunan ancak tek bir görsel alandan daha fazla alanla ayrılan içerik öğeleri çoğunlukla birden çok satıra ayrılır. Bu özellik bazen bitişik içeriği ayrı satırlara böler. Ayrıca, birden çok sütuna veya hücreye bölünmüş metin içeriğinin temsilini de etkinleştirir. Dikey yazıdaki çizgiler dikey yönde algılandı.
JSON örneği:
{
  "lines": [
    {
      "content": "Example Document",
      "source": "D(1,1.264,1.0836,4.1583,1.0795,4.1589,1.4083,1.2645,1.4117)",
      "span": {
        "offset": 0,
        "length": 16
      }
    }
  ]
}
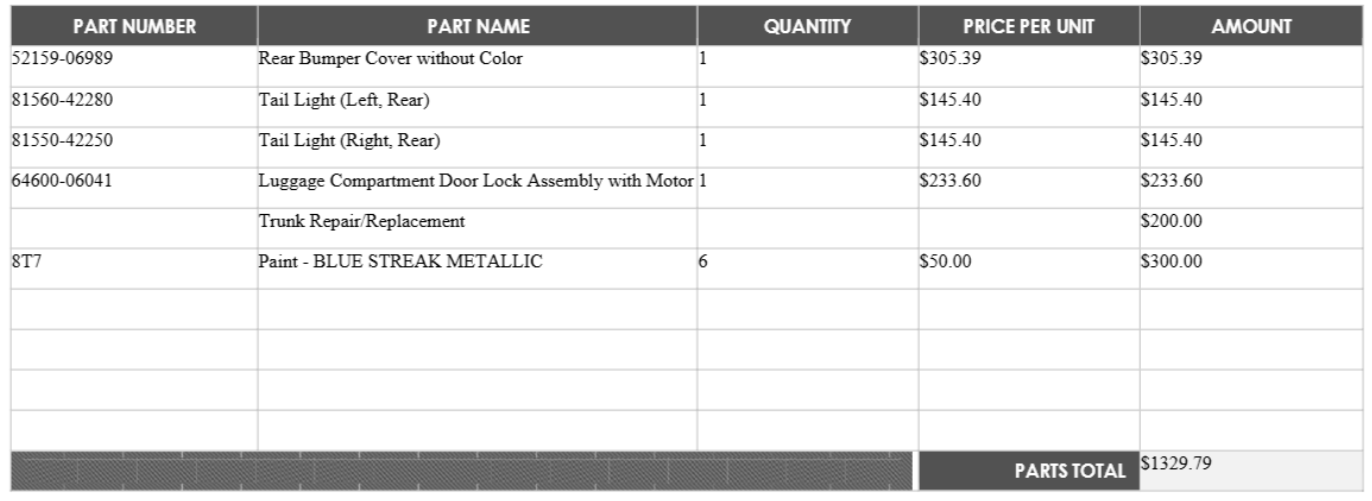
Tablolar
Tablo, içeriği kılavuz düzenindeki bir hücre grubu halinde düzenler. Satırlar ve sütunlar kılavuz çizgileri, renk şeritleri veya daha büyük aralıklarla görsel olarak ayrılmış olabilir. Tablo hücresinin konumu, satır ve sütun dizinleri aracılığıyla belirtilir. Bir hücre birden çok satıra ve sütuna yayılabilir.
Bir hücre, konumuna ve stiline göre genel içerik, satır üst bilgisi, sütun başlığı, saplama başı veya açıklama olarak sınıflandırılır:
- Satır üst bilgisi hücresi genellikle satırdaki diğer hücreleri açıklayan ilk hücredir.
- Sütun üst bilgisi hücresi genellikle sütundaki diğer hücreleri açıklayan ilk hücredir.
- Bir satır veya sütun, hiyerarşik içeriği açıklamak için birden çok üst bilgi hücresi içerebilir.
- Saplama kafası hücresi genellikle ilk satırdaki ve ilk sütun konumundaki hücredir. Hücre boş veya aynı satır/sütundaki üst bilgi hücrelerindeki değerleri açıklar.
- Açıklama hücresi genellikle tablonun en üst veya en alt kısmında görünür ve genel tablo içeriğini açıklar. Bazen tabloyu bölümlere ayırmak için tablonun ortasında görünebilir. Genellikle, açıklama hücreleri tek bir satırdaki birden çok hücreye yayılmıştır.
Tablo başlığı, tabloyu açıklayan içeriği belirtir. Bir tabloda dipnot kümesi de bulunabilir. Açıklama hücresinin aksine, resim yazısı genellikle kılavuz düzeninin dışındadır. Tablo dipnotları, tablonun içindeki içeriğe ek açıklama ekler ve genellikle dipnot simgeleriyle işaretlenir. Bunlar genellikle tablo kılavuzunun altında bulunur.
Tablo, belgenin ardışık sayfalarına yayılabilir. Bu durumda, sonraki sayfalardaki tablo devamlılıkları genellikle aynı sütun sayısını, genişliğini ve stillerini korur. Onlar genellikle sütun başlıklarını yineler. Genellikle, sayfa üst bilgileri, alt bilgiler ve sayfa numaraları dışında ilk tablo ile devamları arasında araya girip çıkan içerik bulunmaz.
Tablo, belgenin ardışık sayfalarına yayılabilir. Bu durumda, sonraki sayfalardaki tablo devamlılıkları genellikle aynı sütun sayısını, genişliğini ve stillerini korur. Onlar genellikle sütun başlıklarını yineler. Sayfa üst bilgileri, alt bilgiler ve sayfa numaraları dışında, genellikle ilk tablo ile devamları arasında araya giren bir içerik yoktur.
Uyarı
Tablolar için yayılma alanı hem temel içeriği hem de ilişkili açıklamalı alt yazılarını ve dipnotları kapsar.
JSON örneği:
{
  "tables": [
    {
      "rowCount": 6,
      "columnCount": 2,
      "cells": [
        {
          "kind": "columnHeader",
          "rowIndex": 0,
          "columnIndex": 0,
          "rowSpan": 1,
          "columnSpan": 1,
          "content": "Category",
          "source": "D(2,1.1674,5.0483,4.1733,5.0546,4.1733,5.2358,1.1674,5.2358)",
          "span": {
            "offset": 798,
            "length": 8
          },
          "elements": [
            "/paragraphs/7"
          ]
        }
      ],
      "source": "D(2,1.1566,5.0425,7.1855,5.0428,7.1862,6.1853,1.1574,6.1858)",
      "span": {
        "offset": 781,
        "length": 280
      },
      "caption": {
        "content": "Table 1: This is a table",
        "source": "D(2,1.1566,5.0425,7.1855,5.0428,7.1862,6.1853,1.1574,6.1858)",
        "span": {
          "offset": 335,
          "length": 30
        }
      }
    }
  ]
}
Bölümler
Bölüm, belge içinde hiyerarşik bir yapı oluşturan ilgili içerik öğelerinin mantıksal bir gruplandırmasıdır. Genellikle ilk paragraf olarak bölüm başlığıyla başlar. Bölüm, semantik ilişkileri koruyan iç içe yerleştirilmiş bir belge yapısı oluşturmak için alt bölümler içerebilir.
JSON örneği:
{
  "sections": [
    {
      "span": {
        "offset": 113,
        "length": 77
      },
      "elements": [
        "/paragraphs/3",
        "/paragraphs/4"
      ]
    }
  ]
}
Öğe özellikleri
Belgeler yapısal, metinsel ve formla ilgili öğelere ayrılmış çeşitli bileşenlerden oluşur. Bu öğeler, belgenin kuruluşunu ve sunumunu tanımlar. Daha fazla analiz veya uygulama için öğeleri sistematik olarak tanımlayıp ayıklayabilirsiniz.
Aralıklar
özelliği, span üst düzey markdown dize özelliğine karakter uzaklığı ve uzunluğu aracılığıyla belgedeki öğenin mantıksal konumunu belirtir. Varsayılan olarak, karakter uzaklıkları ve uzunlukları Python 3 tarafından kullanılan Unicode kod noktalarında döndürülür. Farklı karakter birimleri kullanan farklı geliştirme ortamlarını barındırmak için UTF16 kod birimlerinde (Java, JavaScript veya .NET) veya UTF8 baytlarında (Go, Rust, Ruby veya PHP) yayılma uzaklıklarını ve uzunluklarını döndürmek için sorgu parametresini belirtebilirsiniz stringEncoding .
Kaynak
source özelliği, kodlanmış bir dize kullanarak dosyadaki öğesinin görsel konumunu açıklar. Belgeler için kaynak dize aşağıdaki biçimlerden birindedir:
-
Sınırlayıcı çokgen:
D({pageNumber},{x1},{y1},{x2},{y2},{x3},{y3},{x4},{y4}) -
Eksene hizalanmış sınırlayıcı kutu:
D({pageNumber},{left},{top},{width},{height})
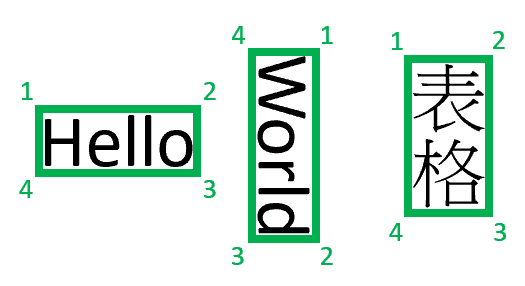
Sayfa numaraları bir dizine eklenir. Sınırlayıcı çokgen, öğenin doğal yönüne göre soldan başlayarak saat yönünde bir noktalar dizisini tanımlar. Dörtgenler için, noktalar sol üst, sağ üst, sağ alt ve sol alt köşeleri temsil eder. Her nokta, özelliği tarafından belirtilen uzunluk biriminde x,y koordinatını unit temsil eder. Genel olarak, görüntüler için ölçü birimi pikseldir. PDF'ler inç kullanır.
Uyarı
Şu anda Content Understanding sınırlayıcı çokgen olarak yalnızca dört noktalı dörtgen döndürür. Gelecekteki sürümler, eğri çizgiler veya üçgen olmayan görüntüler gibi daha karmaşık şekilleri açıklamak için farklı sayıda nokta döndürebilir. Şu anda, kaynak yalnızca işlenen dosyalardan (PDF/resim) öğeler için döndürülür.
Belge meta verileri
Content Understanding, kaynak belgeden yazar, oluşturma tarihi ve başlık gibi ekli meta verileri ayıklayabilir. Hizmet bu bilgileri her içerik öğesindeki bir metadata nesnede döndürür.
metadata nesnesi, dize anahtarlarının dize değerleriyle düz bir eşlemini oluşturur. Yalnızca ayıklanan değere sahip anahtarlar dahil edilir, bu nedenle anahtar kümesi belge ve dosya türüne göre değişir. Düz görüntü gibi kullanılabilir meta veri olmadığında, hizmet nesneyi atlar metadata .
Uyarı
Belge meta verileri API sürümünde kullanılabilir 2026-06-01-preview .
JSON örneği:
{
  "metadata": {
    "contentType": "application/pdf",
    "pageCount": "1",
    "author": "John Doe",
    "createdAt": "2026-06-05T16:17:45+08:00",
    "language": "en"
  }
}
Aşağıdaki tabloda, Content Understanding'in döndürebileceği meta veri anahtarları açıklanmaktadır. Kullanılabilir anahtarlar, dosya türüne ve kaynak belgede bulunan meta veriye bağlıdır.
| Key | Açıklama | Example |
|---|---|---|
contentType |
Belgenin MIME türü. | application/pdf |
createdAt |
ISO 8601 biçiminde oluşturma zaman damgası. E-posta iletileri için bu değer gönderme tarihidir. | 2025-03-30T05:01:00Z |
author |
Belge yazarı. | John Doe |
lastModifiedAt |
ISO 8601 biçiminde son değiştirilen zaman damgası. | 2025-04-01T10:30:00Z |
lastModifiedBy |
Belgeyi değiştiren son kişinin adı. | John Doe |
pageCount |
Toplam sayfa veya slayt sayısı. | 3 |
characterCount |
Toplam karakter sayısı. | 2379 |
wordCount |
Toplam sözcük sayısı. | 596 |
sourceContentEncoding |
IANA karakter kümeleri kayıt defterinden sonra kaynak belgenin karakter kodlaması. | UTF-8 |
title |
Belge başlığı. | Quarterly Report |
description |
Belge açıklaması veya özeti. | |
keywords |
Virgül ve boşlukla birleştirilmiş anahtar sözcükler. | finance, report |
language |
Kaynak belgede BCP-47 biçiminde bildirilen dil. | en-US |
identifier |
Benzersiz belge tanımlayıcısı (EPUB). | urn:isbn:9780123456789 |
publisher |
Belge yayımcısı (EPUB). | |
subject |
E-posta iletileri için konu satırı. | Quarterly Report |
messageFrom |
E-posta gönderen, RFC 5322 adres biçiminde. | Joe Public <john@example.com> |
messageTo |
Alıcılara e-posta gönder, virgül ve boşlukla birleştirilir. | Mary Smith <mary@x.test> |
messageCc |
Virgül ve boşlukla birleştirilen Bilgi alıcılarına e-posta gönderin. | |
messageBcc |
E-posta Gizli alıcıları, virgül ve boşlukla birleştirilir. |
Kullanılabilir anahtarlar dosya türüne bağlıdır. Örneğin, Office belgeleri (örneğin .docx, .xlsx, ve .pptx) author, createdAtve titleiçerebilir; PDF'ler author, , languageve pageCount; e-posta iletilerini (.eml ve .msg) içerebilir messageFrom, , messageTove subject; içerebilir ve çoğu görüntü biçimi yalnızca contentTypedöndürürken, TIFF de içerir pageCount.
İlgili içerik
- Content Understanding Studio'yu kullanarak belge içeriğinizi işlemeyi deneyin.
- Content Understanding Studio Hızlı Başlangıç Kılavuzu'na göz atın.
- Çözümleyici şablonlarını kullanarak belge içeriğini analiz etmeyi öğrenin.
- Görsel belge araması ile kod örneklerini gözden geçirin.
- Kod örneği çözümleyici şablonlarını gözden geçirin.
Tam JSON örneği
Aşağıdaki örnekte, bir belgenin çözümlenmesinden elde edilen tam JSON yanıt yapısı gösterilmektedir. Bu JSON, birden çok öğe türüne sahip bir PDF belgesini işlerken Content Understanding'in tam çıkışını temsil eder:
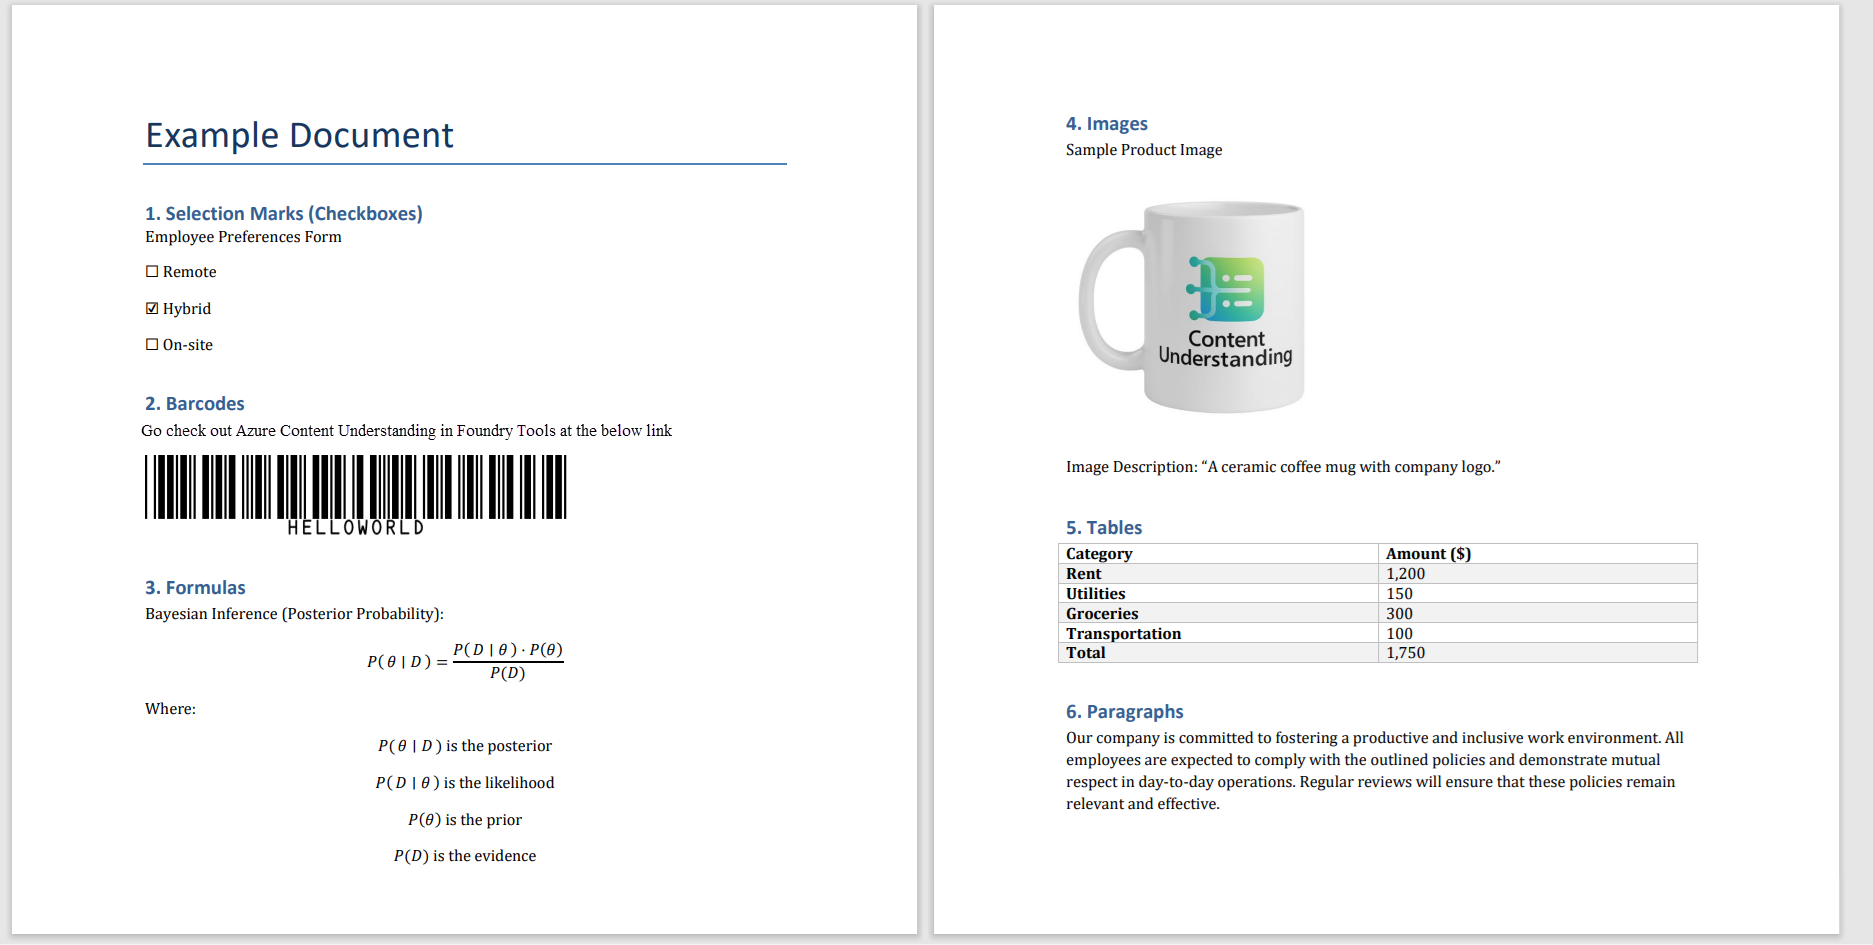
{
  "id": "10a01d32-e21e-46e3-bb5c-361375f184de",
  "status": "Succeeded",
  "result": {
    "analyzerId": "auto-labeling-model-1750287025291-104",
    "apiVersion": "2025-11-01",
    "createdAt": "2025-06-18T22:50:34Z",
    "warnings": [],
    "contents": [
      {
        "markdown": "# Example Document\n\n\n## 1. Selection Marks (Checkboxes)\n\nEmployee Preferences Form\n☐\nRemote\n☒\nHybrid\n☐\nOn-site\n\n\n## 2. Barcodes\n\nGo check out Azure Content Understanding at the below link\n\n\n## 3. Formulas\n\nBayesian Inference (Posterior Probability):\n\n$$P \\left( \\theta \\mid D \\right) = \\frac { P \\left( D \\mid \\theta \\right) \\cdot P \\left( \\theta \\right) } { P \\left( D \\right) }$$\n\nWhere:\n\n$$P \\left( \\theta \\mid D \\right)$$\nis the posterior\n\n$P \\left( D \\mid \\theta \\right)$ is the likelihood\n$P \\left( \\theta \\right)$ is the prior\n\n$$P \\left( D \\right) i s \\quad t h e \\quad e v i d e n c e$$\n\n<!-- PageBreak -->\n\n\n## 4. Images\n\nSample Product Image\n\n\n<figure>\n\nContent\nUnderstanding\n\n</figure>\n\n\nImage Description: \"A ceramic coffee mug with company logo.\"\n\n\n## 5. Tables\n\n\n<table>\n<tr>\n<th>Category</th>\n<th>Amount ($)</th>\n</tr>\n<tr>\n<td>Rent</td>\n<td>1,200</td>\n</tr>\n<tr>\n<td>Utilities</td>\n<td>150</td>\n</tr>\n<tr>\n<td>Groceries</td>\n<td>300</td>\n</tr>\n<tr>\n<td>Transportation</td>\n<td>100</td>\n</tr>\n<tr>\n<td>Total</td>\n<td>1,750</td>\n</tr>\n</table>\n\n\n## 6. Paragraphs\n\nOur company is committed to fostering a productive and inclusive work environment. All\nemployees are expected to comply with the outlined policies and demonstrate mutual\nrespect in day-to-day operations. Regular reviews will ensure that these policies remain\nrelevant and effective.\n",
        "fields": {
          "EmployeePreferences": {
            "type": "string",
            "valueString": "Hybrid",
            "spans": [
              {
                "offset": 94,
                "length": 6
              }
            ],
            "confidence": 0.987,
            "source": "D(1,1.4104,2.7836,1.8760,2.7823,1.8760,2.9377,1.4110,2.9396)"
          },
          "ImageDescription": {
            "type": "string",
            "valueString": "\"A ceramic coffee mug with company logo.\"",
            "spans": [
              {
                "offset": 722,
                "length": 41
              }
            ],
            "confidence": 0.958,
            "source": "D(2,2.5222,4.2511,5.3236,4.2497,5.3237,4.4422,2.5223,4.4436)"
          }
        },
        "kind": "document",
        "startPageNumber": 1,
        "endPageNumber": 2,
        "unit": "inch",
        "pages": [
          {
            "pageNumber": 1,
            "angle": 0.0739153,
            "width": 8.5,
            "height": 11,
            "spans": [
              {
                "offset": 0,
                "length": 620
              }
            ],
            "words": [
              {
                "content": "Example",
                "span": {
                  "length": 7
                },
                "confidence": 0.992,
                "source": "D(1,1.265,1.0836,2.4972,1.0816,2.4964,1.4117,1.2645,1.4117)"
              },
              {
                "content": "Document",
                "span": {
                  "length": 8
                },
                "confidence": 0.996,
                "source": "D(1,2.6252,1.084,4.1615,1.0886,4.1615,1.3993,2.6241,1.4117)"
              },
              {
                "content": "☒",
                "span": {
                  "length": 1
                },
                "confidence": 0.983,
                "source": "D(1,1.258,2.7952,1.3705,2.7949,1.371,2.9098,1.2575,2.9089)"
              },
              {
                "content": "Hybrid",
                "span": {
                  "length": 6
                },
                "confidence": 0.996,
                "source": "D(1,1.4104,2.7836,1.876,2.7823,1.876,2.9377,1.411,2.9396)"
              }
            ],
            "lines": [
              {
                "content": "Example Document",
                "source": "D(1,1.264,1.0836,4.1583,1.0795,4.1589,1.4083,1.2645,1.4117)",
                "span": {
                  "offset": 0,
                  "length": 16
                }
              }
            ],
            "formulas": [
              {
                "confidence": 0.583
              },
              {
                "confidence": 0.708
              }
            ]
          },
          {
            "pageNumber": 2,
            "angle": 0.1008425,
            "width": 8.5,
            "height": 11,
            "spans": [
              {
                "offset": 620,
                "length": 744
              }
            ],
            "words": [
              {
                "content": "Images",
                "source": "D(2,1.4516,1.0434,2.0254,1.0463,2.0254,1.229,1.4506,1.224)"
              },
              {
                "content": "ceramic",
                "source": "D(2,2.5230,4.2539,2.6591,4.2543,2.6584,4.4392,2.5223,4.4407)"
              }
            ],
            "lines": [
              {
                "content": "4. Images",
                "source": "D(2,1.24,1.0409,2.0238,1.0463,2.0226,1.2284,1.2387,1.223)"
              }
            ]
          }
        ],
        "paragraphs": [
          {
            "role": "title",
            "content": "Example Document",
            "source": "D(1,1.264,1.0836,4.1584,1.0795,4.1589,1.4083,1.2644,1.4124)",
            "span": {
              "offset": 0,
              "length": 18
            }
          },
          {
            "role": "sectionHeading",
            "content": "1. Selection Marks (Checkboxes)",
            "source": "D(1,1.2461,1.8719,3.8532,1.8731,3.8531,2.065,1.246,2.0638)",
            "span": {
              "offset": 21,
              "length": 34
            }
          },
          {
            "content": "Employee Preferences Form ☐ Remote ☒ Hybrid ☐ On-site",
            "source": "D(1,1.246,2.0993,3.1019,2.1007,3.101,3.2724,1.2451,3.2709)",
            "span": {
              "offset": 57,
              "length": 53
            }
          }
        ],
        "sections": [
          {
            "span": {
              "offset": 0,
              "length": 1364
            },
            "elements": [
              "/paragraphs/0",
              "/sections/1",
              "/sections/2",
              "/sections/3",
              "/sections/4",
              "/sections/5",
              "/sections/6"
            ]
          },
          {
            "span": {
              "offset": 21,
              "length": 89
            },
            "elements": [
              "/paragraphs/1",
              "/paragraphs/2"
            ]
          }
        ],
        "tables": [
          {
            "rowCount": 6,
            "columnCount": 2,
            "cells": [
              {
                "kind": "columnHeader",
                "rowIndex": 0,
                "columnIndex": 0,
                "rowSpan": 1,
                "columnSpan": 1,
                "content": "Category",
                "source": "D(2,1.1674,5.0483,4.1733,5.0546,4.1733,5.2358,1.1674,5.2358)",
                "span": {
                  "offset": 798,
                  "length": 8
                }
              },
              {
                "kind": "columnHeader",
                "rowIndex": 0,
                "columnIndex": 1,
                "rowSpan": 1,
                "columnSpan": 1,
                "content": "Amount ($)",
                "source": "D(2,4.1733,5.0546,7.1668,5.0546,7.1668,5.2358,4.1733,5.2358)",
                "span": {
                  "offset": 816,
                  "length": 10
                }
              }
            ],
            "source": "D(2,1.1566,5.0425,7.1855,5.0428,7.1862,6.1853,1.1574,6.1858)",
            "span": {
              "offset": 781,
              "length": 280
            }
          }
        ],
        "figures": [
          {
            "source": "D(2,1.3465,1.8481,3.4788,1.8484,3.4779,3.8286,1.3456,3.8282)",
            "span": {
              "offset": 658,
              "length": 42
            },
            "elements": [
              "/paragraphs/14"
            ],
            "id": "2.1"
          }
        ]
      }
    ]
  }
}
Bu tam örnek, Content Understanding'in bir belgedeki tüm farklı öğe türlerini nasıl ayıklayıp oluşturduğunu gösterir. Hem ham içeriği hem de gelişmiş belge işleme iş akışlarını etkinleştiren ayrıntılı konumsal ve yapısal bilgileri sağlar.