Not
Bu sayfaya erişim yetkilendirme gerektiriyor. Oturum açmayı veya dizinleri değiştirmeyi deneyebilirsiniz.
Bu sayfaya erişim yetkilendirme gerektiriyor. Dizinleri değiştirmeyi deneyebilirsiniz.
Bir veri deposu uygun ikincil dizinler sağlamadığında uygulamaların sorgularda sık kullandığı veriler için ayrı arama tabloları oluşturun ve koruyun. Bu yaklaşım, sorgular birincil anahtarı veya bölüm anahtarını kullanmadığında tam veri taramalarından kaçınarak okuma performansını geliştirir.
Bağlam ve sorun
Birçok veri deposu, birincil anahtarı kullanarak bir varlık koleksiyonu için verileri düzenler. Uygulamalar bu anahtarı verileri bulmak ve almak için kullanabilir. Aşağıdaki şekilde, müşteri bilgilerini birincil anahtar olan Müşteri Kimliğine göre düzenlenmiş olarak tutan bir veri deposu örneği gösterilmektedir.
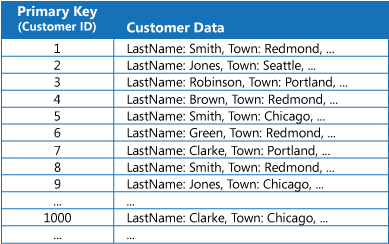
Görüntüde müşteri kayıtlarının iki sütunlu bir tablosu gösterilir. İlk sütun, Birincil Anahtar (Müşteri Kimliği), 1’den 9’a kadar müşteri kimliklerini, ardından bir üç noktayı, 1000 müşteri kimliğini ve bir üç nokta daha içerir. İkinci sütun olan Müşteri Verileri, bir soyadı ve şehir adından oluşan ve ardından üç nokta gelen müşteri verilerini içerir. Görünür örnekler arasında Soyadı Smith ve kasaba Redmond ile eşlenen 1. kimlik ve Soyadı Jones ve Seattle kasabasıyla eşlenen 2. kimlik yer alır. Bir satırda Chicago'daki Smith, bir diğerinde ise Redmond'daki Smith gösterilir. Bir başka satır Chicago’daki Jones’u gösteriyor.
Birincil anahtar, bu anahtarın değerine göre veri getiren sorgular için değerli olsa da, başka bir alana göre veri alması gereken bir uygulama bu sorgu için birincil anahtarı kullanamaz. Müşteriler örneğinde uygulama, verileri yalnızca diğer bir özniteliğin değerine başvurarak sorguluyorsa, örneğin müşterinin bulunduğu şehir gibi, Müşteri Kimliği birincil anahtarını kullanamaz. Yalnızca şehre başvuran bir sorgu gerçekleştirmek için uygulamanın her müşteri kaydını getirmesi ve incelemesi gerekebilir; bu da yavaş bir işlem olabilir.
Pek çok ilişkisel veritabanı yönetim sistemi ikincil dizinler destekler. İkincil dizin, bir veya daha fazla birincil olmayan (ikincil) anahtar alanına göre düzenlenmiş ayrı bir veri yapısıdır. İkincil dizin, dizine alınan her değerin verilerinin nerede depolandığını gösterir. İkincil dizindeki öğeler, hızlı veri arama olanağı sunmak için genellikle ikincil anahtarların değerlerine göre sıralanır. Veritabanı yönetim sistemi genellikle bu dizinleri otomatik olarak korur.
İlişkisel veritabanları, birden çok ikincil dizinin çeşitli sorgu desenlerini desteklemesine olanak sağlar. Örneğin, müşteri kimliğinin birincil anahtar olduğu ilişkisel veritabanındaki Müşteriler tablosunda, uygulama müşterileri bulundukları şehre göre sık sık arıyorsa, Kasaba alanına ikincil bir dizin eklemek yararlı olur.
İlişkisel sistemlerde ikincil dizinler yaygın olsa da, tüm veri depoları eşdeğer bir özellik sağlamaz. Bazı veri depolarında ikincil dizinler eksikken, bazıları iş yükünün sorgu, bölümleme veya performans gereksinimlerini karşılamayen dizinler sağlar. Bu gibi durumlarda, uygulamaların tam taramalar ile el ile dizin yönetimi arasında seçim yapması gerekir.
Çözüm
Verileri belirtilen bir anahtara göre düzenleyen bir dizin tablosu oluşturun. Aşağıdaki bölümde, bir dizin tablosunu yapılandırmak için üç yaygın strateji açıklanmaktadır. Sonraki iki bölümde, belirli senaryolarda dizin tabloları için kullanımlar açıklanmaktadır.
Standart yapılandırma stratejileri
Aşağıdaki stratejiler genellikle dizin tablosunu yapılandırmak için kullanılır. Senaryonuzun gerektirdiği ikincil dizin sayısına ve uygulamanızın gerçekleştirdiği sorguların niteliğine göre bir strateji seçin.
Tam denormalizasyon
Tam denormalizasyon, her dizin tablosunda veriyi çoğaltır, ancak onu birincil anahtar dışındaki anahtarlara göre düzenler. Aşağıdaki şekilde, aynı müşteri bilgilerini Şehir ve Soyadına göre düzenleyen dizin tabloları gösterilmektedir.

Bu strateji, verilerin seyrek değiştiği okuma ağırlıklı iş yükleri için iyi çalışır. Güncelleştirme hızı arttıkça, her kopyanın korunması işlem yükü ekler (bkz . Tutarlılık karmaşıklığı). Yüksek hacimli veri kümeleri için kopyaların depolanması için de önemli bir alan gerekebilir.
Normalleştirilmiş dizin
Normalleştirilmiş dizin tablosu verileri birincil anahtar dışındaki anahtarlara göre düzenler. Normalleştirilmiş dizin tablosu, aşağıdaki şekilde gösterildiği gibi, bu verileri yinelemek yerine birincil anahtarı kullanarak özgün verilere başvurur. Özgün verilere olgu tablosu adı verilir.
Tip
Burada olgu tablosu , bir dizin tarafından başvuruda bulunan yetkili kaynak tablo anlamına gelir. Bu, boyutlu bir veri modeli anlamına gelmez.

Bu teknik, alan tasarrufu yapılmasını sağlar ve yinelenen verileri saklama yükünü azaltır. Dezavantajı, bir uygulamanın ikincil anahtar kullanarak verileri bulmak için iki arama işlemi gerçekleştirmesi gerekir. Uygulamanın dizin tablosundaki verilerin birincil anahtarını bulması ve ardından olgu tablosundaki verileri aramak için birincil anahtarı kullanması gerekir.
Kısmi denormalizasyon
Kısmi denormalizasyon, sık erişilen alanları çoğaltan ve birincil anahtar dışındaki anahtarlara göre düzenlenmiş dizin tabloları oluşturur. Olgu tablosuna daha az sıklıkta erişilen alanlara erişmek için başvurulur. Aşağıdaki şekilde, sık erişilen verilerin her dizin tablosunda nasıl çoğaltıldığı gösterilmektedir.

Bu strateji ilk iki yaklaşımı dengeler. Tek bir arama kullanarak sık kullanılan sorgular için verileri hızla alabilirsiniz, ancak alan ve bakım yükü veri kümesinin tamamını yinelemek kadar önemli değildir.
Bileşik anahtarlar
Bazı uygulamalar, "Redmond'da yaşayan ve soyadı Smith olan tüm müşterileri bul" gibi değerlerin bir bileşimini belirterek verileri sık sık sorgular. Bu durumda, bu durumda Town ve LastName öznitelikleri gibi birden çok öznitelikten dizin anahtarları oluşturun.
Farklı değer bileşimlerinin aynı anahtarı üretememeleri için bileşen sınırlarını koruyan bir kodlama kullanın. Sorgular anahtar sırasına bağlıysa, kodlamanın veri deposunun anahtar harmanlama kuralları altında gerekli sıralama düzenini koruduğundan da emin olun.
Aşağıdaki şekilde bileşik anahtarları temel alan bir dizin tablosu gösterilmektedir. Anahtarlar önce Town'a göre, Town değeri aynı olan kayıtlar içinse ardından LastName'e göre sıralanır.
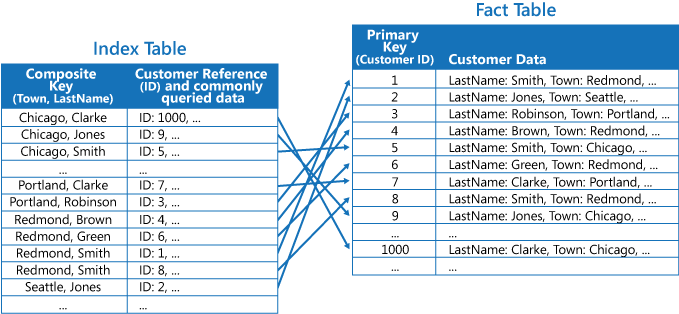
Diyagramda solda bir dizin tablosu ve sağda bir olgu tablosu bulunur. Olgu tablosu müşteri verilerini birincil anahtar olan Müşteri Kimliğine göre düzenler. Her Müşteri Verileri satırı, bir müşterinin soyadını, kasabasını ve başka verilerin de bulunduğunu gösteren bir üç noktayı içerir. Dizin tablosu, Town ve LastName değerlerini birleştiren bileşik anahtara göre düzenlenir. İkinci sütun olan Müşteri Referansı (ID) ve sık sorgulanan veriler, bir müşteri ID’si ve üç nokta içerir. Oklar, dizin tablosu satırlarından olgu tablosuna kadar uzanır ve her ok bu dizin girdisi tarafından başvuruda bulunılan Müşteri Kimliği satırına işaret eder. Çapraz oklar, bileşik anahtara göre sıralanmış girdilerin olgu tablosunda farklı konumlardaki müşteri satırlarına referans verebileceğini gösterir.
Parçalanmış veri üzerindeki dizin tabloları
Dizin tabloları, parçalanmış veriler üzerinde sorgu işlemlerini hızlandırabilir. Bunlar, özellikle shard anahtarı hash’lenmiş olduğunda yararlıdır. Aşağıdaki şekil, shard anahtarının müşteri kimliğinin karma değeri olduğu bir örneği göstermektedir. Dizin tablosu, girişleri hashlenmemiş Town ve LastName değerlerine göre düzenler ve her girişle birlikte karşılık gelen hashlenmiş parça anahtarını depolar.
Bu düzenleme, hash’lenmemiş değerler üzerinde aralık ve sıralı aramaları desteklerken, her kaydı doğru shard’dan geri almak için gereken yönlendirme bilgilerini sağlar. Örneğin, "Redmond'da yaşayan tüm müşterileri bul" gibi bir sorgu, dizin tablosundaki bitişik bir blokta eşleşen öğeleri bulabilir. Uygulama daha sonra dizin tablosunda depolanan parça anahtarlarını kullanarak müşteri verilerine yönelik referansları takip eder.

Sorunlar ve dikkat edilmesi gerekenler
Bu düzenin nasıl uygulaneceğine karar velarken aşağıdaki noktaları göz önünde bulundurun:
Bakım ek yükü. İkincil dizinlerin korunması önemli ek yük oluşturabilir. Uygulamanızın kullandığı sorguları analiz edin ve anlayın. Dizin tablolarını yalnızca düzenli olarak kullanma olasılığınız yüksek olduğunda oluşturun. Bir uygulamanın yalnızca ara sıra gerçekleştirmediği veya gerçekleştirmediği sorguları desteklemek için tahmini dizin tabloları oluşturmayın. Sorgu desenlerinin sayısı arttıkça, dizin tablolarının sayısı artar ve her biri izlemek, korumak ve hata ayıklamak için işletimsel yüzey alanı ekler. Her dizin tablosunun sorgu avantajını, başka bir türetilmiş veri yapısını korumanın operasyonel maliyetine göre değerlendirin. Artık sorgulanmamış dizin tablolarını tanımlamak ve kaldırmak için mevcut dizin tablolarını düzenli aralıklarla gözden geçirin.
Depolama ve aktarım hızı maliyeti. Dizin tablosundaki verileri çoğaltmak, dizin tablolarının sayısı ve kopyalanan alanların boyutuyla orantılı olarak depolama maliyetlerini artırır. Verilerin birden çok kopyasını korumak da çaba gerektirir. Dizin tablosuna yapılan her yazma işlemi, depolama hesabının Azure Tablo Depolaması sınırlarına göre yapılan işlemler veya Azure Cosmos DB'daki istek birimleri gibi aktarım hızı kapasitesini kullanır. Maliyet, depolamanın ötesine geçerek yazma tarafı aktarım hızına kadar uzanır.
Çift arama cezası. Bir dizin tablosunu orijinal verilere başvuruda bulunan normalleştirilmiş bir yapı olarak uygulamak, uygulamanın veri bulmak için iki arama işlemi gerçekleştirmesini gerektirir. İlk işlem, birincil anahtarı almak için dizin tablosunda arama yapar ve ikinci işlem de veri getirmek için birincil anahtarı kullanır.
Tutarlılık karmaşıklığı. Bir sistem büyük veri kümeleri üzerinde bir dizi dizin tablosuna sahipse, dizin tabloları ile özgün veriler arasında tutarlılık sağlamak zor olabilir. Kaynak veriler ve dizin girişleri aynı işlemde güncelleştirilemiyorsa, uygulamayı nihai tutarlılık modeli etrafında tasarlayabilirsiniz. Yazma işlemini onaylamadan önce her kaynak değişikliğini kalıcı olarak kaydedin. Örneğin, bir veritabanı değişiklik akışını tüketin, kaynak değişiklikle aynı işlem içinde bir giden kutusu kaydı yazmak için İşlemsel Giden Kutusu düzenini kullanın veya kaynak veriyi değiştirmeden önce bir komutu kuyruğa alın. Komut tabanlı yaklaşımda, komutunu işlemek ve kaynak verileri ve dizinlerini güncelleştirmek için bir çalışan kullanın. Kaynak verileri güncelleyip ardından dizin güncelleme iletisini ayrı olarak yayımlamayın, çünkü bu işlemler arasında oluşacak bir hata dizinin güncel olmayan durumda kalmasına neden olabilir.
Asenkron tüketiciyi idempotent olacak şekilde tasarlayın; çünkü ileti teslimi ve yeniden denemeler, aynı güncelleştirmenin birden fazla kez uygulanmasına neden olabilir. Aynı kaynak kaydı için güncellemeler de sırasız şekilde ulaşabilir. Her dizin güncelleştirmesine bir kaynak sürüm veya sıra numarası ekleyin ve yalnızca dizindeki sürümden daha yeniyse bir güncelleştirme uygulayın. Silme işlemlerinde, gecikmiş daha eski bir güncellemenin silinen dizin girdisini yeniden oluşturamaması için sürümlendirilmiş bir mezar taşı kaydı veya buna eşdeğer bir yüksek su işaretini saklayın. Kaynak veri yazma ile zaman uyumsuz dizin güncelleştirmesi arasındaki aralık boyunca, dizin tablosuna yönelik sorgular kaynak verilerde güncelleştirilmiş veya silinmiş kayıtlara eski başvurular döndürebilir ve son eklenen kayıtları atlayabilir.
Dizin tablolarını bölümleme. Dizin tabloları bölümlenmiş veya parçalanmış olabilir; bu da sorgu yönlendirmeye karmaşıklık katabilir ve bölümleme stratejisinin dizinin hizmet vermek üzere tasarlandığı sorgu desenleriyle uyumlu olmasını gerektirir.
Bu desen ne zaman kullanılır?
Bir uygulamanın birincil (veya parça) anahtarı dışında bir anahtar kullanarak sık sık veri alması gerektiğinde ve veri deposu ikincil dizinleri yerel olarak desteklemediğinde veya yerel dizinleri iş yükünün sorgu, bölümleme veya performans gereksinimlerini karşılamadığında bu düzeni kullanın.
Bu düzen aşağıdaki durumlarda uygun olmayabilir:
Veriler geçicidir. Veriler o kadar sık değişir ki yazma hızı, dizin tablolarının zaman uyumsuz olarak yenilenme hızını aşıyor. Eskime penceresi, dizin kalıcı olarak güncelliğini yitirene kadar büyür; bu da onu etkisiz hale getirir ve dizin tablosunu korumanın depolama ve işleme hacmi ek yükünün, sorgulardan elde edilen tasarrufu aşmasına neden olur.
Ayrım yapmayan anahtarlarınız var. Dizin tablosu için ikincil anahtar olarak seçilen bir alan ayrımcı değildir ve yalnızca küçük bir değer kümesine (örneğin, bir öğenin etkin olup olmadığını kaydeden boole alanı) sahip olabilir. Dizin tablosu tam depolama ve aktarım hızı maliyetine neden olur, ancak en düşük düzeyde sorgu seçiciliği sağlar.
Veri değerlerinin çarpık bir dağılımı vardır. Dizin tablosunun ikincil anahtarı olarak seçilen bir alanın veri değerlerinin bakiyesi yüksek oranda dengesizdir. Örneğin, kayıtların yüzde 90'ı bir alanda aynı değeri içeriyorsa, bu alana göre verileri aramak için bir dizin tablosu oluşturup bakımını yapmak, verileri sıralı olarak taramaktan daha fazla ek yük oluşturabilir. Ancak, sorgular genellikle kalan yüzde 10'unda yer alan değerleri hedeflerse, bu dizin yine de yararlı olabilir.
İş yükü tasarımı
Bir mimar, Azure Well-Architected Framework yapılarında ele alınan hedefleri ve ilkeleri ele almak için iş yükü tasarımında Dizin Tablosu düzeninin nasıl kullanılacağını değerlendirmelidir. Aşağıdaki tabloda, bu desenin her bir sütunun hedeflerini nasıl desteklediği hakkında rehberlik sağlanmaktadır.
| Temel | Bu desen sütun hedeflerini nasıl destekler? |
|---|---|
| Güvenilirlik , yedeklilik oluşturarak ve hatalar sırasında işlevselliği koruyarak iş yükünüzün dayanıklılık ve kurtarma hedeflerini karşılamasına yardımcı olur. | Eşzamansız dizin bakımı, geçici dizin güncelleştirme hatalarının kaynak veri yazma işlemlerini bloklamasını önleyebilir. İdempotent işleme, ölü mektup işleme, izleme ve uzlaştırma, hatalardan sonra dizin tutarlılığını geri yüklemeye yardımcı olur. - RE:07 Kendini koruma - RE:10 İzleme |
| Performans Verimliliği , ölçeklendirme, veri ve kod iyileştirmeleri aracılığıyla iş yükünüzün talepleri verimli bir şekilde karşılamasını sağlar. | Dizin tabloları, tam veri taramalarına gerek kalmadan birincil olmayan anahtar alanlarında hızlı aramaların etkinleştirilmesini sağlar. Parçalı veri depolarında dizin tabloları, tek başına parça anahtarının verimli bir şekilde hizmet veremeyen aralık ve sıralama sorgularını desteklemek için girdileri karma olmayan değerlere göre düzenleyebilir. - PE:05 Ölçeklendirme ve bölümleme - PE:08 Veri performansı |
Herhangi bir tasarım kararında olduğu gibi, bu desen bir yapı içinde dengeler sağlarsa, bunları diğer sütunların hedeflerine karşı düşünün.
Example
Filmler hakkında bilgi depolayan bir uygulama düşünün. Kataloğun büyük ve okuma ağırlıklı olduğunu, her filmin bir birincil türü olduğunu, oyuncu sorgularının sık olduğunu, oyuncu kadrosu verilerinin seyrek değiştiğini ve kısa süreli dizin gecikmesinin kabul edilebilir olduğunu varsayalım. Tablo Depolama, her varlığı adlandırılmış özelliklerden oluşan yapılandırılmış bir küme olarak depolar. Her varlık bir PartitionKey, RowKeyve zaman damgası içerir ve aynı tablodaki varlıklar farklı özellik kümelerine sahip olabilir.
Tablo Depolama, RowKey ve PartitionKey bileşenlerinden oluşan bileşik birincil anahtar kullanır. değeri, PartitionKey bir varlığın depolandığı bölümü belirler. Bir bölüm içinde RowKey değer bir varlığı benzersiz olarak tanımlar. Tablo Depolama, her iki anahtarı da belirten veya bir bölüm içinde bitişik bir satır anahtarı değeri aralığı getiren sorgular için iyileştirilmiştir.
Tip
Tablo Depolama, varlık grubu işlemleri aracılığıyla aynı tablodaki ve bölümdeki varlıklar için işlem güncelleştirmelerini destekler. Bir işlem olgu tablosuna ve ayrı bir dizin tablosuna yayılamaz. Olgu varlığını ve dizin varlıklarını atomik olarak güncelleştirmek için, bunları aynı tabloda aynı PartitionKeyile depolayın. Varlık grubu işlemleri, toplu iş başına en fazla 4 MiB yüke sahip 100 varlıkla sınırlıdır.
Bu örnekte, bölüm anahtarı olarak kodlanmış bir tür tanımlayıcısı ve satır anahtarı olarak kararlı, benzersiz bir film tanımlayıcısı kullanarak her tür için bölümler içeren bir Azure tablosu oluşturun. Tür ve film adlarını özellik olarak depolayın. Aşağıdaki şekilde, örneğin daha kolay takip edilmesini sağlamak için tanımlayıcılar yerine okunabilir adlar kullanılır.

Bu yaklaşım, uygulamanın filmleri başrol aktörüne göre de sorgulaması gerekiyorsa daha az etkili olur. Bu durumda, dizin tablosu işlevi gören ayrı bir Azure tablosu oluşturun. Bölüm anahtarı olarak kodlanmış, kararlı bir aktör tanımlayıcısı ve satır anahtarı olarak film tanımlayıcısı kullanın. Aktör ve film adlarını özellik olarak depolayın. Aşağıdaki şekil, tanımlayıcılar yerine okunabilir adlar kullanır. Bir filmde birden fazla oyuncu yer alıyorsa, aynı film birden çok bölümde yer alır.
Aşağıdaki şekilde aktör dizin tablosu gösterilmektedir.

Tasarım kılavuzu
Film tablosu, bölümleme anahtarı olarak türü kullanır; bu da türe göre filtre uygulayan sorguların, bitişik satır anahtarı aralıkları üzerinde bölüm taramaları olarak verimli bir şekilde çalıştırıldığı anlamına gelir. Ancak Tablo Depolama, RowKey ve PartitionKey üzerinde yalnızca tek bir kümelenmiş dizini destekler. İkincil dizinleri yok. "Belirli bir aktörün oynadığı tüm filmleri bul" gibi bir sorgu, her tür bölümü genelinde tam tablo taraması gerektirir ve bu büyük ölçekte pahalıdır.
Aktör dizin tablosu, erişim desenini tersine çevirme yoluyla bu sınırlamayı giderir. Her aktör tanımlayıcısı bir bölüm anahtarına ve her film tanımlayıcısı bir satır anahtarına dönüşür, bu nedenle aktör tabanlı sorgular verimli bölüm aramaları olarak çözümlenir. Her bölüm yalnızca bir aktörün filmlerini barındırdığından, sorgu ilişkisiz verileri taramadan bitişik bir varlık aralığı döndürür.
Film ve aktör girişleri ayrı tablolar ve bölüm anahtarları kullandığından, bu girdiler varlık grubu işlemini paylaşamaz. Aktör dizinini dayanıklı bir eşzamansız değişiklik yakalama mekanizmasıyla sürdürün ve uygulamayı, sorguların kısa süreli güncellik gecikmesini tolere edecek şekilde tasarlayın.
Dizin tablosu kısmi normalleştirme uygular: Her girdi, sık erişilen alanları (diğer aktörlerin adları gibi) yineler, böylece en sık kullanılan sorgular tek bir aramayla tek başına dizin tablosundan yanıtlanabilir. Daha seyrek erişilen alanlar için giriş, orijinal film tablosundaki tür bölümleme anahtarını içerir ve tam kayda erişmek için tür bölümlemesine yönelik hedefli bir nokta sorgusuna olanak tanır. Bu tasarım, sorgu hızını depolama maliyeti ve bakım ek yüküne karşı dengeler.
Sonraki Adımlar
Tablo Depolama sorgu tasarımı kılavuzu,
RowKeyvePartitionKeykullanan ikincil dizin desenlerini, dizin girdilerinin aynı bölümde veya ayrı bölümlerde depolanmasına yönelik yaklaşımlar dahil, açıklar.Veri bölümleme stratejileri sorgu desenlerine , veri dağıtımına, işlem gereksinimlerine ve ölçeklenebilirlik hedeflerine göre bölüm ve satır anahtarlarını seçmeyi açıklar.
Veri performansını iyileştirmeye yönelik mimari stratejileri sorgu desenlerini , dizinleri, bölümleri ve izleme gereksinimlerini değerlendirmeye yönelik rehberlik sağlar.
Azure Cosmos DB'daki tutarlılık düzeyleri, Azure Cosmos DB dizin tablolarını koruduğunuzda uygun olan tutarlılık modellerini açıklar.
İlgili kaynaklar
Bu deseni uyguladığınızda aşağıdaki desenler de ilgili olabilir:
Parçalama düzeni. Dizin Tablosu düzeni, parça kullanarak bölümlenmiş verilerle birlikte sık kullanılır. Parçalama düzeni, veri deposunun bir parça kümesine nasıl bölüneceğini açıklar.
Maddileştirilmiş Görünüm deseni. Verileri özetleyen sorguları desteklemek için verileri dizinlemek yerine verilerin gerçekleştirilmiş bir görünümünü oluşturmak daha uygun olabilir. Bu model, verimli özet sorgularını desteklemek için veriler üzerinde önceden doldurulan görünümlerin nasıl oluşturulacağını açıklar.
İşlemsel Giden Kutusu deseni. Kaynak veriler ile indeks girdileri tek bir işlem içinde güncellenemediğinde, eşzamansız indeks bakımına yönelik değişiklikleri güvenilir biçimde yayımlamaya yardımcı olmak için Transactional Outbox desenini kullanın.