Not
Bu sayfaya erişim yetkilendirme gerektiriyor. Oturum açmayı veya dizinleri değiştirmeyi deneyebilirsiniz.
Bu sayfaya erişim yetkilendirme gerektiriyor. Dizinleri değiştirmeyi deneyebilirsiniz.
Uyarlamalı sorgu yürütme (AQE), sorgu yürütme sırasında gerçekleşen sorgu yeniden iyileştirmesidir.
Bir sorgu çalışmadan önce, optimizer veri büyüklüğünün tahminlerine göre bir sorgu planı seçer. Bu tahminler, tablo istatistikleri eksikse veya güncel değilse, veri çarpıksa ya da karmaşık bir sorguda sonraki adımlarda yanlış olabilir. Yanlış tahminlere dayalı bir plan, yavaş bir join stratejisi kullanabilir, bir shuffle işleminden sonra çok fazla küçük görev oluşturabilir veya tüm aşamayı geciktiren birkaç büyük görev oluşturabilir. AQE, bu sorunları, sorgu çalışırken planı gerçek verinin boyutuna göre yeniden optimize ederek çözer.
Her shuffle veya broadcast exchange işleminin sonunda, Azure Databricks şimdiye kadar üretilen veriler için doğru istatistiklere sahiptir. AQE, bu istatistikleri daha iyi bir fiziksel strateji seçmek, karıştırma sonrası bölümlerin optimal sayısı ve boyutunu belirlemek veya başka türlü sorgu ipuçları gerektiren optimizasyonları uygulamak için kullanır; örneğin çarpık birleştirme işleme gibi.
AQE varsayılan olarak etkindir. Bundan faydalanmak için sorgularınızı değiştirmenize gerek yok. Yavaş bir sorguyu sorun giderken AQE'nin bir sorgu planını değiştirip değiştirmediğini kontrol et. AQE ayarlarını yalnızca varsayılan ayarlar iş yükünüze uymadığında özelleştirin. Bkz. Sorgu Planları ve Konfigürasyon.
Yetenekler
AQE'nin dört ana özelliği vardır:
- Sıralama birleştirme bağlantısını dinamik olarak yayınlama karma bağlantısına dönüştürür.
- Karıştırmalı değişimden sonra, bölümleri dinamik olarak birleştirir (küçük bölümleri daha makul boyutlardaki bölümler hâline getirir). Çok küçük görevler daha kötü G/Ç aktarım hızına sahiptir ve zamanlama ek yükü ve görev kurulumu ek yükünden daha fazla zarar görür. Küçük görevlerin birleştirilmesi, kaynak tasarrufu sağlar ve küme aktarım hızını artırır.
- Dengesiz görevleri, sıralama birleştirme ve karıştırma karma birleştirme işlemlerinde dinamik olarak işler, bunları gerekirse çoğaltarak kabaca eşit boyutlu görevlere böler.
- Satır döndürmeyen boş ilişkileri dinamik olarak algılar ve yayar.
Desteklenen sorgular
AQE, bu iki koşulu da karşılayan sorgular için geçerlidir:
- Sorgu, akışlı bir sorgu değildir.
- Sorgu en az bir exchange (genellikle birleştirme, agrega veya pencereden), en az bir alt sorgu veya her ikisini içerir.
AQE desteklenen her sorguyu yeniden optimize eder, ancak sonuç, sorgu çalışmadan önce optimize edicinin derlediği plan olabilir. AQE'nin bir sorgu planını değiştirip değiştirmediğini kontrol etmek için Sorgu planları sayfasına bakınız.
Sorgu planları
AQE uygulanan sorgular genellikle her ana sorgunun veya alt sorgunun kök düğümü olarak bir veya daha fazla AdaptiveSparkPlan düğümü içerir. Her AdaptiveSparkPlan düğümün bir isFinalPlan bayrağı vardır. Bayrak, sorgu yürütülmeden önce ve yürütme sırasında false durumundadır ve sorgu tamamlandığında true durumuna değişir.
Bir sorgu planını görüntülemek için Spark arayüzünü, DataFrame.explain() veya SQL EXPLAIN kullanın. Her biri, AQE'nin planı nasıl değiştirdiğine dair farklı bilgiler gösterir.
Spark Kullanıcı Arabirimi
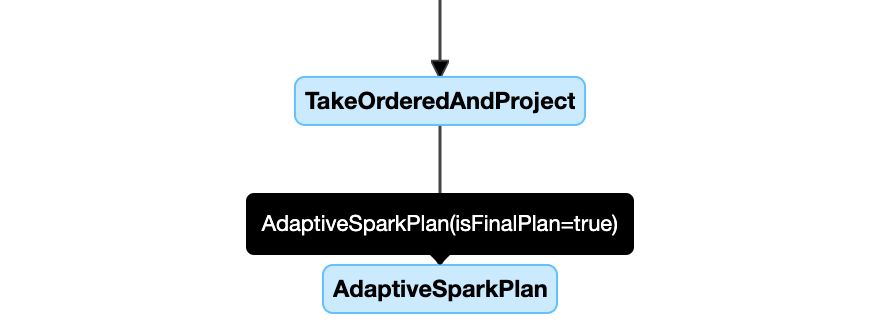
Spark arayüzündeki sorgu planı diyagramı en güncel planı gösterir ve sorgu çalışırken güncellenir. Zaten çalışmış ve metrikleri olan düğümler değişmez. Henüz çalışmamış düğümler, AQE planı yeniden optimize ettikçe değişebilir.
Bu örnek, bir sorgu planı diyagramını gösterir:
DataFrame.explain()
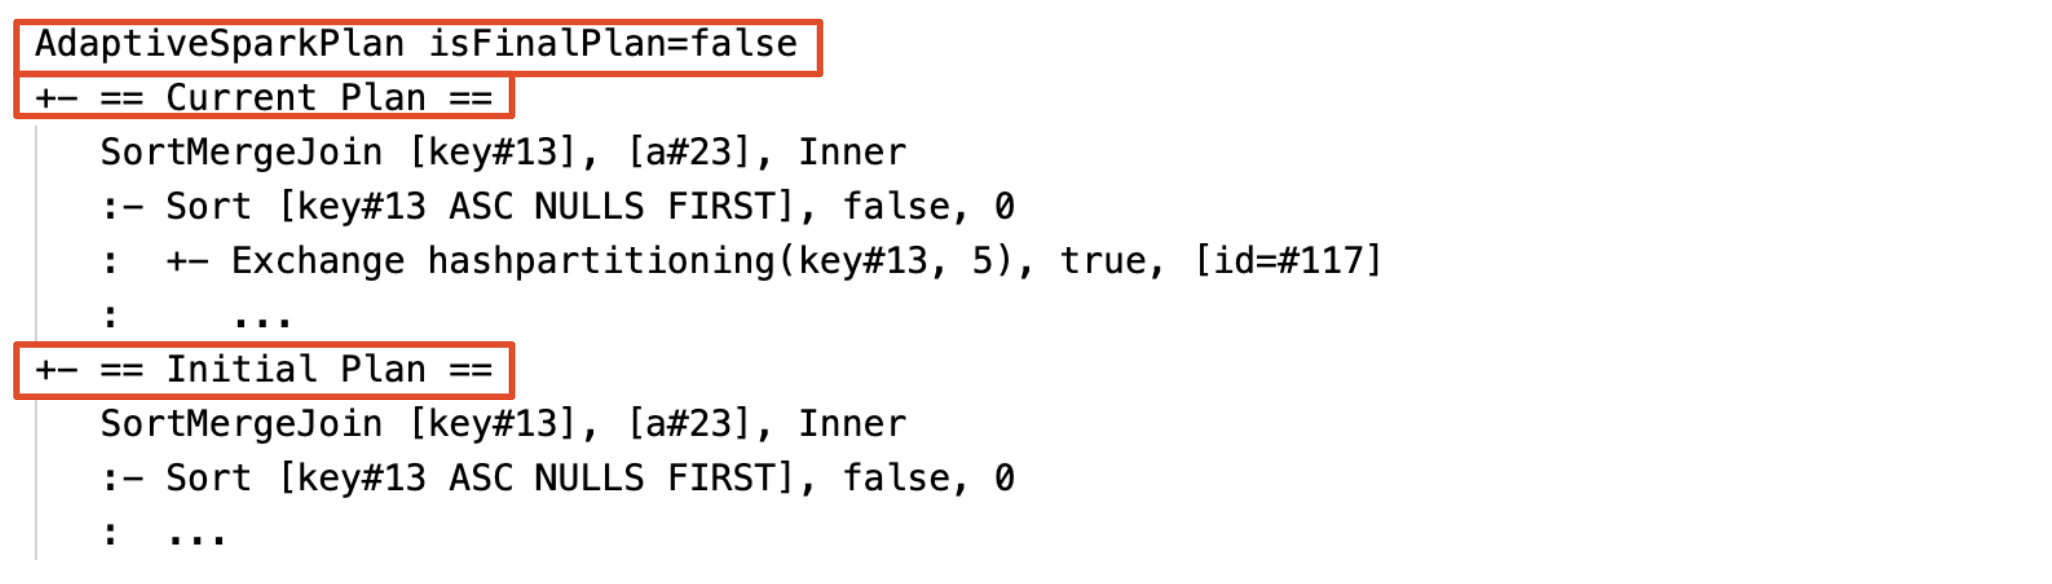
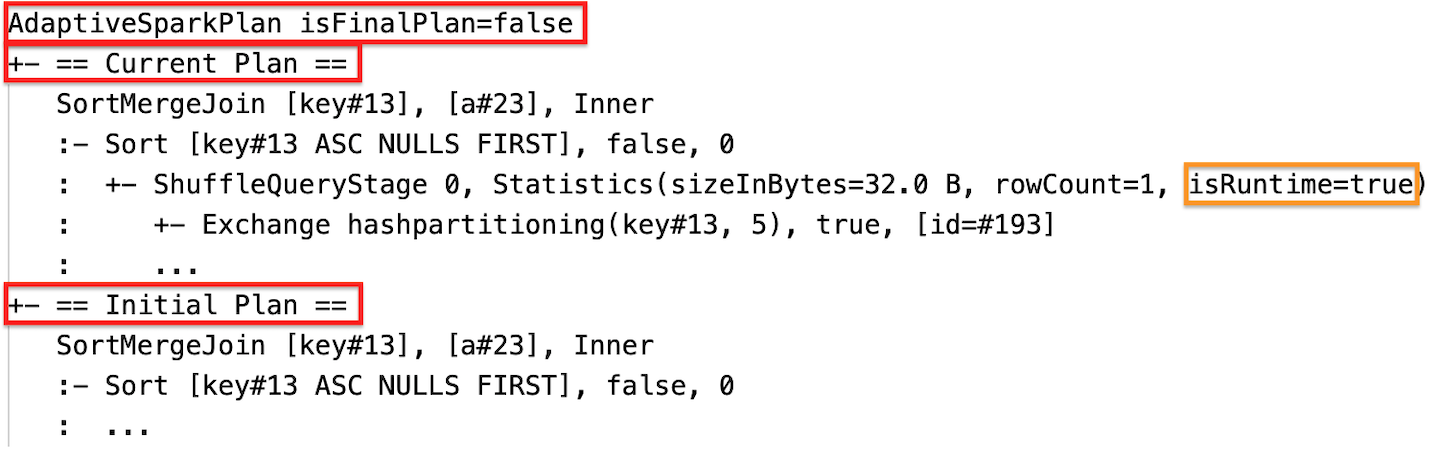
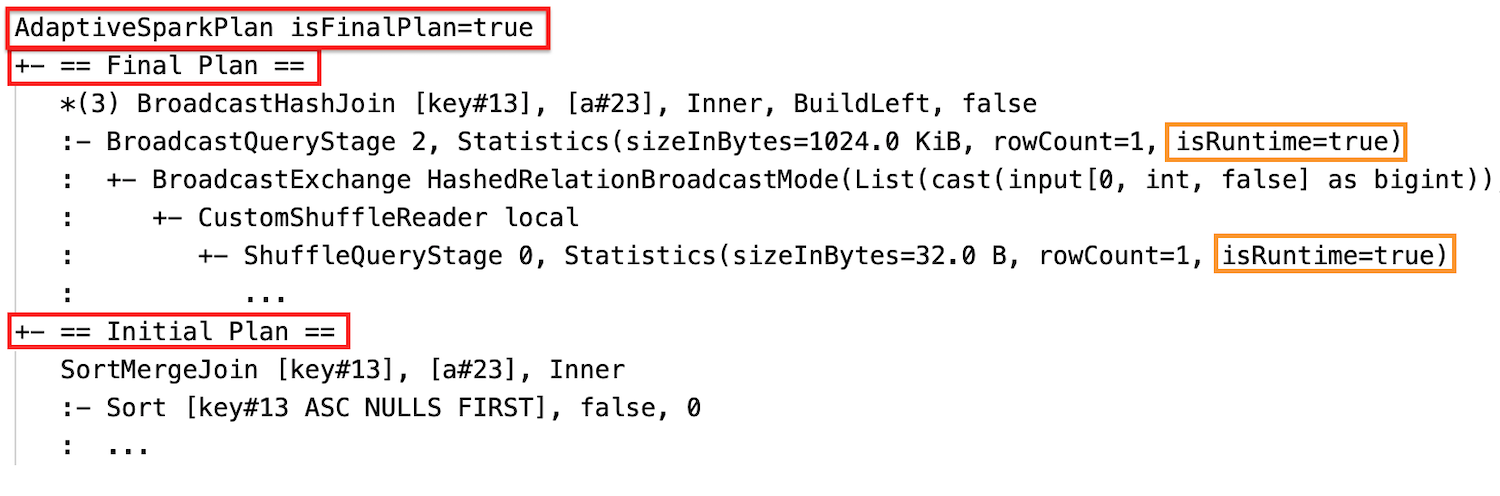
DataFrame.explain() her AdaptiveSparkPlan düğümünün altında iki plan gösterir: AQE herhangi bir optimizasyon uygulamadan önceki ilk plan ve mevcut plan. Mevcut plan, sorgu ilerledikçe değişir ve sorgu bittiğinde nihai plan olur.
Çıktı, her shuffle ve broadcast aşaması için veri istatistiklerini içerir. İstatistikler, aşamanın çalışıp çalışmadığına bağlıdır:
- Aşama çalıştırması öncesinde ve sırasında,
isRuntime,falseve istatistikler derleme zamanı tahminleridir. Örneğin,Statistics(sizeInBytes=1024.0 KiB, rowCount=4, isRuntime=false). - Aşama çalıştıktan sonra,
isRuntimetrueolur ve istatistikler çalışma zamanı ölçümleridir. Örneğin,Statistics(sizeInBytes=658.1 KiB, rowCount=2.81E+4, isRuntime=true).
Bu ekran görüntüleri, DataFrame.explain() çıktıyı çalıştırmadan önce, sırasında ve sonrasında gösterir:
Yürütmeden önce
yürütmeden önce
Yürütme sırasında
Yürütmeden sonra
Yürütme sonrası
SQL EXPLAIN
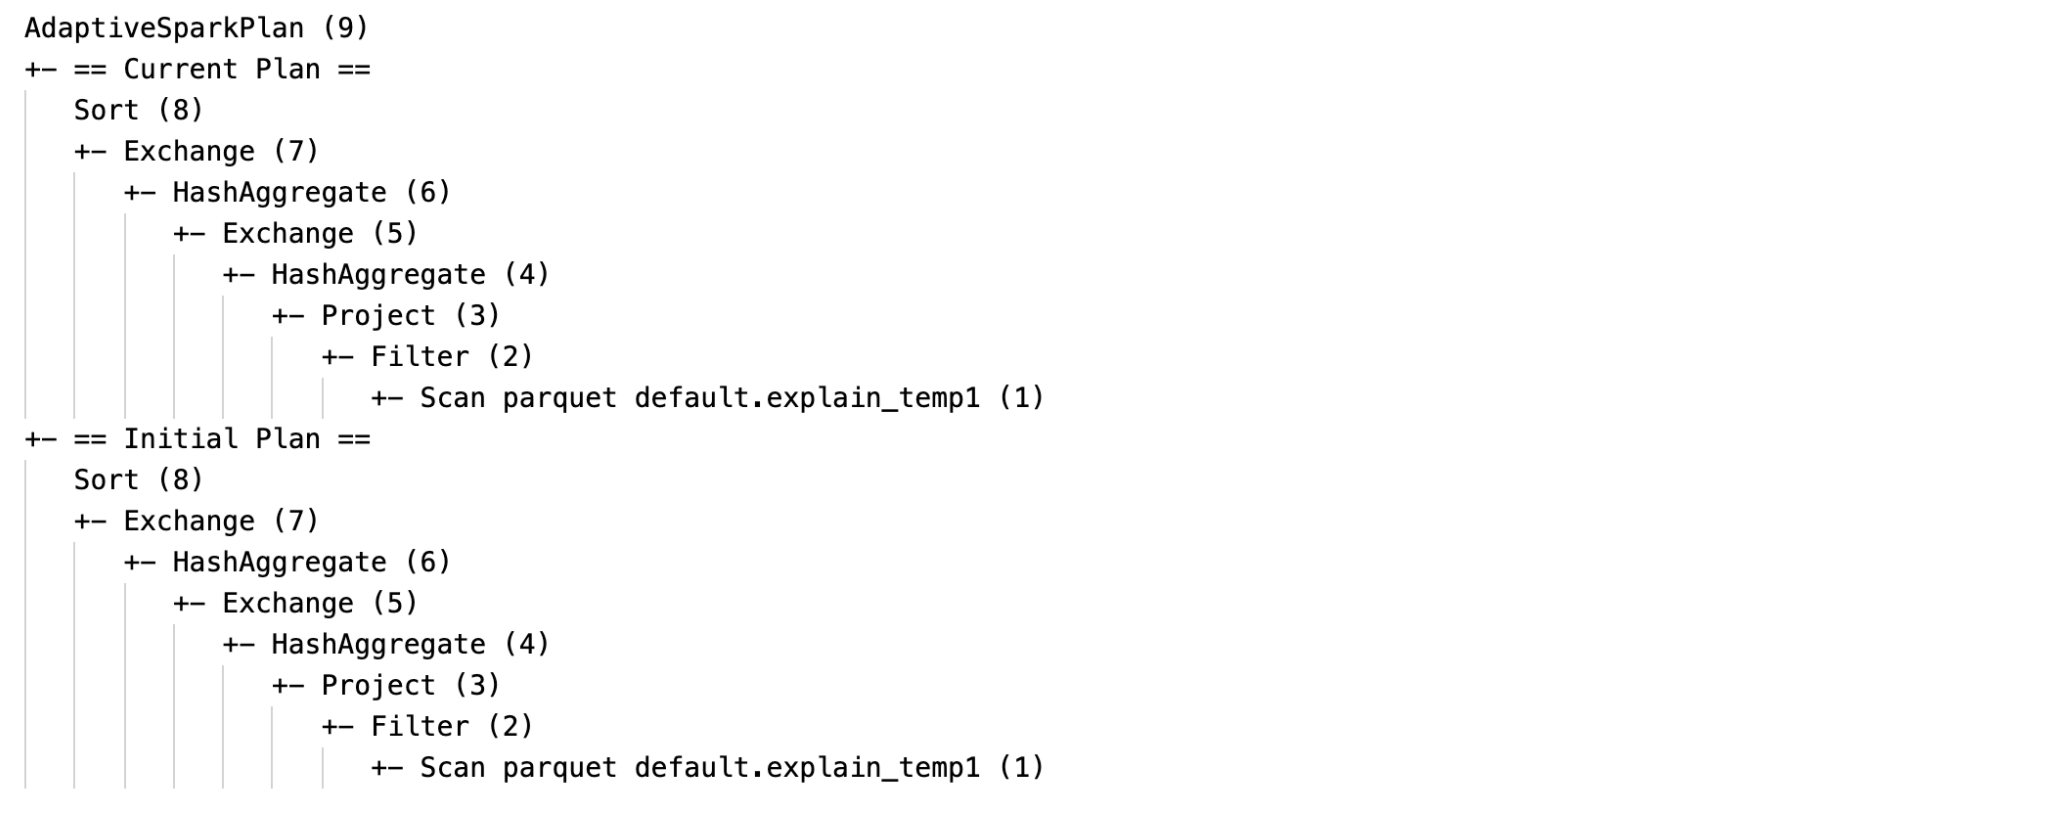
SQL EXPLAIN sorguyu çalıştırmıyor, bu yüzden AQE onu yeniden optimize edemiyor. Çıktı sadece ilk planı gösterir, bu da AQE'nin çalıştırdığı plandan farklı olabilir.
Bu örnek SQL EXPLAIN çıktısını gösteriyor:
Bir sorgu planında uygulanan optimizasyonları belirleyin
AQE bir optimizasyon uyguladığında, sorgu planı değişir. Hangi optimizasyonların yürürlüğe girdiğini belirlemek için, mevcut veya nihai planı ilk planla karşılaştırın. Her optimizasyon planı belirli bir şekilde değiştirir:
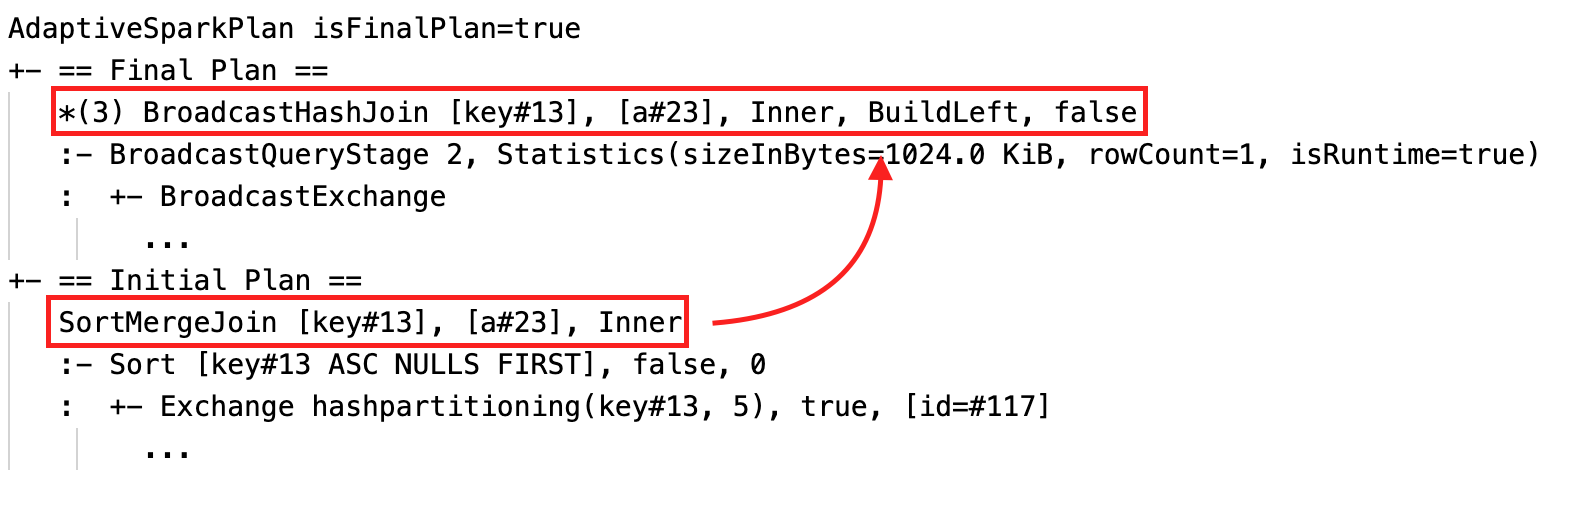
Birleştirme stratejisi değişikliği. Mevcut veya nihai plan, ilk plandakinden farklı bir fiziksel birleşme düğümüne sahiptir.
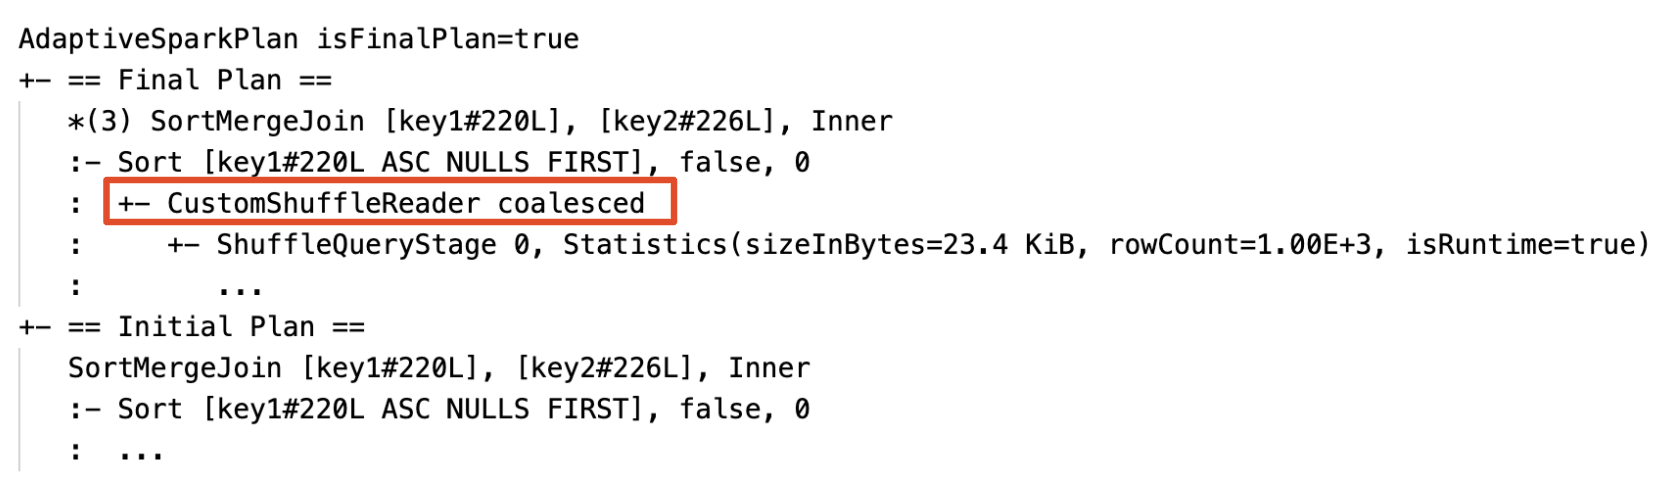
Bölüm birleştirme. Plan,
CustomShuffleReaderözelliğine sahip birCoalesceddüğüm içerir.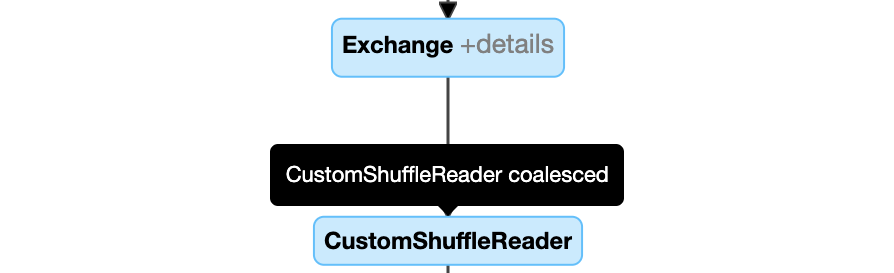
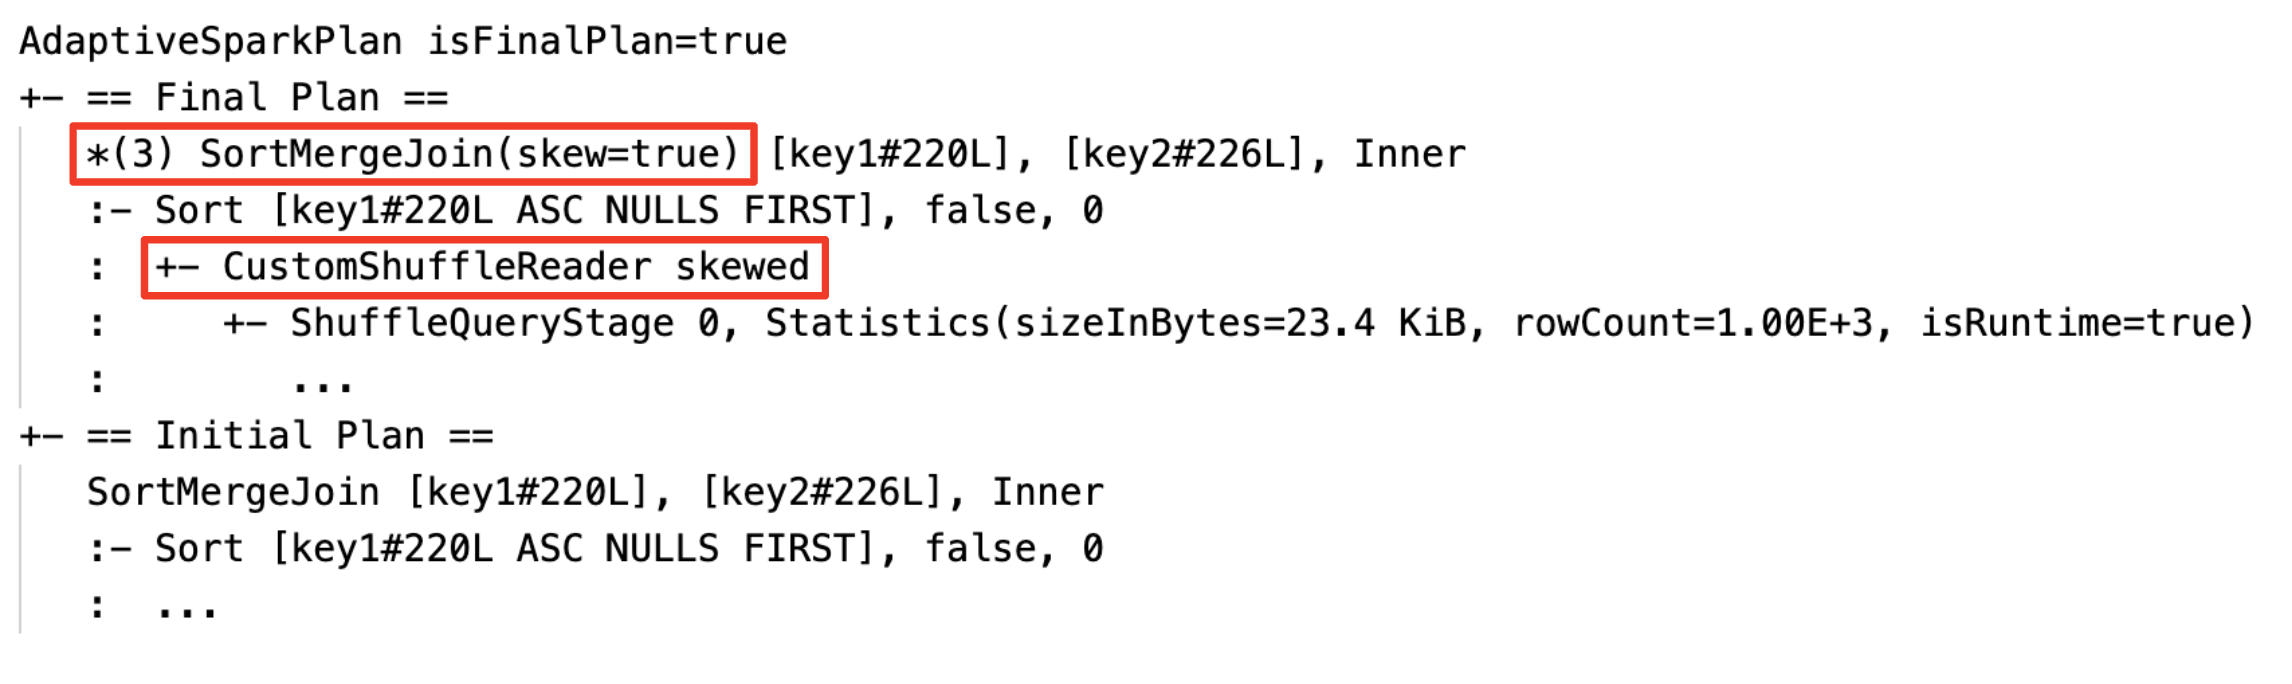
Skew join işleme. Plan,
truealanıSortMergeJoinolarak ayarlanmış birisSkewdüğüm içerir.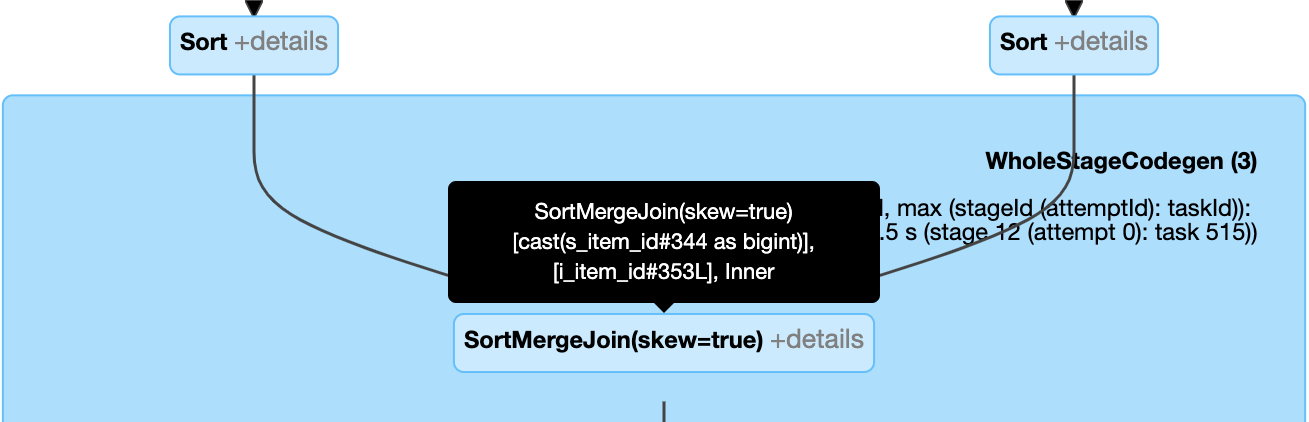
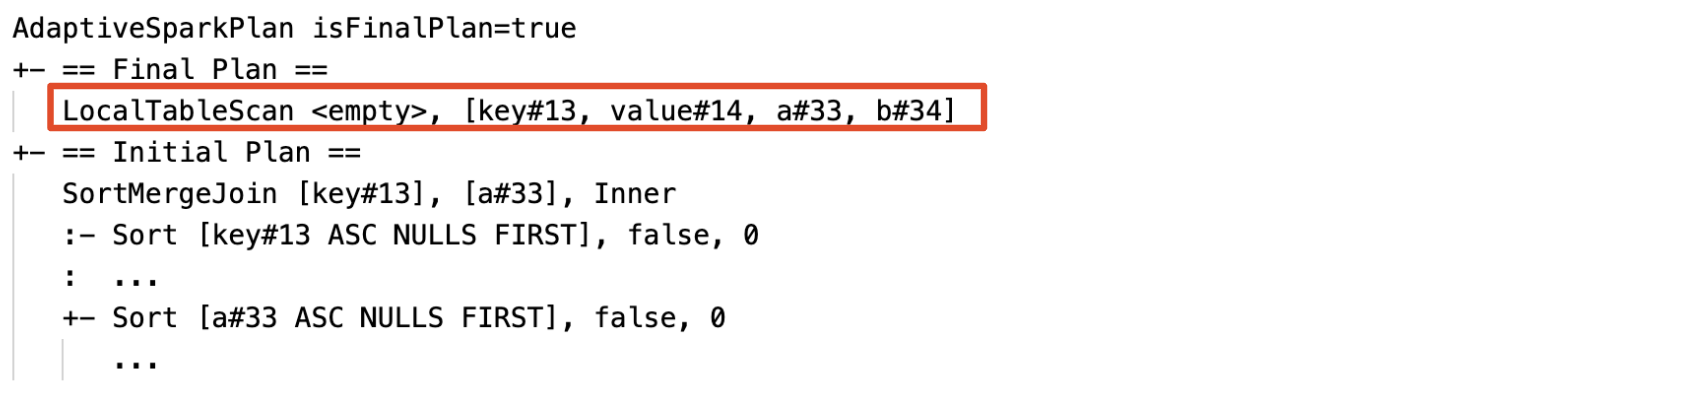
Boş ilişki yayılımı. Boş ilişki alanına sahip bir
LocalTableScandüğüm, planın bir kısmını veya tamamını değiştirir.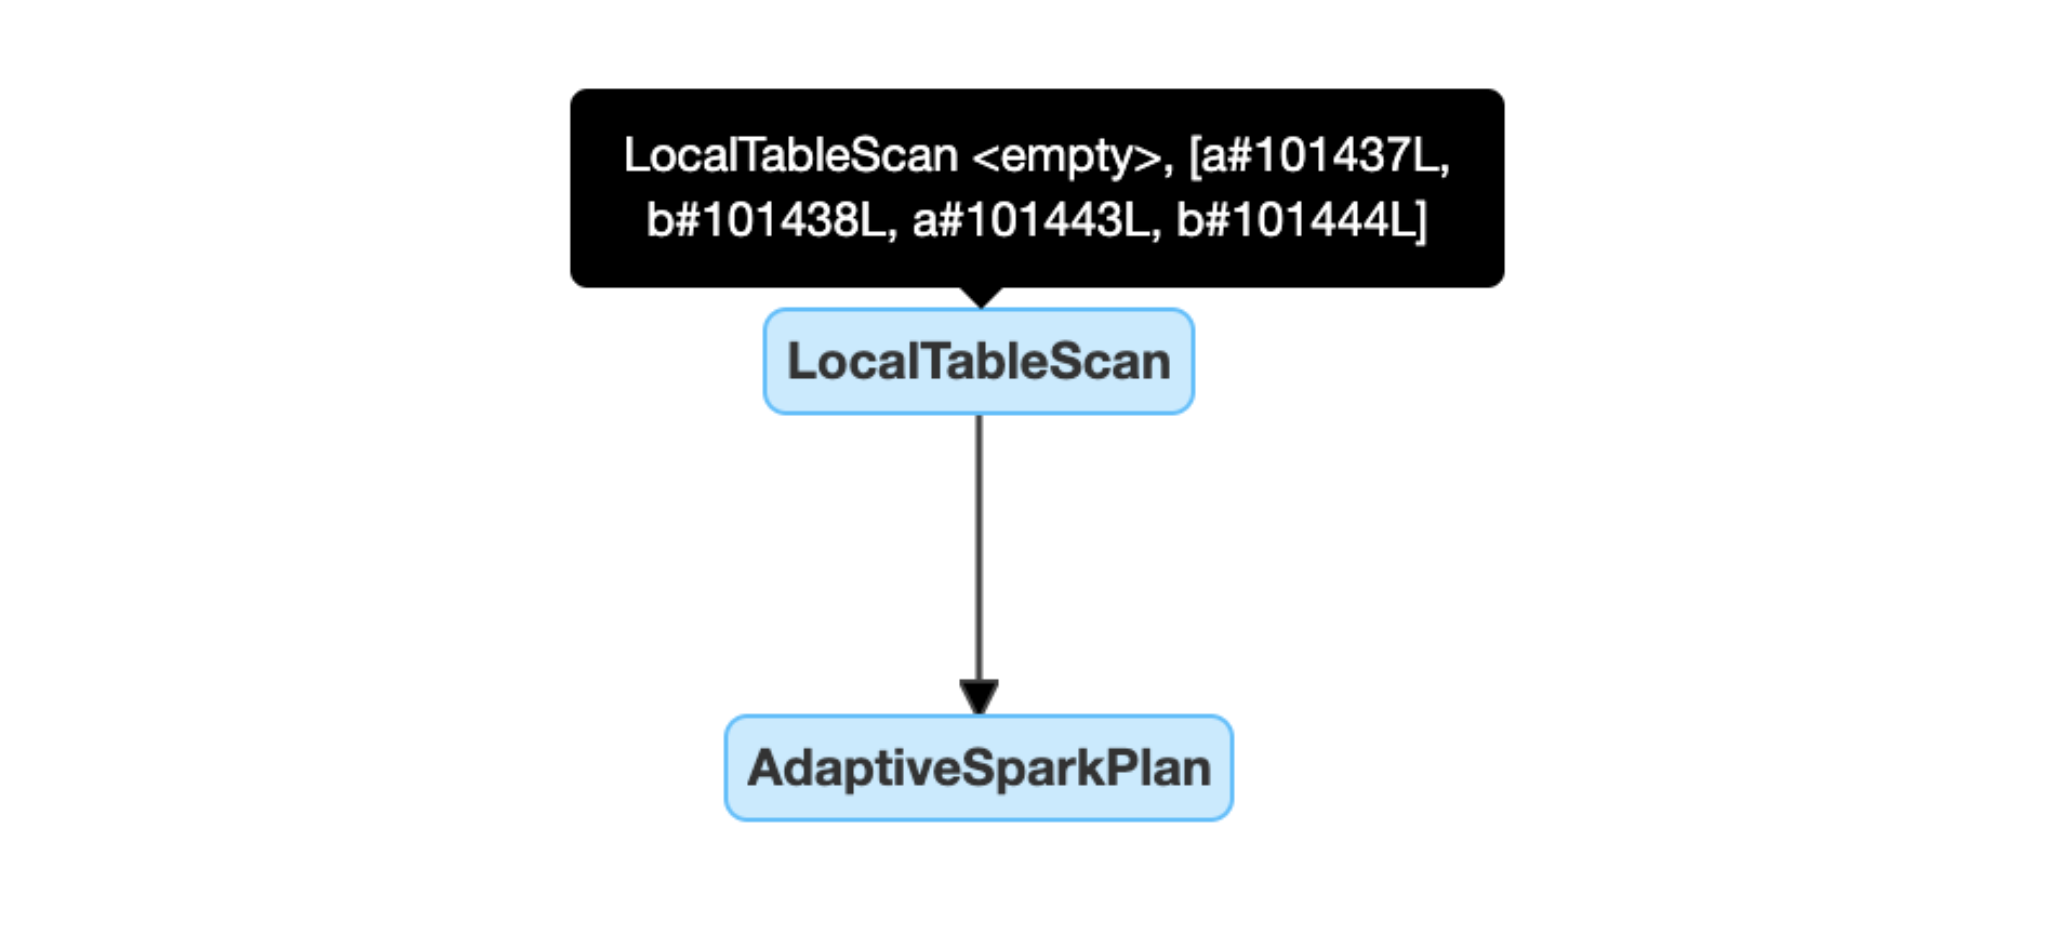
Konfigürasyon
Bu Apache Spark yapılandırma özellikleri AQE'yi kontrol eder. Çoğu iş yükü için varsayılan ayarları değiştirmeye gerek yok.
AQE'yi etkinleştirin ve bireysel optimizasyonları ayarlayın
Bu özellikleri kullanarak AQE'yi açıp kapatın ve otomatik optimize edilmiş shuffle'ı, broadcast join switching'i ve boş ilişki yayılımını ayarlayın:
| Mülk | Type | Default | Description |
|---|---|---|---|
spark.databricks.optimizer.adaptive.enabled |
Boolean |
true |
Uyarlanabilir sorgu yürütmeyi açar veya kapatır. |
spark.sql.shuffle.partitions |
Integer |
200 |
Birleştirmeler veya toplamalar için verileri karıştırırken kullanılacak varsayılan bölüm sayısı. Otomatik optimize edilmiş karıştırmayı etkinleştirmek için auto olarak ayarlayın; bu sayı sorgu planına ve sorgu giriş veri boyutuna göre ayarlanır.Yapılandırılmış Akış için, aynı kontrol noktası konumundan sorgu yeniden başlatmaları arasında bu değeri değiştiremezsiniz. |
spark.databricks.adaptive.autoBroadcastJoinThreshold |
Byte String |
30MB |
Bir sort-merge join’i çalışma zamanında broadcast hash join’e geçirmek için boyut eşiği. |
spark.databricks.adaptive.emptyRelationPropagation.enabled |
Boolean |
true |
Dinamik boş ilişki yayılımını açar veya kapatır. |
Bölümleri dinamik olarak birleştirme
| Mülk | Type | Default | Description |
|---|---|---|---|
spark.sql.adaptive.coalescePartitions.enabled |
Boolean |
true |
Bölüm birleştirmeyi açıp kapatır. |
spark.sql.adaptive.advisoryPartitionSizeInBytes |
Byte String |
64MB |
Koalesan işlemi sonrası hedeflenen boyut. Birleşmiş bölümler bu büyüklüğe yakın, ancak daha büyük değildir. |
spark.sql.adaptive.coalescePartitions.minPartitionSize |
Byte String |
1MB |
Birleştirildikten sonraki bölümlerin minimum boyutu. Birleşmiş bölüntüler bu boyuttan küçük değildir. |
spark.sql.adaptive.coalescePartitions.minPartitionNum |
Integer |
Küme çekirdeği sayısının iki katı | Birleştirme sonrası minimum bölüm sayısı. Bu özelliği ayarlamayın, çünkü bunu ayarlamak spark.sql.adaptive.coalescePartitions.minPartitionSize öğesini geçersiz kılar. |
Çarpık birleşimi dinamik olarak ele alma
| Mülk | Type | Default | Description |
|---|---|---|---|
spark.sql.adaptive.skewJoin.enabled |
Boolean |
true |
Eğik birleştirme işlemeyi açar veya kapatır. |
spark.sql.adaptive.skewJoin.skewedPartitionFactor |
Integer |
5 |
Bir bölümün çarpık olarak kabul edilmesi için aşması gereken medyan bölüm boyutu katsayısı. |
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes |
Byte String |
256MB |
Bir partisyonun çarpık olarak kabul edilmesi için aşması gereken minimum boyut. |
AQE, bir bölümü yalnızca bu iki koşul da doğru olduğunda çarpık olarak ele alır: (partition size > skewedPartitionFactor * median partition size) ve (partition size > skewedPartitionThresholdInBytes).
Sık sorulan sorular (SSS)
AQE neden küçük bir birleştirme tablosu yayınlamadı?
Tablo spark.databricks.adaptive.autoBroadcastJoinThreshold değerinden küçükse ama AQE yayınlamıyorsa, şu nedenleri kontrol edin:
- Birleştirme türü broadcast'ı desteklemiyor. Bazı birleştirme türleri bir tarafı broadcast edemez. Örneğin, AQE bir
LEFT OUTER JOIN'nin sol tarafını dağıtamaz. - Tabloda birçok boş bölümleme bulunur. Sort-merge join işlemindeki görevlerin çoğu hızla tamamlanır veya skew join işleme birleştirmeyi optimize eder. AQE, sıralama birleştirme birleşimini, boş olmayan bölümlerin yüzdesi
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoindeğerinden düşükse yayın hash birleşimine dönüştürmez.
AQE etkin iken yine de bir yayın birleştirme ipucu kullanmalı mıyım?
Evet, sorgunuzu iyi biliyorsanız. Optimizer'ın sorgu çalışmadan önce planladığı bir yayın birleşimi, genellikle AQE'nin çalışma zamanında planladığından daha iyi performans gösterir. AQE, join'in her iki tarafını shuffle ettikten sonra, yani gerçek tablo boyutlarını ancak bu aşamada öğrendiği zaman, broadcast join'e geçmeyebilir.
AQE, sorgu ipuçlarına statik optimizasyon gibi saygı gösterir ve ipuçlarının etkilemediği dinamik optimizasyonları hâlâ uygular.
Skew join ipucu mu kullanmalıyım yoksa AQE skew join handling mi kullanmalıyım?
AQE skew join handling kullanın. Bu otomatik ve genellikle skew join ipucundan daha iyi performans gösterir.
AQE neden join işlemlerimi yeniden sıralamadı?
AQE, çalışma zamanında birleştirmeleri yeniden sıralamıyor. Join sırasını iyileştirmek için, maliyet tabanlı optimizatörün daha iyi bir plan seçebilmesi için tablo istatistiklerini toplayın. Maliyet tabanlı eniyileyiciye bakınız.
AQE neden veri dengesizliğimi algılamadı?
AQE, bir bölümü yalnızca bu iki koşul da doğru olduğunda çarpık olarak ele alır:
- Bölüm,
256MBdeğerinden daha büyüktür (varsayılanspark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes). - Bölüm, medyan bölüm boyutunun
5(varsayılanspark.sql.adaptive.skewJoin.skewedPartitionFactor) katından daha büyüktür.
AQE ayrıca sadece shuffle tabanlı birleştirmelerde (shuffle-based joins) eğikliği yönetir; bunlar sort merge join'lar ve shuffle hash join'lardır. Broadcast join'lerde veri çarpıklığını asla optimize etmez. Shuffle tabanlı birleştirmeler için, birleştirme türü AQE'nin hangi tarafı optimize edebileceğini belirler:
| Katılım türü | Sol tarafa göre optimize edilmiş eğim | Sağ tarafa göre optimize edilmiş eğiklik |
|---|---|---|
INNER |
Yes | Yes |
CROSS |
Yes | Yes |
LEFT OUTER |
Yes | Hayır |
RIGHT OUTER |
Hayır | Yes |
LEFT SEMI |
Yes | Hayır |
LEFT ANTI |
Yes | Hayır |
FULL OUTER |
Hayır | Hayır |
Miras
Spark 1.6, uyarlamalı yürütme adı verilen bir özellik tanıttı, ancak Spark 3.0'daki AQE farklı bir özelliktir. Spark 1.6 uyarlamalı yürütme yalnızca bölümleri dinamik olarak birleştirir. AQE, çalışma zamanı istatistiklerine dayalı sorguları planlayan ve yeniden planlayan bir çerçevedir ve bu sayfadaki tüm optimizasyonları destekler.