Not
Bu sayfaya erişim yetkilendirme gerektiriyor. Oturum açmayı veya dizinleri değiştirmeyi deneyebilirsiniz.
Bu sayfaya erişim yetkilendirme gerektiriyor. Dizinleri değiştirmeyi deneyebilirsiniz.
Important
Bu makalede önizleme olarak işaretlenmiş öğeler şu anda önizleme aşamasındadır. Bu önizleme, hizmet düzeyi sözleşmesi olmadan sağlanır ve Microsoft üretim iş yükleri için bunu önermez. Bazı özellikler desteklenmeyebilir veya kısıtlı özelliklere sahip olabilir. Daha fazla bilgi için bkz. Microsoft Azure Önizlemeleri için Ek Kullanım Koşulları.
Important
Etkileşimli eğitim için açık erişim onayı gerekir. Önizleme kayıt formu aracılığıyla erişim isteyin ve eğitim oturumu oluşturmadan önce onay bekleyin.
Etkileşimli eğitim (önizleme), Microsoft Foundry'de açık ağırlık modelleri üzerinde kendi post-training döngünüzü oluşturmaya yönelik bir API'dir. Deneyi Python'da kontrol edebilirsiniz. Foundry, sunucusuz GPU'larda model örnekleme ve düşük dereceli uyarlama (LoRA) güncelleştirmelerini çalıştırır.
Pekiştirme öğrenmesi (RL) için kodunuz rollout toplama sürecini, ödülleri, avantajları ve güncelleştirme zamanlamasını denetler. Aynı temel öğeler denetimli öğrenme, tercih öğrenmesi, damıtma ve özel kayıp iş akışlarını destekler.
Ne zaman kullanılır?
Eğitim döngüsünün kendisi araştırmanızın bir parçası olduğunda etkileşimli eğitimi kullanın:
- Özel bir öğrenme sinyaline ihtiyacınız var. Gösterimler sağlayın, ödülleri ve avantajları hesaplayın ya da tercih öğrenmesi veya diğer amaçlar için yerel bir kayıp oluşturun.
- Modeliniz bir ortamla etkileşim kurar. Sürücünüzde model yanıtlarını, araç çağrılarını, gözlemleri ve ödülleri koordine edin.
- Tek tek güncelleştirmeler üzerinde denetime sahip olmanız gerekir. Grupları, belirteç maskelerini, kayıp ayarlarını ve iyileştirici parametrelerini seçin. Gradientlerin ne zaman birikeceğine karar verin ve bir güncelleştirme uygulayın.
- Bir denemeyi incelemek ve uyarlamak istiyorsunuz. Geçerli bağdaştırıcıdan örnek alın, değerlendirme için ayrılan istemleri değerlendirin ve gözlemlenen sonuçlara göre sonraki istemleri seçin.
- İlerlemeyi korumanız ve sürdürmeniz gerekir. Adaptörü ve optimizatör durumunu kaydedin, ardından uyumlu bir oturumda devam edin. Driver'ınızda veri kümesi konumunu ve diğer deney durumunu koruyun.
Yönetilen ince ayar, pekiştirmeli ince ayarlama için değerlendiricileri de destekler. Yalnızca grader veya iş ayarları değil, döngü üzerinde denetime ihtiyacınız olduğunda etkileşimli eğitimi seçin. Bkz. Eğitim yaklaşımınızı seçin.
Kim ne yapar?
Python programınız eğitim sürücüsüdür. Girişleri hazırlar ve deneyi koordine eder. Foundry model ve bağdaştırıcı durumunu korur ve istenen işlemleri yürütür.
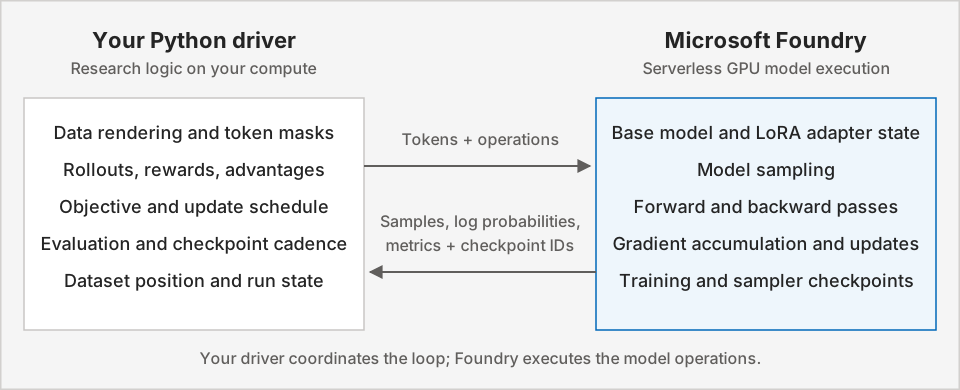
Sürücünüz, kendi makineniz veya hesaplama ortamınız da dahil olmak üzere bir CPU üzerinde çalışabilir. Eklediğiniz bir ödül modelinin veya ortamın kendi işlem gereksinimleri olabilir. Döngüyü yönetirken işlemi çalışır durumda tutun.
Temel kavramlar ve primitifler
Bir oturum durum bilgisine sahiptir: gradyan hesaplama, iyileştirici güncelleştirmeleri ve örnekleme, seçilen model ve bağdaştırıcı üzerinde ayrı işlemlerdir. Bu ayrım, verileri ne zaman toplayacağınızı, gradyanları ne zaman biriktireceğinizi, ne zaman güncelleme yapacağınızı ve ne zaman değerlendireceğinizi seçmenize olanak tanır.
| Yapı taşı | Ne işe yarıyor? |
|---|---|
| Eğitim oturumu ve LoRA adaptörü |
FineTuningSession.create bağdaştırıcı yapılandırmanızla desteklenen bir temel modeli başlatır. Oturum, sonraki işlemler tarafından kullanılan durumu tutar. |
| Tokenize edilmiş yığın ve maskeler |
Datum model girişleri ve kayıp girişleri taşır. Maskeler, istemler veya araç gözlemleri yerine asistan belirteçleri gibi öğrenmeye katkıda bulunan belirteçleri seçer. |
| Örnekleme |
sample seçili sampler checkpoint'inden yanıtlar oluşturur. RL girişleri, örneklenmiş belirteçleri rollout log olasılıkları ve ödül türetilmiş avantajlarıyla eşleştirir. |
| İleri ve geri geçişler |
forward gradyanları biriktirmeden örnek başına loss-function çıkışlarını döndürür.
forward_backward seçili hedefi hesaplar ve gradyanları biriktirir. Optimizer güncellemesi uygulamaz. |
| Optimizer güncellemesi |
optim_step Adam parametrelerinizle birikmiş gradyanları uygular. Ne zaman güncelleştirileceğini ve hangi öğrenme oranının kullanılacağını seçersiniz. |
| Örnekleyici kontrol noktası |
save_weights_for_sampler bağdaştırıcı ağırlıklarını üretim için hazırlar. Güncelleştirilmiş bağdaştırıcıdan örneklemeden önce bir güncelleştirmeden sonra bu ağırlıkları yenileyin. |
| Eğitim kontrol noktası |
save_weights bağdaştırıcı ağırlıklarını ve iyileştirici durumunu kalıcı hale getirmektedir.
FineTuningSession.create_from_checkpoint uyumlu bir oturumda eğitime devam eder. |
SDK, denetimli güncelleştirmeler ve ppo ile cross_entropy gibi RL kayıpları için importance_sampling içerir. Bu kayıplar, önceden tanımlanmış uçtan uca algoritmalar değil, kayıp ilkelleridir. Giriş sözleşmeleri ve özel kayıp bileşimi için bkz. Temel kavramlar.
RL döngüsü nasıl çalışır?
Bir matematik mantığı denemesi düşünün: modeliniz her soruna çeşitli yanıtlar oluşturur ve programınız bunların doğruluğunu not eder. Adım adım örnek için Başlarken'i izleyin.
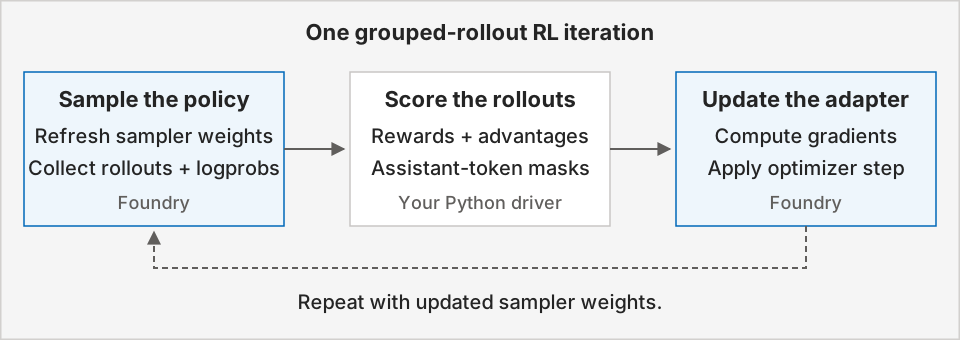
İlk güncelleştirmeden önce ayrılmış bir temel karşılaştırma ölçütü oluşturun ve ödül işlevinizi test edin. Ardından tekrarlayın:
- Geçerli politikayı örnekleme için hazırlayın. Eğitim bağdaştırıcısından örnekleyici ağırlıklarını kaydedin, ardından her istem için çeşitli yanıtlar veya rollout'lar toplayın.
- Yanıtları puanlayıp karşılaştırın. Ödül işleviniz her rollout'a bir puan atar. Her rollout’un advantage değerini elde etmek için prompt grubunun ortalama ödülünü çıkarın.
- Öğrenme sinyalini hazırlayın. Örneklenmiş asistan tokenlerini rollout log olasılıkları ve avantajlarıyla hizalayın. İstemleri ve ortam gözlemlerini öğrenme sinyalinin dışında tutun.
- Gradyanları hesaplayın. Toplu işlemi
forward_backwardöğesineimportance_samplingile gönderin. Onu kullanan güncelleştirmeden önce gradyan hesaplamasını tamamlayın. - Adaptörü güncelleyin.
optim_stepçağrısını yapın, ardından güncelleştirilmiş ilkeden yanıt toplamadan önce örnekleyici ağırlıklarını yenileyin. - İlerlemeyi değerlendirin ve koruyun. Doğrulama doğruluğunu taban çizgisiyle karşılaştırın ve seçtiğiniz tempoda eğitim denetim noktalarını kaydedin.
Get started
Görevinize uygun başlangıç noktasını seçin:
- Hızlı Başlangıç:hızlı başlangıç örneğini izleyerek depoyu klonlayın ve kısa bir pekiştirmeli öğrenme örneğini çalıştırın.
- Diğer tarifleri deneyin: Daha fazla eğitim örneği için fine-tuning örnekleri deposunu keşfedin.
- bir işlemi arayın: İşlevler ve anahtar parametreleri için SDK bilgi sayfasını (önizleme) kullanın.
- Eğitim döngüsünü anlama: Ödüller, avantajlar, belirteç maskeleri ve denetim noktaları için önemli kavramları okuyun.
Desteklenen modeller ve bölgeler
Desteklenen modeller ve desteklenen bölgeler için ince ayarlamaya genel bakışa bakın.