Not
Bu sayfaya erişim yetkilendirme gerektiriyor. Oturum açmayı veya dizinleri değiştirmeyi deneyebilirsiniz.
Bu sayfaya erişim yetkilendirme gerektiriyor. Dizinleri değiştirmeyi deneyebilirsiniz.
Şunlar için geçerlidir: SQL ServerAzure SQL VeritabanıAzure SQL Yönetilen ÖrneğiMicrosoft Fabric'te SQL veritabanı
SQL Server Veritabanı Altyapısı, yerel tablolar, bölümlenmiş tablolar ve birden çok sunucuya dağıtılmış tablolar gibi çeşitli veri depolama mimarilerindeki sorguları işler. Aşağıdaki bölümler, Database Engine'in sorguları nasıl işlediğini ve yürütme planı önbellekleme yoluyla sorgu yeniden kullanımını nasıl optimize ettiğini ele alır.
Bu makaledeki kod örnekleri, Azure Data SQL Samples Repository GitHub deposundan indirebileceğiniz , AdventureWorksDW2025, veya AdventureWorksLT2025 örnek veritabanını kullanırAdventureWorks2025.
Yürütme modları
SQL Server Database Engine, iki farklı işlem modu kullanarak Transact-SQL (T-SQL) ifadelerini işleyebilir:
- Satır modu yürütme
- Toplu modda yürütme
Satır modu yürütme
Satır modunda yürütme, verilerin satır biçiminde saklandığı satır deposu tabloları ve indekslerle kullanılan bir sorgu işleme yöntemidir. Bir sorgu yürütüldüğünde ve rowstore tabloları ile dizinlerdeki verilere erişildiğinde, yürütme ağacı operatörleri ve alt operatörler, nesne şemasında belirtilen tüm sütunlar boyunca gerekli her satırı okur. Okunan her satırdan, Database Engine ardından JOIN ifadesi, SELECT yüklemi veya filtre yüklemiyle referans verilen sonuç kümesi için gerekli sütunları alır.
Uyarı
Satır modu yürütme OLTP senaryoları için çok verimlidir, ancak büyük miktarda veri taranırken daha az verimli olabilir, örneğin Veri Depolama senaryolarında.
Toplu modda yürütme
Toplu modda yürütme , birden fazla satırı birlikte işleyen bir sorgu işleme yöntemidir (bu nedenle toplu kelime terimi de kullanılır). Toplu iş içindeki her sütun, ayrı bir bellek alanında vektör olarak depolanır, bu nedenle toplu iş modu işleme vektör tabanlıdır. Toplu mod işleme ayrıca, gelişmiş komut setleri ve modern işlemcilerde artan bellek aktarım hızı için optimize edilmiş algoritmalar kullanır.
Toplu mod yürütme başlangıçta columnstore depolama formatı etrafında entegre edilip optimize edilmişti. SQL Server 2019 (15.x) ile ve Azure SQL Veritabanı'de başlayarak, toplu modda çalıştırma için columnstore indeksleri gerekmez. Daha fazla bilgi için bkz. Rowstore'da Batch modu.
Toplu mod işleme, mümkün olduğunda sıkıştırılmış veri üzerinde çalışır ve satır modunun yürütülmesinde kullanılan exchange operator'ünü ortadan kaldırır. Sonuç daha iyi paralellik ve daha hızlı performanstır.
Bir sorgu toplu modda çalıştığında ve columnstore indekslerinde verilere eriştiğinde, yürütme ağacı operatörleri ve alt operatörler birden fazla satırı sütun segmentlerinde birlikte okur. Database Engine, yalnızca sonuç için gereken sütunları, bir SELECT deyimi, JOIN yüklemi veya filtre yüklemi tarafından başvurulan şekilde okur. Columnstore indeksleri hakkında daha fazla bilgi için Columnstore Index Architecture'a bakınız.
Uyarı
Toplu modda yürütme, büyük miktarda veriyi okuyup topladığı veri depolama senaryolarında oldukça etkilidir.
SQL deyimi işleme
Tek bir T-SQL deyimini işlemek, Database Engine'in T-SQL ifadelerini çalıştırmasının en temel yoludur. Aşağıdaki adımlar, yalnızca yerel temel tablolara (görünüm veya uzak tablolara başvurmayan) tek bir SELECT SQL deyimini işleyerek temel süreci göstermektedir.
Mantıksal işleç önceliği
Bir ifadede birden fazla mantıksal operatör kullandığınızda, NOT önce değerlendirilir, sonra AND, ve son olarak OR. Aritmetik ve bit bazında operatörler, mantıksal operatörlerden önce ele alınır. Daha fazla bilgi için bkz. Operatör önceliği.
Aşağıdaki örnekte, renk koşulu ürün modeli 21 için geçerlidir, ürün modeli 20 için değil, çünkü AND, OR üzerinde önceliğe sahiptir.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR ProductModelID = 21
         AND Color = 'Red';
GO
Parantez kullanmak, zorunlu olmasa bile, sorguların okunabilirliğini artırabilir ve operatör önceliği nedeniyle hata yapma riskini azaltabilir. Aşağıdaki örnek, önceki örneğe göre daha okunabilir ve aynı anlama sahiptir.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR (ProductModelID = 21
          AND Color = 'Red');
GO
Parantez ekleyerek OR'nın öncelikli değerlendirilmesini sağlamak için sorgunun anlamını değiştirebilirsiniz. Aşağıdaki sorgu yalnızca 20 ve 21 modellerinin altındaki kırmızı olan ürünleri bulur.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE (ProductModelID = 20
       OR ProductModelID = 21)
      AND Color = 'Red';
GO
SELECT deyimlerini iyileştirme
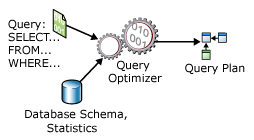
Deyim SELECT yordamsal değildir; veritabanı sunucusunun istenen verileri almak için kullanması gereken adımları tam olarak belirtmez. Bu deklaratif davranış, veritabanı sunucusunun talep edilen veriyi en verimli şekilde çıkarmanın yolunu belirlemek için ifadeyi ve veritabanını analiz etmesini gerektirir. Bu sürece sorgu planı optimizasyonu denir. Bu görevi gerçekleştiren bileşen Sorgu İyileştiricisi'dir. Query Optimizer'a girdi, sorgu, veritabanı şeması (nesne tanımları) ve nesne istatistiklerinden oluşur. Sorgu Optimizator'un çıktısı, bazen sorgu planı veya yürütme planı olarak da adlandırılan bir sorgu yürütme planıdır. Bir yürütme planının içeriği, Yürütme planı önbellekleme ve yeniden kullanım bölümünde daha ayrıntılı olarak açıklanmıştır.
Aşağıdaki diyagram, tek bir SELECT bildiriminin optimizasyonu sırasında Sorgu İyileştiricisi'nin giriş ve çıktılarını göstermektedir:
Bir SELECT ifade yalnızca şunları tanımlar:
- Sonuç kümesinin biçimi. Bu çoğunlukla seçme listesinde belirtilir. Ancak diğer yan tümceler örneğin
ORDER BYveGROUP BY, sonuç kümesinin son biçimini de etkiler. - Kaynak verileri içeren tablolar. Bu,
FROMmaddesinde belirtilir. - Tabloların ifadenin amaçları için mantıksal olarak nasıl ilişkili olduğu. Bu, join ifadesinde tanımlanır; bu ifade,
WHEREyan tümcesinde veyaFROMsonrasındaki birONyan tümcesinde bulunabilir. - Kaynak tablolardaki satırların
SELECTifadesini karşılaması için gereken koşullar. BunlarWHEREveHAVINGyan tümcelerinde belirtilir.
Bir sorgu yürütme planı şunları tanımlar:
Kaynak tablolara erişilen sıra.
Genellikle, veritabanı sunucusu sonuç kümesini oluşturmak için temel tablolara birçok farklı sırayla erişebilir. Örneğin,
SELECTdeyimi üç tabloya başvuruyorsa, veritabanı sunucusu önceTableAöğesine erişebilir,TableAiçindeki verileri kullanarakTableBiçindeki eşleşen satırları ayıklayabilir ve ardındanTableBiçindeki verileri kullanarakTableCiçindeki verileri ayıklayabilir. Veritabanı sunucusunun tablolara erişebildiği diğer sıralar şunlardır:TableC,TableB,TableAveya
TableB,TableA,TableCveya
TableB,TableC,TableAveya
TableC,TableA,TableBHer tablodan veri ayıklamak için kullanılan yöntemler.
Genel olarak, her tablodaki verilere erişmek için farklı yöntemler vardır. Belirli anahtar değerlerine sahip birkaç satır gerekirse, veritabanı sunucusu satırları hızlıca bulabilir veya küçük bir indeks aralığı tarayabilir. Tablodaki tüm satırlar gerekiyorsa, veritabanı sunucusu bunun yerine tüm tabloyu veya indeksi tarayabilir. Bir tablodaki tüm satırlar gerekiyorsa ama anahtar sütunları bir
ORDER BYiçinde olan bir indeks varsa, tablo taraması yerine indeks taraması yapmak sonuç kümesinin ayrıca sıralanmasını gereksiz kılabilir. Bir tablo çok küçükse, tam taramalar neredeyse tüm tabloya erişim için en verimli yöntem olabilir.Hesaplamaları hesaplamak için kullanılan yöntemler ve her tablodan verileri filtreleme, toplama ve sıralama.
Veriler tablolardan erişildiğinde, farklı yöntemler veri üzerinde hesaplamalar yapar; örneğin skaler değerleri hesaplar ve sorgu metninde tanımlandığı gibi verileri toplulaştırır ve sıralar. Örneğin, bir
GROUP BYveyaORDER BYkoşulu kullanırken ve örneğin birWHEREveyaHAVINGkoşulu kullanırken verilerin nasıl filtreleneceği.
Olası birçok plandan bir yürütme planı seçme işlemi iyileştirme olarak adlandırılır. Sorgu İyileştiricisi, Veritabanı Altyapısı'nın en önemli bileşenlerinden biridir. Query Optimizer, sorguyu analiz etmek ve bir plan seçmek için bir miktar ek yük gerektirse de, Query Optimizer verimli bir yürütme planı seçtiğinde bu ek yük genellikle katbekat telafi edilir. Örneğin, iki inşaat şirketine bir ev için aynı şemalar verilebilir. Bir şirket evin nasıl inşa edileceğini planlamak için başlangıçta birkaç gün harcarsa ve diğer şirket plan yapmadan inşaata başlarsa, projesini planlamak için zaman ayıran şirket muhtemelen önce bitirir.
Query Optimizer maliyet tabanlı bir optimizatordur. Her olası yürütme planının, kullanılan bilgi işlem kaynaklarının miktarı açısından ilişkili bir maliyeti vardır. Sorgu İyileştirici olası planları analiz etmeli ve tahmini maliyeti en düşük olanı seçmelidir. Bazı karmaşık ifadeler binlerce olası yürütme planına sahiptir. Bu gibi durumlarda Sorgu İyileştiricisi tüm olası birleşimleri analiz etmez. Bunun yerine, maliyeti mümkün olan en düşük maliyete oldukça yakın bir yürütme planı bulmak için karmaşık algoritmalar kullanır.
Query Optimizer, en düşük tahmini maliyete sahip yürütme planını mutlaka seçmez. Optimizasyon için uygun zaman içinde makul bir tahmini maliyete sahip bir plan bulur. Paralel bir yürütme planı, seri plandan daha fazla kaynak kullanabilir ve tahmini geçen zamanı azaltabilir.
SQL Server Sorgu İyileştiricisi, bir tablo veya indeksten bilgi çıkarmak için farklı yöntemlerin kaynak maliyetlerini tahmin ederken istatistiklere dayanır. İstatistikler sütunlar ve indeksler için saklanır ve temel verinin yoğunluğu1 hakkında bilgi içerir. Bu bilgi, belirli bir indeks veya sütundaki değerlerin seçiciliğini gösterir. Örneğin, arabaları temsil eden bir tabloda, birçok araba aynı üreticiye sahiptir, ancak her arabanın benzersiz bir araç kimlik numarası (VIN) vardır. VIN üzerindeki bir dizin, üreticideki bir dizinden daha seçicidir, çünkü VIN üreticiden daha düşük yoğunluğa sahiptir. Dizin istatistikleri geçerli değilse, Sorgu İyileştiricisi tablonun geçerli durumu için en iyi seçimi yapamayabilir. Yoğunluklar hakkında daha fazla bilgi için bkz. İstatistikler.
1 Yoğunluk, verilerde bulunan benzersiz değerlerin dağılımını veya belirli bir sütun için ortalama yinelenen değer sayısını tanımlar. Yoğunluk azaldıkça değerin seçiciliği artar.
Sorgu İyileştiricisi önemlidir çünkü veritabanı sunucusunun veritabanındaki değişen koşullara dinamik olarak uyum sağlamasını sağlar ve bir geliştirici veya veritabanı yöneticisinden giriş gerektirmez. Bu özellik, geliştiricilerin sorgunun nihai sonucunu tanımlamaya odaklanmasını sağlar. Bir ifade için sorgu planı optimize edildiğinde, veritabanının mevcut durumuna göre verimli bir yürütme planı oluşturacak Sorgu İyileştiricisi'ne güvenebilirler.
Uyarı
SQL Server Management Studio'nun yürütme planlarını görüntülemek için üç seçeneği vardır:
- Tahmini Yürütme Planı, yani Sorgu Optimizeri tarafından üretilen derlenmiş plan.
- Gerçek Yürütme Planı, derlenmiş plan ile yürütme bağlamının toplamıyla aynıdır. Bu bağlam, çalıştırma tamamlandıktan sonra kullanılabilen çalışma zamanı bilgilerini, örneğin çalışma uyarılarını veya Database Engine'in yeni sürümlerinde yürütme sırasında kullanılan geçen süreyi ve CPU süresini içerir.
- Canlı Sorgu İstatistikleri, derlenmiş plan ile yürütme bağlamının toplamıyla aynıdır. Bu bağlam, yürütme ilerlemesi sırasında çalışma zamanı bilgilerini içerir ve her saniye güncellenir. Çalışma zamanı bilgisi, örneğin, operatörlerden geçen gerçek satır sayısını içerir.
SELECT deyimini işleme
Database Engine, tek SELECT bir ifadeyi şu adımları takip ederek işler:
- Ayrıştırıcı deyimi tarar
SELECTve anahtar sözcükler, ifadeler, işleçler ve tanımlayıcılar gibi mantıksal birimlere böler. - Bazen dizi ağacı olarak da adlandırılan bir sorgu ağacı, kaynak veriyi sonuç kümesinin gerektirdiği formata dönüştürmek için gereken mantıksal adımları tanımlayacak şekilde oluşturulur.
- Sorgu İyileştiricisi, kaynak tablolara erişmenin farklı yollarını analiz eder. Daha az kaynak kullanırken sonucu en hızlı veren adımlar dizisini seçer. Sorgu ağacını bu tam adım dizisini kaydedecek şekilde günceller. Sorgu ağacının son, iyileştirilmiş sürümü yürütme planı olarak adlandırılır.
- İlişkisel motor planı uygulamaya başlar. Temel tablolardan veri gerektiren adımları işlerken, depolama motorundan gerekli satır kümelerini ister.
- İlişkisel altyapı, depolama altyapısından döndürülen verileri sonuç kümesi için tanımlanan biçime işler ve sonuç kümesini istemciye döndürür.
Sürekli katlama ve ifade değerlendirmesi
Veritabanı Altyapısı, sorgu performansını geliştirmek için bazı sabit ifadeleri erken değerlendirir. Query Optimizer tarafından kullanılan bu optimizasyon tekniği, ifadeleri çalışma zamanında değil, derleme zamanında basitleştirmeyi amaçlar. Sonuçta elde edilen yürütme planının daha verimli olması için sorgu derlemesi sırasında sabit ifadelerin değerlendirilmesi gerekir. Bu süreç sabit katlama olarak adlandırılır. Bir sabit, 0x12345678, '2025-12-31', 3, 'ABC' veya 1.0e3 gibi bir T-SQL literalidir. Örneğin, şu sorguyu alın:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 30 * 12, '2025-01-01');
Burada ise 30 * 12, sabit bir ifadedir. Database Engine, derleme sırasında bu ifadeyi değerlendirir ve sorguyu dahili olarak şu şekilde yeniden yazabilir:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 360, '2025-01-01');
Katlanabilir ifadeler
Database Engine, aşağıdaki ifade türleriyle constant folding kullanır:
- Aritmetik ifadeler, yalnızca sabitleri içeren
1 + 1ve5 / 3 * 2gibi. - Yalnızca sabitleri içeren mantıksal ifadeler,
1 = 1ve1 > 2 AND 3 > 4gibi. - Database Engine'in katlanabilir olarak kabul ettiği yerleşik fonksiyonlar,
CASTveCONVERTdahil. Genel olarak, bir içsel fonksiyon yalnızca girdilerine bağlıysa veSETseçenekleri, dil ayarları, veritabanı seçenekleri ve şifreleme anahtarları gibi diğer bağlamsal bilgilere bağlı değilse katlanabilir. Belirsiz işlevler katlanabilir değildir. Bazı özel durumlar dışında deterministik yerleşik işlevler katlanabilir. - CLR kullanıcı tanımlı tiplerin deterministik yöntemleri ve deterministik skaler değerli CLR kullanıcı tanımlı fonksiyonları. Daha fazla bilgi için CLR User-Defined İşlevleri ve Yöntemleri için Sabit Katlama sayfasına bakın.
Uyarı
Büyük nesne türleri için özel durum oluşturulur. Eğer katlama sürecinin çıktı tipi büyük bir nesne türüyse (text, ntext, image, nvarchar(max), varchar(max), varbinary(max), json veya xml), Database Engine ifadeyi katlamaz.
Katlanamayan ifadeler
Diğer tüm ifade türleri katlanabilir değildir. Özellikle, aşağıdaki ifade türleri katlanabilir değildir:
- Sonucu bir sütunun değerine bağlı olan ifade gibi tutarsız ifadeler.
- Sonuçları gibi yerel bir değişkene veya parametreye
@xbağlı olan ifadeler. - Belirsiz işlevler.
- Kullanıcı tanımlı T-SQL fonksiyonları.
- Sonuçları dil ayarlarına bağlı olan ifadeler.
- Sonuçları seçeneklere bağlı
SETolan ifadeler. - Sonuçları sunucu yapılandırma seçeneklerine bağlı olan ifadeler.
Katlanabilir ve katlanabilir olmayan sabit ifade örnekleri
Aşağıdaki sorguyu göz önünde bulundurun:
USE AdventureWorks2025;
GO

SELECT *
FROM Sales.SalesOrderHeader AS s
     INNER JOIN Sales.SalesOrderDetail AS d
         ON s.SalesOrderID = d.SalesOrderID
WHERE TotalDue > 117.00 + 1000.00;
Veritabanı PARAMETERIZATION seçeneği bu sorgu için FORCED olarak ayarlanmadıysa, ifade 117.00 + 1000.00 değerlendirilir ve sorgu derlenmeden önce sonucu olan 1117.00 ile değiştirilir. Bu sabit katlamanın faydaları şunlardır:
- İfadenin çalışma zamanında tekrar tekrar değerlendirilmesi gerekmez.
- Değerlendirildikten sonraki ifadenin değeri, Sorgu İyileştiricisi tarafından sorgunun
TotalDue > 117.00 + 1000.00bölümünün sonuç kümesinin boyutunu tahmin etmek için kullanılır.
Öte yandan, dbo.f kullanıcı tanımlı bir skaler fonksiyon ise, ifade dbo.f(100) katlanmaz, çünkü Database Engine, deterministik olsalar bile kullanıcı tanımlı fonksiyonları içeren ifadeleri katlamaz. Parametrizasyon hakkında daha fazla bilgi için bkz. zorunlu parametre kullanımı.
İfade değerlendirmesi
Buna ek olarak, sabit katlanmamış ancak bağımsız değişkenleri derleme zamanında bilinen, bağımsız değişkenlerin parametre mi yoksa sabit mi olduğu bilinen bazı ifadeler, iyileştirme sırasında iyileştiricinin bir parçası olan sonuç kümesi boyutu (kardinalite) tahmin aracı tarafından değerlendirilir.
Özellikle, aşağıdaki yerleşik işlevler ve özel işleçler, tüm girişleri biliniyorsa derleme zamanında değerlendirilir: UPPER, , LOWERRTRIM, DATEPART( YY only ), , GETDATE, CASTve CONVERT. Aşağıdaki işleçler, tüm girişleri biliniyorsa derleme zamanında da değerlendirilir:
- Aritmetik operatörler:
+,-,*,/, tekli- - Mantıksal operatörler:
AND,OR,NOT - Karşılaştırma operatörleri:
<,>,LIKE,>=,<>,IS NULL,<=,IS NOT NULL
Kardinalite tahmini sırasında Sorgu İyileştiricisi tarafından başka hiçbir işlev veya işleç değerlendirilmez.
Derleme zamanı ifade değerlendirmesi örnekleri
Bu saklı yordamı dikkate alın:
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc
(
    @d DATETIME
)
AS
SELECT COUNT(*)
FROM Sales.SalesOrderHeader
WHERE OrderDate > @d + 1;
Yordamdaki deyiminin SELECT iyileştirilmesi sırasında Sorgu İyileştiricisi, koşul OrderDate > @d + 1için sonuç kümesinin beklenen kardinalitesini değerlendirmeye çalışır. İfade @d + 1, sabit katlanmış değildir, çünkü @d bir parametredir. Ancak, iyileştirme zamanında parametresinin değeri bilinir. Bu değer, Sorgu İyileştiricisi'nin sonuç kümesinin boyutunu doğru tahmin etmesini sağlar ve bu da iyi bir sorgu planı seçmesine yardımcı olur.
Şimdi, önceki örneğe benzer bir örneği ele alalım; ancak bu örnekte sorguda @d2 yerine @d + 1 yerel değişkeni kullanılır ve ifade sorguda değil, bir SET deyiminde değerlendirilir.
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc2
(
    @d DATETIME
)
AS
BEGIN
    DECLARE @d2 AS DATETIME;
    SET @d2 = @d + 1;
    SELECT COUNT(*)
    FROM Sales.SalesOrderHeader
    WHERE OrderDate > @d2;
END
MyProc2 içindeki SELECT deyimi Veritabanı Altyapısı'nda iyileştirildiğinde, @d2 değerinin ne olduğu bilinmez. Bu nedenle, Sorgu İyileştiricisi OrderDate > @d2 seçiciliği için varsayılan bir tahmin kullanır (bu durumda yüzde 30).
Diğer ifadeleri işleme
Bir SELECT ifadeyi işlemenin temel adımları, UPDATE, DELETE ve INSERT gibi diğer T-SQL ifadeleri için de geçerlidir. Her ikisi UPDATE ve DELETE ifadeleri, değiştirilecek veya silinecek satır kümesini hedeflemelidir. Bu satırları tanımlama işlemi, bir SELECT deyiminin sonuç kümesine katkıda bulunan kaynak satırları tanımlamak için kullanılan işlemle aynıdır. Her iki UPDATE ve INSERT ifadesi de güncellemek veya eklemek için veri değerlerini sağlayan gömülü SELECT ifadeler içerebilir.
Hatta Veri Tanım Dili (DDL) ifadeleri, örneğin CREATE PROCEDURE veya ALTER TABLE, sistem katalog tabloları üzerinde ve bazen (örneğin ALTER TABLE ADD COLUMN) veri tablolarına karşı bir dizi ilişkisel işleme indirgenir.
Çalışma Masaları
İlişkisel motorun, T-SQL ifadesinde belirtilen mantıksal bir işlemi gerçekleştirmek için bir çalışma tablosu oluşturması gerekebilir. Çalışma tabloları, ara sonuçları tutan iç tablolardır. Çalışma masaları belirli GROUP BY, ORDER BYveya UNION sorgular için oluşturulur. Örneğin, bir ORDER BY yan tümce herhangi bir indeksle kapsatılmayan sütunlara referans verirse, ilişkisel motorun sonuç kümesini istenen sıraya göre sıralamak için bir çalışma tablosu oluşturması gerekebilir. Çalışma tabloları, bazen sorgu planının bir bölümünün yürütülmesinin sonucunu geçici olarak tutan makaralar olarak da kullanılır. Çalışma tabloları tempdb içinde oluşturulur ve artık ihtiyaç duyulmadığında otomatik olarak silinir.
Çözünürlüğü görüntüle
Database Engine sorgu işlemcisi, indekslenmiş ve indekslenmemiş görünümleri farklı şekilde ele alır:
- Veritabanı, indekslenmiş bir görünümün satırlarını bir tabloyla aynı formatta saklar. Eğer Sorgu Optimizer'ı bir sorgu planında indeksli görünüm kullanmaya karar verirse, indekslenmiş görünümü bir temel tablo gibi ele alır.
- Görünümün satırları değil, yalnızca dizinlenmemiş görünümün tanımı depolanır. Sorgu İyileştiricisi, görünüm tanımındaki mantığı, indekslenmemiş görünüme referans veren T-SQL ifadesi için oluşturduğu yürütme planına dahil eder.
Query Optimizer'ın indeksli görünümü ne zaman kullanacağına karar vermek için kullandığı mantık, bir tabloda indeks kullanımına karar verirken kullandığı mantığa benzer. İndekslenen görünümdeki veriler T-SQL ifadesinin tamamını veya bir kısmını kapsıyorsa ve Sorgu Optimizer'ı görünümdeki bir indeksin düşük maliyetli erişim yolu olduğunu belirlerse, sorgu görünüme adını kullanarak başvursa da başvurmasa da indeksi seçer.
Bir T-SQL ifadesi indekslenmemiş bir görünüme referans verdiğinde, ayrıştırıcı ve Sorgu İyileştiricisi hem T-SQL ifadesinin hem de görünümün kaynağını analiz eder ve bunları tek bir yürütme planına dönüştürür. T-SQL ifadesi ve görünüm ayrı planlara sahip değil.
Örneğin, aşağıdaki görünümü göz önünde bulundurun:
USE AdventureWorks2025;
GO

CREATE VIEW EmployeeName AS
    SELECT h.BusinessEntityID,
           p.LastName,
           p.FirstName
    FROM HumanResources.Employee AS h
         INNER JOIN Person.Person AS p
             ON h.BusinessEntityID = p.BusinessEntityID;
GO
Bu görüşe dayanarak, her iki T-SQL ifadesi de temel tablolarda aynı işlemleri gerçekleştirir ve aynı sonuçları verir:
USE AdventureWorks2025;
GO

/* SELECT referencing the EmployeeName view. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM Sales.SalesOrderHeader AS soh
     INNER JOIN dbo.EmployeeName AS EmpN
         ON (soh.SalesPersonID = EmpN.BusinessEntityID)
WHERE OrderDate > '20230531';

/* SELECT referencing the Person and Employee tables directly. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM HumanResources.Employee AS e
     INNER JOIN Sales.SalesOrderHeader AS soh
         ON soh.SalesPersonID = e.BusinessEntityID
     INNER JOIN Person.Person AS p
         ON e.BusinessEntityID = p.BusinessEntityID
WHERE OrderDate > '20230531';
SQL Server Management Studio (SSMS) Showplan özelliği, ilişkisel motorun bu iki SELECT ifadenin her ikisi için de aynı yürütme planını oluşturduğunu gösterir.
Görünümlerle ipuçları kullan
Bir sorguda görünümlere ipuçları koyarsanız, görünüm ana tablolarına erişmek için genişlediğinde ortaya çıkan diğer ipuçlarıyla çelişebilirler. Bu çakışma olduğunda, sorgu hata döndürür. Örneğin, tanımında tablo ipucu içeren aşağıdaki görünümü göz önünde bulundurun:
USE AdventureWorks2025;
GO

CREATE VIEW Person.AddrState
WITH SCHEMABINDING AS
    SELECT a.AddressID,
           a.AddressLine1,
           s.StateProvinceCode,
           s.CountryRegionCode
    FROM Person.Address AS a WITH (NOLOCK), Person.StateProvince AS s
    WHERE a.StateProvinceID = s.StateProvinceID;
Şimdi şu sorguyu girdiğinizi varsayalım:
SELECT AddressID,
       AddressLine1,
       StateProvinceCode,
       CountryRegionCode
FROM Person.AddrState WITH (SERIALIZABLE)
WHERE StateProvinceCode = 'WA';
Sorgu başarısız oluyor, çünkü SERIALIZABLE görünümündeki Person.AddrState ipucu, görünüm genişletildiğinde hem Person.Address hem de Person.StateProvince tablolarına yayılır. Ancak, görünümün genişletilmesi NOLOCK üzerinde Person.Address ipucunu da ortaya çıkarır.
SERIALIZABLE ve NOLOCK ipuçları çakıştığı için, sonuçta elde edilen sorgu yanlıştır.
TABLOCKX, NOLOCK, READCOMMITTED, REPEATABLEREAD ve SERIALIZABLE tablo ipuçları birbirleriyle çelişir; aynı durum HOLDLOCK, TABLOCK, ROWLOCK, NOLOCK ve PAGLOCK tablo ipuçları için de geçerlidir.
İpuçları iç içe görünümlerin düzeyleri aracılığıyla yayılabilir. Örneğin, bir sorgunun HOLDLOCK ipucunu bir görünüme v1 uyguladığını varsayalım.
v1 genişletildiğinde, v2 görünümünün onun tanımının bir parçası olduğunu görürsünüz.
v2'nin tanımı, temel tablolarından biriyle ilgili bir NOLOCK ipucu içerir. Ancak bu tablo, ipucunu HOLDLOCK görünümündeki v1sorgudan da devralır.
NOLOCK ve HOLDLOCK ipuçları çakıştığı için sorgu başarısız olur.
FORCE ORDER ipucunu görünüm içeren bir sorguda kullandığınızda, görünümün sıralı yapıdaki konumu, görünüm içindeki tabloların birleşme sırasını belirler. Örneğin, aşağıdaki sorgu üç tablodan ve bir görünümden seçim yapar:
SELECT * FROM Table1, Table2, View1, Table3
WHERE Table1.Col1 = Table2.Col1
    AND Table2.Col1 = View1.Col1
    AND View1.Col2 = Table3.Col2;
OPTION (FORCE ORDER);
Ve View1 aşağıdaki örnekte gösterildiği gibi tanımlanır:
CREATE VIEW View1 AS
    SELECT Colx,
           Coly
    FROM TableA, TableB
    WHERE TableA.ColZ = TableB.Colz;
Sorgu planındaki birleştirme sırası Table1, Table2, TableA, TableB, Table3 şeklindedir.
Görünümlerde dizinleri çözme
Her indekste olduğu gibi, Database Engine sorgu planında yalnızca Sorgu Optimizatoru bunun faydalı olduğuna karar verirse indeksli görünüm kullanmayı seçer.
Database Engine'in herhangi bir sürümünde indekslenmiş görünümler oluşturabilirsiniz. Bazı sürümlerde Sorgu Optimizeri otomatik olarak indekslenmiş görünümü dikkate alırken, diğer sürümlerde NOEXPAND tablo ipucunu kullanmanız gerekir. Sorgu Optimizeri tarafından indekslenmiş görünümün otomatik kullanımı yalnızca SQL Server'ın belirli sürümlerinde desteklenmektedir.
Uyarı
Azure SQL Veritabanı ve Azure SQL Yönetilen Örneği, NOEXPAND ipucunu belirtmeden dizinlenmiş görünümlerin otomatik kullanımını destekler.
Sorgu İyileştiricisi, aşağıdaki koşullar karşılandığında indekslenmiş bir görünüm kullanır:
- Bu oturum seçenekleri olarak
ONayarlanır:ANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLQUOTED_IDENTIFIER
-
NUMERIC_ROUNDABORToturum seçeneğiOFFolarak ayarlanmıştır. - Sorgu İyileştiricisi, görünüm dizini sütunları ile sorgudaki öğeler arasında bir eşleşme bulur, örneğin:
-
WHEREyan tümcesindeki arama koşulu yüklemleri - Birleştirme işlemleri
- Toplama işlevleri
-
GROUP BYCümleler - Tablo referansları
-
- Dizini kullanmanın tahmini maliyeti, Sorgu İyileştiricisi tarafından dikkate alınacak erişim mekanizmalarının en düşük maliyetine sahiptir.
- Dizinli görünümdeki bir tablo başvurusuna karşılık gelen sorguda başvuruda bulunan her tabloda (doğrudan veya temel tablolarına erişmek için bir görünümü genişleterek) sorguda aynı ipuçları kümesi uygulanmalıdır.
Uyarı
READCOMMITTED ve READCOMMITTEDLOCK ipuçları, geçerli işlem yalıtım düzeyi ne olursa olsun bu bağlamda her zaman farklı ipuçları olarak kabul edilir.
Seçenekler ve tablo ipuçları gereksinimleri SET dışında, bunlar Sorgu İyileştiricisi'nin tablo dizininin sorguyu kapsayıp kapsamadığını belirlemek için kullandığı kurallarla aynıdır. İndekslenmiş bir görünümün kullanılması için sorguda başka bir şey belirtmenize gerek yoktur.
Sorgu İyileştirici'nin dizinlenmiş görünümü kullanması için sorgunun yan tümcesinde FROM dizinlenmiş bir görünüme açıkça başvurması gerekmez. Sorgu, dizinlenmiş görünümde de bulunan temel tablolardaki sütunlara başvurular içeriyorsa ve Sorgu İyileştiricisi dizinlenmiş görünümün kullanılmasıyla en düşük maliyet erişim mekanizmasının sağlandığını tahmin ederse, Sorgu İyileştiricisi dizinlenmiş görünümü seçer; örneğin, sorguda doğrudan başvurulmazsa temel tablo dizinlerini seçme yöntemine benzer. Görünüm, sorguda belirtilen sütunlardan birini veya daha fazlasını kapsayan en düşük maliyet seçeneğini sunduğu sürece, sorgu tarafından referans verilmemiş sütunlar içerse bile Sorgu Optimizasyonu tarafından seçilebilir.
Sorgu İyileştirici, FROM yan tümcesinde referans alınan dizin görünümünü standart görünüm olarak kabul eder. Sorgu İyileştiricisi, iyileştirme işleminin başlangıcında görünümün tanımını sorguya genişletir. Ardından dizinli görünüm eşleştirmesi gerçekleştirilir. Dizine alınmış görünüm, Sorgu İyileştiricisi tarafından seçilen son yürütme planında kullanılabilir veya bunun yerine, plan görünümün başvurmuş olduğu temel tablolara erişerek gerekli verileri görünümden elde edebilir. Sorgu İyileştiricisi en düşük maliyetli alternatifi seçer.
Dizinlenmiş görünümlerle ipuçlarından yararlanma
Sorgu ipucunu kullanarak EXPAND VIEWS görünüm dizinlerinin sorgu için kullanılmasını engelleyebilir veya sorgunun NOEXPAND yan tümcesinde FROM belirtilen dizinli görünüm için dizin kullanımını zorlamak için tablo ipucunu kullanabilirsiniz. Ancak, Sorgu İyileştiricisi'nin her sorgu için kullanılacak en iyi erişim yöntemlerini dinamik olarak belirlemesine izin vermelisiniz. ve EXPAND kullanımınızı, testin NOEXPAND performansı önemli ölçüde artırdığını gösterdiği belirli durumlara sınırlayın.
seçeneği,
EXPAND VIEWSSorgu İyileştiricisi'nin sorgunun tamamı için hiçbir görünüm dizini kullanmadığını belirtir.Bir görünüm için
NOEXPANDbelirttiğinizde, Sorgu İyileştiricisi görünümde tanımlanmış herhangi bir dizinin kullanılmasını dikkate alır.NOEXPANDisteğe bağlıINDEX()yan tümcesiyle belirtilirse, Sorgu İyileştiricisi belirtilen dizinleri kullanmaya zorlar. Sadece indekslenmiş görünüm için belirtebilirsinizNOEXPAND, indekslenmemiş bir görünüm için belirtemezsiniz. Sorgu Optimizeri tarafından indekslenmiş görünümün otomatik kullanımı yalnızca SQL Server'ın belirli sürümlerinde desteklenmektedir.Uyarı
Azure SQL Veritabanı ve Azure SQL Yönetilen Örneği,
NOEXPANDipucunu belirtmeden dizinlenmiş görünümlerin otomatik kullanımını destekler.
Görünüm içeren bir sorguda ne NOEXPAND ne de EXPAND VIEWS belirtilmezse, görünüm temel alınan tablolara erişecek şekilde genişletilir. Görünümü oluşturan sorgu herhangi bir tablo ipucu içeriyorsa, bu ipuçları temel alınan tablolara yayılır. (Bu süreç, Görünüm çözümlemesi bölümünde daha ayrıntılı olarak açıklanmaktadır.) Görünümün temelindeki tablolarda bulunan ipuçları kümesi birbirleriyle aynı olduğu sürece, sorgu dizinlenmiş bir görünümle eşleştirilmeye uygundur. Çoğu zaman, bu ipuçları birbirleriyle eşleşiyor çünkü doğrudan görünümden miras alınıyor. Ancak, sorgu görünümler yerine tablolara başvuruyorsa ve doğrudan bu tablolara uygulanan ipuçları aynı değilse, bu tür bir sorgu dizinli görünümle eşleştirme için uygun değildir.
INDEX, PAGLOCK, , ROWLOCK, TABLOCKX, veya UPDLOCKXLOCK ipuçları görünüm genişletme sonrasında sorguda başvuruda bulunılan tablolara uygulanırsa, sorgu dizinli görünüm eşleştirme için uygun değildir.
Bir sorguda biçiminde INDEX ( index_val [ ,...n] ) olan bir tablo belirteci bir görünüme atıfta bulunuyorsa ve belirteci NOEXPAND olarak da belirtmezseniz, dizin belirteci yoksayılır. Belirli bir dizinin kullanımını belirtmek için kullanın NOEXPAND.
Genel olarak, Sorgu Optimizeri indekslenmiş bir görünümü bir sorguya eşleştirdiğinde, tablolarda veya sorgudaki görünümlerde belirtilen ipuçlarını doğrudan indekslenmiş görünüme uygular. Sorgu İyileştiricisi indeksli görünüm kullanmamayı seçerse, ipuçlarını doğrudan görünümde başvurulan tablolara iletir. Daha fazla bilgi için Çözünürlüğü görüntüle bölümüne bakın. Bu yayılma join hints için geçerli değildir. Bunlar yalnızca sorgudaki özgün konumlarında uygulanır. Sorgu İyileştiricisi, sorguları indekslenmiş görünümlerle eşleştirirken birleştirme ipuçlarını dikkate almaz. Sorgu planı, birleştirme ipucu içeren bir sorgunun parçasıyla eşleşen dizinli bir görünüm kullanıyorsa, birleştirme ipucu planda kullanılmaz.
Dizine alınan görünümlerin tanımlarında ipuçlarına izin verilmez. Database Engine, indekslenmiş görünüm tanımları içindeki ipuçlarını bunların bakımını yaparken veya indekslenmiş görünümler kullanan sorguları çalıştırırken görmezden gelir.
Daha fazla bilgi için bkz. Tablo İpuçları.
Dağıtılmış bölümlenmiş görünümleri çözümleme
Database Engine sorgu işlemcisi, dağıtılmış bölümlenmiş görünümlerin performansını optimize eder. Dağıtılmış bölümlenmiş görünüm performansının en önemli yönü, üye sunucular arasında aktarılan veri miktarını en aza indirmektir.
Database Engine, uzak üye tablolarından verilere erişmek için dağıtık sorguları verimli kullanan zeki, dinamik planlar oluşturur:
- Sorgu İşlemcisi her üye tablosundan denetim kısıtlaması tanımlarını almak için önce OLE DB'yi kullanır. Bu yöntem, sorgu işlemcisinin anahtar değerlerin üye tablolar üzerindeki dağılımını eşlemesine olanak tanır.
- Sorgu İşlemcisi, T-SQL ifade
WHEREyan tümcesinde belirtilen anahtar aralıklarını, satırların üye tablolarda nasıl dağıtıldığını gösteren haritayla karşılaştırır. Sorgu işlemcisi, dağıtık sorgular kullanarak yalnızca T-SQL ifadesini tamamlamak için gereken uzak satırları elde eden bir sorgu yürütme planı oluşturur. Yürütme planı ayrıca, veri veya meta veri için uzak üye tablolarına erişimin, bilgi gerekene kadar ertelendiği şekilde oluşturulmuştur.
Örneğin, bir tablonun Server1 (1 ile 3299999 arasında), Server2 (CustomersCustomerID3300000 ile 6599999 arasında) ve Server3 (CustomerID6600000 ile 9999999 arasında) arasında bölümlendiği bir CustomerID sistem düşünün.
Sunucu1'de yürütülen bu sorgu için oluşturulan yürütme planını göz önünde bulundurun:
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID BETWEEN 3200000 AND 3400000;
Bu sorgunun yürütme planı, anahtar değerleri 3200000 ile CustomerID 3299999 arasındaki satırları yerel üye tablosundan ayıklar ve Server2'den 3300000 ile 3400000 arasındaki anahtar değerlerine sahip satırları almak için dağıtılmış bir sorgu verir.
Database Engine Query Processor, anahtar değerlerin plan oluşturulurken bilinmediği T-SQL ifadeleri için sorgu yürütme planlarına dinamik mantık da entegre edebilir. Örneğin, şu saklı yordamı göz önünde bulundurun:
CREATE PROCEDURE GetCustomer
(
    @CustomerIDParameter INT
)
AS
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID = @CustomerIDParameter;
Database Engine, prosedür her çalıştırıldığında @CustomerIDParameter parametresinin hangi anahtar değerini sağladığını tahmin edemez. Anahtar değeri tahmin edilemediği için, sorgu işlemcisi hangi üye tabloya erişmesi gerektiğini tahmin edemez. Bu durumu yönetmek için, Database Engine, giriş parametresi değerine göre hangi üye tabloya erişileceğini denetlemek amacıyla dinamik filtreler olarak adlandırılan koşullu mantık içeren bir yürütme planı oluşturur. Depolanan prosedürün GetCustomer Server1'de yürütüldüğünü varsayarsak, yürütme planı mantığı aşağıdaki çıktıda gösterildiği gibi temsil edilebilir:
IF @CustomerIDParameter BETWEEN 1 and 3299999
   Retrieve row from local table CustomerData.dbo.Customer_33
ELSE IF @CustomerIDParameter BETWEEN 3300000 and 6599999
   Retrieve row from linked table Server2.CustomerData.dbo.Customer_66
ELSE IF @CustomerIDParameter BETWEEN 6600000 and 9999999
   Retrieve row from linked table Server3.CustomerData.dbo.Customer_99
Database Engine bazen parametrizete sahip olmayan sorgular için bile bu tür dinamik yürütme planları oluşturur. Sorgu İyileştiricisi, yürütme planının yeniden kullanılabilmesi için sorguyu parametreleştirebilir. Eğer Sorgu Optimizer, bölümlenmiş bir görünüme atıfta bulunan bir sorguyu parametreleştirirse, Sorgu Optimizörü artık gerekli satırların belirli bir temel tablodan geldiğini varsayamaz. Daha sonra bu, yürütme planında dinamik filtreler kullanmak zorundadır.
Saklı yordam ve tetikleyici çalıştırma
Database Engine, yalnızca depolanmış prosedürler ve tetikleyiciler için kaynağı saklar. Saklı yordam veya tetikleyici ilk kez yürütüldüğünde, kaynak bir yürütme planına derlenir. Yürütme planı bellekten eskimeden önce saklı yordam veya tetikleyici yeniden yürütülürse ilişkisel altyapı mevcut planı algılar ve yeniden kullanır. Plan bellekten düşerse, yeni bir plan oluşturulur. Bu süreç, Database Engine'in tüm T-SQL ifadeleri için izlediği sürece benzer. Database Engine'de depolanmış prosedürlerin ve tetikleyicilerin dinamik T-SQL gruplarına kıyasla sahip olduğu temel performans avantajı, T-SQL ifadelerinin her zaman aynı olmasıdır. Bu nedenle, ilişkisel altyapı bunları mevcut yürütme planlarıyla kolayca eşleştirir. Saklı yordam ve tetikleyici planları kolayca yeniden kullanılabilir.
Saklı yordamlar ve tetikleyiciler için yürütme planı, saklı yordamı çağıran veya tetikleyiciyi tetikleyen toplu işlemin yürütme planından ayrı olarak yürütülür. Bu ayrım, depolanan prosedürün ve tetikleyici yürütme planlarının daha fazla yeniden kullanılmasına olanak tanır.
Yürütme planı önbelleğe alma ve yeniden kullanma
Database Engine, hem yürütme planlarını hem de veri tamponlarını depolamak için bellek kullanır. Yürütme planlarına veya veri tamponlarına tahsis edilen bellek yüzdesi, sistemin durumuna bağlı olarak dinamik olarak ayarlanır. Yürütme planlarını depolayan bellek bölümüne plan önbelleği denir.
Plan önbelleği depoları
Plan önbelleğinin tüm derlenmiş planlar için iki deposu vardır:
- Nesne Planları önbellek deposu (OBJCP), saklanan prosedürler, fonksiyonlar ve tetikleyiciler gibi kalıcı nesnelerle ilgili planlar için.
- SQL Planları önbellek deposu (SQLCP), otomatik parametreli, dinamik veya hazırlanmış ifadelerle ilgili planlar için.
Aşağıdaki sorgu, bu iki önbellek deposu için bellek kullanımı hakkında bilgi sağlar:
SELECT *
FROM sys.dm_os_memory_clerks
WHERE name LIKE '%plans%';
Plan önbelleğinde plan depolamayan iki ek mağaza vardır:
- Bound Trees önbellek deposu (PHDR), görünümler, kısıtlamalar ve varsayılanlar için plan derleme sırasında kullanılan veri yapılarının önbellek deposu. Bu yapılar bound tree'ler veya algebrizer tree'ler olarak bilinir.
- Genişletilmiş Saklı Yordamlar önbellek deposu (XPROC), sp_executesql veya xp_cmdshell gibi önceden tanımlanmış sistem prosedürleri için. Bu depolanmış prosedürler, T-SQL ifadeleri yerine DLL kullanır. Önbellekli yapı yalnızca fonksiyon adını ve prosedürün uygulandığı DLL adını içerir.
Yürütme planı bileşenleri
Database Engine yürütme planları aşağıdaki ana bileşenlere sahiptir:
Derlenmiş plan (veya sorgu planı)
Derleme işlemi tarafından oluşturulan sorgu planı, çoğunlukla herhangi bir sayıda kullanıcı tarafından kullanılan geri dönüşlü, salt okunur bir veri yapısıdır. Aşağıdakilerle ilgili bilgileri depolar:
Mantıksal işleçler tarafından açıklanan işlemi uygulayan fiziksel işleçler.
Verilere erişilen, filtrelenen ve toplanan verilerin sırasını belirleyen bu işleçlerin sırası.
İşleçlerden geçen tahmini satır sayısı.
Uyarı
Sorgulama planı ayrıca Kardinalite Tahmini için kullanılan istatistiksel nesneler hakkında bilgi de saklar.
Hangi destek nesnelerinin oluşturulması gerekir, örneğin çalışma tabloları veya iş dosyaları içinde?
Sorgu planı herhangi bir kullanıcı bağlamı veya çalışma zamanı bilgisi depolamıyor. Database Engine, plan önbelleğinden bir plan aldığında işçi iş parçacığı sayısını belirler. Önbellekli paralel plan ayrıca tek iş parçacıklı olarak da çalışabilir.
Yürütme bağlamı
Şu anda sorguyu yürüten her kullanıcının, yürütülmesine özgü verileri (örneğin parametre değerleri) tutan bir veri yapısı vardır. Bu veri yapısına yürütme bağlamı denir. Yürütme bağlamı veri yapıları yeniden kullanılır, ancak içeriği yeniden kullanılmaz. Başka bir kullanıcı aynı sorguyu yürütürse, veri yapıları yeni kullanıcının bağlamıyla yeniden başlatılır.
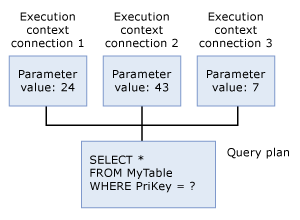
Aynı ifadeler için planları yeniden kullanmak
Database Engine herhangi bir T-SQL ifadesini çalıştırdığında, önce plan önbelleğini inceleyerek aynı T-SQL ifadesi için mevcut bir yürütme planının var olup olmadığını doğrular. T-SQL ifadesi, önbelleğe alınmış bir plana sahip daha önce çalıştırılmış bir T-SQL ifadesiyle karakter karakter tam olarak eşleşiyorsa mevcut kabul edilir. Database Engine, bulduğu mevcut planları tekrar kullanır ve böylece T-SQL ifadesinin yeniden derlenmesinin getirdiği ek yükten kaçınır. Eğer yürütme planı yoksa, Database Engine sorgu için yeni bir yürütme planı oluşturur.
Uyarı
Plan önbelleği, bazı T-SQL ifadeleri için, örneğin rowstore üzerinde çalışan toplu işlem ifadeleri veya büyük dize literalleri içeren ifadeler için yürütme planlarını sürekli tutmaz. Bu planlar yalnızca sorgu çalışırken geçerlidir.
Database Engine, herhangi bir T-SQL ifadesi için mevcut yürütme planlarını bulmak için verimli bir algoritma kullanır. Çoğu sistemde, bu taramanın kullandığı minimum kaynaklar, her T-SQL ifadesini derlemek yerine mevcut planların yeniden kullanılmasıyla tasarruf edilen kaynaklardan daha azdır.
Yeni T-SQL ifadelerini plan önbelleğindeki mevcut ve kullanılmayan yürütme planlarıyla eşleştirmek için algoritmalar, tüm nesne referanslarının tam niteliklendirilmesini gerektirir. Örneğin, aşağıdaki Person ifadelerini yürüten kullanıcının varsayılan şemasının SELECT olduğunu varsayalım. Bu örnek, uygulanmak için Person tablosunu tam adla belirtmenizi gerektirmese de, ikinci ifadenin mevcut bir planla eşleşmediği, ancak üçüncü ifadenin eşleştiği anlamına gelir:
USE AdventureWorks2025;
GO

SELECT *
FROM Person;
GO

SELECT *
FROM Person.Person;
GO

SELECT *
FROM Person.Person;
GO
Belirli bir yürütme için aşağıdaki SET seçeneklerden herhangi birinin değiştirilmesi, planların yeniden kullanılabilmesini etkiler, çünkü Veritabanı Altyapısı sabit katlama işlemi yapar ve bu seçenekler bu tür ifadelerin sonuçlarını etkiler:
ANSI_DEFAULTSANSI_NULL_DFLT_OFFANSI_NULL_DFLT_ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLDATEFIRSTDATEFORMATFORCEPLANLANGUAGENO_BROWSETABLENUMERIC_ROUNDABORTQUOTED_IDENTIFIER
Aynı sorgu için birden çok planı önbelleğe alma
Sorgular ve yürütme planları, Veritabanı Altyapısı'nda parmak izi gibi benzersiz bir şekilde tanımlanabilir:
- Sorgu planı karması, belirli bir sorgu için yürütme planında hesaplanan ikili karma değerdir ve benzer yürütme planlarını benzersiz olarak tanımlamak için kullanılır.
- Sorgu hash, bir sorgunun T-SQL metni üzerinde hesaplanan ikili bir hash değeridir ve sorguları benzersiz şekilde tanımlamak için kullanılır.
Plan önbelleğinden derlenmiş bir planı plan plan handle kullanarak alabilirsiniz. Bu geçici tanımlayıcı yalnızca plan önbellekte kaldığı sürece sabit kalır. Plan tanıtıcısı, toplu işin tamamının derlenmiş planından türetilen bir karma değerdir. Derlenmiş bir planın plan tanıtıcısı, toplu iş içindeki bir veya daha fazla ifade yeniden derlense bile aynı kalır.
Uyarı
Tek bir ifade yerine bir toplu iş için plan derlerseniz, plan tutacağı ve ifade ofsetlerini kullanarak toplu işteki bireysel ifadeler için planı elde edebilirsiniz.
sys.dm_exec_requests DMV, her kayıt için statement_end_offset ve statement_start_offset sütunlarını içerir. Bu sütunlar, şu anda yürütülen bir toplu işin veya kalıcı nesnenin şu anda yürütülen ifadesine atıfta bulunur. Daha fazla bilgi için bkz. sys.dm_exec_requests.
DMV sys.dm_exec_query_stats ayrıca her kayıt için bu sütunları da içerir. Bu sütunlar, bir deyimin bir toplu işlem veya kalıcı hale getirilmiş nesne içindeki konumunu ifade eder. Daha fazla bilgi için bkz. sys.dm_exec_query_stats.
Bir toplu işin gerçek T-SQL metni, plan önbelleğinden ayrı bir bellek alanında, SQL Manager (SQLMGR) önbelleği adı verilen bir alanda saklanır. SQL Manager önbelleğinden derlenmiş bir plan için T-SQL metnini SQL handle kullanarak alabilirsiniz. Bu geçici tanımlayıcı, yalnızca ona referans veren en az bir plan plan önbelleğinde kaldığı sürece sabit kalır. SQL tanıtıcısı, tüm batch metninden türetilen bir hash değeridir ve her batch için benzersiz olacağı garantilidir.
Uyarı
Derlenmiş bir plan gibi, T-SQL metni yorumlar dahil olmak üzere toplu işlem bazında depolanır. SQL handle, tüm toplu metnin MD5 hash'ını içerir ve her batch için benzersiz olacağı garanti edilir.
Aşağıdaki sorgu, SQL Manager önbelleği için bellek kullanımı hakkında bilgi sağlar:
SELECT *
FROM sys.dm_os_memory_objects
WHERE type = 'MEMOBJ_SQLMGR';
SQL tutamacı ile plan tutamaçları arasında bire-çok ilişki vardır. Bu durum, derlenen planların önbellek anahtarı farklı olduğunda ortaya çıkar. Bu fark, aynı partinin iki çalıştırması arasındaki SET seçeneklerindeki değişiklikten kaynaklanabilir.
Aşağıdaki saklı yordamı göz önünde bulundurun:
USE WideWorldImporters;
GO

CREATE PROCEDURE usp_SalesByCustomer
(
    @CID INT
)
AS
SELECT *
FROM Sales.Customers
WHERE CustomerID = @CID;
GO

SET ANSI_DEFAULTS ON;
GO

EXECUTE usp_SalesByCustomer 10;
GO
Aşağıdaki sorguyu kullanarak plan önbelleğinde neler bulabileceğinizi inceleyin:
SELECT cp.memory_object_address,
       cp.objtype,
       refcounts,
       usecounts,
       qs.query_plan_hash,
       qs.query_hash,
       qs.plan_handle,
       qs.sql_handle
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle)
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle)
     INNER JOIN sys.dm_exec_query_stats AS qs
         ON qs.plan_handle = cp.plan_handle
WHERE text LIKE '%usp_SalesByCustomer%';
GO
Sonuç kümesi aşağıdadır.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Şimdi kaydedilen prosedürü farklı bir parametreyle çalıştırın, yürütme bağlamında başka bir değişiklik olmadan:
EXECUTE usp_SalesByCustomer 8;
GO
Plan önbelleğinde bulabildiklerinizi tekrar kontrol edin. Sonuç kümesi aşağıdadır.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Değerin usecounts'den 2'e arttığına dikkat edin, bu da yürütme bağlamı veri yapıları yeniden kullanıldığı için aynı önbelleklenmiş planın olduğu gibi yeniden kullanılması anlamına gelir. Şimdi SET ANSI_DEFAULTS seçeneğini değiştirin ve aynı parametreyi kullanarak depolanmış prosedürü çalıştırın.
SET ANSI_DEFAULTS OFF;
GO

EXECUTE usp_SalesByCustomer 8;
GO
Plan önbelleğinde bulabildiklerinizi tekrar kontrol edin. Sonuç kümesi aşağıdadır.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CD01DEC060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02B031F111CD01000001000000000000000000000000000000000000000000000000000000
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
DMV çıktısında artık iki kayıt olduğuna dikkat edin.
- Sütun
usecounts, ilk kayıttaki değeri1gösterir. Bu değer,SET ANSI_DEFAULTS OFFile bir kez gerçekleştirilen planı temsil eder. - Sütun
usecounts, ikinci kayıttaki değeri2gösterir. Bu değer, iki kez yürütüldüğü içinSET ANSI_DEFAULTS ONile yürütülen planı temsil eder. - Farklı
memory_object_address, plan önbelleğindeki farklı bir yürütme planı girdisine başvurur. Ancak, her iki girdi için desql_handledeğeri aynıdır çünkü aynı partiye atıfta bulunuyorlar.-
ANSI_DEFAULTSdeğeriplan_handleolarak ayarlanmış yürütme yeni birSET’ye sahiptir ve aynıOFFseçenek kümesine sahip çağrılar için yeniden kullanılabilir. Yeni plan tanıtıcısı gereklidir çünkü yürütme bağlamı, değiştirilenSETseçenekleri nedeniyle yeniden başlatıldı. Ancak bu değişiklik yeniden derlemeyi tetiklemez: her iki giriş de aynı plan ve sorguya atıfta bulunur, bu da aynıquery_plan_hashvequery_hashdeğerlerle kanıtlanıyor.
-
Bu durum, önbellekte aynı partiye karşılık gelen iki plan girişi olduğu anlamına gelir. Bu, aynı sorgular tekrar tekrar yürütüldüğünde SET plan önbelleğini etkileyen seçeneklerin aynı olmasını sağlamanın önemini vurgular. Bu yaklaşım, plan yeniden kullanımını optimize eder ve plan önbellek boyutunu gerekli minimumda tutar.
Tavsiye
Yaygın bir tuzak, farklı istemcilerin seçenekler için farklı varsayılan değerlere SET sahip olmasıdır. Örneğin, SQL Server Management Studio aracılığıyla yapılan bir bağlantı QUOTED_IDENTIFIER değerini otomatik olarak ON olarak ayarlarken, SQLCMD QUOTED_IDENTIFIER değerini OFF olarak ayarlar. Bu iki istemciden aynı sorguların yürütülmesi, önceki örnekte açıklandığı gibi birden çok plana yol açar.
Plan önbelleğinden yürütme planlarını kaldırma
Yürütme planları, depolama için yeterli bellek olduğu sürece plan önbelleğinde kalır. Bellek baskısı olduğunda, SQL Server Database Engine plan önbelleğinden hangi yürütme planlarının çıkarılacağına karar vermek için maliyet tabanlı bir yaklaşım kullanır. Maliyet tabanlı bir karar vermek için, SQL Server Database Engine aşağıdaki faktörlere dayanarak her yürütme planını değerlendirmek üzere mevcut maliyet değişkenini artırır ve azaltır.
Bir kullanıcı süreci önbelleğe bir yürütme planı eklediğinde, kullanıcı süreci mevcut maliyeti orijinal sorgu derleme maliyetine eşit ayarlar. Ad hoc yürütme planları için, kullanıcı süreci mevcut maliyeti sıfıra ayarlar. Bundan sonra, bir kullanıcı süreci bir yürütme planına her referans verdiğinde, mevcut maliyeti orijinal derleme maliyetine sıfırlar. Ad hoc yürütme planları için kullanıcı süreci mevcut maliyeti artırır. Tüm planlar için geçerli maliyet için en yüksek değer özgün derleme maliyetidir.
Bellek baskısı olduğunda, SQL Server Database Engine plan önbelleğinden yürütme planlarını kaldırır. Hangi planların kaldırılacağını belirlemek için, SQL Server Veritabanı Altyapısı her yürütme planının durumunu tekrar tekrar inceler ve geçerli maliyetleri sıfır olduğunda planları kaldırır. Sıfır mevcut maliyeti olan bir yürütme planı, bellek baskısı olduğunda otomatik olarak kaldırılmaz. Yalnızca SQL Server Database Engine planı incelediğinde ve mevcut maliyet sıfır olduğunda kaldırılır. SQL Server Veritabanı Motoru, bir yürütme planını incelerken, bir sorgu şu anda planı kullanmıyorsa geçerli maliyeti azaltarak maliyeti sıfıra doğru düşürür.
SQL Server Database Engine, bellek gereksinimlerini karşılayacak kadar planı kaldırana kadar yürütme planlarını incelemeye devam eder. Bellek baskısı mevcut olsa da yürütme planının maliyeti birden çok kez artırılıp azaltılmış olabilir. Bellek baskısı artık mevcut olmadığında, SQL Server Database Engine kullanılmayan yürütme planlarının mevcut maliyetini azaltmayı durdurur. Tüm yürütme planları, maliyeti sıfır olsa bile plan önbelleğinde kalır.
SQL Server Veritabanı Altyapısı, bellek baskısına yanıt olarak, plan önbelleğinden bellek boşaltmak amacıyla kullanıcı iş parçacıkları ve kaynak izleme mekanizmasını kullanır. Kaynak monitörü ve kullanıcı çalışan iş parçacıkları, kullanılmayan her yürütme planı için mevcut maliyeti azaltmak için planları aynı anda inceleyebilir. Kaynak izleyicisi, genel bellek baskısı mevcut olduğunda plan önbelleğinden yürütme planlarını kaldırır. Sistem belleği, işlem belleği, kaynak havuzu belleği ve tüm önbellekler için maksimum boyut dahil belleği serbest bırakarak ilkeleri uygular.
Tüm önbelleklerin maksimum boyutu, arabellek havuzu boyutunun bir işlevidir ve sunucu belleğinin maksimumunu aşamaz. Maksimum sunucu belleğini yapılandırma hakkında daha fazla bilgi için sp_configure içindeki max server memory ayarına bakın.
Tek önbellek bellek baskısı olduğunda, kullanıcı çalışan iş parçacıkları yürütme planlarını plan önbelleğinden kaldırır. Maksimum tekil önbellek boyutu ve maksimum tekil önbellek girdisi için politikaları zorunlu kılarlar.
Aşağıdaki örneklerde, hangi yürütme planlarının plan önbelleğinden kaldırıldığı gösterilmektedir:
- Yürütme planına sık sık başvurulur, böylece maliyeti hiçbir zaman sıfıra gitmez. Plan, plan önbelleğinde kalır ve yalnızca bellek baskısı varsa ve mevcut maliyet sıfırsa kaldırılır.
- Bellek baskısı oluşmadan önce geçici yürütme planı eklenir ve yeniden başvurulmaz. Ad hoc planlar geçerli maliyeti sıfır olarak başlatıldığından, SQL Server Database Engine yürütme planını incelediğinde, sıfır geçerli maliyeti görür ve planı plan önbelleğinden çıkarır. Ad hoc yürütme planı, bellek baskısı olmadığında sıfır güncel maliyetle plan önbelleğinde kalır.
Tek bir planı veya tüm planları önbellekten el ile kaldırmak için DBCC FREEPROCCACHE kullanın. Ayrıca DBCC FREESYSTEMCACHE kullanarak plan önbelleği de dahil olmak üzere herhangi bir önbelleği temizleyebilirsiniz. SQL Server 2016 (13.x) ve sonraki sürümlerde, kapsamdaki veritabanı için prosedür (plan) önbelleğini temizlemek üzere ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE kullanın.
sp_configure ve reconfigure yoluyla bazı yapılandırma ayarlarında yapılan değişiklikler de planların önbelleğinden kaldırılmasına neden olur. Bu yapılandırma ayarlarının listesini DBCC FREEPROCCACHE makalesinin Açıklamalar bölümünde bulabilirsiniz. Bu yapılandırma değişikliğini yaptığınızda, hata günlüğüne aşağıdaki bilgilendirici mesaj yazılır:
SQL Server has encountered %d occurrence(s) of cachestore flush for the '%s' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
Yürütme planlarını yeniden derleme
Veritabanındaki bazı değişiklikler, yürütme planını verimsiz veya geçersiz hale getirebilir. Database Engine bu değişiklikleri algılar ve planı geçersiz olarak işaretler. Ardından sorguyu yürüten sonraki bağlantı için yeni bir plan yeniden derlenmelidir. Bir planı geçersiz kılan koşullar şunlardır:
- Sorgu tarafından referans verilen bir tablo veya görünümdeki değişiklikler (
ALTER TABLEveALTER VIEW). - Tek bir prosedürde yapılan değişiklikler, o prosedüre ait tüm planların önbellekten kaldırılmasına neden olurdu (
ALTER PROCEDURE). - Yürütme planı tarafından kullanılan dizinlerde yapılan değişiklikler.
- Yürütme planı tarafından kullanılan istatistiklere yapılan güncellemeler; ister
UPDATE STATISTICSgibi bir ifade ile açıkça ister otomatik olarak oluşturulmuş olsun. - Yürütme planında kullanılan bir dizini kaldırmak.
-
sp_recompileiçin açık bir çağrı. - Anahtarlardaki çok sayıda değişiklik (diğer kullanıcıların sorgunun başvurduğu bir tabloyu değiştiren
INSERTveyaDELETEdeyimleri tarafından oluşturulan). - Tetikleyicileri olan tablolarda, eklenen veya silinen tablolardaki satır sayısı önemli ölçüde artarsa.
-
WITH RECOMPILEseçeneğini kullanarak saklı yordam çalıştırma.
Çoğu yeniden derleme, ya deyim doğruluğu için ya da potansiyel olarak daha hızlı sorgu yürütme planları elde etmek için gereklidir.
Bir toplu işlem içindeki ifade yeniden derlemeyi tetiklediğinde, yalnızca o ifade yeniden derlenir, toplu işlemin tamamı değil. Bu kural, toplu işlem saklı yordam, tetikleyici, ad hoc toplu işlem veya hazırlanmış bir deyim aracılığıyla gönderilse de geçerlidir.
Deyim düzeyinde yeniden derleme, performansa fayda sağlar çünkü çoğu durumda yeniden derlemelere neden olan şey az sayıda deyimdir ve CPU süresi ile kilitler açısından cezalara yol açan da bu yeniden derlemelerdir. Bu nedenle, yeniden derlenmesi gerekmeyen toplu işteki diğer deyimler için bu cezalardan kaçınılır.
Genişletilmiş olay (XEvent) ifade düzeyinde yeniden derlemeleri raporlar. Bu XEvent, herhangi bir yığın türü için ifade düzeyinde yeniden derleme gerektiğinde meydana gelir. Bu gereklilik, saklı yordamlar, tetikleyiciler, ad hoc toplu komutlar ve sorguları içerir. Toplu işler, sp_executesql, dinamik SQL, Prepare yöntemleri veya Execute yöntemleri dahil olmak üzere çeşitli arayüzler aracılığıyla gönderilebilir.
recompile_cause XEvent sütunusql_statement_recompile, yeniden derlemenin nedenini gösteren bir tamsayı kodu içerir. Aşağıdaki liste olası nedenleri içerir:
- İmleç seçenekleri değiştirildi
- Ertelenmiş derleme
-
FOR BROWSEizin değiştirildi -
OPTION (RECOMPILE)İstenen - Parametreli plan temizlendi
- Bölümlenmiş görünüm değiştirildi
- Veritabanı sürümünü etkileyen plan değiştirildi
- Sorgu bildirim ortamı değiştirildi
- Sorgu Deposu planı eksik
- Query Store planı uygulanamadı
- Sorgu Deposu planı zorlama ilkesi değiştirildi
- Uzak satır kümesi değiştirildi
- Şema değiştirildi
-
SETseçenek değiştirildi - İstatistikler değiştirildi
- Geçici tablo değiştirildi
Uyarı
AUTO_UPDATE_STATISTICS veritabanı seçeneğini ON olarak ayarladığınızda, sorgular istatistikleri güncellenen veya kardinaliteleri son çalıştırmadan bu yana önemli ölçüde değişen tabloları veya indekslenmiş görünümleri hedef aldığında yeniden derlenir. Bu davranış standart kullanıcı tanımlı tablolar, geçici tablolar ve DML tetikleyicileri tarafından oluşturulan eklenen ve silinen tablolar için geçerlidir.
OFF öğesini AUTO_UPDATE_STATISTICS olarak ayarlamak bu yeniden derlemeleri durdurur, ancak güncel olmayan istatistikler genellikle sorgu performansını yeniden derlemelerden daha fazla düşürür. Daha fazla bilgi için AUTO_UPDATE_STATISTICS seçeneğine bakınız. DML INSTEAD OF tetikleyicilerinin eklenen ve silinen tabloları tempdb içinde oluşturulur, bu nedenle AUTO_UPDATE_STATISTICS öğesinin tempdb ayarını izler.
Planın yeniden kullanımı için açık parametreler kullanın
ADO.NET uygulamalarında adlandırılmış parametreler ve OLE DB ile ODBC uygulamalarında parametre işaretleyicileri dahil olmak üzere parametrelerin kullanılması, yürütme planlarının yeniden kullanımını artırabilir.
Uyarı
Tür, uzunluk, biçim ve aralığı test ederek her zaman kullanıcı girişini doğrulayın. Daha fazla bilgi için bkz. SQL enjeksiyonu.
Aşağıdaki iki SELECT ifade arasındaki tek fark, WHERE alt cümlede karşılaştırılan değerlerdir.
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Bu sorgular için yürütme planları arasındaki tek fark, sütunla karşılaştırma ProductSubcategoryID için depolanan değerdir. Amaç, Database Engine'in ifadelerin temelde aynı planı oluşturduğunu her zaman fark edip planları yeniden kullanması olsa da, Database Engine bazen karmaşık T-SQL ifadelerinde bu benzerliği algılamaz.
Parametreler kullanılarak sabitleri T-SQL ifadesinden ayırmak, ilişkisel motorun tekrarlanan planları tanımasına yardımcı olur. Parametreleri aşağıdaki şekillerde kullanın:
T-SQL'de
sp_executesqlkullanın:DECLARE @MyIntParm AS INT; SET @MyIntParm = 1; EXECUTE sp_executesql N'SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = @Parm', N'@Parm INT', @MyIntParm;Bu yöntem, dinamik olarak SQL ifadeleri üreten T-SQL betikleri, depolanmış prosedürler veya tetikleyiciler için önerilir.
ADO.NET,
SqlClientile adlandırılmış parametreler kullanır, örneğin@Parm. OLE DB ve ODBC parametre işaretleyicileri kullanır. Parametre işaretleyicileri, bir SQL ifadesindeki bir sabitin yerine geçen ve bir program değişkenine bağlı olan soru işaretleri (?)dir. Örneğin, bir ODBC uygulamasında aşağıdakileri yapabilirsiniz:Sql deyimindeki ilk parametre işaretçisine bir tamsayı değişkeni bağlamak için kullanın
SQLBindParameter.Tamsayı değerini değişkenine yerleştirin.
Parametre işaretçisini belirterek ifadeyi çalıştırın (
?):SQLExecDirect(hstmt, "SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = ?", SQL_NTS);
SQL Server Native Client OLE DB Provider ve SQL Server Native Client ODBC sürücüsü, uygulamalarda parametre işaretleyicileri kullanıldığında SQL Server'a deyimleri göndermek için
sp_executesqlkullanır.Parametre kullanacak şekilde tasarlanmış saklı yordamlar yazın.
Uygulamalarınızın tasarımına açıkça parametreler eklemediyseniz, varsayılan basit parametrelendirme davranışını kullanarak belirli sorguları otomatik olarak parametreleştirmesi için Sorgu İyileştiricisi'ne de güvenebilirsiniz. Alternatif olarak, PARAMETERIZATION seçeneğini ALTER DATABASE deyiminde FORCED olarak ayarlayarak Sorgu İyileştiricisi'ni, veritabanındaki tüm sorguları parametreleştirmeyi göz önünde bulundurması için zorlayabilirsiniz.
Basit parametreleştirme
Database Engine'de, T-SQL ifadelerinde parametre veya parametre belirteçlerinin kullanılması, ilişkisel motorun yeni T-SQL ifadelerini mevcut, daha önce derlenmiş yürütme planlarıyla eşleştirme yeteneğini artırır.
Uyarı
Tür, uzunluk, biçim ve aralığı test ederek her zaman kullanıcı girişini doğrulayın. Daha fazla bilgi için bkz. SQL enjeksiyonu.
Bir T-SQL ifadesi parametresiz çalıştırılırsa, Database Engine bu ifadeyi dahili olarak parametreleştirerek mevcut bir yürütme planıyla eşleşme olasılığını artırır. Bu sürece parametreleştirme denir. Varsayılan basit parametrelendirmedir ve bir veritabanı için zorunlu parametrelendirmeyi etkinleştirebilirsiniz.
Şu deyimi göz önünde bulundurun:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
1 değerini ifadenin sonunda parametre olarak belirtebilirsiniz. İlişkisel motor, değer 1 yerine bir parametre belirtmişsiniz gibi bu toplu iş için yürütme planını oluşturur. Bu basit parametrelendirme nedeniyle, Database Engine aşağıdaki iki ifadenin esasen aynı yürütme planını oluşturduğunu tanır ve ikinci ifade için ilk planı yeniden kullanır:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Karmaşık T-SQL ifadeleri işlenirken ilişkisel motor hangi ifadelerin parametreleştirilebileceğini belirlemekte zorlanabilir. İlişkisel motorun karmaşık T-SQL ifadelerini mevcut ve kullanılmayan yürütme planlarıyla eşleştirme yeteneğini artırmak için, parametreleri açıkça belirtmek üzere sp_executesql veya parametre belirteçlerinden birini kullanın.
Uyarı
+, -, *, /, veya % aritmetik operatörleri kullanarak int, smallint, tinyint veya bigint sabiti değerlerini float, real, decimal veya numeric veri türlerine örtük veya açık dönüşüm yaptığınızda, Database Engine ifade sonuçlarının türünü ve hassasiyetini hesaplamak için özel kurallar uygular. Bu kurallar, sorgu parametreli olup olmamasına bağlı olarak farklılık gösterir. Bu nedenle, sorgulardaki benzer ifadeler bazı durumlarda farklı sonuçlar üretebilir.
Basit parametrelendirme varsayılan davranışı altında, Database Engine nispeten küçük bir sorgu sınıfını parametreleştirir. Ancak, belirli sınırlamalara tabi olarak veritabanındaki tüm sorguların parametrelendirilmiş olacağını, PARAMETERIZATION komutunun ALTER DATABASE seçeneğini FORCED olarak ayarlayarak belirtebilirsiniz. Bu değişiklik, yüksek eşzamanlı sorgu hacmi yaşayan veritabanlarının performansını sorgu derleme sıklığını azaltarak artırabilir.
Alternatif olarak, tek bir sorgu ve söz dizimsel olarak eşdeğer olan ancak yalnızca parametre değerlerinde farklılık gösteren diğer tüm sorguların parametreleştirilmesini belirtebilirsiniz.
Tavsiye
Entity Framework (EF) gibi nesne-ilişkisel eşleme (ORM) çözümleri kullandığınızda, manuel LINQ sorgu ağaçları veya bazı ham SQL sorguları gibi uygulama sorguları parametre edilmeyebilir. Bu sınırlama, planın yeniden kullanımını ve Query Store'daki sorguları takip etme yeteneğini etkiler. Daha fazla bilgi için bkz. EF Sorgu önbelleğe alma ve parametreleştirme ve EF Raw SQL Sorguları .
Zorlamalı parametreleştirme
Database Engine'in varsayılan basit parametreleştirme davranışını, veritabanındaki tüm SELECT, INSERT, UPDATE, ve DELETE ifadelerinin belirli sınırlamalara tabi olarak parametreleştirilmesini belirterek geçersiz kılabilirsiniz. Zorunlu parametreleştirmeyi etkinleştirmek için ALTER DATABASE ifadesinde PARAMETERIZATION seçeneğini FORCED olarak ayarlayın. Zorlamalı parametreleme, sorgu derlemelerinin ve yeniden derlemelerin sıklığını azaltarak belirli veritabanlarının performansını artırabilir. Zorlamalı parametreleştirmeden yararlanabilecek veritabanları genellikle satış noktası uygulamaları gibi kaynaklardan gelen yüksek hacimli eşzamanlı sorgularla karşılaşan veritabanlarıdır.
PARAMETERIZATION seçeneğini FORCED olarak ayarladığınızda, herhangi bir biçimde gönderilen SELECT, INSERT, UPDATE veya DELETE ifadesinde görünen herhangi bir sabit değer, sorgu derleme sırasında bir parametreye dönüştürülür. Özel durumlar, aşağıdaki sorgu yapılarında görünen sabit değerlerdir.
-
INSERT...EXECUTEİfadeler. - Saklı yordamların, tetikleyicilerin veya kullanıcı tanımlı işlevlerin gövdelerindeki ifadeler. Database Engine zaten bu rutinler için sorgu planlarını yeniden kullanıyor.
- İstemci tarafı uygulamada zaten parametreleştirilmiş hazırlanmış ifadeler.
- XQuery yöntemi çağrıları içeren deyimler, burada yöntemin bağımsız değişkenlerinin genellikle parametreleştirileceği bir bağlamda (yan tümce gibi)
WHEREgörünür. Yöntem, bağımsız değişkenlerinin parametreleştirilmeyeceği bir bağlamda görünüyorsa, ifadenin geri kalanı parametreleştirilir. - T-SQL imleci içindeki ifadeler. (
SELECTAPI kursorler içindeki ifadeler parametreleştirilir.) - Kullanım dışı bırakılan sorgu yapıları.
-
ANSI_PADDINGveyaANSI_NULLSdeğeriOFFolarak ayarlanmış bağlamda çalışan herhangi bir ifade. - Parametreleştirmeye uygun 2.097'den fazla değişmez değer içeren ifadeler.
- gibi
WHERE T.col2 >= @bbdeğişkenlere başvuran deyimler. - Sorgu ipucunu
RECOMPILEiçeren deyimler. -
COMPUTEhükmü içeren ifadeler. -
WHERE CURRENT OFhükmü içeren ifadeler.
Aşağıdaki sorgu ifadeleri parametreleştirilmemiştir. Bu gibi durumlarda yalnızca yan tümceler parametrelendirilmemektedir. Aynı sorgudaki diğer yan tümceler zorunlu parametreleştirme için uygun olabilir.
- Her türlü
SELECTifadesinin<select_list>Bu liste, alt sorgularınSELECTlistelerini veINSERTlisteler içerenSELECTifadeleri içerir. - Bir
SELECTdeyiminin içinde görünen alt sorguIFdeyimleri. - Sorgunun
TOP,TABLESAMPLE,HAVING,GROUP BY,ORDER BY,OUTPUT...INTOveyaFOR XMLyan tümceleri. - Bağımsız değişkenler (doğrudan veya alt ifadeler olarak),
OPENROWSET,OPENQUERY,OPENDATASOURCE,OPENXMLveya herhangi birFULLTEXTişleci için. -
LIKEyan tümcesinin pattern ve escape_character bağımsız değişkenleri. - Bir
CONVERTbölümü için stil argümanı. -
IDENTITYşarta içinde tamsayı sabitleri. - ODBC uzantısı söz dizimi kullanılarak belirtilen sabitler.
-
+,-,*,/ve%işleçlerinin bağımsız değişkenleri olan sabit katlanabilir ifadeler. Zorunlu parametreleştirme uygunluğunu değerlendirirken, Database Engine aşağıdaki koşullardan biri doğruysa, bir ifadeyi sabit katlanabilir olarak kabul eder:- İfadede sütun, değişken veya alt sorgu görüntülenmez.
- İfade bir
CASEyan tümcesi içerir.
-
FASTsorgu ipucunun number_of_rows bağımsız değişkeni,MAXDOPsorgu ipucunun number_of_processors bağımsız değişkeni veMAXRECURSIONsorgu ipucunun number bağımsız değişkeni dahil olmak üzere, sorgu ipucu yan tümcelerinin bağımsız değişkenleri.
Parametrizasyon bireysel T-SQL ifadeleri seviyesinde gerçekleşir. Yani, bir toplu iş içindeki tek tek cümleler parametreleştirilir. Derledikten sonra, parametreli bir sorgu, orijinal olarak gönderildiği batch bağlamında yürütülür. Bir sorgu için bir yürütme planı önbelleklenirse, sql dinamik yönetim görünümündeki sys.syscacheobjects sütununa başvurarak sorgunun parametrelendirilip parametrelendirilmediğini belirleyebilirsiniz. Bir sorgu parametreleştirilmişse, parametrelerin isimleri ve veri türleri, bu sütunda gönderilen toplu iş metninin önüne gelir, örneğin (@1 TINYINT).
Uyarı
Parametre adları rastgeledir. Kullanıcılar veya uygulamalar belirli bir adlandırma sırasına güvenmemelidir. Ayrıca, aşağıdaki öğeler SQL Server sürümleri ve kümülatif güncelleştirme (CU) yükseltmeleri arasında değişebilir: Parametre adları, parametreli literal seçimi ve parametreli metindeki boşluklar.
Parametre veri türleri
Database Engine literalları parametreleştirdiğinde, parametreler aşağıdaki veri türlerine dönüştürülür:
- Boyutları aksi takdirde int veri türüne sığacak tam sayı sabitleri int olarak parametrelenir. Herhangi bir karşılaştırma işleci içeren yüklemlerin parçası olan daha büyük tam sayı sabitleri (
<,<=,=,>=,>,!=,!<,ANY,BETWEEN,ALL,<>,SOME,!>veINdahil) numeric(38,0) olarak parametrelenir. Karşılaştırma operatörleri içeren predikatların parçası olmayan daha büyük literaller, hassasiyeti boyutunu destekleyecek kadar büyük ve ölçeği 0 olan numeric türüne parametreleştirilir. - Karşılaştırma operatörlerini içeren yüklemlerin parçaları olan sabit noktalı sayısal literaller, kesinliği 38 olan ve ölçeği boyutunu destekleyecek kadar büyük olan numeric türüne parametrelenir. Karşılaştırma operatörleri içeren predikatların parçası olmayan sabit noktalı sayısal literaller, hassasiyeti ve ölçeği kendi boyutunu destekleyecek kadar büyük olan numeric türüne parametrelenir.
- Kayan nokta sayısal literaller float(53) olarak parametrelenir.
- Unicode olmayan dize sabitleri, sabit 8.000 karakter içine sığıyorsa varchar(8000) olarak, 8.000 karakterden büyükse varchar(max) olarak parametreleştirilir.
- Unicode dize literalleri, literal 4.000 Unicode karakter içine uyduğunda nvarchar(4000) ile parametrelenir; literal 4.000 karakterden büyükse nvarchar(max) olarak parametrelenir.
- İkili literaller, literal 8.000 bayta sığarsa varbinary(8000) olarak parametreleştirilir. Eğer 8.000 bayttan büyükse, varbinary(max) olarak dönüştürülür.
- Para sabitleri money olarak parametreleştirilir.
Zorlamalı parametreleştirme kullanma yönergeleri
PARAMETERIZATION seçeneğini FORCED olarak ayarlarken, aşağıdaki noktaları göz önünde bulundurun:
- Zorunlu parametreleştirme, bir sorgu derlerken bir sorgudaki literal sabitleri parametrelere dönüştürür. Bu nedenle, Sorgu İyileştiricisi sorgular için en iyi olmayan planları seçebilir. Özellikle Sorgu İyileştiricisi'nin sorguyu dizine alınmış bir görünümle veya hesaplanan sütundaki bir dizinle eşleştirme olasılığı daha düşüktür. Bölümlenmiş tablolarda ve dağıtılmış bölümlenmiş görünümlerde bulunan sorgular için en iyi olmayan planları da seçebilir. Zorunlu parametreleştirmeyi endeksli görünümlere ve hesaplanan sütunlardaki indekslere çok bağımlı ortamlar için kullanmayın. Genellikle, sadece deneyimli veritabanı profesyonelleri, performansı olumsuz etkilemediği belirlendikten sonra bu
PARAMETERIZATION FORCEDseçeneğini kullanmalıdır. - Birden fazla veritabanına başvuran dağıtılmış sorgular,
PARAMETERIZATIONseçeneği, sorgunun çalıştığı veritabanının bağlamındaFORCEDolarak ayarlandığı sürece zorlamalı parametreleştirme için uygundur. -
PARAMETERIZATIONseçeneğininFORCEDolarak ayarlanması, şu anda derlenmekte, yeniden derlenmekte veya çalışmakta olanlar dışında, bir veritabanının plan önbelleğindeki tüm sorgu planlarını temizler. Ayar değişikliği sırasında derlenen veya çalışan sorguların planları, sorgu bir sonraki yürütüldüğünde parametrelenir. - Bu
PARAMETERIZATIONseçeneği ayarlamak, veritabanı düzeyinde özel kilitler gerektirmeyen çevrimiçi bir işlemdir. - Veritabanını yeniden eklerken veya geri yüklerken seçeneğin geçerli ayarı
PARAMETERIZATIONkorunur.
Zorunlu parametreleştirme davranışını, tek bir sorguda ve yalnızca parametre değerleri bakımından farklılık gösteren sözdizimsel olarak eşdeğer diğer sorgularda basit parametreleştirmenin uygulanmasının denenmesini belirterek geçersiz kılabilirsiniz. Buna karşılık, veritabanında zorlamalı parametreleştirme devre dışı bırakılsa bile, yalnızca söz dizimsel olarak eşdeğer sorgularda zorlamalı parametreleştirmenin deneneceğini belirtebilirsiniz. Bu amaçla plan guides kullanın.
Uyarı
PARAMETERIZATION seçeneği FORCED olarak ayarlandığında, hata iletilerinin raporlanması PARAMETERIZATION seçeneği SIMPLE olarak ayarlandığında farklı olabilir: zorlamalı parametreleme altında birden çok hata iletisi bildirilebilir, basit parametreleme altında ise daha az ileti bildirilir ve hataların oluştuğu satır numaraları yanlış bildirilebilir.
Zorlamalı parametreleştirme etkinleştirildiğinde, basit parametreleştirme yine de oluşabilir. Örneğin, aşağıdaki sorgu zorlamalı parametreleştirme kurallarına göre parametrelenemez:
SELECT *
FROM Person.Address
WHERE AddressID = 1 + 2;
Ancak, basit parametreleştirme kurallarına göre parametrelendirilebilir. Zorlamalı parametreleştirme denendiğinde ancak başarısız olduğunda, basit parametreleştirme yine de denenmeye devam edilir.
SQL deyimlerini hazırlama
Database Engine, yürütülmeden önce T-SQL ifadelerinin hazırlanmasını destekler. Bir uygulamanın bir T-SQL ifadesini birden fazla kez çalıştırması gerekiyorsa, veritabanı API'sini şu şekilde kullanabilir:
- Beyanı bir kez hazırlayın. Bu adım, T-SQL ifadesini yürütme planı olarak derler.
- Önceden derlenmiş yürütme planı, ifadeyi yürütmesi gerektiğinde her seferinde çalıştırılır. Bu yaklaşım, ilk çalıştırmadan sonra her çalıştırmada T-SQL ifasının yeniden derlenmesini engeller. Deyimlerin hazırlanması ve yürütülmesi API işlevleri ve yöntemleri tarafından denetlenir. SQL Server Native Client OLE DB Provider ve SQL Server Native Client ODBC sürücüsü, T-SQL ifadelerini yürütmeye yönelik prepare/execute modelini destekler. Hazırlama isteğinde, ya sağlayıcı ya da sürücü ifadeyi hazırlama talebiyle SQL Server'a gönderir. Database Engine, bir yürütme planı derler ve o planın handle’ını sağlayıcıya veya sürücüye döndürür. Yürütme isteğinde, sağlayıcı veya sürücü sunucuya tanıtıcıyla ilişkili planı yürütmek için bir istek gönderir.
Hazırlanmış ifadeler Database Engine'de geçici nesneler oluşturamaz. Hazırlanan deyimler, geçici tablolar gibi geçici nesneler oluşturan sistem saklı yordamlarına referans veremez. Bu prosedürler doğrudan uygulanmalıdır.
Hazırla/çalıştır modelinin aşırı kullanımı performansı düşürebilir. Bir ifade yalnızca bir kez çalıştırılırsa, doğrudan yürütme için sunucuya sadece bir ağ gidiş-dönüş gerekir. Sadece bir kez çalıştırılan bir T-SQL ifadesi hazırlamak ve çalıştırmak için ekstra bir ağ gidiş-dönüş gerekir: bir sefer ifadeyi hazırlamak ve bir sefer de onu çalıştırmak için.
Bir deyim hazırlamak, parametre işaretleyicileri kullandığınızda daha etkilidir. Örneğin, bir uygulamanın zaman zaman örnek veritabanından ürün bilgilerini almasının AdventureWorksLT2025 istendiğini varsayalım. Uygulamanın bu görevi yerine getirmesinin iki yolu vardır.
İlk yaklaşımı kullanarak, uygulama istenen her ürün için ayrı bir sorgu çalıştırabilir:
SELECT *
FROM Production.Product
WHERE ProductID = 63;
İkinci yaklaşımı kullanarak uygulama aşağıdaki işlemleri gerçekleştirir:
Parametre belirteci (
?) içeren bir deyim hazırlar.SELECT * FROM Production.Product WHERE ProductID = ?;Bir program değişkenini parametre işaretçisine bağlar.
Ürün bilgilerine her ihtiyaç duyulduğunda, ilişkili değişkeni anahtar değeriyle doldurur ve deyimini yürütür.
İkinci yaklaşım ise, ifade üç kereden fazla yürütüldüğünde daha verimlidir.
Database Engine'de, hazırla/çalıştırma modeli, doğrudan yürütmeye göre önemli bir performans avantajı sunmaz; bunun nedeni, Database Engine'in yürütme planlarını yeniden kullanma biçimidir. Database Engine, mevcut T-SQL ifadelerini aynı T-SQL ifadesinin önceki yürütmeleri için oluşturulan yürütme planlarıyla eşleştirmek için verimli algoritmalara sahiptir. Bir uygulama, parametre işaretleyicileriyle bir T-SQL ifadesini birden fazla kez çalıştırırsa, Database Engine ilk yürütmedeki yürütme planını ikinci ve sonraki yürütmeler için tekrar kullanır (plan önbelleğinden yaşlanmadıkça). Hazırlama/yürütme modelinin hala şu avantajları vardır:
- Bir tanımlayıcı tutamaçla bir yürütme planı bulmak, T-SQL ifadesini mevcut yürütme planlarıyla eşleştirmek için kullanılan algoritmalardan daha verimlidir.
- Uygulama, yürütme planının ne zaman oluşturulacağını ve ne zaman tekrar kullanılacağını kontrol edebilir.
- Hazırlama/yürütme modeli, SQL Server'ın önceki sürümleri de dahil olmak üzere diğer veritabanlarına taşınabilir.
Parametre duyarlılığı
Parametre hassasiyeti, parametre koklama olarak da bilinir, Database Engine'in derleme veya yeniden derleme sırasında mevcut parametre değerlerini kokladığı ve bunları Sorgu Optimizator'a ileterek daha verimli sorgu yürütme planları oluşturulmasına yardımcı olması anlamına gelir.
Parametre değerleri, aşağıdaki toplu iş türleri için derleme veya yeniden derleme işlemleri sırasında incelenir:
- Saklanan prosedürler
- Aracılığıyla gönderilen sorgular
sp_executesql - Hazırlanan sorgular
Parameter sniffing sorunlarının giderilmesi hakkında daha fazla bilgi için bkz:
- Parametreye duyarlı sorunları araştırma ve çözme
- Planın yeniden kullanımı için açık parametreler kullanın
- Parametreye Duyarlı Plan optimizasyonu
- Azure SQL Veritabanı'nda parametreye duyarlı sorgu yürütme planı sorunlarıyla ilgili sorguları giderme
- Azure SQL Yönetilen Örneği'nde parametreye duyarlı sorgu yürütme planı sorunlarıyla ilgili sorguları giderme
Database Engine'deki bir sorgu OPTION (RECOMPILE) ipucunu kullandığında, Query Optimizer parametre ve yerel değişkenleri sabit katlama uygulanabilen ve literallere indirgenebilen derleme zamanı sabitlerine dönüştürür. Derleme sırasında, iyileştirici parametrelerin ve yerel değişkenlerin söz konusu ifadeden hemen önceki mevcut çalışma zamanı değerlerini bilir ve kullanabilir. Bu OPTION (RECOMPILE) ipucu, optimize edicinin belirli değerlere göre daha optimal bir sorgu planı oluşturmasını ve çalışma zamanında en iyi temel indekslerden faydalanmasını sağlar. Parametreler için, bu işlem toplu işleme veya saklı yordama başlangıçta geçirilen değerleri değil, yeniden derleme sırasındaki değerlerini ifade eder. Bu değerler, yordam içinde, RECOMPILE içeren deyime ulaşmadan önce değiştirilebilir. Bu davranış, yüksek değişkenlikli veya çarpık girdi verilerine sahip sorguların performansını artırabilir; ancak sorgunun her çalıştırıldığında yeniden derlenmesi pahasına. Bu maliyet yüksek olabilir. Tüm iş yükü üzerindeki etkisini değerlendirmeden RECOMPILE ipucunu kullanmaktan kaçının.
Yerel değişkenler ve kardinalite tahminleri
Bir sorgu yerel değişkenler kullandığında, Database Engine derleme sırasında değerlerini belirleyemez, bu yüzden mevcut istatistikler veya sezgisel veriler kullanarak kardinaliteyi tahmin eder. İstatistikler varsa, koşulla eşleşen satır sayısını tahmin etmek için genellikle istatistiksel histogramdaki Tüm Yoğunluk değerini ( ortalama yoğunluk olarak da bilinir) kullanır. Ancak, sütun için istatistikler yoksa, Database Engine eşitlik koşulları için %10 seçicilik, eşitsizlikler ve aralıklar için ise %30 varsaymak gibi sezgisel tahminlere başvurur. Bu tahminler, yürütme planlarının doğruluğunu azaltabilir. Aşağıda yerel değişken kullanan bir sorgu örneği verilmiştır.
DECLARE @ProductId AS INT = 100;

SELECT *
FROM Products
WHERE ProductId = @ProductId;
Bu durumda, Database Engine sorguyu optimize etmek için 100 değerini kullanmaz. Genel bir tahmin kullanır.
Paralel sorgu işleme
Database Engine, birden fazla mikroişlemci (CPU) olan bilgisayarlar için sorgu yürütme ve indeksleme işlemlerini optimize etmek için paralel sorgular sağlar. Database Engine, birkaç işletim sistemi işçi iş parçacığı kullanarak paralel olarak sorgulama veya indeksleme işlemi gerçekleştirebildiği için, işlem hızlı ve verimli bir şekilde tamamlanır.
Sorgu optimizasyonu sırasında, Database Engine paralel yürütmeden fayda sağlayabilecek sorgular veya indeksleme işlemleri arar. Bu sorgular için, Database Engine, sorguyu paralel yürütmeye hazırlamak için sorgu yürütme planına değişim operatörleri ekler. Exchange işleci, işlem yönetimi, veri yeniden dağıtım ve akış denetimi sağlayan sorgu yürütme planındaki bir işleçtir. Exchange işleci, alt tür olarak Distribute Streams, Repartition Streams ve Gather Streams mantıksal işleçlerini içerir, bunlardan biri veya daha fazlası paralel sorgu için sorgu planının Showplan çıkışında görünebilir.
Önemli
Bazı yapılar, Database Engine'in tüm yürütme planı veya yürütme planının bazı bölümlerinde paralellik kullanabilmesini engeller.
Paralelliği engelleyen yapılar şunlardır:
| İnşa etmek | Açıklama |
|---|---|
| Skaler Kullanıcı Tanımlı İşlevler | Skaler kullanıcı tanımlı fonksiyonlar hakkında daha fazla bilgi için Kullanıcı Tanımlı Fonksiyonlar Oluştur bölümüne bakınız. SQL Server 2019 (15.x) itibarıyla, SQL Server Database Engine bu fonksiyonları inline yapabilir ve sorgu işleme sırasında paralellik kullanımını açabilir. skaler UDF satır içi kullanımı hakkında daha fazla bilgi için SQL veritabanlarında akıllı sorgu işleme bölümünü inceleyebilirsiniz. |
| Uzak Sorgu | Uzaktan Sorgu hakkında daha fazla bilgi için Mantıksal ve fiziksel showplan işleci başvurusu bölümüne bakın. |
| Dinamik imleçler | İmleçler hakkında daha fazla bilgi için bkz. DECLARE CURSOR. |
| Özyinelemeli sorgular | Özyineleme hakkında daha fazla bilgi için, Özyinelemeli Ortak Tablo İfadelerini Tanımlama ve Kullanma Yönergeleri ve T-SQL'de Özyineleme konularına bakınız. |
| Çok ifadeli tablo değerli işlevler (MSTVFs) | MSTVF'ler hakkında daha fazla bilgi için Kullanıcı Tanımlı Fonksiyonları Oluştur (Database Engine) bölümüne bakınız. |
TOP anahtar sözcük |
Daha fazla bilgi için bkz. TOP. |
Sorgu yürütme planı QueryPlan öğesinde NonParallelPlanReason özniteliğini içerebilir ve paralelliğin neden kullanılmadığı açıklanır. Bu özniteliğin değerleri şunlardır:
| NonParallelPlanReason Değeri | Açıklama |
|---|---|
MaxDOPSetToOne |
Maksimum paralellik derecesi 1 olarak ayarlanmıştır. |
EstimatedDOPIsOne |
Tahmini paralellik derecesi 1. |
NoParallelWithRemoteQuery |
Paralellik uzak sorgular için desteklenmez. |
NoParallelDynamicCursor |
Dinamik imleçler için paralel planlar desteklenmez. |
NoParallelFastForwardCursor |
Hızlı imleçler için paralel planlar desteklenmez. |
NoParallelCursorFetchByBookmark |
Yer işaretiyle getirilen imleçler için paralel planlar desteklenmez. |
NoParallelCreateIndexInNonEnterpriseEdition |
Paralel dizin oluşturma, Enterprise dışı sürümler için desteklenmez. |
NoParallelPlansInDesktopOrExpressEdition |
Masaüstü ve Express sürümü için paralel planlar desteklenmez. |
NonParallelizableIntrinsicFunction |
Sorgu paralelleştirilemez bir iç işleve başvuruyor. |
CLRUserDefinedFunctionRequiresDataAccess |
Paralellik, veri erişimi gerektiren bir CLR UDF için desteklenmez. |
TSQLUserDefinedFunctionsNotParallelizable |
Sorgu, paralelleştirilebilir olmayan bir T-SQL Kullanıcı Tanımlı İşleve başvuruyor. |
TableVariableTransactionsDoNotSupportParallelNestedTransaction |
Tablo değişkeni işlemleri paralel iç içe geçmiş işlemleri desteklemez. |
DMLQueryReturnsOutputToClient |
DML sorgusu istemciye çıktı döndürür ve paralelleştirilebilir değildir. |
MixedSerialAndParallelOnlineIndexBuildNotSupported |
Tek bir çevrimiçi dizin oluşturma için desteklenmeyen seri ve paralel plan karışımı. |
CouldNotGenerateValidParallelPlan |
Paralel planın doğrulanması başarısız oldu, seriye geri dönülüyor. |
NoParallelForMemoryOptimizedTables |
Başvurulan In-Memory OLTP tabloları için paralellik desteklenmiyor. |
NoParallelForDmlOnMemoryOptimizedTable |
In-Memory OLTP tablosunda DML için paralellik desteklenmez. |
NoParallelForNativelyCompiledModule |
Referans verilen yerel derlenmiş modüller için paralellik desteklenmez. |
NoRangesResumableCreate |
Devam edebilen bir oluşturma işlemi için aralık üretimi başarısız oldu. |
Exchange işleçleri eklendikten sonra, sonuç paralel sorgu yürütme planıdır. Paralel sorgu yürütme planı birden fazla çalışan iş parçacığı kullanabilir. Paralel olmayan (seri) bir sorgu tarafından kullanılan seri yürütme planı, yürütmesi için yalnızca bir çalışan iş parçacığı kullanır. Paralel sorgu tarafından gerçekte kullanılan işçi iş parçacığı sayısı, sorgu planının yürütülmesinin başlatılması sırasında belirlenir ve planın karmaşıklığına ve paralellik derecesine bağlıdır.
Paralellik derecesi (DOP), paralel bir görevi yürütmek için kullanılabilecek maksimum işlemci sayısını belirtir. DOP, bir sorgu tarafından kullanılan toplam işçi iş parçacığı sayısını göstermez. DOP sınırı, görev başına ayarlanır. Bu, talep başına veya sorgu başına bir sınır değildir. Bu, paralel sorgu yürütme sırasında tek bir isteğin zamanlayıcıya atanmış birden çok görev oluşturabileceği anlamına gelir. Farklı görevler eşzamanlı yürütüldüğünde, sorgu yürütmesinin herhangi bir anında, MAXDOP tarafından belirtilenden daha fazla işlemci aynı anda kullanılabilir. Daha fazla bilgi için İş Parçacığı ve görev mimarisi kılavuzuna bakın.
Sorgu İyileştiricisi, aşağıdaki koşullardan herhangi biri doğruysa, bir sorgu için paralel yürütme planı kullanmaz:
Seri yürütme planı basittir ya da paralellik ayarı için maliyet eşiğini aşmaz.
Seri yürütme planı, iyileştirici tarafından keşfedilen paralel yürütme planlarından daha düşük toplam tahmini alt ağaç maliyetine sahiptir.
Sorgu, paralel olarak çalıştırılamayan skaler veya ilişkisel işleçler içeriyor. Bazı işleçler, sorgu planının bir bölümünün seri modda çalışmasına veya planın tamamının seri modda çalışmasına neden olabilir.
Uyarı
Paralel bir planın toplam tahmini alt ağaç maliyeti, paralellik ayarı için maliyet eşiğinden daha düşük olabilir. Yani, seri planın toplam tahmini alt ağacı maliyeti bunu aşmış ve daha düşük toplam tahmini alt ağac maliyetine sahip sorgu planı seçilmiştir.
Paralellik derecesi (DOP)
Database Engine, her bir paralel sorgu yürütme veya indeks veri tanımlama dili (DDL) işlemi örneği için en iyi paralellik derecesini otomatik olarak algılar. Bu değeri aşağıdaki kriterlere göre belirler:
SQL Server'ın simetrik çok işlemcili bilgisayar (SMP) gibi birden fazla mikro işlemciye veya CPU'ya sahip bir bilgisayarda çalışıp çalışmadığı. Yalnızca birden fazla CPU'ya sahip bilgisayarlar paralel sorgular kullanabilir.
Yeterli iş parçacığının mevcut olup olmadığı Her sorgu veya dizin işleminin yürütülmesi için belirli sayıda çalışan iş parçacığı gerekir. Paralel plan yürütmek için seri plana göre daha fazla çalışan iş parçacığı gerekir ve gerekli çalışan iş parçacıklarının sayısı paralellik derecesiyle artar. Paralellik planının belirli bir paralellik derecesi için çalışan iş parçacığı gereksinimi karşılanamazsa, SQL Server Database Engine otomatik olarak paralellik derecesini azaltır veya paralel planı seri olarak çalıştırır.
Yürütülen sorgu veya dizin işleminin türü. Dizin oluşturan veya yeniden oluşturan ya da kümelenmiş dizini bırakan dizin işlemleri ve cpu döngülerini yoğun olarak kullanan sorgular paralel plan için en iyi adaylardır. Örneğin, büyük tabloların birleşimleri, büyük toplamalar ve büyük sonuç kümelerinin sıralanması iyi adaylardır. İşlem işleme uygulamalarında sıkça bulunan temel sorgularda, bir sorguyu paralel yürütmek için gereken ek koordinasyonun potansiyel performans artışından daha ağır bastığı görülür. Paralellikten yararlanan sorgular ile fayda sağlamayan sorguları ayırt etmek için, SQL Server Veritabanı Altyapısı sorguyu veya dizin işlemini yürütmenin tahmini maliyetini paralellik değerinin maliyet eşiğiyle karşılaştırır. Kullanıcılar, uygun testler farklı bir değerin çalışan iş yükü için daha uygun olduğunu gösterirse,
5kullanarak varsayılan değerini değiştirebilirler.İşlenmek için yeterli sayıda satır olup olmadığı. Sorgu İyileştirici, satır sayısının çok düşük olduğunu belirlerse, satırları dağıtmak için değişim operatörleri kullanmaz. Bu nedenle, işleçler seri olarak yürütülür. İşleçlerin seri planda yürütülmesi, başlatma, dağıtım ve koordinasyon maliyetlerinin paralel işleç yürütmesi tarafından elde edilen kazanımları aşması senaryolarını önler.
Mevcut istatistiklerin kullanılabilir olup olmadığı. En yüksek paralellik derecesi mümkün değilse, paralel plan terk edilmeden önce düşük dereceler dikkate alınır. Örneğin, bir görünümde kümelenmiş bir indeks oluşturduğunuzda, istatistikler değerlendirilemez çünkü kümelenmiş indeks henüz mevcut değildir. Bu durumda, SQL Server Veritabanı Altyapısı dizin işlemi için en yüksek paralellik derecesini sağlayamaz. Ancak sıralama ve tarama gibi bazı işleçler paralel yürütmeden yararlanmaya devam edebilir.
Uyarı
Paralel dizin işlemleri yalnızca SQL Server Enterprise, Developer ve Evaluation sürümlerinde kullanılabilir.
Yürütme zamanında SQL Server Veritabanı Altyapısı, daha önce açıklanan geçerli sistem iş yükünün ve yapılandırma bilgilerinin paralel yürütmeye izin verip vermediğini belirler. Paralel yürütme garanti edilirse, SQL Server Veritabanı Altyapısı en iyi çalışan iş parçacığı sayısını belirler ve paralel planın yürütülmesini bu çalışan iş parçacıklarına yayar. Paralel yürütme için bir sorgu veya dizin işlemi birden çok çalışan iş parçacığında yürütülmeye başladığında, işlem tamamlanana kadar aynı sayıda çalışan iş parçacığı kullanılır. SQL Server Veritabanı Motoru, bir yürütme planı plan önbelleğinden her alındığında çalışan iş parçacıkları için en uygun sayıyı yeniden değerlendirir. Örneğin, önbelleklenmiş paralel planın bir yürütülmesi seri olarak çalışabilir, aynı planın sonraki bir yürütmesi üç işçi iş parçacığını kullanabilir ve üçüncü bir yürütme dört işçi iş parçacığını kullanabilir.
Paralel sorgu yürütme planındaki güncelleştirme ve silme işleçleri seri olarak yürütülür, ancak WHERE bir UPDATE veya DELETE deyiminin yan tümcesi paralel olarak yürütülebilir. Gerçek veri değişiklikleri daha sonra veritabanına seri olarak uygulanır.
Veritabanı uyumluluk seviyesi 110'dan başlayarak, bu SELECT ... INTO deyim paralel olarak çalıştırılabilir. Diğer insert operatör türleri önceki sürümlerde açıklandığı şekilde çalışır.
Veritabanı uyumluluk seviyesi 130'dan başlayarak, INSERT ... SELECT deyimi, yığınlara veya kümelenmiş sütun deposu dizinlerine (CCI) ekleme yapılırken ve TABLOCK ipucusu kullanıldığında paralel olarak yürütülebilir. Yerel geçici tablolara (# önekiyle tanımlanan) ve küresel geçici tablolara (## önekleriyle tanımlanan) eklemeler de TABLOCK ipucu kullanılarak paralellik için etkinleştirilir. Daha fazla bilgi için bkz. INSERT.
Statik ve anahtar kümesine dayalı imleçler, paralel yürütme planları tarafından doldurulabilir. Ancak, dinamik imleçlerin davranışı yalnızca seri yürütme tarafından sağlanabilir. Sorgu İyileştiricisi, dinamik imlecin parçası olan bir sorgu için her zaman bir seri yürütme planı oluşturur.
Paralellik derecelerini geçersiz kılma
Paralellik derecesi, paralel plan yürütmede kullanılacak işlemci sayısını ayarlar. Bu yapılandırmayı çeşitli seviyelerde ayarlayabilirsiniz:
Sunucu seviyesinde, maksimum paralellik derecesi (
MAXDOP) sunucu yapılandırma seçeneği kullanılarak.Şunlar için geçerlidir: SQL Server
SQL Server 2019 (15.x), kurulum sürecinde
MAXDOPsunucu yapılandırma seçeneğinin ayarlanmasına yönelik otomatik öneriler sundu. Kurulum kullanıcı arabirimi, önerilen ayarları kabul etmenizi veya kendi değerinizi girmenizi sağlar. Daha fazla bilgi için bkz. Veritabanı Altyapısı Yapılandırması - MaxDOP sayfası.İş yükü seviyesi,
MAX_DOPkullanılarak.Şunlar için geçerlidir: SQL Server
Veritabanı düzeyinde,
MAXDOPkullanılarak.Uygulanır: SQL Server, Azure SQL Veritabanı ve Azure SQL Yönetilen Örneği
Sorgu veya dizin deyimi düzeyinde,
MAXDOPveyaMAXDOPdizin seçeneği kullanılarak. Örneğin, çevrimiçi dizin işlemi için ayrılmış işlemci sayısını artırıp azaltarak denetlemek üzereMAXDOPseçeneğini kullanabilirsiniz. Bu şekilde, bir endeks operasyonunun kullandığı kaynakları eşzamanlı kullanıcıların kaynaklarıyla dengeleyebilirsiniz.Uygulanır: SQL Server, Azure SQL Veritabanı ve Azure SQL Yönetilen Örneği
max degree of parallelism seçeneğini 0 (varsayılan) olarak ayarlamak, Database Engine'in paralel plan yürütmesinde maksimum 64 işlemciye kadar tüm mevcut işlemcileri kullanmasını sağlar. Database Engine, 0 seçeneği MAXDOP olarak ayarlandığında 64 mantıksal işlemci için çalışma zamanı hedefi belirlese de, gerekirse manuel olarak farklı bir değer ayarlayabilirsiniz.
MAXDOP öğesini sorgular ve dizinler için 0 olarak ayarlamak, Veritabanı Altyapısı'nın paralel plan yürütmesinde verilen sorgular veya dizinler için en fazla 64 işlemciye kadar kullanılabilir tüm işlemcileri kullanmasına olanak tanır.
MAXDOP tüm paralel sorgular için zorunlu bir değer değil, paralellik için uygun tüm sorgular için geçici bir hedeftir. Bu, çalışma zamanında yeterli işçi iş parçacığı mevcut değilse, bir sorgunun MAXDOP sunucu yapılandırma seçeneğinden daha düşük bir paralellik derecesiyle yürütülebileceği anlamına gelir.
Tavsiye
Daha fazla bilgi için, öğesinin sunucu, veritabanı, sorgu veya ipucu düzeyinde yapılandırılmasına ilişkin yönergeler için MAXDOP bakın.
Paralel sorgu örneği
Aşağıdaki sorgu, 1 Nisan 2024'ten itibaren belirli bir çeyrekte verilen sipariş sayısını sayar; bu siparişlerde siparişin en az bir satır kalemi müşteri tarafından taahhüt edilen tarihten sonra teslim alınmıştır. Bu sorgu, her sıralama önceliğine göre gruplandırılmış ve artan öncelik sırasına göre sıralanmış bu tür siparişlerin sayısını listeler.
Bu örnekte teorik tablo ve sütun adları kullanılır.
SELECT o_orderpriority,
       COUNT(*) AS Order_Count
FROM orders
WHERE o_orderdate >= '2024/04/01'
      AND o_orderdate < DATEADD(mm, 3, '2024/04/01')
      AND EXISTS (SELECT *
                  FROM lineitem
                  WHERE l_orderkey = o_orderkey
                        AND l_commitdate < l_receiptdate)
GROUP BY o_orderpriority
ORDER BY o_orderpriority;
İlk olarak `lineitem` ve `orders` tablolarında aşağıdaki dizinlerin tanımlandığını varsayalım:
CREATE INDEX l_order_dates_idx
    ON lineitem(l_orderkey, l_receiptdate, l_commitdate, l_shipdate);

CREATE UNIQUE INDEX o_datkeyopr_idx
    ON ORDERS(o_orderdate, o_orderkey, o_custkey, o_orderpriority);
Aşağıda daha önce gösterilen sorgu için oluşturulmuş olası paralel planlardan biri gösterilmiştir:
|--Stream Aggregate(GROUP BY:([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=COUNT(*)))
    |--Parallelism(Gather Streams, ORDER BY:
                  ([ORDERS].[o_orderpriority] ASC))
         |--Stream Aggregate(GROUP BY:
                  ([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=Count(*)))
              |--Sort(ORDER BY:([ORDERS].[o_orderpriority] ASC))
                   |--Merge Join(Left Semi Join, MERGE:
                  ([ORDERS].[o_orderkey])=
                        ([LINEITEM].[l_orderkey]),
                  RESIDUAL:([ORDERS].[o_orderkey]=
                        [LINEITEM].[l_orderkey]))
                        |--Sort(ORDER BY:([ORDERS].[o_orderkey] ASC))
                        |    |--Parallelism(Repartition Streams,
                           PARTITION COLUMNS:
                           ([ORDERS].[o_orderkey]))
                        |         |--Index Seek(OBJECT:
                     ([tpcd1G].[dbo].[ORDERS].[O_DATKEYOPR_IDX]),
                     SEEK:([ORDERS].[o_orderdate] >=
                           Apr  1 2024 12:00AM AND
                           [ORDERS].[o_orderdate] <
                           Jul  1 2024 12:00AM) ORDERED)
                        |--Parallelism(Repartition Streams,
                     PARTITION COLUMNS:
                     ([LINEITEM].[l_orderkey]),
                     ORDER BY:([LINEITEM].[l_orderkey] ASC))
                             |--Filter(WHERE:
                           ([LINEITEM].[l_commitdate]<
                           [LINEITEM].[l_receiptdate]))
                                  |--Index Scan(OBJECT:
         ([tpcd1G].[dbo].[LINEITEM].[L_ORDER_DATES_IDX]), ORDERED)
Aşağıdaki illüstrasyon, paralellik derecesi 4 olan ve iki tablolu birleştirme içeren bir sorgu planını göstermektedir.
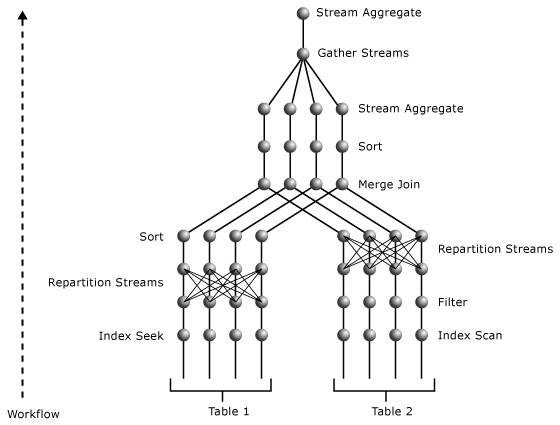
Paralel plan üç paralellik işleci içerir. Hem dizinin Index Seek işleci o_datkey_ptr hem de dizinin Dizin Tarama işleci l_order_dates_idx paralel olarak gerçekleştirilir. Bu süreç, sırasıyla Index Scan’ın üzerindeki en yakın Paralellik operatörlerinden ve Index Seek operatörlerinden belirlenebilen birkaç ayrı akış üretir. Her iki operatör de exchange türünü yeniden bölümleme yapıyor. Verileri akışlar arasında yeniden dağıtır ve çıktılarında da girdilerindeki kadar sayıda akış üretirler. Bu akış sayısı paralellik derecesine eşittir.
l_order_dates_idx Index Scan operatörünün üzerindeki paralellik operatörü, giriş akışlarını L_ORDERKEY değerini anahtar olarak kullanarak yeniden bölümler. Bu şekilde, L_ORDERKEY aynı değerleri aynı çıkış akışında son bulur. Aynı zamanda, çıkış akışları Birleştirme İşlecinin L_ORDERKEY sütunundaki giriş gereksinimini karşılamak için sırayı korur.
Index Seek operatörünün üzerindeki paralellik operatörü, giriş akışlarını O_ORDERKEY değerini kullanarak yeniden bölümlendirir. Çünkü girdisi O_ORDERKEY sütun değerlerine göre sıralanmamıştır ve bu sütun Merge Join operatöründe birleştirme sütunu olduğundan, paralellik ve Merge Join operatörleri arasındaki Sıralama operatörü, girdinin birleştirme sütunlarında Merge Join operatörü için sıralı olmasını sağlar. Sort işleci, Birleştirme işleci gibi paralel olarak gerçekleştirilir.
En üstteki paralellik işleci, çeşitli akışlardan tek bir akışta sonuç toplar. Paralellik işlecinin altındaki Stream Aggregate işleci tarafından gerçekleştirilen kısmi toplamalar, paralellik işlecinin üzerindeki Stream Aggregate işlecinde her bir farklı SUM değeri için tek bir O_ORDERPRIORITY değerinde toplanır. Bu planın iki değişim segmenti olduğu ve paralellik derecesi 4 olduğu için sekiz işçi ipliği kullanılır.
Bu örnekte kullanılan operatörler hakkında daha fazla bilgi için Mantıksal ve fiziksel showplan operatörü başvurusuna bakınız.
Paralel dizin işlemleri
Bir indeks oluşturan veya yeniden inşa eden ya da kümelenmiş bir indeksi kaldıran indeks işlemleri için sorgu planları, birden fazla işlemcisi olan bilgisayarlarda paralel, çok iş parçacıklı işlemleri destekleyebilir.
Uyarı
Paralel indeks işlemleri yalnızca Enterprise sürümünde mevcuttur.
Database Engine, indeks işlemlerinde paralellik derecesini (çalıştırılması gereken toplam ayrı işçi iş parçacığı) belirlemek için diğer sorgularda olduğu gibi aynı algoritmaları kullanır.
Maksimum paralellik derecesi sunucu yapılandırma seçeneği, bir indeks işlemi için maksimum paralellik derecesini belirler.
ALTER TABLE, CREATE INDEX, MAXDOP ve max degree of parallelism ifadelerinde DROP INDEX dizin seçeneğini ayarlayarak, tek tek dizin işlemleri için ALTER INDEX değerini geçersiz kılabilirsiniz.
SQL Server Database Engine bir indeks yürütme planı oluşturduğunda, paralel işlem sayısı bu değerler arasında en düşük değere ayarlanır:
- Bilgisayardaki işlemci veya CPU sayısı.
-
max degree of parallelismsunucu yapılandırma seçeneğinde belirtilen sayı. - SQL Server işçi iş parçacıkları için gerçekleştirilen iş yükü eşiğini aşmamış CPU sayısı.
Örneğin, sekiz CPU'ya sahip bir bilgisayarda, ancak max degree of parallelism, 6 olarak ayarlanmışsa, dizin oluşturma işlemi en fazla altı paralel işçi iş parçacığı kullanır. Bir dizin yürütme planı oluşturulduğunda bilgisayardaki CPU'lardan beşi SQL Server çalışma eşiğini aşarsa, yürütme planı yalnızca üç paralel çalışan iş parçacığı belirtir.
Paralel indeks işleminin ana aşamaları şunlardır:
- Bir eşgüdüm çalışan iş parçacığı, dizin anahtarlarının dağılımını tahmin etmek için tabloyu hızla ve rastgele tarar. Eşgüdüm sağlayan çalışan iş parçacığı, paralel işlemlerin derecesine eşit sayıda anahtar aralığı oluşturan anahtar sınırlarını belirler; her anahtar aralığının benzer sayıda satır kapsadığı tahmin edilir. Örneğin, tabloda dört milyon satır varsa ve paralellik derecesi 4 ise, koordine eden çalışan iş parçacığı, her kümede 1 milyon satır bulunan dört satır setini ayıran anahtar değerleri belirler. Koordinasyon yapan işçi iş parçacığı tüm CPU'ları kullanacak kadar anahtar aralığı oluşturamazsa, paralellik derecesini buna göre azaltır.
- Koordine eden çalışan iş parçacığı, paralel işlemlerin derecesine eşit bir dizi çalışan iş parçacığı gönderir ve bu çalışan iş parçacıklarının işlerini tamamlanmasını bekler. Her çalışan iş parçacığı, yalnızca çalışan iş parçacığına atanan aralık içinde anahtar değerleri olan satırları alan bir filtre kullanarak temel tabloyu tarar. Her çalışan iş parçacığı, anahtar aralığındaki satırlar için bir dizin yapısı oluşturur. Bölümlenmiş dizin söz konusu olduğunda, her çalışan iş parçacığı belirli sayıda bölüm oluşturur. Bölümler çalışan iş parçacıkları arasında paylaşılmaz.
- Tüm paralel işçi iş parçacıkları tamamlandıktan sonra, koordine eden işçi iş parçacığı indeks alt birimlerini tek bir indekse bağlar. Bu aşama yalnızca çevrimdışı dizin işlemleri için geçerlidir.
Bireysel ALTER TABLE veya CREATE TABLE ifadeler, bir dizin oluşturmayı gerektiren birden fazla kısıtlama içerebilir. Her dizin oluşturma işlemi birden çok CPU'su olan bir bilgisayarda paralel bir işlem olsa da, bu birden çok dizin oluşturma işlemi seri olarak gerçekleştirilir.
Dağıtılmış sorgu mimarisi
Database Engine, T-SQL ifadelerinde heterojen OLE DB veri kaynaklarına referans vermek için iki yöntemi destekler:
Bağlı sunucu adları
Bir OLE DB veri kaynağına sunucu adı vermek için sistemde saklanan
sp_addlinkedservervesp_addlinkedsrvloginprosedürlerini kullanın. Bu bağlı sunuculardaki nesnelere dört parçalı isimlerle T-SQL ifadeleriyle referans verebilirsiniz. Örneğin, bağlı sunucu adıDeptSQLSrvrbaşka bir SQL Server örneğinde tanımlanmışsa, aşağıdaki deyim bu sunucudaki bir tabloya başvurur:SELECT JobTitle, HireDate FROM DeptSQLSrvr.AdventureWorks2025.HumanResources.Employee;Ayrıca, OLE DB veri kaynağından bir satır kümesini açmak için bağlantılı sunucu adını bir
OPENQUERYifadesinde de belirtebilirsiniz. Sonra bu satır kümesine T-SQL ifadelerindeki bir tablo gibi referans verebilirsiniz.Geçici bağlayıcı adları
Veri kaynağına nadiren yapılan başvurular için, bağlı sunucuya bağlanmak için gereken bilgileri içeren
OPENDATASOURCEveyaOPENROWSETişlevlerini belirtin. Böylece T-SQL ifadelerinde bir tabloya referans verdiğiniz gibi satır kümesine referans verebilirsiniz:SELECT a.* FROM OPENROWSET ( 'Microsoft.Jet.OLEDB.4.0', 'MSOffice\Access\Samples\Northwind.mdb'; 'Admin'; '', Employees ) AS a;
Database Engine, ilişkisel motor ile depolama motoru arasında iletişim kurmak için OLE DB kullanır. İlişkisel motor, her T-SQL ifadesini, depolama motorunun temel tablolardan açtığı temel OLE DB satır kümelerinde bir dizi işleme ayırır. Bu süreç, ilişkisel motorun herhangi bir OLE DB veri kaynağında temel OLE DB satır kümelerini de açabilmesini sağlar.
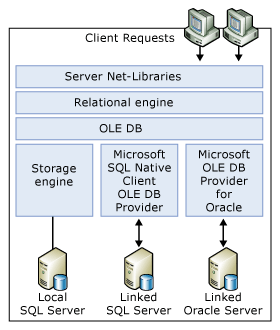
İlişkisel altyapı, bağlı sunucularda satır kümelerini açmak, satırları getirmek ve işlemleri yönetmek için OLE DB uygulama programlama arabirimini (API) kullanır.
Bağlantılı sunucu olarak eriştiğiniz her OLE DB veri kaynağı için, SQL Server çalıştıran sunucunun bir OLE DB sağlayıcısı olması gerekir. Belirli bir OLE DB veri kaynağına karşı kullanabileceğiniz T-SQL operasyonları seti, OLE DB sağlayıcısının yeteneklerine bağlıdır.
Her SQL Server örneği için, sysadmin sabit sunucu rolünün üyeleri, SQL Server DisallowAdhocAccess özelliğini kullanarak bir OLE DB sağlayıcısı için ad hoc connector adlarının kullanımını etkinleştirebilir veya devre dışı bırakabilir. Ad hoc erişimi etkinleştirdiğinizde, o örneğine giriş yapan herhangi bir kullanıcı, OLE DB sağlayıcısının erişebileceği ağdaki herhangi bir veri kaynağına referans olarak ad hoc bağlayıcı isimleri içeren T-SQL ifadelerini çalıştırabilir. Veri kaynaklarına erişimi kontrol etmek için, sysadmin sabit sunucu rolü üyeleri, o OLE DB sağlayıcısı için ad hoc erişimi devre dışı bırakabilir ve böylece kullanıcıları yalnızca yöneticiler tarafından tanımlanan bağlantılı sunucu adlarıyla referans verilen veri kaynaklarıyla sınırlandırabilir. Varsayılan olarak, SQL Server OLE DB sağlayıcısı için geçici erişim etkinleştirilir ve diğer tüm OLE DB sağlayıcıları için devre dışı bırakılır.
Dağıtık sorgular, kullanıcıların SQL Server hizmetinin çalıştığı Windows hesabının güvenlik bağlamını kullanarak başka bir veri kaynağına (örneğin dosyalar, Active Directory gibi ilişkisel olmayan veri kaynakları vb.) erişmesine olanak tanıyabilir. SQL Server, Windows girişleri için oturum açma hesabını uygun şekilde taklit eder. Ancak, SQL Server girişleri için bu kimliğe bürünme mümkün değildir. Bu sınırlama, dağıtık sorgu kullanıcısının izinlerinin bulunmadığı, ancak SQL Server hizmetinin çalıştığı hesabın izinlerinin bulunduğu başka bir veri kaynağına erişmesine potansiyel olarak olanak tanıyabilir. İlgili bağlı sunucuya erişme yetkisi olan belirli oturum açma bilgilerini tanımlamak için kullanın sp_addlinkedsrvlogin . Bu kontrol ad hoc isimler için mevcut değildir, bu yüzden bir OLE DB sağlayıcısını ad hoc erişim için etkinleştirirken dikkatli olun.
Mümkün olduğunda, Database Engine, birleştirmeler, kısıtlamalar, projeksiyonlar, sıralamalar ve GROUP BY işlemleri gibi ilişkisel işlemleri OLE DB veri kaynağına gönderir. Database Engine, varsayılan olarak temel tabloyu SQL Server'a tarayıp ilişkisel işlemleri kendisi gerçekleştirmez. Database Engine, desteklediği SQL dilbilgisi seviyesini belirlemek için OLE DB sağlayıcısına sorgular ve bu bilgilere dayanarak mümkün olduğunca çok ilişkisel işlemi sağlayıcıya gönderir.
Database Engine, bir OLE DB sağlayıcısının OLE DB veri kaynağında anahtar değerlerin nasıl dağıtıldığını gösteren istatistikleri döndürmesi için bir mekanizma tanımlar. Bu mekanizma, Database Engine Query Optimizer'ın, veri kaynağındaki veri desenini her T-SQL ifadesinin gereksinimlerine göre daha iyi analiz etmesini sağlar ve Query Optimizer'ın optimal yürütme planları oluşturma yeteneğini artırır.
Bölümlenmiş tablolar ve indeksler üzerinde sorgu işleme
Database Engine, bölümlenmiş tablolar ve indeksler için bölüm farkında sorgu işlemeyi destekler. Bu bölüm, sorgu işlemcisinin bölümlenmiş nesneleri nasıl işlediğini, bölümlemeyi içeren yürütme planlarının nasıl yorumlanacağını ve bölümlenmiş nesnelerde sorgu performansını artırmak için en iyi uygulamaları açıklar.
Uyarı
Bölümlenmiş tablolar ve indeksler, SQL Server Standard sürümünde SQL Server 2016 (13.x) Service Pack 1’den başlayarak desteklenmektedir.
Yeni bölünmeye duyarlı arama işlemi
Database Engine'de, sorgu işlemcisi bölümlenmiş bir tabloyu dahili olarak, PartitionID önde gelen sütun olacak şekilde çok sütunlu bir dizin olarak görür.
PartitionID , belirli bir satırı içeren bölümü temsil ID etmek için dahili olarak kullanılan gizli bir hesaplanan sütundur. Örneğin, T olarak tanımlanan T(a, b, c) tablosunun, a sütunu üzerinde bölümlendiğini ve b sütunu üzerinde kümelenmiş bir dizine sahip olduğunu varsayın. Bu bölümlenmiş tablo, şema T(PartitionID, a, b, c) ve kompozit anahtar (PartitionID, b)üzerinde kümelenmiş bir indeks içeren bölünmemiş bir tablo olarak ele alınır. Bu temsil, Sorgu İyileştiricisi'nin herhangi bir bölümlenmiş tabloda veya dizinde PartitionID temelinde arama işlemleri gerçekleştirmesini sağlar.
Bölüm eleme işlemi artık bu arama işleminde gerçekleştirilir.
Ayrıca, Sorgu Optimizeri, tek bir koşula sahip bir arama veya tarama işleminin PartitionID mantıksal olarak önde gelen sütun olacak şekilde ve muhtemelen diğer dizin anahtarı sütunları üzerinde de gerçekleştirilebilmesi için genişletilmiştir. Sorgulama işlemcisi, birinci seviye arama işleminin ölçütünü karşılayan her farklı değer için, farklı bir koşulla bir veya daha fazla ek sütunda ikinci seviye arama yapar.
bölüm atlama taraması olarak adlandırılan bu işlem, Sorgu İyileştiricisinin erişilecek bölümleri belirlemek için tek bir koşula dayalı bir arama veya tarama işlemi gerçekleştirmesine ve bu operatör içinde, farklı bir koşulu karşılayan satırları bu bölümlerden döndürmek için ikinci düzey bir dizin arama işlemi gerçekleştirmesine olanak tanır. Örneğin, aşağıdaki sorguyu göz önünde bulundurun.
SELECT *
FROM T
WHERE a < 10
      AND b = 2;
Bu örnek için, T olarak tanımlanan T(a, b, c) tablosunun a sütununa göre bölümlendiğini ve b sütununda kümelenmiş bir indekse sahip olduğunu varsayalım. Aşağıdaki bölümleme fonksiyonu, tablo Tiçin bölünme sınırlarını tanımlar:
CREATE PARTITION FUNCTION myRangePF1(INT)
    AS RANGE LEFT
    FOR VALUES (3, 7, 10);
Sorguyu çözmek için sorgu işlemcisi, koşulunu T.a < 10karşılayan satırları içeren her bölümü bulmak için birinci düzey bir arama işlemi gerçekleştirir. Bu işlem, erişilecek bölümleri belirler. Tanımlanan her bölüm içinde işlemci, T.b = 2 sütunundaki kümelenmiş dizinde ikinci düzey bir arama gerçekleştirerek T.a < 10 ve b koşulunu karşılayan satırları bulur.
Aşağıdaki illüstrasyon, partition skip scan işleminin mantıksal bir temsilidir.
T tablosunu, sütunlarda a ve b veri içererek gösterir. Bölümler, bölüm sınırları kesikli dikey çizgilerle gösterilen 1 ile 4 arasında numaralandırılır. Bölümlere yönelik birinci seviye arama işlemi (resimde gösterilmemiş), tablo için tanımlanan bölümlendirme ve a sütunundaki yüklemle (T.a < 10) ima edilen arama koşulunu 1, 2 ve 3 bölümlerinin karşıladığını belirler. İkinci seviye seek ile geçilen yol, eğri çizgi ile gösterilir. Temelde, işlem bu bölümlerin her birinde b = 2 koşulunu karşılayan satırları arar. İşlemin toplam maliyeti, üç ayrı indeks aramasınınkiyle aynıdır.
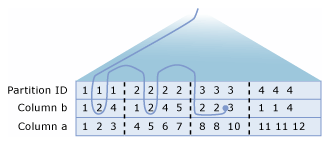
Sorgu yürütme planlarında bölümleme bilgilerini görüntüleme
T-SQL SET ifadeleri SET SHOWPLAN_XML veya SET STATISTICS XML, veya SSMS'deki grafiksel yürütme planı çıktısını kullanarak bölümlenmiş tablolar ve indeksler üzerindeki sorguların yürütme planlarını inceleyin. Örneğin, derleme zamanı yürütme planını Sorgu Düzenleyicisi araç çubuğunda Tahmini Yürütme Planını Göster seçerek ve çalışma zamanı planını Gerçek Yürütme Planını İçer seçerek gösterebilirsiniz.
Bu araçları kullanarak aşağıdaki bilgileri bulabilirsiniz:
- Bölümlenmiş tablolara veya indekslere erişen tarama, arama, ekleme, güncelleştirme, birleştirme ve silme gibi işlemler
- Sorgu tarafından erişilen bölümler. Örneğin, çalışma zamanı yürütme planları erişilen toplam bölümleme sayısını ve erişilen bitişik bölümleme aralıklarını içerir.
- Bir partisyon atlama tarama işlemi, bir arama veya tarama işleminde bir veya daha fazla partizyondan veri almak için kullanılır.
Bölüm bilgi geliştirmeleri
Database Engine, hem derleme zamanı hem de çalışma zamanı yürütme planları için geliştirilmiş bölümleme bilgisi sağlar. Yürütme planları artık aşağıdaki bilgileri sağlar:
- Arama, tarama, ekleme, güncelleştirme, birleştirme veya silme gibi bir operatörün bölümlenmiş bir tabloda gerçekleştirildiğini gösteren isteğe bağlı
Partitionedbir öznitelik. - Yeni bir
SeekPredicateNewöğesi,SeekKeysalt öğesi ile birliktePartitionIDönde gelen dizin anahtarı sütunu vePartitionIDüzerinde aralık aramaları belirten filtre koşullarını içerir. İkiSeekKeysalt öğesinin varlığı,PartitionIDüzerinde bir partition skip scan olduğunu gösterir. - Erişilen bölümlerin toplam sayısını sağlayan özet bilgiler. Bu bilgiler yalnızca çalışma zamanı planlarında kullanılabilir.
Bu bilgilerin hem grafik yürütme planı çıkışında hem de XML Showplan çıkışında nasıl görüntülendiğini göstermek için, bölümlenmiş tabloda fact_salesaşağıdaki sorguyu göz önünde bulundurun. Bu sorgu iki bölümdeki verileri güncelleştirir.
UPDATE fact_sales
    SET quantity = quantity - 2
WHERE date_id BETWEEN 20190802 AND 20190902;
Aşağıdaki çizimde, bu sorgu için Clustered Index Seek çalışma zamanı yürütme planındaki işlecin özellikleri gösterilmektedir. Tablonun fact_sales tanımını ve bölüm tanımını görmek için Örnek'e bakınız.
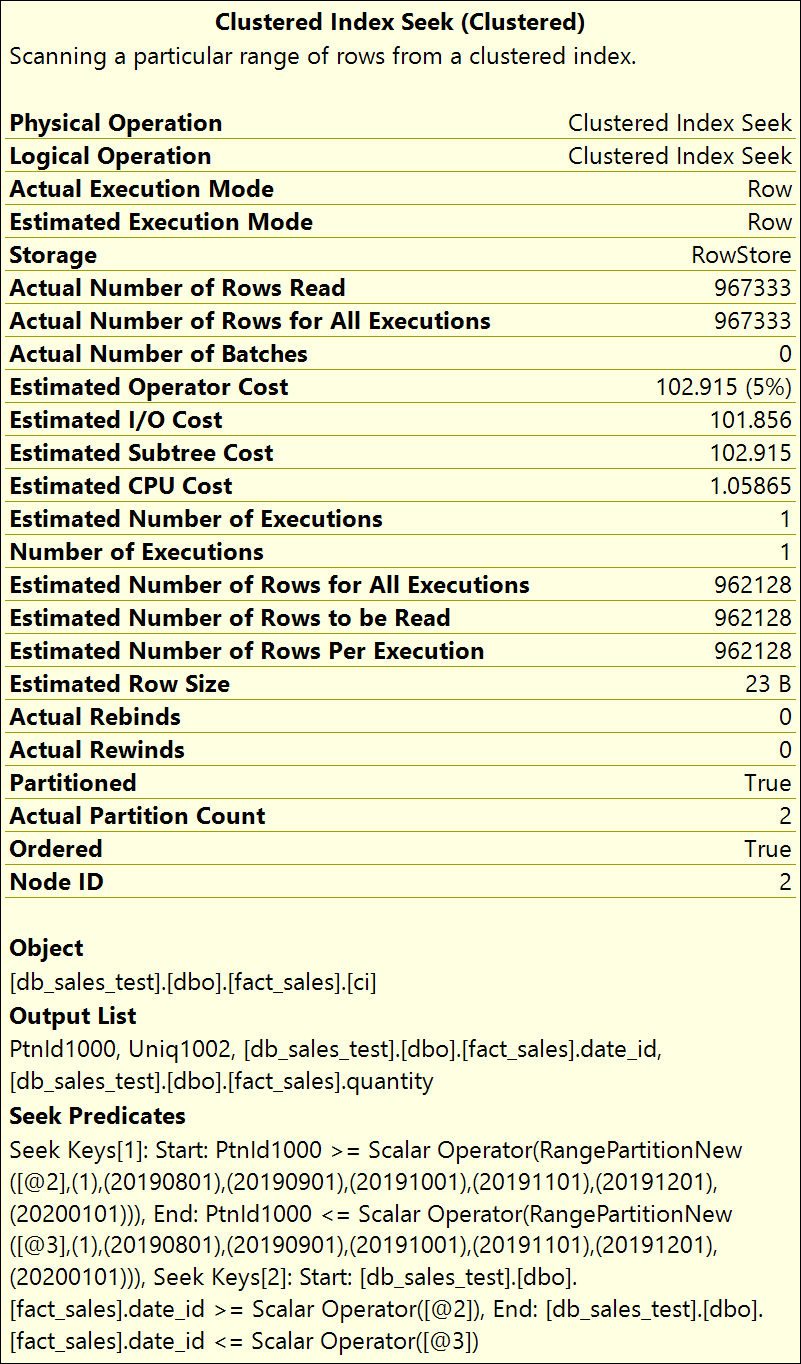
Bölümlenmiş öznitelik
Bölümlenmiş bir tablo veya dizinde bir işleç, Dizin Arama gibi, yürütüldüğünde, Partitioned öznitelik derleme zamanı ve çalışma zamanı planında görünür ve True (1) değeri olarak ayarlanır. Öznitelik, False (0) olarak ayarlandığında görüntülenmez.
Partitioned özniteliği aşağıdaki fiziksel ve mantıksal işleçlerde görünebilir:
- Tablo Tarama
- Dizin Taraması
- Dizin Arama
- Yerleştir
- Güncelleştir
- Sil
- Birleştir
Önceki resimde gösterildiği gibi, bu öznitelik, tanımlandığı operatörün özelliklerinde görünür. XML Showplan çıktısında, bu öznitelik, tanımlandığı operatörün RelOp düğümünde Partitioned="1" olarak görünür.
Yeni arama koşulu
XML Showplan çıktısında, eleman SeekPredicateNew tanımlandığı operatörde görünür.
SeekKeys alt öğesinden en fazla iki tane içerebilir. İlk SeekKeys öğe, mantıksal dizinin bölüm kimliği düzeyinde birinci düzey arama işlemini belirtir. Yani, bu seek işlemi, sorgu koşullarını karşılamak için erişilmesi gereken bölümleri belirler. İkinci SeekKeys öğe, birinci seviye aramada tanımlanan her bölümde gerçekleşen ikinci seviye aramayı belirtir.
Bölüm özeti bilgileri
Çalışma zamanı yürütme planlarında bölüm özeti bilgileri, erişilen bölümlerin sayısını ve erişilen gerçek bölümlerin kimliğini sağlar. Sorguda doğru bölümlere erişildiğini ve diğer tüm bölümlerin dikkate alınmadığını doğrulamak için bu bilgileri kullanabilirsiniz.
Aşağıdaki bilgiler sağlanır: Actual Partition Count, ve Partitions Accessed.
Actual Partition Count sorgu tarafından erişilen toplam bölüm sayısıdır.
Partitions Accessed, XML Showplan çıktısında, tanımlandığı operatörün RelOp düğümündeki yeni RuntimePartitionSummary elemanında görünen bölüm özeti bilgisidir. Aşağıdaki örnek, toplam iki bölüme (bölüm 2 ve 3) erişildiğini gösteren öğesinin içeriğini RuntimePartitionSummary gösterir.
<RunTimePartitionSummary>
    <PartitionsAccessed PartitionCount="2" >
        <PartitionRange Start="2" End="3" />
    </PartitionsAccessed>
</RunTimePartitionSummary>
Bölümleme bilgisini diğer showplan yöntemlerini kullanarak görüntüleyin
Showplan yöntemleri SHOWPLAN_ALL, SHOWPLAN_TEXTve STATISTICS PROFILE aşağıdaki özel durumla birlikte bu makalede açıklanan bölüm bilgilerini raporlamaz. Koşulun SEEK bir parçası olarak, erişilecek bölümler bölüm kimliğini temsil eden hesaplanan sütundaki bir aralık koşulu tarafından tanımlanır. Aşağıdaki örnek, bir SEEK işleci için Clustered Index Seek predikatı göstermektedir. Bölüm 2 ve Bölüm 3'e erişim sağlanır, ve arama operatörü date_id BETWEEN 20190802 AND 20190902 koşulunu karşılayan satırları filtreler.
|--Clustered Index Seek(OBJECT:([db_sales_test].[dbo].[fact_sales].[ci]),
        SEEK:([PtnId1000] >= (2) AND [PtnId1000] <= (3)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] >= (20190802)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] <= (20190902))
                ORDERED FORWARD)
Bölümlenmiş yığınlar için yürütme planlarını yorumlama
Bölümlenmiş yığın, bölüm kimliğinde mantıksal dizin olarak kabul edilir. Bir yürütme planında, bölümlenmiş bir yığındaki bölüm elemesi, bölüm kimliği üzerinde bir SEEK yüklemi olan bir Table Scan operatörü olarak temsil edilir. Aşağıdaki örnekte sağlanan Showplan bilgileri gösterilmektedir:
|-- Table Scan (OBJECT: ([db].[dbo].[T]), SEEK: ([PtnId1001]=[Expr1011]) ORDERED FORWARD)
Birlikte bulunan birleşimler için yürütme planlarını yorumlama
Birleştirmede konumlandırma, iki tablo aynı veya eşdeğer bölümleme işlevi kullanılarak bölümlendiğinde ve birleştirmenin her iki tarafındaki bölümleme sütunları sorgunun birleştirme koşulunda belirtildiğinde oluşabilir. Sorgu İyileştiricisi, eşit bölüm kimliklerine sahip her tablonun bölümlerinin ayrı olarak birleştirildiği bir plan oluşturabilir. Birlikte bulunan birleşimler, daha az bellek ve işlem süresi gerektirebileceğinden, birlikte konumlandırılmamış birleşimlerden daha hızlı olabilir. Sorgu Düzenleyicisi, maliyet hesaplamasına göre çakışmayan bir plan veya çakışan bir plan seçer.
Eşleşmiş bir planda, Nested Loops iç tarafındaki bir veya daha fazla birleştirilmiş tablo veya dizin bölümünü okur. İşleçler içindeki Constant Scan sayılar bölüm numaralarını temsil eden sayılardır.
Bölümlenmiş tablolar veya dizinler için birlikte görünen birleşimler için paralel planlar oluşturulduğunda, Constant Scan ve Nested Loops birleştirme işleçleri arasında bir Paralellik işleci görünür. Bu durumda, birleştirmenin dış kısmındaki her bir çalışan iş parçacığı, farklı bir bölümü okur ve üzerinde çalışır.
Aşağıdaki çizimde, eş konumlu birleştirme için paralel sorgu planı gösterilmektedir.
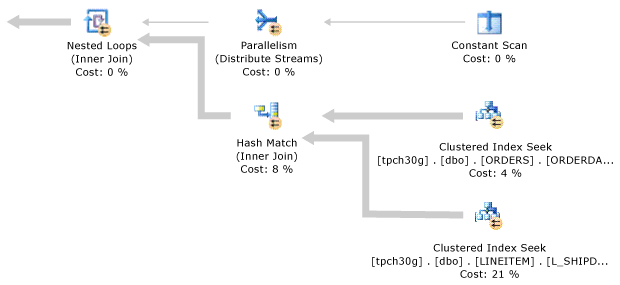
Bölümlenmiş nesneler için paralel sorgu yürütme stratejisi
Sorgu işlemcisi, bölümlenmiş nesnelerden seçim yapılan sorgular için paralel yürütme stratejisi kullanır. Yürütme stratejisinin bir parçası olarak, sorgu işlemcisi sorgu için gereken tablo bölümlerini ve her bölüme ayrılacak çalışan iş parçacıklarının oranını belirler. Çoğu durumda, sorgu işlemcisi her bölüme eşit veya neredeyse eşit sayıda çalışan iş parçacığı ayırır ve ardından sorguyu bölümler arasında paralel olarak yürütür. Aşağıdaki paragraflarda çalışan iş parçacığı ayırma işlemi daha ayrıntılı açıklanmaktadır.
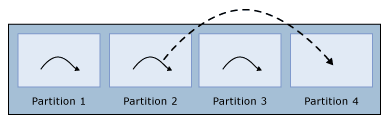
Çalışan iş parçacığı sayısı bölüm sayısından azsa, sorgu işlemcisi her çalışan iş parçacığını farklı bir bölüme atar ve başlangıçta atanmış bir çalışan iş parçacığı olmadan bir veya daha fazla bölüm bırakır. Bir işçi iş parçacığı bir bölümde yürütmesini tamamladığında, sorgu işlemcisi onu bir sonraki bölüme atar, ta ki her bölüme tek bir işçi iş parçacığı atanana kadar. Bu atama, sorgu işlemcisinin işçi iş parçacıklarını diğer bölümlere yeniden tahsis ettiği tek durumdur.
Bir iş parçacığını tamamladıktan sonra yeniden atanan çalışan ipliği gösterir. Çalışan iş parçacığı sayısı bölüm sayısına eşitse, sorgu işlemcisi her bölüme bir çalışan iş parçacığı atar. Bir çalışan iş parçacığı tamamlandığında, başka bir bölüme yeniden ayrılmaz.
Çalışan iş parçacığı sayısı bölüm sayısından büyükse, sorgu işlemcisi her bölüme eşit sayıda çalışan iş parçacığı ayırır. Eğer işçi iş parçacığı sayısı bölüm sayısının tam katı değilse, sorgu işlemcisi tüm mevcut işçi iş parçacıklarını kullanmak için bazı bölümlere fazladan bir işçi iş parçacığı ayırır. Sadece bir partition varsa, tüm işçi iş parçacıkları o partition’a atanır. Aşağıdaki diyagramda dört bölümleme ve 14 çalışan iş parçacığı vardır. Her bölüme üç çalışan iş parçacığı atanmış ve iki bölümde ekstra bir çalışan iş parçacığı bulunur; toplamda 14 çalışan iş parçacığı ataması vardır. Bir çalışan iş parçacığı tamamlandığında, başka bir bölüme yeniden atanmaz.
Önceki örnekler çalışan iş parçacıklarını tahsis etmenin doğrudan bir yolunu önerse de, gerçek strateji daha karmaşıktır ve sorgu yürütme sırasında ortaya çıkan diğer değişkenleri de hesaba katmaktadır. Örneğin, tablo bölümlendirilmişse ve sütunda A kümelenmiş bir dizin varsa ve bir sorguda WHERE A IN (13, 17, 25) yüklem koşulu varsa, sorgu işlemcisi tablo bölümlerinin her biri yerine bu üç arama değerinin (A = 13, A = 17 ve A = 25) her birine bir veya daha fazla iş parçacığı tahsis eder. Sorguyu yalnızca bu değerleri içeren bölümlerde çalıştırmak yeterlidir ve eğer tüm bu arama predikatları aynı tablo bölümünde olursa, tüm işçi iş parçacıkları aynı tablo bölümüne atanır.
Başka bir örnek vermek gerekirse, tablonun A sütununda sınır noktaları (10, 20, 30) olan dört bölümü, B sütununda bir dizini olduğunu ve sorgunun WHERE B IN (50, 100, 150) yüklem koşuluna sahip olduğunu varsayalım. Tablo bölümleri A değerlerine dayandığı için, B değerleri herhangi bir tablo bölümünde bulunabilir. Bu nedenle, sorgu işlemcisi, dört tablo bölümünün her birinde, (50, 100, 150) olmak üzere B öğesinin üç değerinin her birini arar. Sorgu işlemcisi, bu 12 sorgu taramasının her birini paralel olarak çalıştırabilmek için işçi iş parçacıklarını orantılı olarak atar.
Sütuna dayalı tablo bölümleri A |
Her tablo bölümünde B sütununu arar |
|---|---|
Tablo Bölümü 1: A < 10 |
B = 50, B = 100, B = 150 |
Tablo Bölüm 2: A >= 10 AND A < 20 |
B = 50, B = 100, B = 150 |
Tablo Bölümleme 3: A >= 20 AND A < 30 |
B = 50, B = 100, B = 150 |
Tablo Bölümleme 4: A >= 30 |
B = 50, B = 100, B = 150 |
En iyi yöntemler
Büyük bölümlenmiş tablolar ve indekslerden büyük miktarda veriye erişen sorguların performansını artırmak için şu en iyi uygulamaları takip edin:
Her bölümü birçok disk arasında şeritleme. Bu yaklaşım özellikle dönen diskler kullanılırken önemlidir.
Mümkün olduğunda, G/Ç maliyetini azaltmak için sık erişilen bölümleri veya tüm bölümleri belleğe sığdırmak için yeterli ana belleğe sahip bir sunucu kullanın.
Sorguladığınız veri belleğe sığmazsa, I/O maliyetini azaltmak için tabloları ve indeksleri sıkıştırın.
Paralel sorgu işleme özelliğinden yararlanmak için hızlı işlemcilere ve mümkün olduğunca çok işlemci çekirdeğine sahip bir sunucu kullanın.
Sunucunun yeterli G/Ç denetleyicisi bant genişliğine sahip olduğundan emin olun.
B ağacı tarama iyileştirmelerinden yararlanmak için her büyük bölümlenmiş tabloda kümelenmiş dizin oluşturun.
Verileri toplu olarak bölümlenmiş tablolara yüklerken, The Data Loading Performance Guide başlıklı teknik inceleme belgesindeki en iyi uygulama önerilerini takip edin.
Örnek
Aşağıdaki örnek, yedi bölüm içeren tek bir tablo içeren bir test veritabanı oluşturur. Hem derleme zamanı hem de çalışma zamanı planları için bölümleme bilgilerini görüntülemek için, bu örnekte sorguları çalıştırırken Sorgu yürütme planlarında bölümleme bilgisini göster bölümünde tanımlanan araçları kullanın.
Uyarı
Bu örnek tabloya 1 milyondan fazla satır ekler. Bu örneği çalıştırmak, donanımınıza bağlı olarak birkaç dakika sürebilir. Bu örneği yürütmeden önce 1,5 GB'tan fazla disk alanınız olduğunu doğrulayın.
USE master;
GO

IF DB_ID(N'db_sales_test') IS NOT NULL
    DROP DATABASE db_sales_test;
GO

CREATE DATABASE db_sales_test;
GO

USE db_sales_test;
GO

CREATE PARTITION FUNCTION pf_range_fact(INT)
    AS RANGE RIGHT
    FOR VALUES (20190801, 20190901, 20191001, 20191101, 20191201, 20200101);
GO

CREATE PARTITION SCHEME ps_fact_sales
    AS PARTITION pf_range_fact
    ALL TO ([PRIMARY]);
GO

CREATE TABLE fact_sales
(
    date_id INT,
    product_id INT,
    store_id INT,
    quantity INT,
    unit_price NUMERIC (7, 2),
    other_data CHAR (1000)
) ON ps_fact_sales (date_id);
GO

CREATE CLUSTERED INDEX ci
    ON fact_sales(date_id);
GO

PRINT 'Loading...';

SET NOCOUNT ON;

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 1000000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190800 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END
GO

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 10000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190900 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END

PRINT 'Done.';
GO

-- Two-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190802 AND 20190902
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO

-- Single-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190801 AND 20190831
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO
İlgili içerik
- Mantıksal ve Fiziksel Showplan İşleç Referansı
- Genişletilmiş olaylara genel bakış
- Sorgu Deposu ile iş yüklerini izlemeye yönelik en iyi yöntemler
- Kardinalite Tahmini (SQL Server)
- SQL veritabanlarında akıllı sorgu işleme
- İşleç önceliği (Transact-SQL)
- Yürütme planına genel bakış
- SQL Server Veritabanı Altyapısı ve Azure SQL Veritabanı için Performans Merkezi