Not
Bu sayfaya erişim yetkilendirme gerektiriyor. Oturum açmayı veya dizinleri değiştirmeyi deneyebilirsiniz.
Bu sayfaya erişim yetkilendirme gerektiriyor. Dizinleri değiştirmeyi deneyebilirsiniz.
Bu öğreticinin önceki aşamasında PyTorch ile veri analizi modelimizi eğitmek için kullanacağımız veri kümesini edindik. Şimdi bu verileri kullanmaya koymanın zamanı geldi.
PyTorch ile veri analizi modelini eğitmek için aşağıdaki adımları tamamlamanız gerekir:
- Verileri yükleyin. Bu öğreticinin önceki adımını yaptıysanız, bunu zaten hallettiniz.
- Bir sinir ağı tanımlayın.
- Bir kayıp işlevi tanımlayın.
- Modeli eğitim verileri üzerinde eğitin.
- Ağı test verilerinde test edin.
Sinir ağı tanımlama
Bu öğreticide, üç doğrusal katmanla temel bir sinir ağı modeli oluşturacaksınız. Modelin yapısı aşağıdaki gibidir:
Linear -> ReLU -> Linear -> ReLU -> Linear
Doğrusal katman, gelen verilere doğrusal bir dönüşüm uygular. Giriş özelliklerinin sayısını ve sınıf sayısına karşılık gelen çıkış özelliklerinin sayısını belirtmeniz gerekir.
ReLU katmanı, tüm gelen özellikleri 0 veya daha büyük olacak şekilde tanımlayan bir etkinleştirme işlevidir. Bu nedenle, ReLU katmanı uygulandığında, 0'dan küçük herhangi bir sayı sıfır olarak değiştirilirken, diğerleri aynı tutulur. Etkinleştirme katmanını iki gizli katmana uygulayacağız ve son doğrusal katmanda etkinleştirme olmayacak.
Model parametreleri
Model parametreleri hedefimize ve eğitim verilerine bağlıdır. Giriş boyutu, modeli beslediğimiz özelliklerin sayısına (bizim durumumuzda dört) bağlıdır. Üç olası Iris türü olduğundan çıkış boyutu üç'tür.
Üç doğrusal katmana (4,24) -> (24,24) -> (24,3)sahip olan ağ, 744 ağırlığa (96+576+72) sahip olacaktır.
Öğrenme hızı (lr), ağımızın ağırlıklarını kayıp gradyanıyla ilgili olarak ne kadar ayarlayabileceğinizi denetler. Ne kadar düşük olursa, eğitim o kadar yavaş olur. Bu öğreticide lr değerini 0,01 olarak ayarlayacaksınız.
Ağ nasıl çalışır?
Burada bir ileri akış ağı oluşturuyoruz. Eğitim süreci sırasında ağ, girdiyi tüm katmanlar boyunca işler, görüntünün tahmin edilen etiketinin doğru etiketten ne kadar saptığını anlamak için kaybı hesaplar ve katmanların ağırlıklarını güncellemek üzere gradyanları ağa geri yayar. Büyük bir giriş veri kümesi üzerinde yineleme yaparak ağ, en iyi sonuçları elde etmek için ağırlıklarını ayarlamayı "öğrenir".
İleriye doğru işlevi kayıp işlevinin değerini hesaplar ve geriye dönük bir işlev, öğrenilebilir parametrelerin gradyanlarını hesaplar. Sinir ağımızı PyTorch ile oluşturduğunuzda yalnızca forward işlevini tanımlamanız gerekir. Geriye dönük işlev otomatik olarak tanımlanır.
- Model parametrelerini ve sinir ağını
DataClassifier.pytanımlamak için Visual Studio'daki dosyaya aşağıdaki kodu kopyalayın.
# Define model parameters
input_size = list(input.shape)[1]   # = 4. The input depends on how many features we initially feed the model. In our case, there are 4 features for every predict value
learning_rate = 0.01
output_size = len(labels)           # The output is prediction results for three types of Irises.


# Define neural network
class Network(nn.Module):
   def __init__(self, input_size, output_size):
       super(Network, self).__init__()

       self.layer1 = nn.Linear(input_size, 24)
       self.layer2 = nn.Linear(24, 24)
       self.layer3 = nn.Linear(24, output_size)


   def forward(self, x):
       x1 = F.relu(self.layer1(x))
       x2 = F.relu(self.layer2(x1))
       x3 = self.layer3(x2)
       return x3

# Instantiate the model
model = Network(input_size, output_size)
Ayrıca bilgisayarınızda bulunan yürütme cihazını da tanımlamanız gerekir. PyTorch'un GPU için ayrılmış bir kitaplığı yoktur, ancak yürütme cihazını el ile tanımlayabilirsiniz. Makinenizde varsa cihaz bir Nvidia GPU veya yoksa CPU'nuz olacaktır.
- Yürütme cihazını tanımlamak için aşağıdaki kodu kopyalayın:
# Define your execution device
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
print("The model will be running on", device, "device\n")
model.to(device)    # Convert model parameters and buffers to CPU or Cuda
- Son adım olarak, modeli kaydetmek için bir işlev tanımlayın:
# Function to save the model
def saveModel():
    path = "./NetModel.pth"
    torch.save(model.state_dict(), path)
Uyarı
PyTorch ile sinir ağı hakkında daha fazla bilgi edinmek istiyor musunuz? PyTorch belgelerine göz atın.
Bir kayıp fonksiyonu tanımlayın
Kayıp işlevi, çıkışın hedeften ne kadar uzakta olduğunu tahmin eden bir değer hesaplar. Temel amaç, sinir ağlarında geri yayılım yoluyla ağırlık vektörü değerlerini değiştirerek kayıp fonksiyonunun değerini azaltmaktır.
Kayıp değeri model doğruluğundan farklıdır. Kayıp işlevi, eğitim kümesindeki her iyileştirme yinelemesinin ardından modelimizin ne kadar iyi davrandığını temsil eder. Modelin doğruluğu test verilerinde hesaplanır ve doğru tahminlerin yüzdesini gösterir.
PyTorch'ta sinir ağı paketi, derin sinir ağlarının yapı taşları oluşturan çeşitli kayıp işlevleri içerir. Bu özelliklerden daha fazla bilgi edinmek istiyorsanız yukarıdaki notu kullanmaya başlayın. Burada, bunun gibi sınıflandırma için en iyi duruma getirilmiş mevcut işlevleri ve sınıflandırma çapraz entropi kaybı işlevini ve Adem iyileştiricisini kullanacağız. İyileştiricide, öğrenme oranı (lr), kayıp gradyanına göre ağımızın ağırlıklarını nasıl ayarladığınızı kontrol eder. Burada 0,001 olarak ayarlayacaksınız; ne kadar düşükse, eğitim o kadar yavaş olacaktır.
- Kayıp işlevini ve iyileştiriciyi
DataClassifier.pytanımlamak için aşağıdaki kodu Visual Studio'daki dosyaya kopyalayın.
# Define the loss function with Classification Cross-Entropy loss and an optimizer with Adam optimizer
loss_fn = nn.CrossEntropyLoss()
optimizer = Adam(model.parameters(), lr=0.001, weight_decay=0.0001)
Modeli eğitim verileri üzerinde eğitin.
Modeli eğitmek için veri yineleyicimiz üzerinde döngü oluşturmanız, girişleri ağa beslemeniz ve iyileştirmeniz gerekir. Sonuçları doğrulamak için, her eğitim döneminin ardından tahmin edilen etiketleri doğrulama veri kümesindeki gerçek etiketlerle karşılaştırmanız yeterlidir.
Program, her dönem için veya eğitim kümesi üzerindeki her tam yineleme için eğitim kaybını, doğrulama kaybını ve modelin doğruluğunu görüntüler. Modeli en yüksek doğrulukla kaydeder ve 10 dönem sonra program son doğruluğu görüntüler.
- Dosyaya aşağıdaki kodu
DataClassifier.pyekleyin
# Training Function
def train(num_epochs):
    best_accuracy = 0.0

    print("Begin training...")
    for epoch in range(1, num_epochs+1):
        running_train_loss = 0.0
        running_accuracy = 0.0
        running_vall_loss = 0.0
        total = 0

        # Training Loop
        for data in train_loader:
        #for data in enumerate(train_loader, 0):
            inputs, outputs = data  # get the input and real species as outputs; data is a list of [inputs, outputs]
            optimizer.zero_grad()   # zero the parameter gradients
            predicted_outputs = model(inputs)   # predict output from the model
            train_loss = loss_fn(predicted_outputs, outputs)   # calculate loss for the predicted output
            train_loss.backward()   # backpropagate the loss
            optimizer.step()        # adjust parameters based on the calculated gradients
            running_train_loss +=train_loss.item()  # track the loss value

        # Calculate training loss value
        train_loss_value = running_train_loss/len(train_loader)

        # Validation Loop
        with torch.no_grad():
            model.eval()
            for data in validate_loader:
               inputs, outputs = data
               predicted_outputs = model(inputs)
               val_loss = loss_fn(predicted_outputs, outputs)

               # The label with the highest value will be our prediction
               _, predicted = torch.max(predicted_outputs, 1)
               running_vall_loss += val_loss.item()
               total += outputs.size(0)
               running_accuracy += (predicted == outputs).sum().item()

        # Calculate validation loss value
        val_loss_value = running_vall_loss/len(validate_loader)

        # Calculate accuracy as the number of correct predictions in the validation batch divided by the total number of predictions done.
        accuracy = (100 * running_accuracy / total)

        # Save the model if the accuracy is the best
        if accuracy > best_accuracy:
            saveModel()
            best_accuracy = accuracy

        # Print the statistics of the epoch
        print('Completed training batch', epoch, 'Training Loss is: %.4f' %train_loss_value, 'Validation Loss is: %.4f' %val_loss_value, 'Accuracy is %d %%' % (accuracy))
Test verilerinde modeli test edin.
Modeli eğitdiğimize göre modeli test veri kümesiyle test edebiliriz.
İki test işlevi ekleyeceğiz. İlki, önceki bölümde kaydettiğiniz modeli sınar. 45 öğeden oluşan test veri kümesiyle modeli test eder ve modelin doğruluğunu yazdırır. İkincisi, modelin her bir türün başarılı sınıflandırma olasılığıyla temsil edilen üç iris türünün her birini tahmin etme güvenini test etmek için isteğe bağlı bir işlevdir.
-
DataClassifier.pydosyasına aşağıdaki kodu ekleyin.
# Function to test the model
def test():
    # Load the model that we saved at the end of the training loop
    model = Network(input_size, output_size)
    path = "NetModel.pth"
    model.load_state_dict(torch.load(path))

    running_accuracy = 0
    total = 0

    with torch.no_grad():
        for data in test_loader:
            inputs, outputs = data
            outputs = outputs.to(torch.float32)
            predicted_outputs = model(inputs)
            _, predicted = torch.max(predicted_outputs, 1)
            total += outputs.size(0)
            running_accuracy += (predicted == outputs).sum().item()

        print('Accuracy of the model based on the test set of', test_split ,'inputs is: %d %%' % (100 * running_accuracy / total))


# Optional: Function to test which species were easier to predict
def test_species():
    # Load the model that we saved at the end of the training loop
    model = Network(input_size, output_size)
    path = "NetModel.pth"
    model.load_state_dict(torch.load(path))

    labels_length = len(labels) # how many labels of Irises we have. = 3 in our database.
    labels_correct = list(0. for i in range(labels_length)) # list to calculate correct labels [how many correct setosa, how many correct versicolor, how many correct virginica]
    labels_total = list(0. for i in range(labels_length))   # list to keep the total # of labels per type [total setosa, total versicolor, total virginica]

    with torch.no_grad():
        for data in test_loader:
            inputs, outputs = data
            predicted_outputs = model(inputs)
            _, predicted = torch.max(predicted_outputs, 1)

            label_correct_running = (predicted == outputs).squeeze()
            label = outputs[0]
            if label_correct_running.item():
                labels_correct[label] += 1
            labels_total[label] += 1

    label_list = list(labels.keys())
    for i in range(output_size):
        print('Accuracy to predict %5s : %2d %%' % (label_list[i], 100 * labels_correct[i] / labels_total[i]))
Son olarak ana kodu ekleyelim. Bu işlem model eğitimini başlatır, modeli kaydeder ve sonuçları ekranda görüntüler. Eğitim kümesi üzerinde yalnızca iki yineleme [num_epochs = 25] çalıştıracağız, bu nedenle eğitim süreci çok uzun sürmez.
-
DataClassifier.pydosyasına aşağıdaki kodu ekleyin.
if __name__ == "__main__":
    num_epochs = 10
    train(num_epochs)
    print('Finished Training\n')
    test()
    test_species()
Testi yapalım! Üst araç çubuğundaki açılan menülerin Debug olarak ayarlandığından emin olun. Solution Platform'yi x64 olarak değiştirin ve cihazınız 64 bitse yerel makinenizde projeyi çalıştırın, veya Solution Platform'yi olarak değiştirin, eğer cihazınız 32 bitse.
- Projeyi çalıştırmak için araç çubuğundaki
Start Debuggingdüğmeye tıklayın veya tuşuna basınF5.
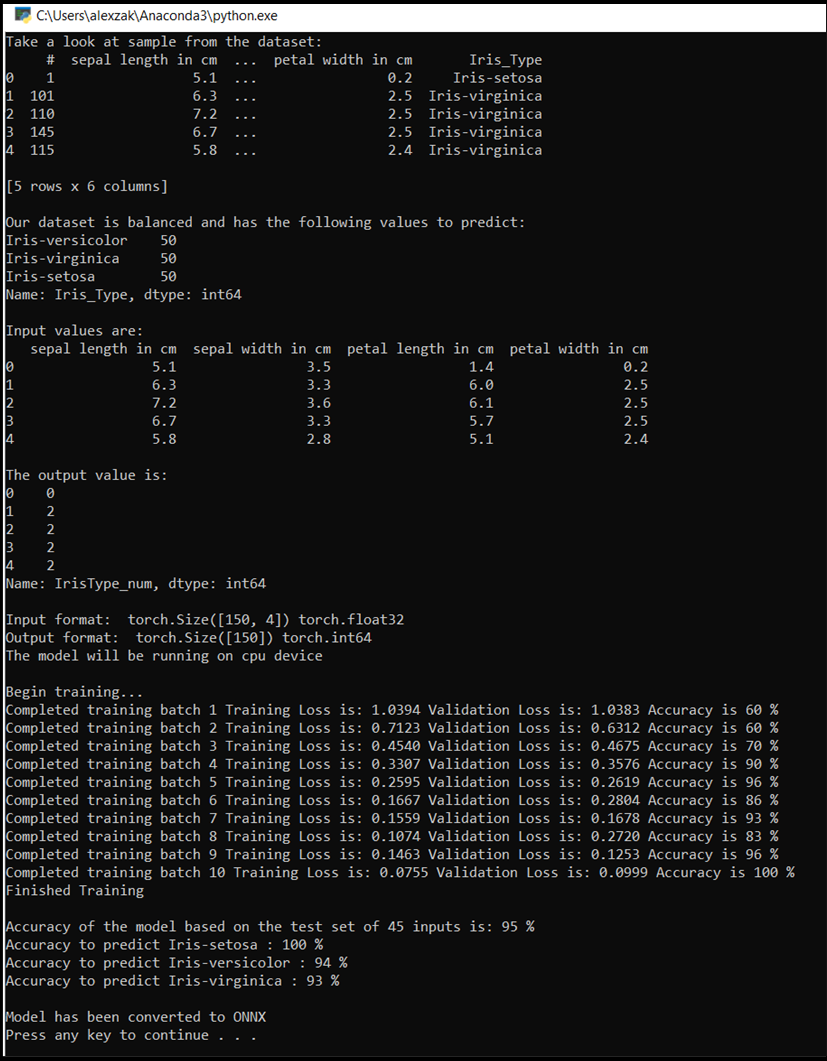
Konsol penceresi açılır ve eğitim sürecini görürsünüz. Tanımladığınız gibi, kayıp değeri her dönem boyunca yazdırılacak. Beklenti, her döngüde kayıp değerinin düşmesidir.
Eğitim tamamlandıktan sonra aşağıdakine benzer bir çıktı görmeniz gerekir. Sayılarınız tam olarak aynı olmayacaktır; eğitim birçok faktöre bağlıdır ve her zaman resmi sonuçlar döndürmez; ancak benzer görünmelidir.
Sonraki Adımlar
Artık bir sınıflandırma modelimiz olduğuna göre, sonraki adım modeli ONNX biçimine dönüştürmektir.