GPU 分析曲線圖顯示哪些函式佔用最多 GPU 記憶體。 本文說明如何解讀 Azure Kubernetes Service (AKS) GPU 效能分析工具所產生的火焰圖。
Important
AKS 預覽功能以自助方式提供,並採選擇加入制。 預覽版本係依「現狀」及「可用情況」提供,且不適用於服務等級協定與有限保固。 客戶支援部門會盡最大努力,部分支援 AKS 預覽。 因此,這些功能不適合實際執行用途。 如需詳細資訊,請參閱下列支援文章:
開始之前,請先設定 GPU 剖析,並確認可在 Pyroscope 和 Grafana 中取得剖析資料。
Note
第一次剖析執行可能無法顯示所有符號,包括啟動操作(如模型載入)的符號,而剖析器則分析工作負載並解析符號。 在初步分析後再次執行工作負載,以在後續的配置檔中捕捉這些符號。
了解火焰圖
火焰圖會以視覺化方式呈現經過效能剖析的呼叫堆疊。 每條條代表一個函式,堆疊條顯示呼叫鏈,也就是哪個函式呼叫另一個函式。 每個長條的寬度代表流經該函式的所測量資源量,例如 CPU 時間或配置的 GPU 記憶體。
關鍵規則:長條越寬,流經該功能的所測量資源就越多。
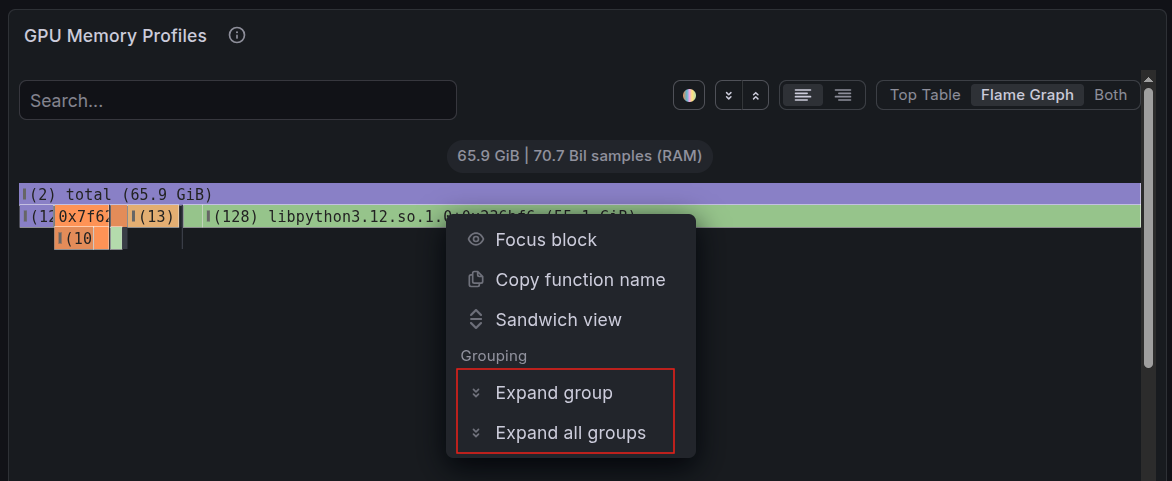
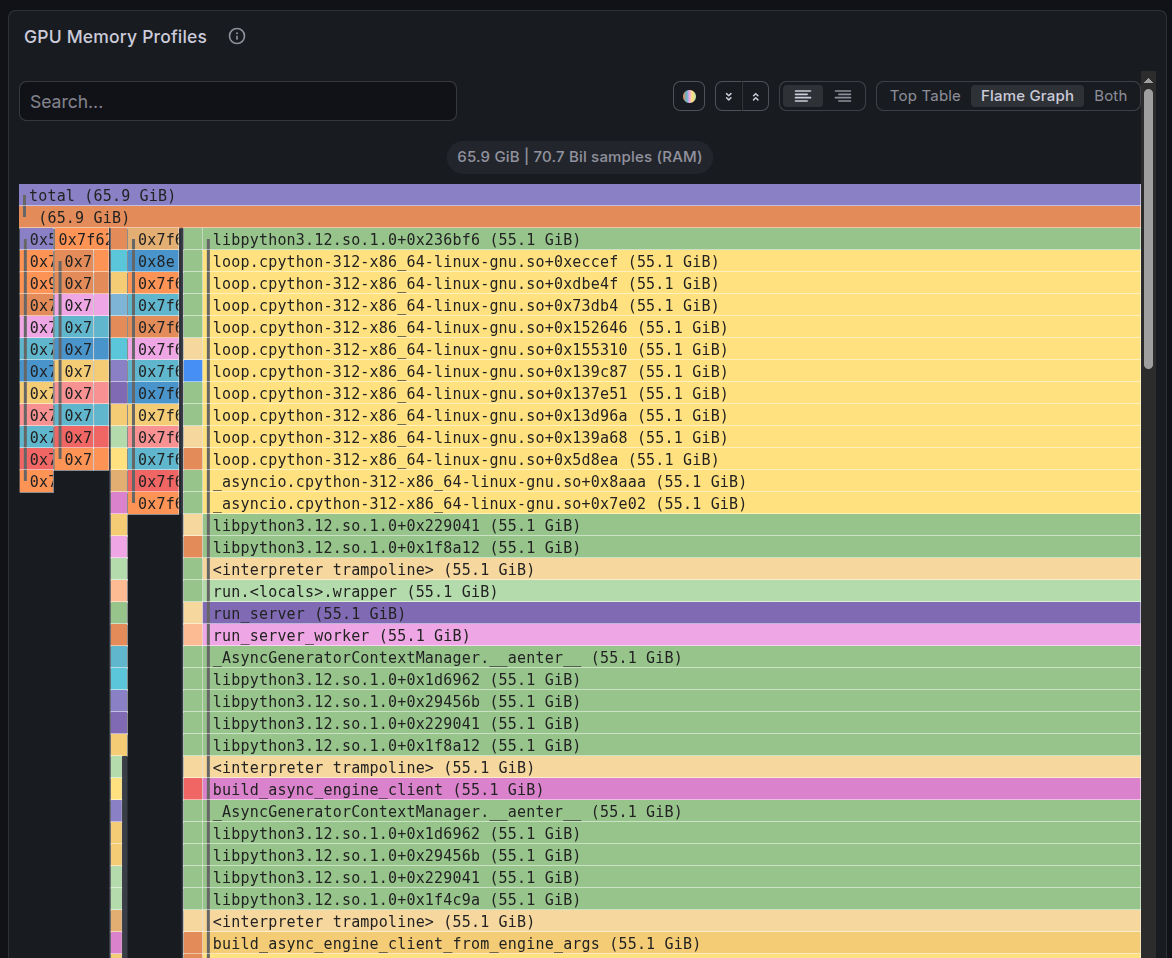
以下範例火焰圖取自 vLLM 推論工作負載。
Tip
使用 Grafana 火焰圖面板中的展開所有群組,即可查看未摺疊的完整呼叫堆疊。 使用 搜尋 框來尋找特定功能或關鍵字。 為了防止面板再次崩塌,請在 Grafana 儀表板右上角將刷新間隔設為 關閉 ,暫停儀表板自動刷新,同時檢查展開的火焰圖。
Tip
使用 焦點方塊 來專注於特定的分配路徑。
讀符號
火焰圖標籤遵循以下慣例:
| 符號格式 | Meaning |
|---|---|
Foo > bar |
class Foo: method def bar() |
Foo > __init__ |
類別 Foo 的建構子 |
bar (獨處) |
獨立式 def bar() 功能 |
<interpreter trampoline> |
CPython 的額外負荷。 你可以忽略這個符號。 |
<raw-address>,例如 0x7f151 |
原生 C 或 CUDA 程式碼,沒有 Python 符號可用。 |
範例包括:
-
GPUModelRunner/_allocate_kv_cache_tensors:類別上的方法。 將此符號讀作class GPUModelRunner: def _allocate_kv_cache_tensors(self)。 -
LlamaMLP/__init__: 一個在建立LlamaMLP(...)物件時所呼叫的建構子。 -
_compile_fx_inner:一個獨立的模組層函式,不在類別中。
了解自我與總分配的關係
利用 Self 和 Total 值來判斷資源的消耗範圍:
- 總資源 是函式及其呼叫所消耗的資源。 函式可以有很大的總數,但因為屬於呼叫鏈的一部分,自己卻什麼都不分配。
- Self 是函數直接消耗的資源,排除其子函數。 高自我價值表示這個功能是資源被消耗的地方。
例如,若 GPUModelRunner._allocate_kv_cache_tensors 的自身配置量為 55.1 GB,則它就是呼叫 torch.empty() 來建立鍵值(KV)快取張量的函式。
請使用以下導航技巧:
- 先從葉節點開始,葉節點是上方沒有東西的條狀結構。 其整體寬度代表自身配置。
- 當您搜尋配置的來源時,請略過沒有自身配置的寬長條。 這些函式會統籌對其他函式的呼叫。
- 將具有高自身配置的寬長條視為潛在的最佳化目標進行調查。
尋找最大的資源消費者
請依照以下步驟辨識熱點:
看看圖表頂端最寬的條紋。 這些葉函式負責配置記憶體。 長條越寬,取用的記憶體就越多。
檢查自身配置與總計配置。 底部帶有
self: 0的寬列是呼叫鏈的一部分。 沿著它往上走,直到找到一個自我分配率很高的列。從下到上閱讀呼叫堆疊,了解為什麼這個函式會被呼叫。 以下範例以執行分配的函數作結:
<raw-address>, for example, 0x7f151       -> native code entry
<interpreter trampoline>                 -> CPython dispatch
<module>                                 -> script top level
EngineCoreProc.run_engine_core           -> vLLM engine startup
EngineCore.__init__                      -> engine initialization
EngineCore._initialize_kv_caches         -> KV cache setup
Worker.initialize_from_config            -> worker setup
GPUModelRunner.initialize_kv_cache       -> model runner
GPUModelRunner._allocate_kv_cache_tensors -> actual allocation
請參考以下表格作為快速參考:
| Goal | 應該注意哪些事項 |
|---|---|
| 找出占用最多記憶體的項目 | 最寬的葉條位於堆疊頂端 |
| 找出負責最多記憶的因素 | 最寬的長條位於堆疊底部 |
| 識別優化目標 | 具有寬廣自身配置的長條 |
| 找出可以跳過的功能 | 自身配置為零的寬長條 |