Azure
藉由以透明方式重試失敗的作業,讓應用程式在嘗試連線到服務或網路資源時處理暫時性失敗。 這可以改善應用程式的穩定性。
內容和問題
應用程式若要與在雲端中執行的元素通訊,必須能感應在此環境中發生的暫時性錯誤。 錯誤包括暫時遺失對元件和服務的網路連線、暫時無法使用服務,或服務忙碌時發生的逾時。
這些錯誤通常是自我更正,而且如果觸發錯誤的動作在適當延遲之後重複,可能會成功。 例如,處理大量並行要求的資料庫服務可以實 作節流策略 ,以暫時拒絕任何進一步的要求,直到工作負載放寬為止。 嘗試存取資料庫的應用程式可能無法連線,但如果應用程式在延遲之後再次嘗試,可能會成功。
解決方案
在雲端中,應該預期暫時性錯誤,且應用程式應設計為以簡潔且透明的方式處理它們。 這麼做可將錯誤對應用程式執行之商務工作的影響降到最低。 最常見的設計模式是引進重試機制。
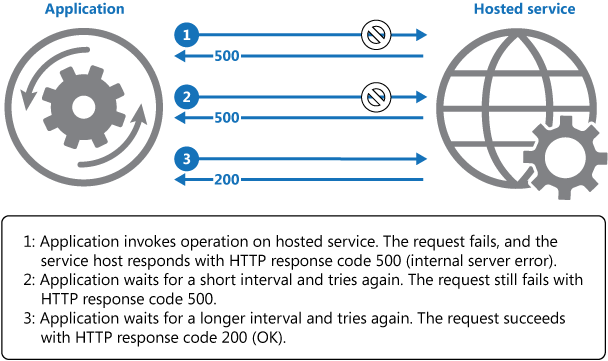
上圖說明使用重試機制叫用託管服務中的作業。 如果要求在預先定義的嘗試次數之後失敗,應用程式應該將錯誤視為例外狀況並據以處理。
注意
由於暫時性錯誤的常見本質,許多用戶端連結庫和雲端服務現在都提供內建重試機制,對於重試次數上限、重試之間的延遲和其他參數,具有某種程度的可設定性。 例如,Entity Framework Core提供重試失敗資料庫操作的功能。
重試策略
如果應用程式嘗試將要求傳送至遠端服務時偵測到失敗,則可以使用下列策略來處理失敗:
取消。 如果錯誤顯示失敗不是暫時性的,或者即使重試也不太可能成功,應用程式應該取消作業並引發例外。
立即重試。 如果報告的特定故障異常或罕見,例如網路封包在傳輸過程中損壞,最佳做法可能是立即重試該請求。
延遲後重試。 如果錯誤是由其中一個較常見的連線或繁忙故障所造成,網路或服務可能需要一小段時間,當連線問題得到解決或積壓工作被清除時,程式上延遲重試是不錯的策略。 在許多情況下,重試之間的間隔應選擇為能夠盡可能均勻地分散來自應用程式多個實例的請求,以降低繁忙服務持續超載的可能性。
如果要求仍然失敗,應用程式可以等候並嘗試另一次。 如果有需要,這一過程可以重複進行,並在每次重試之間逐漸增加延遲時間,直到達到最大嘗試次數為止。 延遲可以逐步或指數方式增加,這取決於故障的類型以及在此期間修復的概率。
應用程式應該將所有存取遠端服務的嘗試,封裝在實施符合上述其中一個策略的重試原則的程式代碼中。 傳送至不同服務的要求可能會受限於不同的原則。
應用程式應該記錄錯誤和失敗作業的詳細數據。 這項資訊對運算子很有用。 也就是說,為了避免讓操作員被過多警示淹沒,最好將早期失敗記錄為資訊性條目,並僅將最後一次重試嘗試的失敗記錄為實際錯誤。 以下是此記錄模型的外觀範例。
如果服務經常無法使用或忙碌,通常是因為服務已耗盡其資源。 您可以藉由水平擴展服務來減少這些錯誤的頻率。 例如,如果資料庫服務持續超載,則分割資料庫並將負載分散到多部伺服器上可能有助於改善情況。
問題和考量
決定如何實作此模式時,您應該考慮下列幾點。
對效能的影響
應調整重試原則,以符合應用程式的商務需求和失敗的性質。 對於某些非關鍵操作,快速失敗比多次重試影響應用程式吞吐量更好。 例如,在存取遠端服務的互動式 Web 應用程式中,最好是在重試嘗試之間只有短暫延遲的少量重試之後失敗,並向使用者顯示適當的訊息(例如,「請稍後再試一次」)。 針對批次應用程式,可能更適合增加嘗試次數,並增加嘗試之間的延遲指數。
如果重試策略的延遲時間極短且重試次數過多,這項激進的重試策略可能會進一步加重運行接近或達到容量上限的繁忙服務的負擔。 如果應用程式持續嘗試執行失敗的作業,此重試原則也會影響應用程式的回應性。
如果請求經過多次重試仍失敗,應用程式最好阻止更多請求前往同一資源,並立即回報失敗。 當期間到期時,應用程式可以暫時允許一或多個要求,以查看其是否成功。 欲了解更多此設計模式資訊,請參閱斷路器模式。
等冪
請考慮這項操作是否為等冪。 如果是,則重試原本就很安全。 否則,重試可能會導致作業多次執行,併產生非預期的副作用。 例如,服務可能會接收要求、成功處理要求,但無法傳送回應。 此時,重試邏輯可能會重新傳送要求,前提是未收到第一個要求。 對於處理重投訊息的消費者,請參見 冪等消費者模式。
例外狀況類型
對服務的請求可能因各種原因而失敗,並根據故障的性質產生不同的例外情況。 某些例外狀況表示可快速解決的失敗,而其他例外狀況則表示失敗持續時間較長。 重試原則適合根據例外狀況類型調整重試嘗試之間的時間。
交易一致性
請考慮重試屬於交易一部分的作業將如何影響整體交易一致性。 微調交易作業的重試原則,以最大化成功的機會,並減少復原所有交易步驟的需求。
一般指導
確保所有重試程式碼都經過針對各種失敗條件的完整測試。 檢查它不會嚴重影響應用程式的效能或可靠性,不會造成服務和資源過載,或產生競爭條件或瓶頸。
只有在了解失敗作業的完整內容時,才實作重試邏輯。 例如,如果包含重試原則的工作叫用另一個同時包含重試原則的工作,這個額外的重試層可能會為處理增加長時間的延遲。 最好將較低層級的工作設定為快速失敗,並將失敗的原因回報給叫用它的工作。 此較高層級的工作接著可以根據自己的原則來處理失敗。
記錄導致重試的所有連線失敗,以便識別應用程式、服務或資源的根本問題。
調查服務或資源中最可能發生的故障,以了解這些故障是否可能是持續存在的或最終會導致終止。 如果是,最好將錯誤視為例外來處理。 應用程式可以報告或記錄例外狀況,然後嘗試叫用替代服務(如果有的話),或提供降級的功能來繼續。 如需如何偵測及處理長期錯誤的詳細資訊,請參閱 斷路器模式。
使用此模式的時機
當應用程式與遠端服務互動或存取遠端資源時,可能會發生暫時性錯誤時,請使用此模式。 這些錯誤預期會短暫存在,而且重複先前失敗的要求可能會在後續嘗試時成功。
此模式可能沒有用處:
- 當錯誤可能持續很長時間時,因為這可能會影響應用程式的回應性。 應用程式可能會浪費時間和資源,而嘗試重複可能會失敗的要求。
- 針對處理非因暫時性故障所造成的失敗,例如應用程式商業邏輯錯誤所引起的內部例外狀況。
- 作為解決系統中延展性問題的替代方案。 如果應用程式頻繁出現忙碌錯誤,這通常顯示需要擴充所存取的服務或資源。
工作負載設計
架構設計人員應該評估如何在工作負載的設計中使用重試模式,以解決 Azure 架構架構要素中涵蓋的目標和原則。 例如:
| 支柱 | 此模式如何支援支柱目標 |
|---|---|
| 可靠性設計決策有助於使工作負載對故障具有彈性,並確保在發生失敗後會復原到全面功能正常的狀態。 | 減輕分散式系統中的暫時性錯誤是改善工作負載復原能力的核心技術。 - RE:07 自我保護 - RE:07 暫時性錯誤 |
如同任何設計決策,請考慮任何可能影響其他支柱目標的取捨,這些可能藉由此模式引入。
範例
如需使用 Azure SDK 的內建重試機制支援的詳細範例,請參閱使用 .NET 實作重試原則指南。
下一步
在撰寫自定義重試邏輯之前,請考慮使用一般架構,例如 適用於 .NET 的 Polly 或 適用於 Java 的 Resilience4j 。
處理變更商務數據的命令時,請注意重試可能會導致執行兩次動作,如果該動作像是向客戶的信用卡收費,可能會造成問題。 使用此部落格文章中所述的等冪模式有助於處理這些情況。
相關資源
針對大部分的 Azure 服務,用戶端 SDK 包含內建的重試邏輯。
斷路器模式。 如果失敗預期會持續更長時間,則更適合實作斷路器模式。 結合重試和斷路器模式提供處理錯誤的完整方法。