適用於:
 卡珊德拉
Important
您是否正在尋找一種適用於高擴展性場景的資料庫解決方案,且具有 99.999% 可用性的服務等級協定(SLA)、即時自動擴展,以及跨多個區域的自動容錯切換? 考慮使用Azure Cosmos DB作為NoSQL的選擇。
您是否想要移轉現有的 Apache Cassandra 應用程式? 請考慮 Azure 受控執行個體 for Apache Cassandra。
本文說明分區在 Azure Cosmos DB for Apache Cassandra 中的運作方式。
API for Cassandra 會使用分區,將 Keyspace 中的個別資料表進行擴展,以滿足應用程式的效能需求。 系統會根據與資料表中每筆記錄相關聯的分區索引鍵值來形成分區。 分區中的所有記錄都具有相同的分區索引鍵值。 Azure Cosmos DB 會以透明且自動的方式,管理分區在實體資源之間的配置,以有效滿足資料表的擴展性與效能需求。 隨著應用程式的輸送量與儲存體需求增加,Azure Cosmos DB 會在更多實體機器之間移動並平衡資料。
從開發人員的觀點來看,Azure Cosmos DB for Apache Cassandra 的分區行為,與原生 Apache Cassandra 的運作方式相同。 不過,在幕後仍存在一些差異。
Apache Cassandra 與 Azure Cosmos DB 之間的差異
在 Azure Cosmos DB 中,用來儲存分區的每一部機器,本身稱為實體分區。 實體分區類似於虛擬機器,是專用的計算單位或一組實體資源。 儲存在此計算單位上的每個分區,在 Azure Cosmos DB 中稱為邏輯分區。 如果你已經熟悉 Apache Cassandra,你可以把邏輯分割區當作 Cassandra 裡的一般分割區來思考。
Apache Cassandra 建議單一分區中可儲存的資料大小上限為 100 MB。 Azure Cosmos DB 的 API for Cassandra 允許每個邏輯分區最多 20 GB,且每個實體分區最多可儲存 30 GB 的資料。 在 Azure Cosmos DB 中,不同於 Apache Cassandra,實體分區中可用的計算容量,會以稱為要求單位的單一指標來表示,這可讓您以每秒要求數 (讀取或寫入) 的角度來思考工作負載,而非核心數、記憶體或 IOPS。 在您了解每個要求的成本後,這能讓容量規劃變得更加直接。 每個實體分區最多可提供 10000 RU 的計算能力。 您可以閱讀 API for Cassandra 中的彈性擴展文章,以深入了解擴展選項。
在 Azure Cosmos DB 中,每個實體分區都包含一組複本 (也稱為複本集),且每個分區至少有 4 個複本。 這與 Apache Cassandra 不同,因為在 Apache Cassandra 中可以將複寫因子設為 1。 然而,若唯一含有資料的節點發生故障,這會導致可用性偏低。 在 API for Cassandra 中,複寫因子一律為 4 (3 的法定人數)。 Azure Cosmos DB 會自動管理複本集,而在 Apache Cassandra 中,則需要使用各種工具來維護。
Apache Cassandra 具有權杖的概念,其為分區索引鍵的雜湊值。 這些權杖是以 murmur3 64 位元組雜湊為基礎,數值範圍從 -2^63 到 -2^63 - 1。 在 Apache Cassandra 中,這個範圍通常稱為「權杖環」。 權杖環會分配成權杖範圍,而這些範圍會分散配置到原生 Apache Cassandra 叢集中的各個節點。 Azure Cosmos DB 的分區採用類似的實作方式,但使用不同的雜湊演算法,且具有較大的內部權杖環。 不過,在對外公開時,仍會提供與 Apache Cassandra 相同的權杖範圍,也就是 -2^63 到 -2^63 - 1。
主要金鑰
API for Cassandra 中的所有資料表,都必須定義 primary key。 主索引鍵的語法如下所示:
column_name cql_type_definition PRIMARY KEY
假設我們要建立一個使用者資料表,用來儲存不同使用者的訊息:
CREATE TABLE uprofile.user (
   id UUID PRIMARY KEY,
   user text,
   message text);
在此設計中, id 欄位被定義為主鍵。 主鍵作為表格中記錄的識別碼,同時也用作 Azure Cosmos 資料庫中的分割鍵。 如果主鍵是以前述方式定義,每個分割區只有一條記錄。 這在寫入資料庫時呈現完美的水平分布且可擴展,非常適合鍵值查詢的使用場景。 應用程式在從資料表讀取資料時,應提供主索引鍵,以最大化讀取效能。
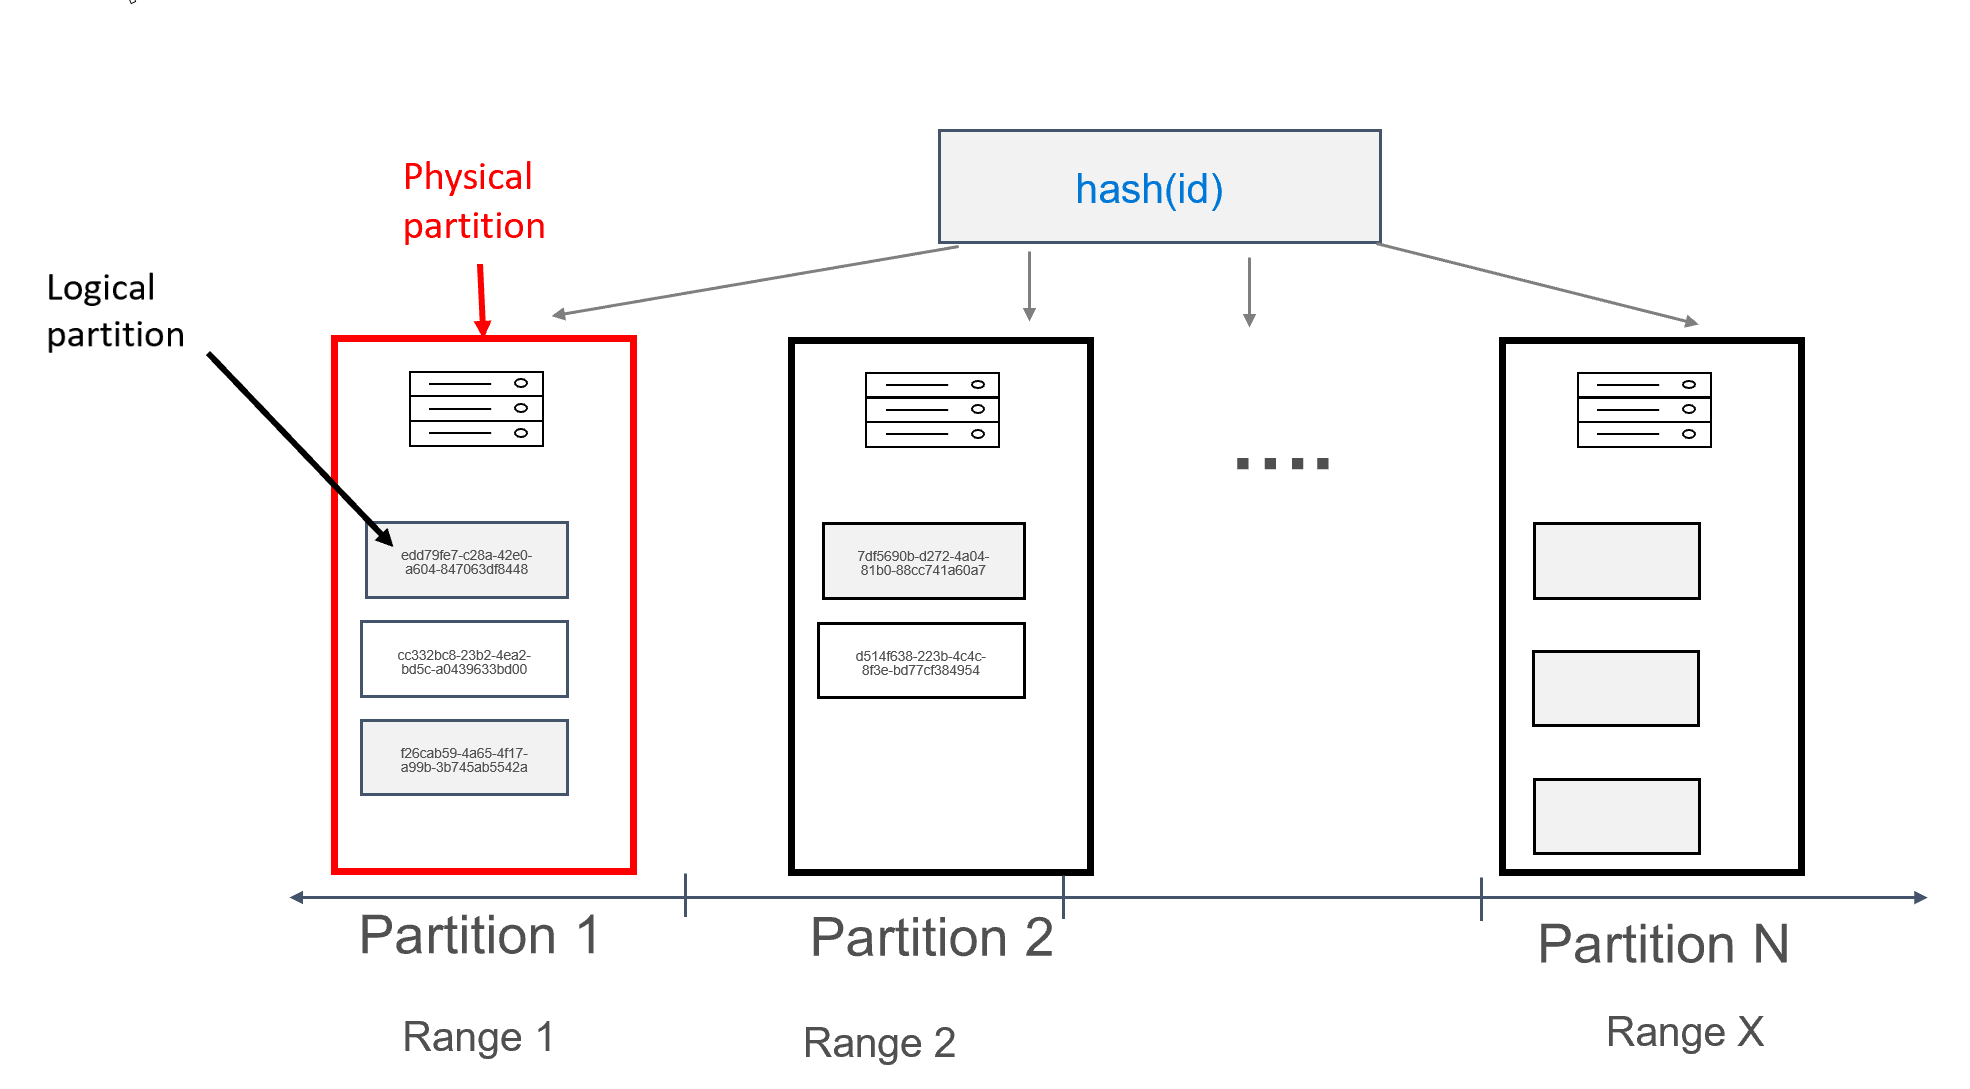
複合主索引鍵
Apache Cassandra 也有 compound keys 的概念。 複合 primary key 由多個資料行組成;第一個資料行為 partition key,其餘資料行則為 clustering keys。
compound primary key 的語法如下所示:
PRIMARY KEY (partition_key_column_name, clustering_column_name [, ...])
假設我們要變更上述設計,並使其能有效擷取特定使用者的訊息:
CREATE TABLE uprofile.user (
   user text,
   id int,
   message text,
   PRIMARY KEY (user, id));
在此設計中, user 定義為分割鍵, id 而為群集鍵。 您可以定義任意數量的叢集索引鍵,但每個叢集索引鍵的值 (或值的組合) 都必須是唯一的,才能將多筆記錄新增至同一個分區,例如:
insert into uprofile.user (user, id, message) values ('theo', 1, 'hello');
insert into uprofile.user (user, id, message) values ('theo', 2, 'hello again');
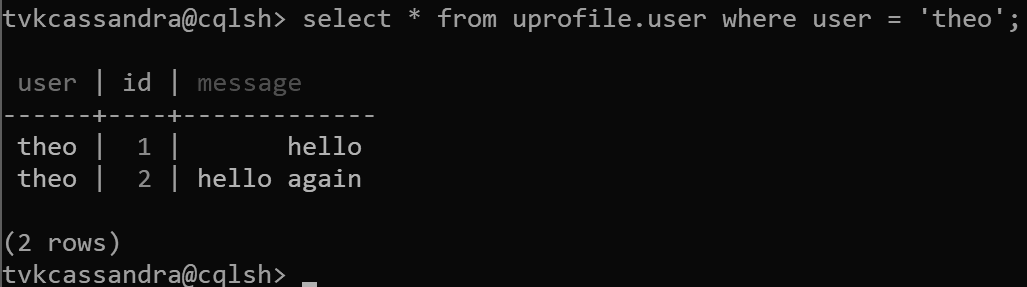
資料傳回時,系統會依叢集索引鍵排序,這與 Apache Cassandra 的預期行為一致:
Warning
當您查詢具有複合主索引鍵的資料表,且想要在分區索引鍵以及叢集索引鍵以外的任何未建立索引欄位上進行篩選時,請務必明確在分區索引鍵上新增次要索引:
CREATE INDEX ON uprofile.user (user);
Azure Cosmos DB for Apache Cassandra 預設不會對分割區鍵套用索引,在這種情況下,索引可能會大幅提升查詢效能。 請參閱我們關於次要索引的文章,以取得更多資訊。
以這種方式建立資料模型後,可以將多筆記錄指派給每個分區,並依使用者分組。 因此,我們可以發出由 partition key (在此案例中為 user) 有效率路由的查詢,以取得指定使用者的所有訊息。
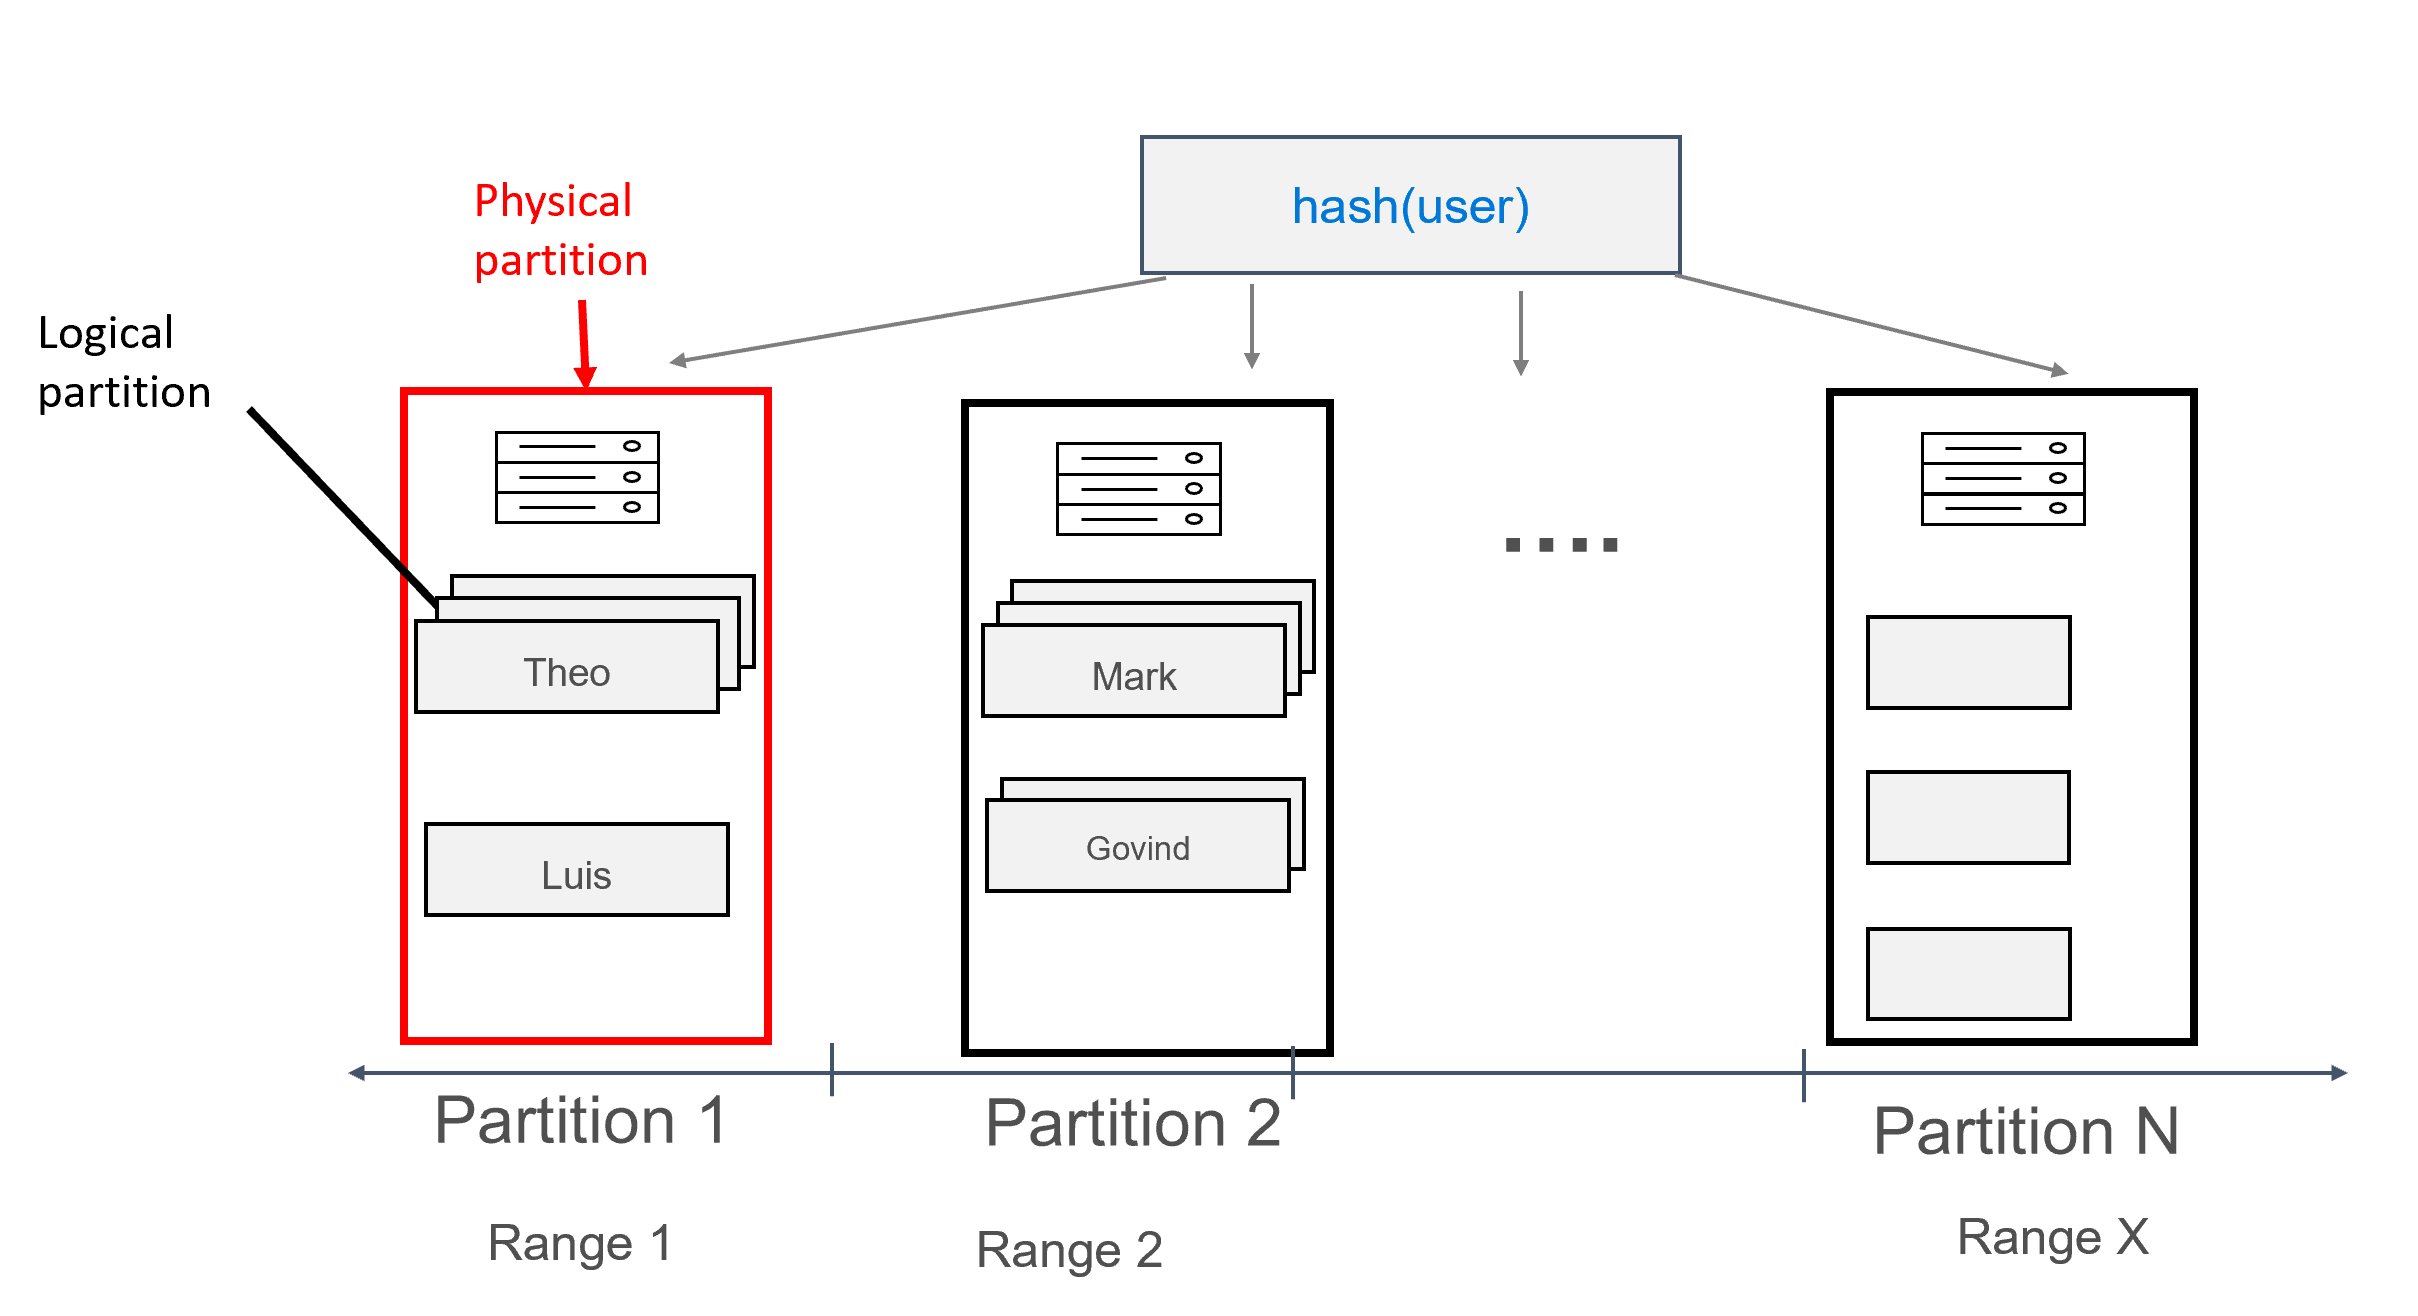
複合分區索引鍵
複合分區索引鍵的運作方式基本上與複合索引鍵相同,不同之處在於您可以指定多個資料行作為複合分區索引鍵。 複合分區索引鍵的語法如下所示:
PRIMARY KEY (
   (partition_key_column_name[, ...]),
    clustering_column_name [, ...]);
例如,您可以使用下列方式,其中 firstname 與 lastname 的唯一組合會形成分區索引鍵,而 id 則為叢集索引鍵:
CREATE TABLE uprofile.user (
   firstname text,
   lastname text,
   id int,
   message text,
   PRIMARY KEY ((firstname, lastname), id) );