將你的工作負載從經典運算遷移到無伺服器運算。 無伺服器運算自動處理配置、擴展、執行時升級與優化。
大多數經典工作負載都能以極少甚至不需修改程式碼的方式遷移。 例如,使用 df.cache() 和 df.persist() 的工作負載大多可在不修改程式碼的情況下遷移。 本頁聚焦於這些工作負載。 某些依賴 R 或 Scala 筆記本的工作負載需要經典運算,無法遷移到無伺服器。 關於目前的完整限制清單,請參見 無伺服器運算限制。
使用 Genie Migrate for Serverless 進行遷移
Important
這項功能位於 測試版 (Beta) 中。 Workspace 管理員可在 預覽 頁面中選擇加入 Compute Agent 預覽,以啟用此功能。 請參閱 管理 Azure Databricks 預覽。
Genie Migrate for Serverless 是一款代理程式,能將單一筆記本或作業遷移到無伺服器運算。 代理會審查工作負載的環境、函式庫、Spark 設定、標籤和程式碼,然後將每個變更作為個別建議,讓你接受或拒絕。 已接受的變更會直接套用,且可還原。
使用 Genie Code 以互動方式遷移筆記本或作業,或使用 Databricks CLI 在背景遷移工作,包括從腳本遷移的許多工作。 請參閱 使用 Databricks CLI 遷移作業。
代理人審查並更改的內容
| Area | 代理人的工作內容 |
|---|---|
| 環境與函式庫 | 將函式庫安裝轉換為無伺服器環境規範,包括 %pip 安裝、叢集初始化腳本、工作上的叢集函式庫,以及對私有套件索引的參考。 |
| 環境變數 | 將叢集環境變數轉換為無伺服器對應變數,保留工作區秘密參考並省略平台管理值。 |
| 資料與儲存存取 | 將與無伺服器運算不相容的路徑(例如本機磁碟、dbfs:/ 和掛載路徑)改寫為 Unity Catalog 磁碟區。 代理程式會自動套用無歧義的改寫,並在目標有歧義時要求你選擇一個磁碟區。 |
| Spark 設定 | 分類每個 Spark 配置,註解哪些配置安全可丟棄,並標記並移除無伺服器支援的配置。 涵蓋叢集連接式及筆記型電腦內的配置。 |
| 工作負載程式碼 | 將無伺服器不支援的程式碼重寫為相容的對應物,例如將 RDD 操作重寫為 DataFrame 操作,並調整無伺服器時 ANSI 模式 SQL 行為的程式碼。 |
| 標籤 | 將自訂叢集標籤(如成本中心標籤)轉換為無伺服器版本。 |
| 表演模式 | 根據叢集組態建議效能模式。 請參見 選擇表演模式。 |
要求
建議使用工作區管理員權限以確保完整遷移。 這是因為代理程式也會檢查超出目標工作負載的工作區層級全域初始化腳本。 如果你有
CAN MANAGE工作負載權限,或許可以遷移,但沒有管理員權限,可能會導致缺少函式庫、環境設定或標籤。確認你有權聯絡該代理。 在 Genie Code 中輸入
/compute。/compute應該會出現在自動完成選單中。 如果沒有顯示,工作區管理員必須在你的工作區啟用預覽。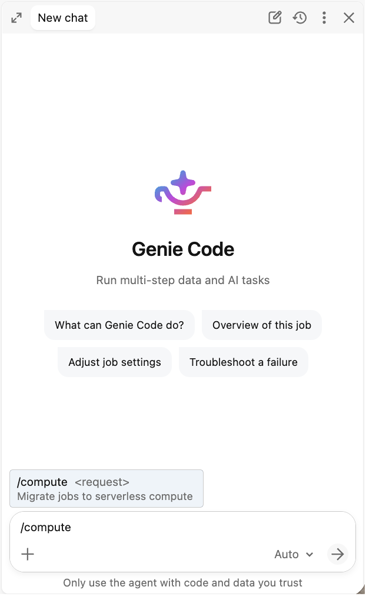
遷移筆記本
- 打開你想遷移的筆記本。
- 打開 Genie Code,從
/指令面板執行/compute migrate to serverless。 - 審查代理人的調查結果。 代理會掃描筆記本的環境、函式庫與程式碼,並針對每個需要變更的項目提出變更建議,例如將函式庫安裝移入環境規範,或重寫程式碼單元以在無伺服器上執行。
- 接受或拒絕每一項提案。
- 套用你已接受的變更。 它們會寫在固定的筆記本上。
- 將筆記本連接到無伺服器環境,然後執行它,確認其運作是否符合你的預期。 請參閱 「驗證已遷移的工作負載」。
遷移工作
- 開啟您要遷移的作業。
- 打開 Genie Code,從
/指令面板執行/compute migrate to serverless。 - 代理程式會複製你的作業,並嘗試將複製的作業遷移至無伺服器。
- 審查代理人的調查結果。 對於多工工作,代理會列舉每個任務及其每個任務叢集的配置,並在保留該工作排程的前提下提出變更建議。
- 接受或拒絕遷移表面上的每一項擬議變更:環境與函式庫、Spark 設定,以及任何必須變更的工作負載程式碼。
- 套用你已接受的變更。 此作業的運算已切換為無伺服器。
- 在無伺服器模式下執行工作並確認結果。 請參閱 「驗證已遷移的工作負載」。
- 作為最後步驟,代理會自動推廣遷移的克隆。 它會將複製的設定和筆記本複製回你原本的工作(保持相同的工作 ID、排程和權限),然後刪除複製品。 如果你跳過提升,原本的工作會維持排程,並繼續在經典運算上執行。 這個複製體沒有排程或觸發條件,所以只有在你啟動它時才會執行。
使用 Databricks CLI 遷移工作
使用 compute-migrations Databricks CLI 中的指令群組,在背景執行 Genie Migrate for Serverless 的工作,且不開啟 Genie Code 工作階段。 您可以從腳本啟動多個工作遷移,並在每個工作準備好時進行檢視。
Databricks CLI 路徑具備以下需求:
- 一位工作區管理員已啟用 Compute Agent 預覽。 若沒有它,所有
compute-migrations指令都會因PERMISSION_DENIED而失敗。 - Databricks CLI 版本 1.24.0 或更高。 請參閱安裝或更新 Databricks CLI。
-
CAN MANAGE你遷移的每個作業權限。
代理程式先備份作業,然後建立一個無伺服器的工作副本。 工作副本是名為 [Serverless Migration - <timestamp>] <job name> 的新作業,執行該作業筆記本和檔案的副本。 它沒有排程或觸發器,所以只有在你啟動時或 Azure Databricks 執行驗證時才會執行。 您的原始工作在您核准遷移前不會變更。
警告
驗證執行並非孤立的。 工作副本會針對與原始工作相同的資料表、卷、檢查點及外部系統執行。 如果工作寫入生產資料表、發送通知、呼叫外部 API 或推進串流檢查點,驗證執行也會這樣做。 僅對可安全額外執行一次的作業設定 run_validation。 建立移轉後,您無法更改此設定。
在遷移進行中,不要編輯原始工作或工作副本。 核准遷移後,原始工作的設定與檔案會被工作副本的設定與檔案取代。
啟動該作業的遷移:
databricks compute-migrations create -o json --request-id "<uuid>" --json '{
  "asset_type": "JOB",
  "asset_uri": "jobs/<job-id>",
  "auto_approve": false,
  "run_validation": false
}'
回應中包含遷移 ID。 為每個工作使用一個新的
request-id,若逾時後重試,請重複使用該request-id,避免建立重複的遷移。 建立遷移後,你無法更改run_validation或auto_approve。請使用
databricks compute-migrations get <migration-id> -o json檢查遷移狀態。 規劃與製作工作複本通常需要數分鐘。 若要檢查多個遷移,請先使用list,然後在執行前先確認每一次get遷移。當遷移到達
TRANSLATION_READY時,請檢視工作副本。migration_report.primary_asset.id是工作副本的工作編號。 將設定與程式碼與原始作業比對,然後使用你最新get中的--etag執行approve-migration-translation或reject-migration-translation。如果您設定
run_validation,Azure Databricks 會執行一次工作副本,並將結果記錄在validation_report中。 遷移無論執行成功或失敗都會移至MIGRATION_REVIEW,所以在核准前請先確認validation_report.passed。當遷移到達
MIGRATION_REVIEW時,請檢視工作副本與驗證結果,然後執行approve-migration-execution或reject-migration-execution使用--etag最新的get。 核准會將工作副本的設定與檔案套用到原始工作,並保留其工作 ID、排程與權限。當遷移達到
MIGRATION_COMPLETE時,原始工作已被更改。 請立即確認。 請參閱 「驗證已遷移的工作負載」。驗證原始工作後,刪除工作複本作業。
migration_report.secondary_assets列出工作副本執行所在的筆記本。 只有在確認原始工作沒有引用它們之後才刪除它們。
每個拒絕指令都需要一個拒絕理由,該理由需在移轉 ID 後傳入。 例如:
databricks compute-migrations reject-migration-translation <migration-id> "Keep the existing output table names." --etag <etag>
給出具體理由。 代理程式會修訂工作複本並寄回審核。 如果你一再拒絕一個遷移,它就會失敗。
下表列出了這些 compute-migrations 指令:
| Command | Description |
|---|---|
create |
開始為作業進行遷移。 若工作已有進行中的遷移或已成功的遷移,則會傳回 ALREADY_EXISTS。 |
get,list |
回傳單一遷移或所有遷移的狀態、報告及 etag。 |
approve-migration-translation,reject-migration-translation |
核准或拒絕處於 TRANSLATION_READY 狀態的工作副本。 在建立時設定 auto_approve 會跳過此審核。 |
approve-migration-execution,reject-migration-execution |
在 MIGRATION_REVIEW 狀態下批准或否決遷移。 核准會改變原始作業。 |
cancel-migration |
停止遷移。 取消不會撤銷已套用於原始作業的變更或驗證執行的副作用。 |
delete |
移除遷移記錄。 不會回滾變更或移除工作複本或備份。 失敗或被取消的遷移已經會釋放該工作,因此在開始新的遷移前,您不需要先刪除該工作。 |
每次執行核准、拒絕或取消指令時,都要從最新的 --etag 傳遞 get。 如果遷移在你讀取後已變更,指令會以 ABORTED 失敗,而非對你尚未檢閱的狀態採取動作。 如果代理程式無法遷移作業,遷移會移至 NOT_SUPPORTED 或 FAILED,而 state_history 會說明原因。
驗證已遷移的工作負載
代理程式會提出並套用變更,但不會驗證您的工作負載輸出。 使用 Databricks CLI 進行驗證執行時,只會檢查執行是否成功。 請務必先在無伺服器環境中執行遷移後的工作負載,並在加以依賴之前先確認結果,尤其是對於會寫入正式環境資料表的工作負載。 如果客服提出看起來不對勁的變更,請拒絕並給我們回饋,讓我們能改進客服。 請參閱 提交產品意見反應。
Tip
在驗證遷移工作負載時,先以效能優化模式執行。 它比標準模式啟動得更快,所以確認結果後回饋會更快。 在正式執行前,先切換到最適合工作負載的模式。 請參見 選擇表演模式。
當代理程式發現有內容無法安全遷移時,會回報阻礙因素,並在預設情況下停止。 你可以明確指示它略過某些相容性或相依性方面的阻礙,但這樣做表示你接受以下風險:這些相依性、成本歸因或執行階段行為可能無法沿用,而且工作負載可能會在無伺服器環境中失敗。
回滾移轉變更
代理人施加的變更是可逆的。
對於筆記本,打開它並還原遷移前的版本。 請參閱 Databricks 筆記本中的版本歷史。
對於某個工作來說,如果你沒有在 Genie Code 中推廣已遷移的複製品,或沒有使用 Databricks CLI 核准遷移,那麼你的原始工作就從未被更改。 照原樣執行,刪除複製品或工作副本。 否則,請使用代理程式在進行任何變更前所建立的備份來還原:
- 開啟備份資料夾:
/Workspace/Users/<username>/serverless-migration/backups/job-<job-id>/<timestamp>/。 備份位於執行遷移的使用者的主資料夾中,而 Databricks CLI 的主資料夾就是建立該資料夾的使用者。 在 Genie Code 中,代理程式在遷移過程中也會顯示這條路徑。 如果有多個時間戳記,請選擇遷移前不久的那個。 - 打開
job.yaml,其中包含您遷移前的作業設定,接著使用POST /api/2.2/jobs/reset要求將這些設定重新套用到同一個作業;此要求會以您提供的設定覆寫該作業的設定。 你也可以把它們貼到工作 UI 裡的 JSON 定義裡。 這會將作業恢復為傳統計算。 - 開啟
mapping.yaml,列出每個備份檔案及其原始路徑。 將每個備份檔案複製回原本的路徑,以還原程式碼重寫。 - 執行該作業,以確認其行為是否與遷移前相同。
遷移過程中從未刪除這個備份。 代理未修改的任務,如 git-sourced、SQL 或 dbt 任務,會被記錄在 job.yaml 備份中,但其檔案不會被複製到備份中,因此如果需要,請從真實來源還原這些任務。
已知的限制
- 以下項目被列為阻礙因素:自訂映像檔、ML Runtime 變體、早於 13 的 Databricks Runtime 版本、無法在無伺服器環境中安全忽略的 Spark 組態,以及 eggs、JAR 和 Maven 程式庫等相依項。 阻礙因素表示代理程式會停止,而不會遷移該項目。 你可以自行解決此問題並再次執行遷移,或者告訴代理程式仍繼續進行遷移,但這會讓該項目維持未解決狀態,且可能導致工作負載在無伺服器環境中失敗。
- 代理程式會讀取儲存在工作區檔案或 Unity 目錄卷中的初始化腳本。 儲存在 ABFSS 或 DBFS 中的 init 腳本無法讀取,並被報告為阻擋者。
- 代理程式不會檢查所有經典的計算屬性。 叢集日誌傳遞與 SSH 金鑰未被建模,雖然它能偵測許多 DBFS 掛載依賴性,但不會列舉或解析每個掛載。
- 快取與檢查點 API、全域暫存視圖、DBFS 掛載管理呼叫,以及 Scala 或 R 程式碼預設是硬阻擋。 你可以指示代理繼續,但未解決的功能會保持不變,且在無伺服器時可能會失敗。
- 擁有超過 10 個可遷移任務的工作無法被遷移。
- Genie Code 中的代理程式一次遷移一個工作負載。 若要遷移多個工作,請使用 Databricks CLI 為每個工作各建立一個遷移作業。 沒有全域探索或管理員核准流程。
- 使用 Databricks CLI 時,代理程式僅會遷移工作。 一個工作如果有來自遠端 Git 儲存庫的筆記本或 Python 任務,則無法遷移。
- 代理程式會提出變更並套用您接受的變更,但不會驗證輸出是否正確。 在依賴它取得生產資料之前,先確認已遷移的工作負載。
- 如果你的工作負載真實來源是 Databricks 資產包或 Git 資料夾,代理程式會對工作區物件套用變更。 將這些變更與你的套件或儲存庫對照,避免後續部署覆蓋遷移。
手動遷移至無伺服器
要將您的工作負載從經典運算遷移到無伺服器運算,請依照以下步驟操作:
- 檢查先決條件:確認您的工作空間、網路及雲端儲存存取符合需求。 請參閱必要條件。
- 更新程式碼:進行必要的程式碼與設定變更。 請參見 更新你的程式碼。
- 測試您的工作負載:在切換前驗證相容性與正確性。 請參見 「測試你的工作負載」。
- 選擇效能模式:選擇最適合您工作負載需求的效能模式。 請參見 選擇表演模式。
- 分階段遷移:逐步推出無伺服器,從新增且低風險的工作負載開始。 參見 分階段遷移。
- 監控成本:追蹤無伺服器 DBU 使用情況並設定警示。 請參見 監控成本。
Prerequisites
在開始遷移之前,你可能需要更新工作空間中的一些舊有設定。
| 先決條件 | Action | 詳細資料 |
|---|---|---|
| 已為工作區啟用了 Unity Catalog | 如有需要,請從 Hive Metastore 遷移 | 將 Azure Databricks 工作區升級至 Unity Catalog |
| 網路配置 | 以 NCC、Private Link 或防火牆規則取代 VPC 對等 | 無伺服器計算平面網路 |
| 雲端儲存存取 | 將舊有的資料存取模式替換為 Unity Catalog 的外部位置 | 使用 Unity Catalog 連接雲端物件儲存 |
確認你的工作區是否位於 支援區域。
更新您的程式碼
以下章節列出為使工作負載與無伺服器相容所需的程式碼與設定變更。
數據存取
無伺服器系統不支援舊有的資料存取模式。 更新你的程式碼改用 Unity Catalog。
| 經典圖案 | 無伺服器架構替代 | 詳細資料 |
|---|---|---|
DBFS 路徑 (dbfs:/...) |
Unity 目錄卷 | 什麼是 Unity Catalog 磁碟區? |
| Hive Metastore 資料表 | Unity Catalog 表格(或稱 HMS Federation) | 將 Azure Databricks 工作區升級至 Unity Catalog |
| 存儲帳戶憑證 | Unity Catalog 外部位置 | 使用 Unity Catalog 連接雲端物件儲存 |
| 客製化 JDBC JAR 檔案們 | Lakehouse 聯盟 | 什麼是查詢聯合? |
警告
DBFS 在無伺服器時存取有限。 遷移前請更新所有 dbfs:/ 通往 Unity 目錄卷的路徑。 欲了解更多資訊,請參閱 DBFS 中儲存的檔案遷移。
範例:替換 DBFS 路徑與 Hive Metastore 參照
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
API 與程式碼
某些 API 和程式碼模式在無伺服器上不被支援。 參考此表,看看你的程式碼是否需要更新。
| 經典圖案 | 無伺服器架構替代 | 詳細資料 |
|---|---|---|
RDD API (sc.parallelize, rdd.map) |
DataFrame API | 比較 Spark Connect 與 Spark Classic |
spark.sparkContext,sqlContext |
直接使用 spark (SparkSession) |
比較 Spark Connect 與 Spark Classic |
蜂巢變數 (${var}) |
SQL DECLARE VARIABLE 或 Python f-strings |
DECLARE VARIABLE |
| 不支援的 Spark 設定 | 移除不支援的設定。 Serverless 大多數設定會自動調整。 | 為無伺服器筆記型電腦與作業設定 Spark 屬性 |
範例:以 DataFrames 取代 RDD 操作
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
範例:替換 SparkContext API
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")
SQL 行為差異
無伺服器運算預設啟用 ANSI 模式。 Databricks 執行時在版本 17.0 及以上預設啟用 ANSI 模式。 如果你的經典運算執行的是較早版本,某些在該處可成功執行的查詢在無伺服器環境中會引發執行階段錯誤。
Genie Migrate for Serverless 會自動調整程式碼以符合 ANSI 模式的行為。 若您手動遷移,請檢視以下操作,這些操作最常會改變行為:
| 作業 | 已停用 ANSI 模式的經典運算 | 無伺服器計算 |
|---|---|---|
無效的型別轉換,例如 CAST('abc' AS INT) |
傳回 NULL。 |
引發 CAST_INVALID_INPUT |
| 整數算術溢位 | 自動換行。 例如 2147483647 + 1 會傳回 -2147483648。 |
引發 ARITHMETIC_OVERFLOW |
| 十進位算術溢位 | 傳回 NULL。 |
引發 NUMERIC_VALUE_OUT_OF_RANGE |
| 除以零 | 傳回 NULL。 |
引發 DIVIDE_BY_ZERO |
| parse_url 中的 URL 格式錯誤 | 傳回 NULL。 |
調薪 INVALID_URL |
若要返回 NULL 而非產生錯誤,請將操作替換為其 try_* 等價運算,例如 try_cast、 try_add、 try_divide 或 try_parse_url。 Databricks 建議採用此方法,而非關閉 ANSI 模式,因為 ANSI 模式會顯示出無提示的 NULL 所隱藏的資料品質問題。
若要讓轉型、算術運算和剖析不使用 ANSI 模式,請將 spark.sql.ansi.enabled 設為 false。 無伺服器計算對資料表插入的隱含轉換套用 ANSI 規則,無論此設定為何,因為 spark.sql.storeAssignmentPolicy 無法在無伺服器計算中更改。 欲了解 ANSI 行為的完整說明,請參閱 Databricks 執行時中的 ANSI 合規。
函式庫與環境
你可以在工作區層級使用 基礎環境 管理函式庫和環境,並在筆記本層級使用筆記本的 無伺服器環境管理。
| 經典圖案 | 無伺服器架構替代 | 詳細資料 |
|---|---|---|
| 初始化腳本 | 無伺服器環境 | 設定無伺服器環境 |
| 叢集層級程式庫 | 限定於筆記本的或環境中的函式庫 | 設定無伺服器環境 |
| Maven/JAR 函式庫 | JAR工作支援;筆記本用的 PyPI | 用於作業的 JAR 工作任務 |
| Docker 容器 | 無伺服器環境以滿足函式庫需求 | 設定無伺服器環境 |
在 requirements.txt 中鎖定 Python 封包,以便建立可重現的環境。 請參見 Specified Python 套件版本。
串流
串流工作負載在無伺服器架構上受支援,但不支援某些觸發事件。 更新你的程式碼,使用支援的觸發器。
| 火花觸發器 | 支援 | Notes |
|---|---|---|
Trigger.AvailableNow() |
是的 | Recommended |
Trigger.Once() |
是的 | 這已被取代。 請改用 Trigger.AvailableNow()。 |
Trigger.ProcessingTime(interval) |
No | 傳回 INFINITE_STREAMING_TRIGGER_NOT_SUPPORTED。 |
Trigger.Continuous(interval) |
No | 改用 Lakeflow 管線的連續模式 |
預設(非設定 .trigger()) |
No | 省略 .trigger() 預設值為 ProcessingTime("0 seconds"),在無伺服器架構中不支援。 一定要明確設定 .trigger(availableNow=True) 。 |
若需連續串流,請在連續模式下遷移至 Spark 宣告式管線,或使用帶有 連續排程工作 的 AvailableNow。 對於大型來源,請設定 maxFilesPerTrigger 或 maxBytesPerTrigger 防止記憶體不足錯誤。
範例:修正串流觸發器
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
測試你的工作負載
- 快速相容性測試:在經典運算上以 標準 存取模式及 Databricks Runtime 14.3 或以上版本執行工作負載。 如果執行成功,工作負載可以遷移到無伺服器,且不需修改程式碼。
- A/B 比較 (建議用於正式環境):在經典(控制)與無伺服器(實驗)上執行相同工作負載。 比較輸出表格並驗證其正確性。 反覆迭代直到輸出匹配。
- 臨時設定:您可以在測試期間暫時設定支援的 Spark 設定。 穩定後再取下。
選擇表演模式
無伺服器工作與管線支援兩種效能模式:標準與效能優化。 你選擇的效能模式取決於你的工作負載需求。
| 模式 | 可用性 | Startup | 最適合用於 |
|---|---|---|---|
| 標準 | 工作與 Lakeflow 管線 | 通常 4-6 分鐘 | 成本敏感批次 |
| 效能優化 | 工作與 Lakeflow 管線 | 通常不到一分鐘 | 互動式,對延遲敏感 |
標準模式消耗的 DBU 比效能優化模式少,因此成本較低。 若要比較模式並設定已遷移作業或管線的模式,請參閱 「為無伺服器作業與管線選擇效能模式」。
分階段遷徙
- 新增工作負載:在無伺服器上啟動所有新的筆記本與工作。
- 低風險工作負載:遷移已採用標準存取模式及 Databricks Runtime 14.3 或以上版本的 PySpark/SQL 工作負載。
- 複雜工作負載:遷移需要程式碼變更的工作負載(RDD 重寫、DBFS 更新、觸發器修正)。
- 剩餘工作負載:隨著功能擴充定期檢視。
成本監控
無伺服器計費是以 DBU 消耗為基礎,而非叢集運作時間。 在大規模遷移前,請以具代表性的工作負載驗證成本預期。 關於監控無伺服器成本的工具與策略,請參見 「監控無伺服器運算成本」。
其他資源
- 無伺服器運算最佳實務:無伺服器工作負載的優化技巧
- 無伺服器運算限制:完整現行限制與不支援功能清單
- 設定無伺服器環境:管理函式庫與相依性
- 支援的 Spark 配置:無伺服器環境中可用的 Spark 設定
- Spark Connect 與經典 Spark:無伺服器架構中的行為差異
-
在無伺服器運算上快取資料框:使用
df.cache()和df.persist()快取資料框 - 無伺服器網路安全:NCC、Private Link 與防火牆設定
- 無伺服器運算版本說明:追蹤新功能陸續推出
- Unity Catalog 升級指南:從 Hive Metastore 遷移至 Unity Catalog
您也可以參考以下部落格文章以獲得更多資訊:
- 什麼是無伺服器運算?:無伺服器能力與客戶成果概述
- 資料工程的演進:無伺服器運算如何改變筆記型電腦與 Lakeflow 作業:無伺服器運算如何驅動 Lakeflow 作業與管線