sdp-meta 的專案提供工具,讓你能從你維護的元資料產生管線。
Note
開放原始碼 sdp-meta 專案,和 databrickslabs GitHub 帳號中的所有專案一樣,僅供探索用途。 Azure Databricks 不支援它,也不為其提供服務等級協定 (SLA)。 請勿針對與此專案相關的問題提交 Azure Databricks 支援票證。 請改為提交 GitHub 問題,我們會在有時間時審查。
什麼是 sdp-meta?
Lakeflow 管線允許你以聲明方式指定一個表格,並在管線中產生一個流程,既能建立該表格,也能隨著來源資料的變化保持其最新。 不過,如果您的組織有數百個資料表,則產生和管理這些管線非常耗時,而且可能會導致做法不一致。
sdp-meta 專案是一個以元資料驅動的元程式設計框架,專為 Lakeflow 管線設計而設計。 該框架透過利用一組 JSON 和 YAML 檔案中記錄的元資料,實現青銅和白銀資料管道的自動化。 執行時,通用管線會讀取你的元資料,並動態建立其中描述的流程。 青銅與銀的加工可以在獨立管線中進行,也可以合併在一條合流管線中進行。 你產生關於管線的元資料,而 sdp-meta 則會產生你的管線。
當您的邏輯集中在一個地方(元數據)時,您的系統會更快、可重複使用且更易於維護。
Note
sdp-meta 專案先前名稱dlt-meta來自 Azure Databricks 中較早的 Delta Live Tables 功能。
Delta Live Tables 已被 Lakeflow pipelines 取代,而 sdp-meta 則與 Lakeflow pipelines 合作。 如果你正在升級現有 dlt-meta 安裝,請參考 sdp-meta 文件中的 遷移指南 。
sdp-meta 的優點
sdp-meta 有兩個主要的使用情境:
- 輕鬆擷取並清理大量資料表。
- 跨多個管道和使用者強制執行資料工程標準。
使用中繼資料驅動方法的好處包括:
- 維護元資料可以在不了解 Python 或 SQL 程式碼的情況下完成。
- 維護中繼資料 (而不是程式碼) 需要較少的額外負荷,並減少錯誤。
- 程式碼是用 sdp-meta 產生的,所以保持一致性,且在管線和已發佈資料表間的自訂程式碼較少。
- 您可以輕鬆地在中繼資料中將資料表分組到各個管線內,產生以最高效率更新資料所需的管線數量。
SDP-meta 的運作方式
下圖展示了 sdp-meta 系統的概述:
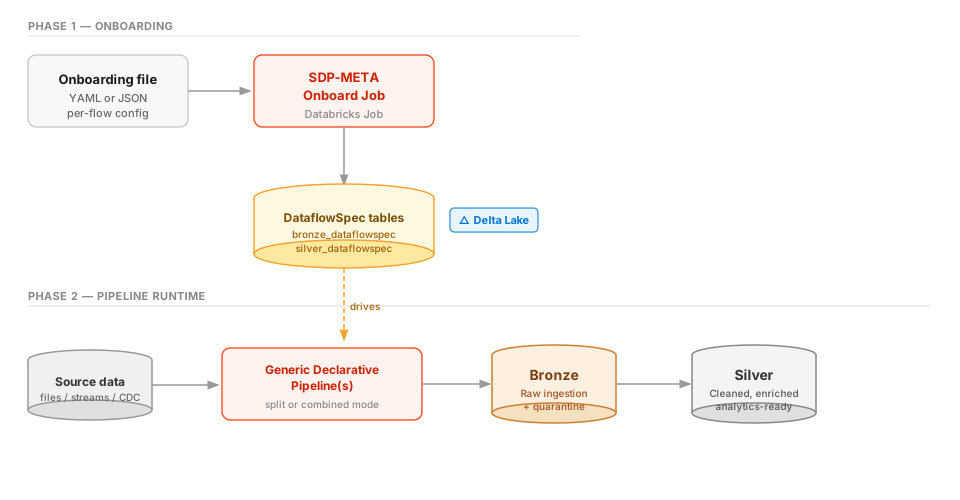
- 你將元資料檔案作為 sdp-meta 的輸入,用來指定來源檔案與輸出、品質規則以及所需的處理。 這些入職檔案可以用 JSON 或 YAML 撰寫。
- 你負責 sdp-meta 的入職工作。 引擎會將導入檔案編譯成稱為 DataflowSpec 的資料流程規範,並儲存在 Delta 表格(
bronze_dataflowspec和silver_dataflowspec)中以供日後使用。 - 執行時,通用管線會讀取 DataflowSpec,並動態建立青銅處理圖。 它會讀取你的原始資料(檔案、串流或 CDC),並套用符合品質規則的正確數據期望,產生你的青銅表,並隔離不符合這些規則的紀錄。
- Silver 處理可在獨立的通用管線中執行,這是宣告式自動化套件的預設方式;或者在使用合併模式時,於同一條管線中執行。 該管線使用 DataflowSpec 來套用適當的轉換和其他處理程序,產生已清理、已擴充且可供分析的銀資料表。
你可執行由 sdp-meta 產生的管線,以在來源資料更新時讓輸出內容維持最新狀態。
開始
要使用 sdp-meta,你必須:
- 部署並配置 sdp-meta 解決方案。
- 為青銅層和銀層的資料表準備中繼資料。
- 建立一個作業以導入中繼資料。
- 使用中繼資料為您的資料表建立管線。
sdp-meta 專案支援多種部署介面:推薦的套件、互動式 CLI、帶有瀏覽器 GUI 的 Databricks 應用程式、用於 AI 輔助設定的 MCP 伺服器,以及支援具備技能感知的 AI 代理的可攜式代理技能。
GitHub 上的 sdp-meta 文件有教學,幫助你開始這個流程。 更多資訊請參閱 GitHub 上的 sdp-meta 入門指南。