Important
本文中標示為預覽的項目目前仍在預覽中。 此預覽版未簽訂服務等級協議,Microsoft 不建議用於生產工作負載。 某些功能可能不被支援或功能受限。 欲了解更多資訊,請參閱 Microsoft Azure 預覽版補充使用條款。
Important
互動式訓練需要明確的存取核准。 請透過 預覽報名表單 申請存取權限,並等待核准後再建立培訓課程。
互動式訓練(預覽)是一個 API,用於在 Microsoft Foundry 中基於開放權重模型建立你自己的後訓練流程。 你用 Python 控制實驗。 Foundry 在無伺服器 GPU 上執行模型取樣與低秩適應(LoRA)更新。
在強化學習(RL)中,你的程式碼控制軌跡收集、獎勵、優勢及更新排程。 相同的基元支援監督學習、偏好學習、蒸餾及自訂損失工作流程。
何時使用它
當訓練循環本身是你研究的一部分時,就使用互動式訓練:
- 你需要一個自訂的學習訊號。 提供示範、計算獎勵與優勢,或撰寫局部損失函數以促進偏好學習或其他目標。
- 你的模型與環境互動。 在你的驅動程式中協調模型回應、工具呼叫、觀察與獎勵。
- 你需要對個別更新進行控制。 選擇批次、標記遮罩、損失設定和優化參數。 決定何時累積梯度並進行更新。
- 你想要檢視並調整一個實驗。 從現有的適配器中取樣,評估保留作測試的提示,並根據觀察結果選擇下一批提示。
- 你需要保存並延續進度。 儲存 adapter 和優化器狀態,然後在相容的會話中繼續。 將資料集位置和其他實驗狀態保留在你的驅動程式碼中。
管理式微調也支援強化微調的評分器。 當你需要控制迴圈時,選擇互動式訓練,而不只是評分器或工作設定。 請參閱 選擇你的訓練方式。
誰做什麼
你的 Python 程式是訓練主程式。 它負責準備輸入資料並協調實驗。 Foundry 維護模型與適配器狀態,並執行所請求的操作。
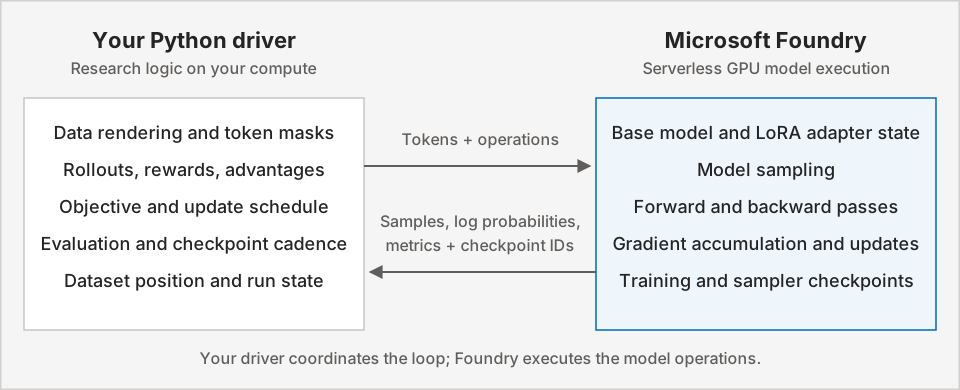
你的驅動程式可在 CPU 上執行,包括在你自己的電腦或運算環境中。 你新增的獎勵模型或環境可以有自己的計算需求。 讓驅動器在管理迴路時持續運轉。
核心概念與原語
會話是有狀態的:梯度計算、優化器更新與抽樣都是在所選模型與適配器上進行的獨立操作。 這種分離讓你能選擇何時收集資料、累積梯度、更新與評估。
| 基礎組件 | 其功能是什麼 |
|---|---|
| 訓練課程與 LoRA 轉接器 |
FineTuningSession.create 以你的轉接器配置初始化支援的基礎模型。 該會話會保留後續操作所使用的狀態。 |
| 標記化批次與遮罩 |
Datum 攜帶模型輸入與損失輸入。 遮罩選擇哪些 token 能幫助學習,例如助理 token,而非提示詞或工具觀察。 |
| 取樣 |
sample 從選定的取樣檢查點產生回應。 強化學習輸入會將抽樣的代幣與其 rollout 的對數機率及獎勵衍生的優勢配對。 |
| 前向傳播與反向傳播 |
forward 回傳每個範例的損失函數輸出,且不累積梯度。
forward_backward 計算所選目標並累積梯度。 它不套用優化器更新。 |
| 優化器更新 |
optim_step 用你的 Adam 參數套用累積的梯度。 你可以選擇何時更新以及使用哪種學習速率。 |
| 取樣器檢查點 |
save_weights_for_sampler 準備適配器權重用於生成。 更新後,請先刷新這些權重,再從更新的轉接器取樣。 |
| 訓練檢查點 |
save_weights 保存介面卡權重與優化器狀態。
FineTuningSession.create_from_checkpoint 在相容的工作階段中恢復訓練。 |
SDK 包含 cross_entropy 監督更新與強化學習損失,如 importance_sampling 和 ppo。 這些損失是損失原語,而非預先定義的端對端演算法。 關於輸入簽章與自訂損失函式組合,請參見 關鍵概念。
強化學習迴圈的運作方式
試想一個數學推理實驗:你的模型會對每個問題產生多個答案,程式會評分它們的正確性。 範例請參考 開始使用。
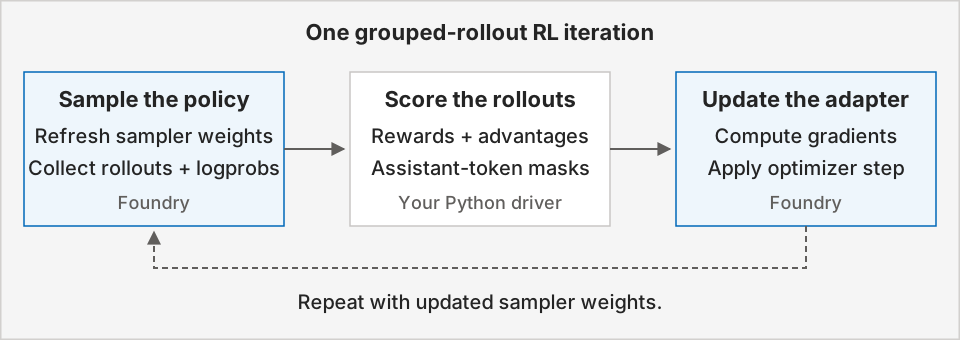
建立一個留出的基準,並在第一次更新前測試你的獎勵功能。 然後重複:
- 準備目前的取樣策略。 從訓練 adapter 儲存取樣器權重,然後為每個提示收集多個回應或 rollouts。
- 評分並比較回應。 你的獎勵函數會為每次 rollout 分配分數。 減去提示組的平均獎勵,以產生每次 rollout 的 advantage。
- 準備學習訊號。 將抽樣助理代幣與其 rollout 對數機率及優勢對齊。 將提示與環境觀察從學習訊號中排除。
- 計算梯度。 將批次提交到
forward_backward,並使用importance_sampling。 在會使用該梯度的更新之前完成梯度計算。 - 更新介接器。 呼叫
optim_step,然後刷新取樣器權重,再從更新的策略中收集回應。 - 評估並保留進度。 將留出集的正確率與基準比較,並依你選擇的頻率儲存訓練檢查點。
開始
選擇最適合你任務的起點:
- 快速入門: 請依照 快速入門範例 複製倉庫,並執行一個簡短的強化學習流程。
- 試試其他食譜: 探索微調範例庫以獲得更多訓練範例。
- 查一下操作: 使用 SDK 速查表(預覽) 來查看功能和關鍵參數。
- 了解訓練循環: 閱讀關鍵概念,了解獎勵、優勢、token 遮罩與檢查點。