Microsoft Fabric 中的 Eventstream 是一項完全受管理的事件擷取與串流服務,能實現即時資料處理與分析。 你可以使用 Spark 結構化串流,將 eventstream 與 Fabric 筆記本整合,實時處理和分析串流資料。
此整合讓您能透過 Real-Time 中心,直接在Fabric筆記本中探索事件串流及其他即時來源。 你也可以建立新的事件串流,並開始從近 30 個(且持續成長)的串流來源匯入資料,包括支援 CDC 的資料庫、訊息代理、串流服務和公開訂閱。 新的程式設計模式讓你能輕鬆連接事件串流、讀取串流資料,並使用熟悉的 Spark API 進行即時分析,無需任何連線字串或憑證,讓建立即時應用程式更加安全
先決條件
在開始之前,請確保你已經具備以下先決條件:
- 一個啟用事件串流的 Fabric 工作區。
- 一個用 Fabric 設定的筆記本環境。
- Spark 結構化串流、PySpark 或 Scala 的基礎知識。
從筆記本查詢事件串流的步驟
發現並將事件串流加入 Notebook:
打開你的 Microsoft Fabric 筆記本。
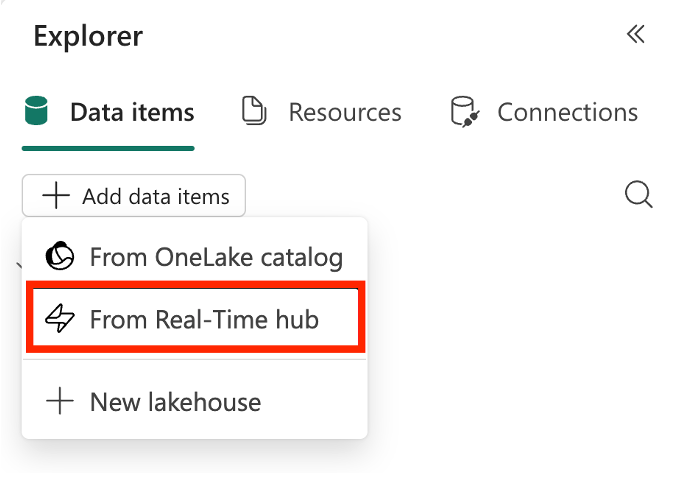
在「資料項目」標籤下選擇「新增資料項目」,然後從下拉選單中選擇「從 Real-Time 樞紐」。
在 Real-Time 樞紐對話框中,找到你想查詢的目標事件流,並使用不同的搜尋和篩選選項。
把事件串流加入你的筆記本環境。
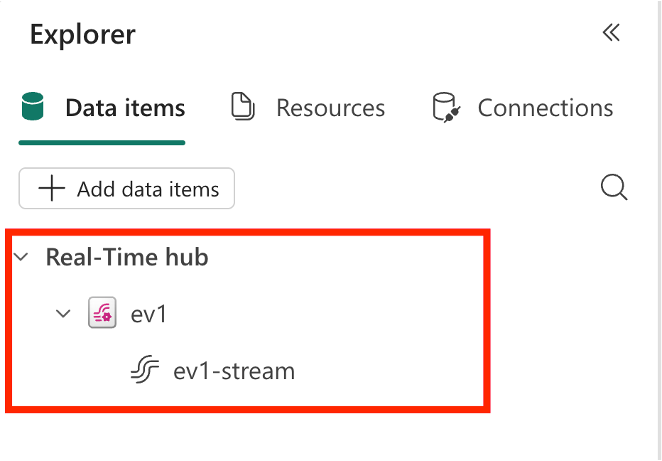
事件串流項目加入後,它會出現在筆記本物件總管的 Real-Time 樞節點 下,並以項目名稱顯示,展開節點後,你會看到該事件串流項目中的預設或衍生串流。
讀取 eventstream 的串流資料:
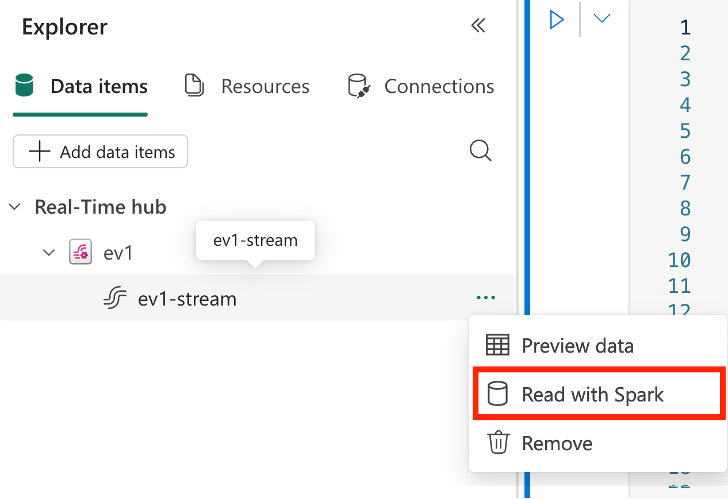
在物件總管中事件串流項目的右鍵選單中,選擇「 用 Spark 讀取 」以建立預先設定的程式碼儲存格,從所選事件串流讀取。
在新建立的程式碼儲存格中,您可以使用以下 PySpark 程式碼片段來讀取事件串流資料:
from pyspark.sql import SparkSession from pyspark.sql.functions import col from pyspark.sql.types import StringType from pyspark.sql.dataframe import DataFrame eventstream_options = { "eventstream.itemid": __in_eventstream_item_id, "eventstream.datasourceid": __in_eventstream_datasource_id } # Read from Kafka using the config map df_raw = spark.readStream.format("kafka").options(**eventstream_options).load() decoded_df = df_raw.select( col("key").cast(StringType()).alias("key"), col("value").cast(StringType()).alias("value"), col("partition"), col("offset") ) def showDf(x:DataFrame, y:int): x.show() # Print messages to the console query = decoded_df.writeStream.foreachBatch(showDf).outputMode("append").start() query.awaitTermination()eventstream.itemid和eventstream.datasourceid選項的值會自動填入此代碼格上方的參數代碼格。備註
對於 Read with Spark 的每個選擇,都會自動產生一個新程式碼儲存格,並自動填入必要的參數,並為 Eventstream 項目建立新的 Notebook 目的地,且每個 目的地 都是
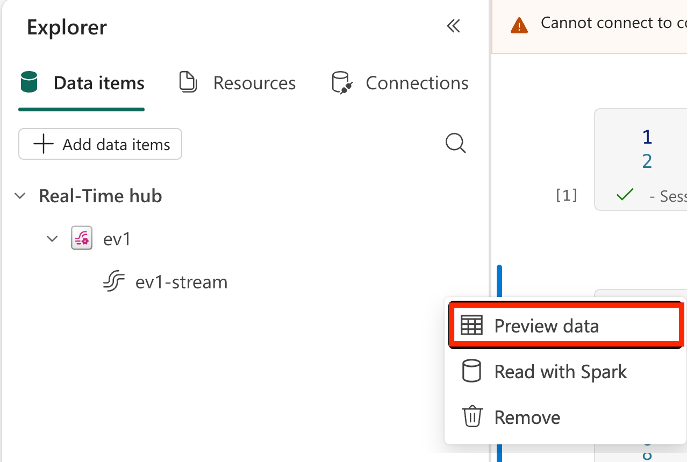
eventstream.datasourceid唯一的。 對於一個筆記本項目,我們建議你只設定一次作為一個 Eventstream 項目的目的地,以避免建立多個目的地。在執行任何工作之前,你也可以點擊事件串流項目的右鍵選單中的 「預覽資料 」按鈕來預覽串流資料。 側邊面板打開,顯示筆記本旁串流資料的快照。
新增筆記本作為目的地:你也可以將筆記本新增為事件串流的目的地,以便從筆記本內部開始將資料匯入事件串流。 欲了解更多資訊,請參閱 「將 Spark Notebook 目的地加入事件串流」。
Conclusion
利用 Spark 結構化串流將 eventstream 整合於Fabric筆記本中,能讓您無縫處理與分析即時資料。 遵循本文所述步驟,您可以輕鬆連接事件串流、讀取串流資料,並利用熟悉的 Spark API 進行即時分析。 此整合開啟了建構即時應用及從 Fabric 生態系統中串流數據獲取洞見的新可能。
相關內容
想了解更多如何在 Fabric 中使用事件串流和筆記本,請參考以下資源