SpeechRecognition API 是一種標準 Web API,可讓您將來自媒體檔案或裝置麥克風等音訊來源的語音直接從網站或瀏覽器擴充功能的 JavaScript 程式碼轉換為文字。 本文著重於使用 SpeechRecognition API 搭配內建於 Microsoft Edge 的裝置上 (或本機) 語音辨識模型。
如需有關 API 的詳細資訊,請參閱 MDN 的 Web 語音 API。
詳細內容:
- 本機語音辨識模型的可用性
- 本機語音辨識模型的優點
- 在 Microsoft Edge 中啟用本機語音辨識
- 查看運作範例
- 在您的網站中使用具有本機辨識的 SpeechRecognition API
- 傳送意見反應
- 另請參閱
本機語音辨識模型的可用性
本機語音辨識模型可在 Microsoft Edge Canary 或 Dev (版本 150.0.4076 或更新版本中使用) 。 請參閱 成為 Microsoft Edge 測試人員。
本機語音辨識模型的優點
搭配 Microsoft Edge 中的本機模型使用 SpeechRecognition API 時,語音辨識會在擷取語音的相同裝置上進行。 相較於雲端式解決方案,此方法具有下列優點:
降低成本: 使用雲端辨識服務無需支付任何費用。
網路獨立性: 除了初始模型下載之外,使用此 API 轉換語音時不會出現網路延遲,而且該 API 也可以在裝置離線時使用。
改善隱私權: 輸入到模型的語音永遠不會離開裝置,也不會被收集來訓練 AI 模型。
型號可用性
網站首次透過 SpeechRecognition API 使用本機語音辨識模型時,需要初始下載模型。
您可以使用 SpeechRecognition API install() 方法傳回的 Promise 來監視模型下載。 請參閱下方 [檢查本機模型] 是否已安裝。
在 Microsoft Edge 中啟用本機語音辨識
若要搭配 SpeechRecognition API 使用本機語音辨識模型,您必須在 Microsoft Edge Canary 或 Dev 中啟用此功能。 若要使用裝置上的型號啟用語音辨識:
請確定您使用的是 Microsoft Edge Canary 或 Dev (版本 150.0.4076 或更新版本的) 。 請參閱 成為 Microsoft Edge 測試人員。
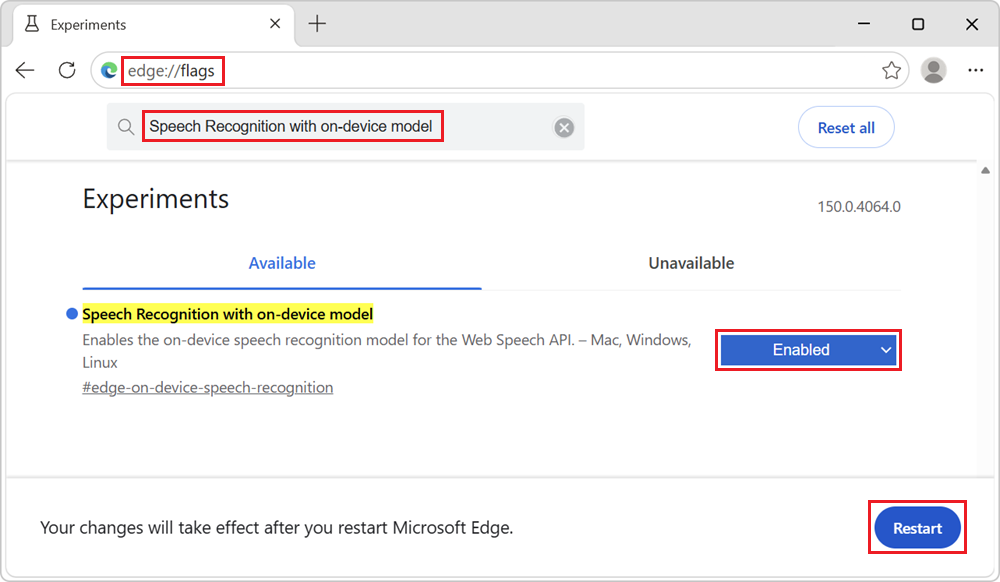
在 Microsoft Edge Canary 或 Dev 中,開啟新的索引標籤或視窗,然後移至
edge://flags。在頁面頂端的搜尋方塊中,輸入 含裝置型號的語音辨識。
在 [具有裝置端型號的語音辨識] 下拉式清單中,選取 [已啟用],然後按一下右下角的 [重新啟動 ] 按鈕:
查看運作範例
若要查看 SpeechRecognition API 的運作方式並檢視示範程式碼:
如上所述,在 Microsoft Edge 中啟用本機語音辨識。
在 Microsoft Edge Canary 或 Dev 中,開啟索引標籤或視窗,然後移至 SpeechRecognition API playground。
在頂端的資訊橫幅中,檢查狀態:最初顯示為 SpeechRecognition API 就緒。按一下 [開始] 以開始。
在 [ 輸入語言] 下拉式清單中,選取您要用於語音辨識的語言。
在 [音訊來源] 下拉式清單中,選取語音辨識的音訊來源:
- 選取 [麥克風] 以使用裝置麥克風做為音訊來源。
- 選取 [檔案 ] 以使用您裝置中的音訊或視訊檔案做為音訊來源。
如果您選取 [ 檔案 ] 做為音訊來源,則會顯示 [ 媒體檔案 ] 區段。 按一下 [選擇檔案 ] 按鈕,然後從您的裝置選取音訊或視訊檔案。
按一下 [開始] 按鈕。
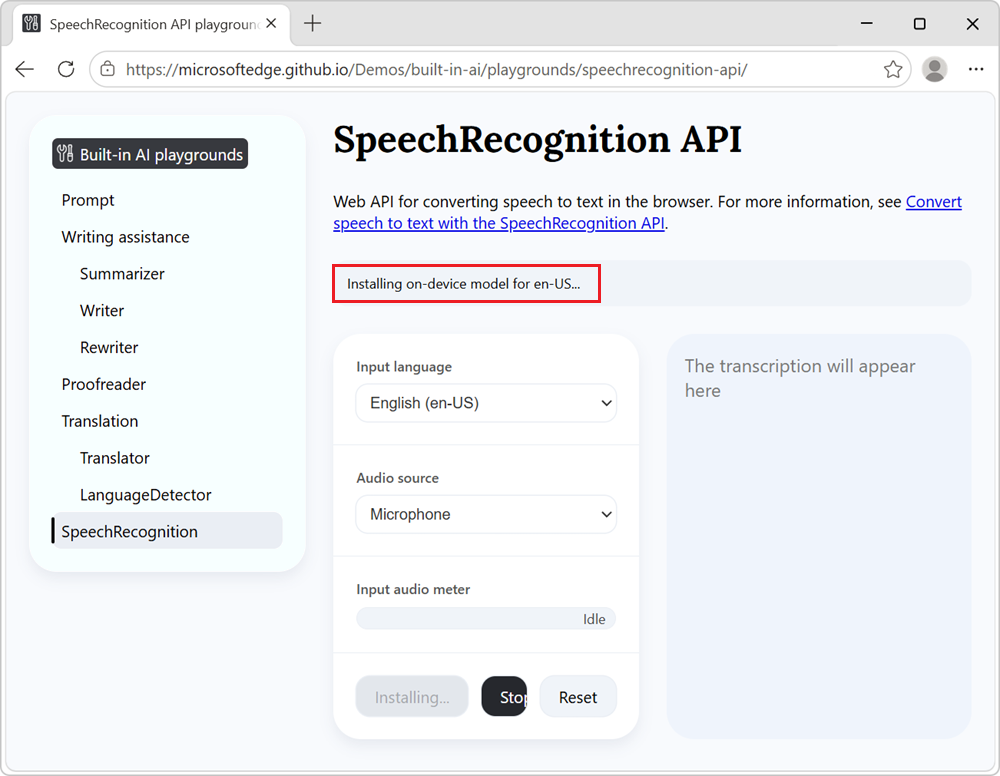
如果您尚未下載所選語言的本機語音辨識模型,則會開始下載並顯示資訊橫幅顯示 安裝 en-US 的裝置上模型...:
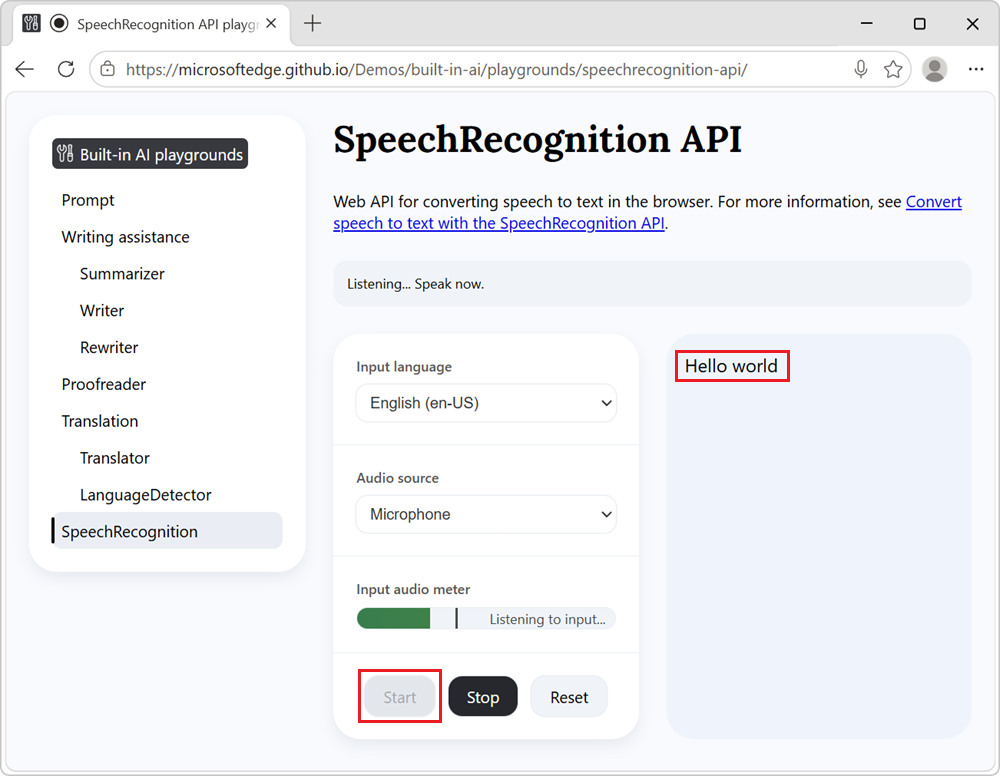
安裝模型之後,文字轉譯會顯示在頁面中:
若要停止將語音轉換成文字,請隨時按一下 [停止 ] 按鈕。
在輸入音訊長時間靜音之後,轉譯也可能會自動停止。
另請參閱:
- /built-in-ai/playgrounds/speechrecognition-api/ - SpeechRecognition API Playground 示範的原始程式碼。
在您的網站中使用具有本機辨識的 SpeechRecognition API
下列各節說明如何在網站的程式碼中使用 SpeechRecognition API 搭配本機語音辨識。 有關 API 本身的詳細資訊,請參閱 MDN 的 Web 語音 API。
檢查是否支援 API,並具現化 SpeechRecognition 物件
若要確保瀏覽器支援 SpeechRecognition API,請測試物件是否 SpeechRecognition 可用:
if (!window.SpeechRecognition) {
  console.log("The SpeechRecognition API is not available in this browser.");
} else {
  console.log("The SpeechRecognition API is available.");
}
如果支援 API,請建立新的 SpeechRecognition 執行個體以開始使用 API:
const recognition = new SpeechRecognition();
另請參閱:
- SpeechRecognition,位於 MDN。
選擇輸入語言並選擇加入本機辨識
若要使用本機模型來設定語音辨識,請指定輸入語言並設定 processLocally 選項:
recognition.lang = "en-US";
recognition.processLocally = true;
本機語音辨識支援下列輸入語言:
- 英文 (en-US)
- 德文 (de-DE)
- 義大利文 (it-IT)
- 葡萄牙文 (pt-PT)
- 西班牙文 (es-ES)
- 韓文 (ko-KR)
語言支援預期將在未來版本中擴大。
也將 和interimResults選項true設定continuous為轉錄長時間的音訊工作階段而不停止並接收中期結果:
recognition.continuous = true;
recognition.interimResults = true;
另請參閱:
- SpeechRecognition: lang property, 位於 MDN。
- SpeechRecognition: processLocally 屬性,位於 MDN。
- SpeechRecognition: continuous property, at MDN.
- SpeechRecognition: interimResults 屬性。
檢查是否已安裝本機模型
開始辨識之前,請使用方法 SpeechRecognition.available() 檢查本機模型是否適用於選取的語言。
如果尚未安裝模型,請使用方法 SpeechRecognition.install() 觸發安裝,等待模型完成後再開始辨識:
async function ensureModelReady(lang) {
  // Check if the model is already available.
  const availability = await SpeechRecognition.available({
    langs: [lang],
    processLocally: true,
  });

  // If the model is already available, proceed to recognition.
  if (availability === "available") {
    return true;
  }

  // If the model is not available but can be downloaded,
  // trigger the installation and wait for it to complete
  // before proceeding to recognition.
  if (availability === "downloadable" || availability === "downloading") {
    const installed = await SpeechRecognition.install({
      langs: [lang],
      processLocally: true,
    });

    if (!installed) {
      throw new Error(`Failed to install local model for ${lang}.`);
    }

    return true;
  }

   return false;
}
當安裝成功或失敗時,所 SpeechRecognition.install() 傳回的 Promise 會解決。
另請參閱:
開始語音辨識
確認 API 和模型都已準備就緒之後,請使用方法 start() 開始辨識。
在呼叫時不帶參數時,方法會 start() 辨識來自使用者麥克風的音訊:
recognition.start();
若要辨識來自媒體檔案的音訊,而不是來自使用者麥克風的音訊,請將實例作為引數start()傳遞MediaStreamTrack給方法。 例如,您可以使用 WebAudio API 建立MediaStreamDestinationNode執行個體,以建立MediaStreamTrack執行個體:
const audioContext = new AudioContext();
const mediaStreamDestination = audioContext.createMediaStreamDestination();
recognition.start(mediaStreamDestination.stream.getAudioTracks()[0]);
另請參閱:
- SpeechRecognition: start () 方法,於 MDN。
- Web 音訊 API,位於 MDN。
明確地停止辨識,並在媒體端停止辨識
若要停止辨識,請使用方法:stop()
recognition.stop();
您也可以使用您做為輸入之媒體元素的事件處理常式,選擇 onended 在媒體輸入結束時停止辨識。 例如,如果您使用 OR HTMLVideoElement 做HTMLAudioElement為音訊來源,可以設定事件處理常式,如下所示:
mediaElement.onended = () => recognition.stop();
另請參閱:
- SpeechRecognition: stop () method, at MDN.
傳送意見反應
我們很想知道您對下列各項的意見反應:
- 本機語音辨識模型。
- 本機語音辨識模型的效能。
- 您希望針對使用案例看到的任何其他改進。
請對 SpeechRecognition API 意見反應問題新增註解,以傳送意見反應。
另請參閱
Microsoft:
MDN:
GitHub: