適用於: SQL ServerAzure SQL DatabaseAzure SQL 受控執行個體Microsoft Fabric 中的 SQL 資料庫
SQL Server 資料庫引擎會處理各種資料儲存結構上的查詢,例如本機資料表、資料分割資料表,以及分散到多部伺服器的資料表。 以下章節將介紹 資料庫引擎 如何處理查詢並透過執行計畫快取優化查詢重用。
本文中的程式碼範例使用 AdventureWorks2025、AdventureWorksDW2025 或 AdventureWorksLT2025 範例資料庫,您可以從 Azure Data SQL Samples 儲存庫 GitHub 儲存庫下載。
執行模式
SQL Server Database Engine 可使用兩種不同的處理模式處理 Transact-SQL(T-SQL)語句:
- 列模式執行
- 批次模式執行
列模式執行
列模式執行 是一種用於資料列存放資料表和索引的查詢處理方法,資料以資料列格式儲存。 當查詢執行並存取列存放資料表與索引中的資料時,執行樹運算子及其子運算子會針對物件結構中指定的所有資料行,讀取每一個所需的資料列。 從讀取的每一列中,資料庫引擎 接著會擷取結果集所需的欄位,如 JOIN陳述式SELECT、謂詞或篩選謂詞所參考。
注意
列模式執行在 OLTP 情境中非常有效率,但在掃描大量資料時,例如資料倉儲情境中效率可能較低。
批次模式執行
批次模式執行 是一種查詢處理方法,會同時處理多列(因此稱為 批次)。 批次內的每個資料行會儲存為不同儲存體區域中的向量,因此批次模式處理是以向量為基礎。 批次模式處理也使用針對先進指令集及現代處理器提升的記憶體吞吐量最佳化的演算法。
批次模式執行最初是圍繞資料行存放區儲存格式整合並最佳化的。 從 SQL Server 2019(15.x)開始,在 Azure SQL Database 中,批次模式執行不需要欄位儲存索引。 如需詳細資訊,請參閱資料列存放區上的批次模式。
批次模式處理在可能的情況下處理壓縮資料,並消除了列模式執行所使用的 交換運算子。 結果是更好的並行性和更快的性能。
當查詢以批次模式執行並存取欄位儲存索引中的資料時,執行樹運算子與子運算子會在欄位區段中一併讀取多個資料列。 資料庫引擎 只讀取結果所需的欄位,這些欄位由 SELECT 語句、JOIN 謂詞或篩選謂詞所參考。 欲了解更多關於欄位儲存索引的資訊,請參閱 欄位儲存索引架構。
注意
批次模式執行對於能夠讀取並彙整大量資料的資料倉庫情境非常有效率。
SQL 陳述式處理
處理單一 T-SQL 語句是 資料庫引擎 執行 T-SQL 語句最基本的方式。 以下步驟透過處理一個僅參考本地基表(無視圖或遠端資料表)的 SELECT 敘述,說明基本流程。
邏輯運算子優先順序
當你在一個語句中使用多個邏輯運算子時,會先評估 NOT,接著評估 AND,最後評估 OR。 算術運算子與位元運算子會先處理,邏輯運算子則後處理。 如需詳細資訊,請參閱運算子優先順序。
以下範例中,色彩條件適用於產品模型 21,而非產品模型 20,因為 AND 優先於 OR。
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR ProductModelID = 21
         AND Color = 'Red';
GO
使用括號,即使在不需要時,也能提升查詢的可讀性,並降低因操作員優先順序而出錯的機率。 以下範例比前一個更容易閱讀,且意義相同。
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR (ProductModelID = 21
          AND Color = 'Red');
GO
您可以加上括號以強迫先評估 OR 來改變查詢的涵義。 下列查詢只會尋找型號 20 和 21 下的紅色產品。
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE (ProductModelID = 20
       OR ProductModelID = 21)
      AND Color = 'Red';
GO
最佳化 SELECT 陳述式
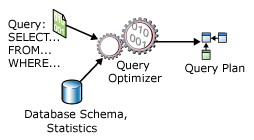
SELECT 陳述式為非程序性,無法敘述資料庫伺服器應用來擷取所需資料的正確步驟。 這種宣告式行為意味著資料庫伺服器必須分析語句與資料庫,以找出最有效率地擷取所要求資料的方法。 這個過程稱為 查詢計畫優化。 執行此任務的元件是查詢優化器(Query Optimizer)。 查詢優化器的輸入包含查詢、資料庫結構(物件定義)及物件統計資料。 查詢優化器的輸出是一個 查詢執行計畫,有時也稱為 查詢計畫 或 執行計畫。 執行計畫的內容在 執行計畫快取與重複使用中有更詳細的說明。
下圖說明查詢優化器在單一 SELECT 語句優化過程中的輸入與輸出:
一個 SELECT 陳述式僅定義:
- 結果集的格式。 這大部份是在選取清單中指定。 不過,其他如
ORDER BY和GROUP BY等子句也會影響結果集的最後格式。 - 包含來源資料的資料表。 這指定於
FROM子句中。 - 資料表如何在邏輯上與
SELECT陳述式的目的產生關聯。 這在連接表達式中定義,該表達式可能出現在WHERE子句中,或在FROM之後的ON子句中。 - 來源資料表中的資料列必須滿足才能符合
SELECT陳述式的條件。 這些條件指定於WHERE和HAVING子句中。
查詢執行計畫定義:
存取來源資料表的順序。
通常,資料庫伺服器可以以多種順序存取基底資料表來建立結果集。 例如,如果
SELECT陳述式參考三個資料表,則資料庫伺服器會先存取TableA、使用TableA中的資料來擷取TableB中相符的資料列,然後使用TableB中的資料來擷取TableC中的資料。 資料庫伺服器可以存取資料表的其他順序如下:TableC、TableB、TableA或
TableB、TableA、TableC或
TableB、TableC、TableA或
TableCTableATableB用來從每個資料表擷取資料的方法。
一般而言,有各種不同的方式可存取每個資料表中的資料。 如果只需要幾個具有特定鍵值的資料列,資料庫伺服器可以快速查找資料列或掃描一小段索引範圍。 如果需要資料表中的所有資料列,資料庫伺服器可以改為掃描整個資料表或索引。 如果資料表中所有資料列都是必需的,但有一個索引,其鍵欄位位於
ORDER BY中,則執行索引掃描而非資料表掃描可能會省去對結果集另外排序。 如果資料表非常小,幾乎所有存取方式,全掃描可能是最有效率的方法。用於進行計算的方法,以及如何篩選、彙總及排序各資料表中的資料。
從資料表存取資料時,不同方法會對資料進行計算,例如計算純量值,並依查詢文本定義彙總與排序資料。 例如,使用
ORDER BY或GROUP BY子句時,以及如何過濾資料,例如使用WHERE或HAVING子句時。
從許多可能的計畫中選擇其中一個執行計畫的程序,便稱為最佳化。 查詢最佳化工具是資料庫引擎中最重要的元件之一。 雖然查詢優化器會使用部分開銷來分析查詢並選擇計畫,但當查詢優化器選擇有效率的執行計畫時,這些開銷通常能獲得數倍回報。 例如,兩家營造公司可能對同一間房屋有相同的藍圖。 如果一家公司在一開始花幾天規劃如何建造房屋,而另一家公司則沒有規劃就開始建造,那麼花時間規劃專案的公司通常會先完成。
查詢優化器是一種基於成本的優化器。 每個可能的執行計畫都有計算所使用資源量的相關成本。 查詢最佳化工具必須分析可能的計畫並選擇最低估計成本的計畫。 有些複雜的語句有成千上萬種可能的執行計畫。 在這些情況中,查詢最佳化工具不會分析所有可能的組合。 相反的,它會使用複雜的演算法來尋找最接近最小可能成本的執行計畫。
查詢優化器不一定會選擇預估成本最低的執行計畫。 它會在可供優化的時間內找到一個具有合理預估成本的計畫。 平行執行計畫可能比串列計畫消耗更多資源,同時縮短預估的經過時間。
SQL Server 查詢優化器在估算從資料表或索引中提取資訊的不同方法的資源成本時,依賴統計數據。 系統會為欄位與索引保留統計資料,並儲存底層資料密度1 的資訊。 這些資訊顯示特定索引或欄位中數值的選擇性。 例如,在表示車種的資料表中,許多車種的製造商都是相同的,但每輛車都有一個唯一的汽車識別號碼。 由於 VIN 的密度比製造商低,因此 VIN 的索引會比製造商的索引更具選擇性。 如果索引統計資料過期,查詢最佳化工具可能無法為資料表的目前狀態做出最佳選擇。 如需密度的詳細資訊,請參閱統計資料。
1 密度會定義資料中唯一值的分佈,或指定資料行中重複值的平均數。 當密度降低時,值的選擇性會增加。
查詢優化器的重要性在於它讓資料庫伺服器能動態調整資料庫中不斷變化的狀況,而無需開發者或資料庫管理員的介入。 此功能使開發者能專注於描述查詢的最終結果。 他們可以信任查詢優化器,每次在陳述式的查詢計畫被優化時,都能針對資料庫的當前狀態建立一個高效的執行計畫。
注意
SQL Server Management Studio 有三個選項可顯示執行計畫:
處理 SELECT 陳述式
資料庫引擎 透過以下步驟處理單一SELECT語句:
- 剖析器會掃描
SELECT陳述式,並將其分成數個邏輯單位,例如關鍵字、運算式、運算子和識別碼。 - 查詢樹,有時稱為序列樹,是用來描述將來源資料轉換為結果集所需格式所需的邏輯步驟。
- 查詢優化器分析存取來源資料表的不同方式。 它選擇能在使用較少資源的情況下,最快回傳結果的步驟序列。 它會更新查詢樹以記錄這一系列的精確步驟。 查詢樹的最後最佳版本就稱為執行計畫。
- 關聯引擎開始執行計畫。 當它處理需要基礎資料表資料的步驟時,會向儲存引擎請求所需的資料列集。
- 關聯式引擎處理從儲存引擎傳回的資料,並將其設定成結果集所定義的格式,然後將結果集傳回給用戶端。
常數摺疊和運算式評估
資料庫引擎會提前評估部分常數運算式,並改善查詢效能。 查詢優化器所採用的優化技術旨在在編譯時簡化表達式,而非在執行時簡化。 它牽涉到在查詢編譯期間評估常數表達式,讓產生的執行計劃更有效率。 這個過程稱為 常數摺疊。 常數是 T-SQL 的字面值,例如 3、'ABC'、'2025-12-31'、1.0e3 或 0x12345678。 例如,考慮這個查詢:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 30 * 12, '2025-01-01');
這裡, 30 * 12 是一個常數表達式。 資料庫引擎 在編譯時會評估此表達式,並可在內部重寫查詢為:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 360, '2025-01-01');
可展開/摺疊的表達式
資料庫引擎 使用常數摺疊,包含以下類型的表達式:
- 只包含常數的算術運算式,例如
1 + 1和5 / 3 * 2。 - 只包含常數的邏輯運算式,例如
1 = 1和1 > 2 AND 3 > 4。 - 資料庫引擎 視為可摺疊的內建函式,包括
CAST和CONVERT。 一般而言,若內在函數僅取決於其輸入,而非其他上下文資訊(如SET選項、語言設定、資料庫選項及加密金鑰),則稱為可摺疊函數。 非決定性函數不可摺疊。 決定性內建函數可摺疊,但有一些例外。 - CLR 使用者定義型別的確定性方法,以及確定性、傳回純量值的 CLR 使用者定義函數。 如需詳細資訊,請參閱 CLR 使用者定義之函式與方法的常數摺疊。
注意
例外之一是大型物件類型。 如果摺疊過程的輸出型態是大型物件型態(text、ntext、image、nvarchar(max)、varchar(max)、varbinary(max)、json 或 xml),資料庫引擎 不會摺疊該表達式。
不可摺疊運算式
所有其他運算式類型都不可摺疊, 尤其是下列運算式類型不可折疊:
- 非常數運算式,例如結果相依於資料行值的運算式。
- 結果相依於本機變數或參數 (例如
@x) 的運算式。 - 非決定性函數。
- 使用者自訂的 T-SQL 函式。
- 結果相依於語言設定的運算式。
- 這些表達式的結果依賴於
SET選項。 - 結果相依於伺服器組態選項的運算式。
可摺疊和不可摺疊常數運算式的範例
請考慮下列查詢:
USE AdventureWorks2025;
GO

SELECT *
FROM Sales.SalesOrderHeader AS s
     INNER JOIN Sales.SalesOrderDetail AS d
         ON s.SalesOrderID = d.SalesOrderID
WHERE TotalDue > 117.00 + 1000.00;
如果 PARAMETERIZATION 資料庫選項未設定為 FORCED,則在查詢編譯前,該表達式 117.00 + 1000.00 會被計算並替換為其結果 1117.00。 這種常數摺疊的好處包括:
- 執行階段不必重複評估運算式。
- 運算式在計算後的值會被查詢優化器用來估計查詢中
TotalDue > 117.00 + 1000.00這一部分的結果集大小。
另一方面,如果dbo.f是使用者定義的純量函數,運算式 dbo.f(100) 不會被摺疊,因為 資料庫引擎 不會摺疊包含使用者定義函數的運算式,即使它們是確定性的。 欲了解更多參數化相關資訊,請參見 強制參數化。
表達式評估
此外,某些運算式不會進行常數摺疊,但它們的引數在編譯時間是已知的,無論這些引數是參數還是常數。這些運算式在最佳化過程中,會由作為最佳化工具一部分的結果集大小(基數)估計器進行評估。
具體來說,如果所有的輸入都是已知的,將會在編譯時評估以下這些內建函式和特殊運算子:UPPER、LOWER、RTRIM、DATEPART( YY only )、GETDATE、CAST 和 CONVERT。 若所有的輸入都是已知的,那麼以下運算子在編譯期間也會被評估:
- 算術運算子:
+,-,*,/,一元- - 邏輯運算子:
AND,OR,NOT - 比較運算子:
<、IS NULL、<=、>=、<>、LIKE、>、IS NOT NULL
在基數估計期間,查詢最佳化工具不會評估任何其他函式或運算子。
編譯時運算式評估的範例
請看此預存程式:
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc
(
    @d DATETIME
)
AS
SELECT COUNT(*)
FROM Sales.SalesOrderHeader
WHERE OrderDate > @d + 1;
在此程序的 SELECT 陳述式最佳化期間,查詢最佳化工具會嘗試評估條件 OrderDate > @d + 1 之結果集的預期基數。 運算式 @d + 1 不是常量折疊,因為 @d 是參數。 然而,在最佳化時間內,此參數的值為已知。 此數值使查詢優化器能準確估算結果集大小,幫助選擇良好的查詢計畫。
現在請考慮一個與前一個類似的範例,不同之處在於,查詢中以區域變數 @d2 取代 @d + 1,而且運算式是在 SET 陳述式中評估,而不是在查詢中。
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc2
(
    @d DATETIME
)
AS
BEGIN
    DECLARE @d2 AS DATETIME;
    SET @d2 = @d + 1;
    SELECT COUNT(*)
    FROM Sales.SalesOrderHeader
    WHERE OrderDate > @d2;
END
當在 MyProc2 中的 SELECT 陳述句在 資料庫引擎 中被優化時,@d2 的值是未知的。 因此,查詢優化器會對 OrderDate > @d2 的選擇性使用預設估計值(此例為 30%)。
處理其他的陳述式
處理 SELECT 陳述式的基本步驟適用於其他 T-SQL 語句,如 INSERT、UPDATE 和 DELETE。
UPDATE 和 DELETE 語句都必須針對要修改或刪除的資料列集合。 識別這些資料列的處理序,與用以識別參與 SELECT 陳述式結果集之來源資料列的處理序相同。
UPDATE 和 INSERT 語句都可能包含內嵌 SELECT 語句,提供要更新或插入的資料值。
即使是資料定義語言(DDL)陳述式,如 CREATE PROCEDURE 或 ALTER TABLE,也會轉換成系統目錄資料表上的一系列關聯操作,有時(如 ALTER TABLE ADD COLUMN)也會針對資料表進行操作。
工作資料表
關聯式引擎可能需要建立工作資料表來執行 T-SQL 陳述式中指定的邏輯操作。 工作資料表是內部用來存放中間結果的表格。 工作資料表會針對特定的 GROUP BY、 ORDER BY或 UNION 查詢而產生。 例如,如果某 ORDER BY 個子句參考的欄位未被任何索引覆蓋,關聯引擎可能需要產生工作資料表,將結果集依請求順序排序。 工作資料表有時也用作暫存區,暫時保存執行查詢計劃部分的結果。 工作台會在 tempdb 中建立,當不再需要時會自動丟棄。
檢視解析度
資料庫引擎 查詢處理器對索引與非索引檢視有不同處理:
- 資料庫以與資料表相同的格式儲存索引檢視的列。 如果查詢優化器決定在查詢計畫中使用索引檢視,它會將索引檢視視為基底資料表。
- 只會儲存非索引檢視的定義,而不會儲存檢視的資料列。 查詢優化器將視圖定義的邏輯整合到它為參考非索引視圖的 T-SQL 陳述式所建立的執行計畫中。
查詢優化器用來決定何時使用索引檢視的邏輯,類似於決定何時在資料表上使用索引的邏輯。 如果索引檢視中的資料涵蓋了 T-SQL 陳述式的全部或部分內容,且查詢優化器判定檢視上的某個索引是低成本存取路徑,則無論查詢是否以名稱參考該檢視,都會選擇該索引。
當 T-SQL 陳述式參考非索引檢視時,解析器與查詢優化器會分析 T-SQL 陳述式與檢視的來源,並將兩者化簡為單一執行計畫。 T-SQL 陳述句和視圖沒有分開的執行計畫。
例如,請考慮下列觀點:
USE AdventureWorks2025;
GO

CREATE VIEW EmployeeName AS
    SELECT h.BusinessEntityID,
           p.LastName,
           p.FirstName
    FROM HumanResources.Employee AS h
         INNER JOIN Person.Person AS p
             ON h.BusinessEntityID = p.BusinessEntityID;
GO
根據此觀點,這兩個 T-SQL 陳述式對基底資料表執行相同的操作,並產生相同的結果:
USE AdventureWorks2025;
GO

/* SELECT referencing the EmployeeName view. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM Sales.SalesOrderHeader AS soh
     INNER JOIN dbo.EmployeeName AS EmpN
         ON (soh.SalesPersonID = EmpN.BusinessEntityID)
WHERE OrderDate > '20230531';

/* SELECT referencing the Person and Employee tables directly. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM HumanResources.Employee AS e
     INNER JOIN Sales.SalesOrderHeader AS soh
         ON soh.SalesPersonID = e.BusinessEntityID
     INNER JOIN Person.Person AS p
         ON e.BusinessEntityID = p.BusinessEntityID
WHERE OrderDate > '20230531';
SQL Server Management Studio(SSMS)的 Showplan 功能顯示,關聯引擎對這SELECT兩個語句建置相同的執行計畫。
搭配檢視使用提示
如果你在查詢中的檢視上放置提示,可能會與檢視展開存取基底資料表時發現的其他提示發生衝突。 當發生此衝突時,查詢會回傳錯誤。 例如,請考慮下列在其定義中包含資料表提示的檢視:
USE AdventureWorks2025;
GO

CREATE VIEW Person.AddrState
WITH SCHEMABINDING AS
    SELECT a.AddressID,
           a.AddressLine1,
           s.StateProvinceCode,
           s.CountryRegionCode
    FROM Person.Address AS a WITH (NOLOCK), Person.StateProvince AS s
    WHERE a.StateProvinceID = s.StateProvinceID;
現在假設您輸入以下查詢:
SELECT AddressID,
       AddressLine1,
       StateProvinceCode,
       CountryRegionCode
FROM Person.AddrState WITH (SERIALIZABLE)
WHERE StateProvinceCode = 'WA';
查詢失敗,因為 Person.AddrState 視圖上的 SERIALIZABLE 提示在展開時會同時傳播到視圖中的 Person.Address 和 Person.StateProvince 資料表。 不過,擴展視圖也會在 NOLOCK 上顯示 Person.Address 提示。 由於 SERIALIZABLE 提示與 NOLOCK 提示相衝突,因此會產生不正確的查詢。
PAGLOCK、NOLOCK、ROWLOCK、TABLOCK 和 TABLOCKX 表格提示彼此衝突,而 NOLOCK、READCOMMITTED、REPEATABLEREAD、SERIALIZABLE 和 HOLDLOCK 表格提示也彼此衝突。
提示可以透過巢狀檢視層級來傳播。 例如,假設查詢在 HOLDLOCK 檢視表中套用 v1提示。 當 v1 展開時,你會發現該檢視 v2 是其定義的一部分。
v2的定義包括其中一個基底資料表上的 NOLOCK 提示。 但此資料表也會繼承來自檢視表HOLDLOCK的查詢v1提示。 因為 NOLOCK 與 HOLDLOCK 提示相衝突,所以查詢會失敗。
當你在包含視圖的查詢中使用 FORCE ORDER 提示時,視圖在有序結構中的位置決定了視圖內資料表的連接順序。 例如,下列查詢會從三個資料表和一個檢視中選取:
SELECT * FROM Table1, Table2, View1, Table3
WHERE Table1.Col1 = Table2.Col1
    AND Table2.Col1 = View1.Col1
    AND View1.Col2 = Table3.Col2;
OPTION (FORCE ORDER);
且 View1 定義如下範例所示:
CREATE VIEW View1 AS
    SELECT Colx,
           Coly
    FROM TableA, TableB
    WHERE TableA.ColZ = TableB.Colz;
查詢計畫中的聯結順序為 Table1、 Table2、 TableA、 TableB、 Table3。
解析檢視表上的索引
如同任何索引,資料庫引擎 只有在查詢優化器認為有利時,才會選擇在查詢計畫中使用索引檢視。
你可以在任何版本的 資料庫引擎 中建立索引檢視。 在某些版本中,查詢優化器會自動考慮索引檢視,而在其他版本則需要使用 NOEXPAND 資料表提示。 查詢優化器自動使用索引檢視的功能僅在 SQL Server 的特定版本中受支援。
注意
Azure SQL Database 和 Azure SQL 受控實例支持自動使用索引檢視,而不需指定 NOEXPAND 提示。
當符合以下條件時,查詢優化器會使用索引檢視:
- 下列工作階段選項會設定為
ON:ANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLQUOTED_IDENTIFIER
-
NUMERIC_ROUNDABORT會話選項設定為OFF。 - 查詢優化器會找出檢視索引欄位與查詢中元素之間的相符項目,例如:
- 在
WHERE子句中的搜尋條件謂詞 - 合併操作
- 彙總函式
-
GROUP BY子句 - 資料表參考
- 在
- 使用索引的預估成本是查詢最佳化工具考量的所有存取機制中最低的。
- 在對應於索引檢視中之資料表參考的查詢中,每個參考的資料表 (直接參考,或藉由展開檢視以存取其基礎資料表) 都必須在查詢中套用同一組提示。
注意
無論目前的交易隔離等級為何,在此內容中,永遠都會將 READCOMMITTED 和 READCOMMITTEDLOCK 提示視為不同的提示。
除了 SET 選項與資料表提示的需求以外,這些也是查詢最佳化工具用來判斷資料表索引是否涵蓋查詢的相同規則。 你不需要在查詢中指定其他內容,就會使用索引檢視。
查詢不一定要在 FROM 子句中明確參考索引檢視表,才能讓最佳化工具使用索引檢視表。 如果查詢中包含了基底資料表中的資料行的參考,而這些資料行也同時出現於索引檢視中,且最佳化工具的估計結果是使用索引檢視提供最低成本的存取機制,那麼最佳化工具便選擇索引檢視,這和查詢中並未直接參考基底資料表的索引時,最佳化工具選擇這些索引的方式類似。 當檢視包含查詢所未參考到的資料行,只要檢視針對涵蓋在查詢中所指定的一個或多個資料行提供最低的成本選項,最佳化工具可能就會選擇該檢視。
查詢最佳化工具會將 FROM 子句中參考的索引檢視表視為標準檢視表。 在最佳化程序開始時,查詢最佳化工具會將檢視的定義擴充到查詢中。 接著,會執行索引檢視比對。 索引檢視表可用在查詢最佳化工具所選取的最終執行計畫中,或者,此計畫可存取檢視表所參考的基底資料表,藉以從檢視表具體化必要的資料。 查詢最佳化工具會選擇成本最低的方式。
搭配索引檢視表使用提示
您可以使用 EXPAND VIEWS 查詢提示來防止在查詢中使用檢視表索引,或者可以使用 NOEXPAND 資料表提示,針對查詢的 FROM 子句所指定的索引檢視表強制使用索引。 然而,您應該讓查詢最佳化工具動態判斷每個查詢最適用的存取方法。 只有在測試已顯現出其大幅改善效能的特定情況下,才能使用 EXPAND 和 NOEXPAND 。
EXPAND VIEWS選項指定查詢最佳化工具在整個查詢中不會使用任何檢視表索引。當你指定
NOEXPAND一個檢視時,查詢優化器會考慮使用檢視上定義的任何索引。 指定NOEXPAND並透過選擇性的INDEX()子句,強制查詢優化器使用指定的索引。 你只能對已建立索引的檢視指定NOEXPAND,且不能對未建立索引的檢視指定。 查詢優化器自動使用索引檢視的功能僅在特定版本的 SQL Server 中受到支援。注意
Azure SQL Database 和 Azure SQL 受控實例支持自動使用索引檢視,而不需指定
NOEXPAND提示。
如果未在含有檢視表的查詢中指定 NOEXPAND 或 EXPAND VIEWS ,即會展開檢視表以存取基礎資料表。 若構成檢視的查詢中含有任何資料表提示,這些提示便會傳播到基礎資料表。 (此過程在 檢視表解析中有更詳細說明。)只要檢視表底層資料表上的提示集合彼此相同,查詢即可與索引檢視表相符。 大多數時候,這些提示彼此吻合,因為它們是直接從檢視繼承而來的。 然而,若查詢參考資料表 (而非檢視表) 以及直接套用於這些資料表的提示不相同,這種查詢將無法與索引檢視表進行比對。 若 INDEX、PAGLOCK、ROWLOCK、TABLOCKX、UPDLOCK 或 XLOCK 提示會在檢視表展開後套用到查詢中所參考的資料表,查詢就無法與索引檢視表進行比對。
如果格式為 INDEX ( index_val [ ,...n] ) 的資料表提示會參考查詢中的檢視表,而您也未指定 NOEXPAND 提示,則會忽略索引提示。 若要指定使用特定的索引,請使用 NOEXPAND。
一般而言,當查詢優化器將索引檢視與查詢匹配時,會直接將查詢中表格或檢視中指定的提示套用到索引檢視上。 如果查詢優化器選擇不使用索引視圖,它會將任何提示直接傳播到視圖中所參考的資料表。 欲了解更多資訊,請參閱 「檢視解析度」。 這種傳播方式不適用於聯接提示。 它們僅適用於查詢語句中的原始位置。 查詢優化器在將查詢與索引檢視匹配時,並不會考慮連接提示。 若查詢計畫所使用的索引檢視表符合含有聯結提示的部分查詢,則計畫中不會使用此聯結提示。
不允許在索引檢視表的定義中使用提示。 資料庫引擎 在維護索引檢視定義時,或執行使用索引檢視的查詢時,會忽略其內部的提示。
如需詳細資訊,請參閱 表格提示。
解決分散式分割檢視
資料庫引擎 查詢處理器優化分散式分割檢視的效能。 分散式資料分割檢視效能最重要的一點,便是將在成員伺服器間傳輸的資料量最小化。
資料庫引擎 建立智慧且動態的計畫,有效利用分散式查詢存取遠端成員資料表的資料:
- 查詢處理器會先使用 OLE DB 來擷取各成員資料表中的 CHECK 條件約束定義。 此方法允許查詢處理器映射成員資料表之間的鍵值分布。
- 查詢處理器會將 T-SQL 陳述句
WHERE中指定的金鑰範圍與顯示列在成員資料表中分布的映射進行比較。 查詢處理器接著建立一個查詢執行計畫,利用分散式查詢只檢索完成 T-SQL 陳述句所需的遠端列。 執行計畫也以這種方式建置,使得對遠端成員資料表的任何存取(無論是資料或中繼資料)都會延後,直到需要該資訊時為止。
例如,假設系統中的 Customers 資料表是跨 Server1 (從 1 到 3299999 的 CustomerID)、Server2 (從 3300000 到 6599999 的 CustomerID),以及 Server3 (從 6600000 到 9999999 的 CustomerID) 進行資料分割。
請考慮針對這個在 Server1 上執行之查詢所建置的執行計畫:
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID BETWEEN 3200000 AND 3400000;
這個查詢的執行計畫會擷取本機成員資料表中 CustomerID 索引鍵值從 3200000 到 3299999 之間的資料列,並提交分散式查詢以擷取 Server2 中索引鍵值從 3300000 到 3400000 之間的資料列。
資料庫引擎 查詢處理器也能將動態邏輯納入查詢執行計畫中,針對在必須建立計畫時尚未確定關鍵值的 T-SQL 語句。 例如,請參考這個預存程序:
CREATE PROCEDURE GetCustomer
(
    @CustomerIDParameter INT
)
AS
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID = @CustomerIDParameter;
資料庫引擎 無法預測每次執行程序時,@CustomerIDParameter參數會提供哪個鍵值。 由於無法預測金鑰值,查詢處理器也無法預測要存取哪個成員資料表。 為了處理這種情況,資料庫引擎 建立一個執行計畫,該計畫包含條件邏輯,稱為動態過濾器,用以控制根據輸入參數值存取哪個成員資料表。 假設 GetCustomer 儲存程序是在 Server1 上執行,執行計畫邏輯可如以下輸出所示表示:
IF @CustomerIDParameter BETWEEN 1 and 3299999
   Retrieve row from local table CustomerData.dbo.Customer_33
ELSE IF @CustomerIDParameter BETWEEN 3300000 and 6599999
   Retrieve row from linked table Server2.CustomerData.dbo.Customer_66
ELSE IF @CustomerIDParameter BETWEEN 6600000 and 9999999
   Retrieve row from linked table Server3.CustomerData.dbo.Customer_99
資料庫引擎 有時甚至會為未參數化的查詢建立這類動態執行計畫。 查詢最佳化工具可能會參數化查詢以重複使用執行計畫。 如果查詢優化器參數化了參考分割檢視的查詢,查詢優化器就無法再假設所需的資料列來自指定的基底表。 接著必須在執行計畫中使用動態過濾器。
儲存程序與觸發器執行
資料庫引擎 僅儲存儲存程序與觸發器的原始碼。 當先執行預存程序或觸發程序時,會將來源編譯成執行計畫。 如果在執行計畫從儲存體中淘汰之前,再執行一次預存程序或觸發程序,關聯式引擎會偵測到現有的計畫並重複使用它。 如果計畫從記憶體中淘汰,會重新建立新的計畫。 此過程與 資料庫引擎 對所有 T-SQL 語句所遵循的流程相似。 與動態 T-SQL 批次相比,資料庫引擎 中儲存程序與觸發器的主要效能優勢在於它們的 T-SQL 語句始終相同。 因此,關聯式引擎可以輕易地將這些陳述式與任何現有的執行計畫配對。 就可以輕易地重複使用預存程序及觸發程序計畫
預存程序和觸發程序的執行計畫會與呼叫預存程序或觸發觸發程序的批次執行計畫分開執行。 這種分離允許更廣泛地重用儲存程序與觸發程序執行計畫。
執行計畫快取與重複使用
資料庫引擎 使用記憶體來儲存執行計畫與資料緩衝區。 分配給執行計畫或資料緩衝區的記憶體比例會根據系統狀態動態調整。 儲存執行計畫的記憶體部分稱為 計畫快取。
計畫快取存放區
計劃快取擁有兩個用於存放經編譯計劃的存儲區:
- 物件計畫快取儲存庫(OBJCP),用於與持續性物件相關的計畫,例如儲存程序、函式與觸發器。
- SQL 計畫快取儲存庫(SQLCP),儲存與自動參數化、動態或預先準備查詢相關計畫的快取儲存庫。
以下查詢提供這兩個快取儲存的記憶體使用資訊:
SELECT *
FROM sys.dm_os_memory_clerks
WHERE name LIKE '%plans%';
計畫快取還有兩個額外的儲存,但它們不會儲存計畫:
- Bound Trees 快取存放區 (PHDR),用於在查詢計劃編譯期間用於視圖、限制與預設值的資料結構。 這些結構稱為 bound trees 或 algebrizer trees。
- 擴充儲存程序快取儲存庫(XPROC),用於預定義的系統程序,如sp_executesql或xp_cmdshell。 這些儲存程序使用 DLL 取代 T-SQL 語句。 快取結構僅包含函式名稱及實作該程序所在的 DLL 名稱。
執行計畫元件
資料庫引擎 執行計畫包含以下主要元件:
編譯計畫(或查詢計畫)
編譯程序產生的查詢計畫,大多是可重複使用的唯讀資料結構,可供任意數量的使用者使用。 該計畫會儲存下列資訊:
實體運算子會實作邏輯運算子所描述的作業。
這些運算子的順序,決定資料存取、篩選及彙總的順序。
預估會流經運算子的資料列數。
注意
查詢計畫同時儲存用於 基數評估 的統計物件資訊。
查詢計畫不會儲存任何使用者上下文或執行時資訊。 資料庫引擎 每次從計畫快取取得計畫時,會決定工作執行緒的數量。 快取的平行計畫也可以串列執行。
執行環境
目前執行查詢的每位使用者都有一個資料結構,儲存與其執行相關的資料,例如參數值。 此資料結構稱為 執行上下文。 執行上下文資料結構會被重複使用,但其內容不會。 若其他使用者操作相同的查詢,將會為新使用者的上下文重新初始化資料結構。
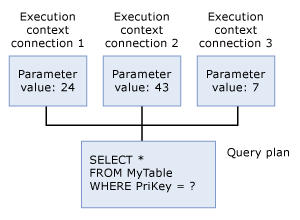
相同陳述式的重複使用計畫
當 資料庫引擎 執行任何 T-SQL 語句時,會先檢查計畫快取,確認同一 T-SQL 語句是否存在已存在的執行計畫。 如果 T-SQL 陳述句能逐字元匹配先前已執行且具有快取計畫的 T-SQL 陳述句,則該陳述句即被視為存在。 資料庫引擎 會重用它找到的任何現有計畫,節省重新編譯 T-SQL 陳述式的開銷。 若無執行計畫,資料庫引擎 會為查詢產生新的執行計畫。
注意
計畫快取不會持久化某些 T-SQL 語句的執行計畫,例如在列儲存中執行的 bulk 操作語句或包含大型字串字面量的語句。 這些執行方案僅在查詢執行期間存在。
資料庫引擎 採用高效的演算法,找出任何特定 T-SQL 陳述式是否已有執行計畫。 在大多數系統中,這種掃描所消耗的最小資源,比透過重複使用現有計畫而非編譯每個 T-SQL 語句所節省的資源還要少。
將新的 T-SQL 語句與計畫快取中現有未使用的執行計畫匹配的演算法要求所有物件參考都必須完全限定。 例如,假設 Person 是執行下列 SELECT 陳述式之使用者的預設結構描述。 雖然這個範例不需要你完全限定 Person 表格才能執行,但代表第二個陳述式與現有的執行計畫不符,但第三個陳述式則符合:
USE AdventureWorks2025;
GO

SELECT *
FROM Person;
GO

SELECT *
FROM Person.Person;
GO

SELECT *
FROM Person.Person;
GO
更改以下SET任一執行選項會影響重複使用計畫的能力,因為資料庫引擎會執行常數摺疊,而這些選項會影響這類運算式的結果:
ANSI_DEFAULTSANSI_NULL_DFLT_OFFANSI_NULL_DFLT_ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLDATEFIRSTDATEFORMATFORCEPLANLANGUAGENO_BROWSETABLENUMERIC_ROUNDABORTQUOTED_IDENTIFIER
為相同的查詢快取多個計畫
查詢與執行計畫在資料庫引擎中都是獨一無二的,與指紋非常類似:
- 查詢計畫雜湊是針對指定查詢之執行計畫計算所得的二進位雜湊值,可用於專門識別類似的執行計畫。
- 查詢雜湊值是根據查詢的 T-SQL 文本計算的二進位雜湊值,用來唯一識別查詢。
你可以透過計畫 控制代碼從計畫快取中取得編譯好的計畫。 這個暫態識別碼只有在計畫仍留在快取中時才會保持不變。 計畫識別碼是從整個批次中經過編譯之計畫衍生而來的雜湊值。 已編譯計畫的計畫控制代碼即使在批次中的一個或多個敘述重新編譯後,仍會保持不變。
注意
如果你編譯的是批次計畫而非單一語句,你可以利用計畫 handle 和語句偏移量來取得批次中個別語句的計畫。
sys.dm_exec_requests DMV 包含每筆紀錄的 statement_start_offset 和 statement_end_offset 欄位。 這些欄位指的是正在執行的批次或持久物件的當前執行陳述式。 如需詳細資訊,請參閱 sys.dm_exec_requests。
sys.dm_exec_query_stats DMV 也會為每條紀錄列出這些欄位。 這些欄位指的是陳述式在批次或持久物件中的位置。 如需詳細資訊,請參閱 sys.dm_exec_query_stats。
批次的實際 T-SQL 文字會儲存在與計畫快取不同的記憶體空間中,稱為 SQL Manager 快取(SQLMGR)。 你可以透過 SQL handle 從 SQL Manager 快取中取得編譯計畫的 T-SQL 文字。 這個暫態識別碼只有在至少有一個參考它的計畫仍存在於計畫快取中時才保持不變。 SQL 句柄是從整個批次文本中推導出的雜湊值,且保證對每個批次而言都是唯一的。
注意
如同編譯後的查詢計畫,T-SQL 文字會針對每個批次分別儲存,包括註解。 SQL 控制代碼包含整個批次文字的 MD5 雜湊值,且保證對於每個批次都是唯一的。
以下查詢提供 SQL Manager 快取記憶體使用情況:
SELECT *
FROM sys.dm_os_memory_objects
WHERE type = 'MEMOBJ_SQLMGR';
一個 SQL handle 與多個 plan handle 之間存在對應關係。 當已編譯計畫的快取金鑰不同時,會發生此狀況。 此差異可能是因為同一批次兩次執行間 SET 選項的變更所致。
請考慮下列預存程序:
USE WideWorldImporters;
GO

CREATE PROCEDURE usp_SalesByCustomer
(
    @CID INT
)
AS
SELECT *
FROM Sales.Customers
WHERE CustomerID = @CID;
GO

SET ANSI_DEFAULTS ON;
GO

EXECUTE usp_SalesByCustomer 10;
GO
請使用以下查詢確認你在計畫快取中能找到的內容:
SELECT cp.memory_object_address,
       cp.objtype,
       refcounts,
       usecounts,
       qs.query_plan_hash,
       qs.query_hash,
       qs.plan_handle,
       qs.sql_handle
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle)
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle)
     INNER JOIN sys.dm_exec_query_stats AS qs
         ON qs.plan_handle = cp.plan_handle
WHERE text LIKE '%usp_SalesByCustomer%';
GO
結果集如下所示。
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
現在以不同參數執行儲存程序,且不更改執行上下文:
EXECUTE usp_SalesByCustomer 8;
GO
再確認你在執行計畫快取中能找到什麼。 結果集如下所示。
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
注意值 usecounts 增加到 2,表示相同的快取計畫會原樣重複使用,因為執行上下文資料結構會被重複使用。 現在更改 SET ANSI_DEFAULTS 選項,並使用相同的參數執行儲存程序。
SET ANSI_DEFAULTS OFF;
GO

EXECUTE usp_SalesByCustomer 8;
GO
再確認你在計畫快取中能找到什麼。 結果集如下所示。
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CD01DEC060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02B031F111CD01000001000000000000000000000000000000000000000000000000000000
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
請注意,現在 sys.dm_exec_cached_plans DMV 輸出中有兩個項目:
- 欄位
usecounts顯示第一筆記錄中的值1。 此值代表使用SET ANSI_DEFAULTS OFF執行一次的計畫。 - 欄位
usecounts顯示第二筆記錄中的值2。 此值代表以SET ANSI_DEFAULTS ON執行的計畫,因為該計畫已執行兩次。 - 不同的
memory_object_address指向計畫快取中的不同執行計畫項目。 但這兩個項目因為參考了同一批次,所以兩者的sql_handle值都相同。- 將
ANSI_DEFAULTS設為OFF的執行有新的plan_handle,且可供具有相同SET選項集的呼叫重複使用。 新的計畫句柄是必要的,因為執行上下文因選項變更SET而被重新初始化。 但這個變更不會觸發重新編譯:兩個條目都指向相同的計畫和查詢,從相同的query_plan_hash和query_hash值可見一斑。
- 將
這種情況代表快取中有兩個計畫條目對應同一批次。 這強調了確保在重複執行相同查詢時,影響 SET 選項的計畫快取相同的重要性。 此方法優化計畫重用,並將計畫快取大小維持在所需最小值。
提示
一個常見的陷阱是不同客戶的選項預設值 SET 可能不同。 例如,透過 SQL Server Management Studio 建立的連線會自動設QUOTED_IDENTIFIER為 ON,而 SQLCMD 則設QUOTED_IDENTIFIER為 OFF。 從這兩個用戶端執行相同的查詢會產生多個計畫(如前述範例所述)。
從計畫快取中移除執行計畫
只要有足夠的記憶體可儲存這些執行計畫,執行計畫就會留在計畫快取中。 當記憶體壓力存在時,SQL Server Database Engine 會採用成本為基礎的方法來決定哪些執行計畫要從計畫快取中移除。 為了做出基於成本的決策,SQL Server Database Engine 會根據以下因素,為每個執行計畫調整一個當前成本變數。
當使用者程序將執行計畫插入快取時,使用者程序會設定當前成本等於原始查詢編譯成本。 對於臨時執行計畫,使用者程序會將目前成本設為零。 之後,每次使用者程序參考執行計畫時,都會將目前成本重設為原始編譯成本。 對於臨時執行計畫,使用者程序會增加目前成本。 對於所有計畫而言,目前成本的最大值就是原始編譯成本。
當記憶體壓力存在時,SQL Server Database Engine 會從計畫快取中移除執行計畫。 為了判斷要移除哪些計畫,SQL Server 資料庫引擎會重複檢查每個執行計畫的狀態,然後移除目前成本為零的計畫。 當前成本為零的執行計畫在記憶體壓力存在時不會被自動移除。 只有當 SQL Server Database Engine 檢查計畫且目前成本為零時,才會被移除。 檢查執行計畫時,如果查詢目前未使用該計畫,SQL Server 資料庫引擎就會減少目前成本,藉此將目前成本推向零。
SQL Server Database Engine 會持續檢查執行計畫,直到移除足夠的計畫以滿足記憶體需求。 當記憶體壓力存在時,執行計畫可能會多次增加和減少其成本。 當記憶體壓力不再存在時,SQL Server Database Engine 會停止降低未使用之執行計畫的目前成本。 所有執行計畫都會保留在計畫快取中,即使其成本為零。
為了回應記憶體壓力,SQL Server 資料庫引擎使用資源監視器和用戶工作執行緒來釋放計劃快取中的記憶體。 資源監控與使用者工作執行緒可同時檢視計畫,以降低每個未使用的執行計畫的當前成本。 當全域記憶體壓力存在時,資源監視器就會從計畫快取中移除執行計畫。 它會釋放記憶體,以便強制執行系統儲存體、處理序記憶體、資源集區記憶體和所有快取大小上限的原則。
所有快取大小上限是緩衝集區大小的函數,而且不能超過伺服器儲存體的最大值。 如需更多關於設定最大伺服器記憶體的資訊,請參閱 max server memory 中的 sp_configure 設定。
當存在單一的快取記憶體壓力時,使用者工作執行緒會從計畫快取中移除執行計畫。 它們會強制執行最大單一快取大小和最大單一快取項目的原則。
下列範例說明要從計畫快取中移除哪些執行計畫:
- 執行計畫經常被參考,所以它的成本永遠都不會變成零。 計畫會留在計畫快取中,只有在有記憶體壓力且目前成本為零時,才會被移除。
- 系統會插入特定執行計畫,但在記憶體壓力存在之前,不會再次參考該計畫。 由於臨時計畫在初始化時目前成本為零,當 SQL Server Database Engine 檢查執行計畫時,會看到目前成本為零,並將計畫從計畫快取中移除。 當記憶體壓力不存在時,臨時執行計畫會以零目前成本保留在計畫快取中。
若要手動從快取中移除單一計畫或所有計畫,請使用 DBCC FREEPROCCACHE。 你也可以使用 DBCC FREESYSTEMCACHE 來清除任何快取,包括計畫快取。 SQL Server 2016(13.x)及更新版本,使用 ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE 來清除範圍內資料庫的程序(計畫)快取。
透過 sp_configure 與 reconfigure 改變某些設定,也會導致計畫從計畫快取中移除。 您可在 DBCC FREEPROCCACHE 一文其<備註>一節中找到這些組態設定的清單。 當您進行此配置變更時,以下資訊訊息會寫入錯誤日誌:
SQL Server has encountered %d occurrence(s) of cachestore flush for the '%s' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
重新編譯執行計畫
資料庫中的某些變更可能會使執行計畫變得低效率或無效。 資料庫引擎 會偵測這些變更,並將該計畫標記為無效。 然後系統會根據執行查詢的下一個連接,重新編譯新的計畫。 使計畫無效的條件包括:
- 查詢(
ALTER VIEW和ALTER TABLE)所參考的資料表或檢視的變更。 - 變更單一程序,會將該程序的所有計畫自快取中捨棄(
ALTER PROCEDURE)。 - 對執行計畫所使用之任何索引所做的變更。
- 執行計畫所使用的統計資料更新,不論是由如
UPDATE STATISTICS的陳述句明確產生,或是自動產生。 - 移除執行計畫所使用的索引。
- 明確呼叫
sp_recompile。 - 對索引鍵所做的大量變更 (由
INSERT或DELETE陳述式所產生,而這類陳述式是來自其他修改查詢所參考之資料表的使用者)。 - 對於含有觸發程序的資料表,是指插入或刪除資料表中的資料列數目有顯著增加的情況。
- 透過使用 選項
WITH RECOMPILE執行儲存程序。
大多數重新編譯是為了語句正確性或可能更快的查詢執行計畫所必需。
當批次中的某個陳述句觸發重新編譯時,只有該陳述句會被重新編譯,而非整個批次。 此規則適用於批次是透過儲存程序、觸發器、臨時批次或預備語句提交。
語句層級的重新編譯有助於提升效能,因為在大多數情況下,只有少量語句會導致重新編譯及其相關的 CPU 時間與鎖定損失。 因此,批次中其他不需要重新編譯的語句則可避免這些效能損失。
sql_statement_recompile 擴充事件 (XEvent) 用來報告語句層級的重新編譯。 當任何類型的批次需要語句層級重新編譯時,就會發生此 XEvent。 此需求包含儲存程序、觸發器、臨時批次及查詢。 批次可透過多種介面提交,包括 sp_executesql、動態 SQL、準備方法或執行方法。
recompile_cause XEvent 的sql_statement_recompile欄位包含一個整數碼,指出重新編譯的原因。 以下列出可能的原因:
- 游標選項已變更
- 延遲編譯
-
FOR BROWSE權限已變更 -
OPTION (RECOMPILE)要求的 - 參數化方案已清除
- 分區檢視已變更
- 影響資料庫版本的計畫已變更
- 查詢通知環境已變更
- 查詢存放區缺失執行計畫
- 強制執行查詢存放區計畫失敗
- 查詢存放區計畫強制策略已更改
- 遠端資料列集已變更
- 結構已變更
-
SET選項變更 - 統計資料已變更
- 暫存資料表已變更
注意
當您將 AUTO_UPDATE_STATISTICS 資料庫選項設為 ON 時,若查詢的目標是其統計資料已更新,或自上次執行後其基數已顯著變更的資料表或已建立索引的檢視,則查詢會重新編譯。 此行為適用於標準使用者定義的資料表、暫存資料表,以及 DML 觸發程序所建立的插入和刪除資料表。
將 AUTO_UPDATE_STATISTICS 設為 OFF 可以停止這些重新編譯,但過時的統計通常比重新編譯更會降低查詢效能。 欲了解更多資訊,請參閱 AUTO_UPDATE_STATISTICS 選項。 DML INSTEAD OF 觸發器的 inserted 與 deleted 資料表皆建立於 tempdb,因此它們遵循 tempdb 的 AUTO_UPDATE_STATISTICS 設定。
使用明確參數來重用查詢計劃
使用參數,包括在 ADO.NET 應用程式中的命名參數,以及 OLE DB 和 ODBC 應用程式中的參數標記,可以增加執行計畫的重複使用率。
警告
透過測試類型、長度、格式和範圍,始終驗證使用者輸入。 如需詳細資訊,請參閱 SQL 插入。
下列這兩個 SELECT 陳述式的唯一差異在於 WHERE 子句中所比較的值:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
這些查詢執行計畫間唯一的差異在於用於與 ProductSubcategoryID 資料行進行比較的儲存值。 雖然目標是讓 資料庫引擎 始終識別這些語句產生的計畫本質上相同並重用這些計畫,但 資料庫引擎 有時無法在複雜的 T-SQL 語句中偵測到這種相似性。
透過參數將常數與 T-SQL 陳述式分離,有助於關聯式引擎辨識重複計畫。 參數可透過以下方式使用:
在 T-SQL 中,請使用
sp_executesql:DECLARE @MyIntParm AS INT; SET @MyIntParm = 1; EXECUTE sp_executesql N'SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = @Parm', N'@Parm INT', @MyIntParm;此方法建議用於 T-SQL 腳本、儲存程序或動態產生 SQL 語句的觸發器。
ADO.NET 搭配
SqlClient使用命名參數,例如@Parm。 OLE DB 和 ODBC 使用參數標記。 參數標記是問號(?),用來取代 SQL 陳述式中的常數,並繫結至程式變數。 例如,您可以在 ODBC 應用程式中執行下列動作:使用
SQLBindParameter將整數變數系結至 SQL 語句中的第一個參數標記。在變數中放入整數值。
執行該陳述句,指定參數標記(
?):SQLExecDirect(hstmt, "SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = ?", SQL_NTS);
SQL Server 原生客戶端 OLE DB 提供者與 SQL Server 原生客戶端 ODBC 驅動程式會在應用程式中使用參數標記時,使用
sp_executesql將陳述式傳送至 SQL Server。撰寫儲存程序,這些程序是設計上使用參數的。
如果你沒有在應用程式的設計中明確納入參數設定,也可以依賴查詢優化器(Query Optimizer)透過預設的簡單參數化行為,自動將某些查詢參數化。 另外,您也可以強制查詢最佳化工具考慮將資料庫中的所有查詢參數化,方式是將 PARAMETERIZATION 陳述式的 ALTER DATABASE 選項設為 FORCED。
簡單參數化
在 資料庫引擎 中,使用 T-SQL 語句中的參數或參數標記,能提升關聯引擎將新 T-SQL 語句與先前編譯的執行計畫匹配的能力。
警告
透過測試類型、長度、格式和範圍,始終驗證使用者輸入。 如需詳細資訊,請參閱 SQL 插入。
若執行 T-SQL 語句未加參數,資料庫引擎 會內部參數化該語句,以提高與現有執行計畫匹配的可能性。 這個過程稱為 參數化。 預設是 簡單的參數化,你可以啟用 資料庫的強制參數化 。
請考慮這句話:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
你可以在語句結尾將值 1 指定為參數。 關聯引擎會如同您在值 1 的位置指定參數一樣,建立這個批次的執行計畫。 由於這種簡單的參數化,資料庫引擎 會辨識以下兩個陳述式產生本質相同的執行計畫,並將第一個計畫用於第二個陳述:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
在處理複雜的 T-SQL 語句時,關聯引擎可能難以判斷哪些表達式可以參數化。 為了提升關聯引擎將複雜 T-SQL 語句與現有未使用的執行計畫相符的能力,可以明確指定參數,方法是使用 sp_executesql 或參數標記。
注意
當你使用 +、-、*、/ 或 % 算術運算子將 int、smallint、tinyint 或 bigint 常數值隱含或顯式轉換成 float、real、decimal 或 numeric 資料型態時,資料庫引擎 會套用特定規則來計算表達式結果的類型與精確度。 這些規則會因查詢是否參數化而有所不同。 因此,在某些情況下,查詢中類似的運算式可能會產生不同的結果。
在簡單參數化的預設行為下,資料庫引擎 只會將相對少量的一類查詢參數化。 不過,您可以藉由將 PARAMETERIZATION 命令的 ALTER DATABASE 選項設為 FORCED,來指定資料庫中所有查詢都會依據特定限制進行參數化。 此變更能透過降低查詢編譯頻率,提升遭遇大量並行查詢的資料庫效能。
此外,您可以指定單一查詢,以及任何其他語法相同但唯有參數值不同的查詢,使其進行參數化。
提示
當你使用像 Entity Framework (EF) 這類物件關聯映射(ORM)解決方案時,像手動 LINQ 查詢樹或某些原始 SQL 查詢可能沒有參數化。 此限制影響計畫重用及在 查詢存放區 追蹤查詢的能力。 如需詳細資訊,請參閱 EF 查詢快取和參數化和 EF 原始 SQL 查詢。
強制參數化
你可以透過指定資料庫中所有 SELECT、 INSERT、 UPDATE和 DELETE 陳述句都要參數化,但必須受某些限制,來覆寫 資料庫引擎 預設的簡單參數化行為。 在 ALTER DATABASE 陳述式中,將 PARAMETERIZATION 設為 FORCED,即可啟用強制參數化。 強制參數化可藉由降低查詢編譯與重新編譯的頻率,來增進特定資料庫的效能。 可經由強制參數化獲益的資料庫通常會有來自來源 (如銷售點應用程式) 的大量並行查詢。
當你將PARAMETERIZATION選項設為 FORCED時,任何出現在 INSERT、UPDATE、DELETE 或 SELECT 陳述句中的常值,無論以任何形式提交,都會在查詢編譯過程中轉換成參數。 然而,出現在下列查詢結構中的文字常數則為例外:
-
INSERT...EXECUTE陳述式。 - 位於預存程序、觸發程序或使用者自訂函數主體中的語句。 資料庫引擎已經會重複使用這些常式的查詢方案。
- 已在客戶端應用程式中參數化的預備陳述式。
- 含有 XQuery 方法呼叫的陳述式,其方法會出現在引數通常已參數化的內容中,如
WHERE子句。 若此方法出現在引數未參數化的內容中,則該陳述式的其他部分會進行參數化。 - T-SQL 游標內的語句。 (API 資料指標內的
SELECT陳述式會進行參數化)。 - 已棄用的查詢結構。
- 任何在
ANSI_PADDING或ANSI_NULLS設為OFF的情況下執行的陳述式。 - 包含超過 2,097 個可參數化之常值的陳述式。
- 參考變數的陳述式,如
WHERE T.col2 >= @bb。 - 含有
RECOMPILE查詢提示的陳述式。 - 含有
COMPUTE子句的陳述式。 - 含有
WHERE CURRENT OF子句的陳述式。
以下查詢子句未進行參數化。 在這些情況下,只有子句沒有參數化。 相同查詢內的其他子句可進行強制參數化。
- 任何
<select_list>陳述的SELECT。 此清單包含子查詢的SELECT清單及INSERT陳述式中的SELECT清單。 - 出現在
SELECT陳述式中的子查詢IF陳述式。 - 查詢中的
TOP、TABLESAMPLE、HAVING、GROUP BY、ORDER BY、OUTPUT...INTO或FOR XML子句。 - 傳送至
OPENROWSET、OPENQUERY、OPENDATASOURCE、OPENXML或任何FULLTEXT運算子的引數 (直接或做為子運算式)。 -
LIKE子句中的 pattern 和 escape_character 引數。 -
CONVERT子句的 style 參數。 -
IDENTITY子句中的整數常數。 - 使用 ODBC 延伸語法指定的常數。
- 可摺疊常數的運算式,其為
+、-、*、/和%運算子的引數。 在考慮強制參數化的資格時,資料庫引擎 將該表達式視為常數可摺疊,當以下任一條件成立時:- 運算式中未出現資料行、變數或子查詢。
- 運算式包含
CASE子句。
- 查詢提示子句的參數,包括 查詢提示的
FAST參數、 查詢提示的MAXDOP參數,以及MAXRECURSION查詢提示的 number 參數。
參數化發生在個別 T-SQL 語句的層級。 換句話說,批次中的個別陳述式會進行參數化。 編譯完成後,參數化查詢會在其原始提交批次的上下文中執行。 如果查詢的執行計畫被快取,你可以透過參考 sql 動態管理檢視的 sys.syscacheobjects 欄位來判斷該查詢是否被參數化。 若查詢已參數化,在此欄中,參數的名稱與資料型別會出現在已提交批次的文字之前,例如 (@1 TINYINT)。
注意
參數名稱可以是任意的名稱。 使用者或應用程式不應依賴特定的命名順序。 此外,以下項目在 SQL Server 版本與累積更新(CU)升級之間可能會改變:參數名稱、被參數化的常值選擇,以及參數化文字的間距。
參數的資料類型
當 資料庫引擎 參數化常值時,參數會被轉換成以下資料型態:
- 原本可容納於 int 資料型別中的整數常值,會參數化為 int。較大的整數常值,若為涉及任何比較運算子的謂詞一部分(包括
<、<=、=、>、!=、>=、!<、ANY、BETWEEN、ALL、<>、SOME、!>和IN),則會參數化為 numeric(38,0)。 較大的常值,若不屬於涉及比較運算子的謂詞部分,則會參數化為 numeric,其精度剛好足以支援其大小,且小數位數為 0。 - 作為涉及比較運算子之謂詞一部分的定點數值常值,會視為精度為 38 且小數位數剛好足以支援其大小的 numeric。 不屬於涉及比較運算子的謂詞部分的固定點數值常值,會被視為精確度與小數位數剛好足以支援其大小的 numeric 值。
- 浮點數值常值參數化為 float(53)。
- 非 Unicode 字串的字面值如果字面值長度在 8,000 個字元以內,則參數化為 varchar(8000),如果超過 8,000 字元則為 varchar(max)。
- Unicode 字串常值會參數化為 nvarchar(4000),如果常值可容納在 4,000 個 Unicode 字元以內;如果常值超過 4,000 個字元,則會參數化為 nvarchar(max)。
- 如果二進位常值可容納在 8,000 位元組內,則會參數化成 varbinary(8000)。 如果超過 8,000 位元組,則會轉換成 varbinary(max)。
- 金錢字面值會參數化為 money。
強制參數化的使用指南
當你將 PARAMETERIZATION 選項設定為 FORCED 時,請考慮以下幾點:
- 強制參數化會在編譯查詢時,將查詢中的文字常數改為參數。 因此,查詢優化器可能會選擇不理想的查詢計畫。 特別是,查詢最佳化工具較不可能比對查詢與索引檢視或計算資料行上的索引。 它可能會為分割資料表與分散式分割檢視上的查詢選擇次佳的方案。 對於高度依賴索引檢視和計算欄位索引的環境,不要使用強制參數化。 一般來說,只有有經驗的資料庫專業人士在確定不會對效能造成負面影響後,才會使用這個
PARAMETERIZATION FORCED選項。 - 只要在查詢執行的資料庫中將
PARAMETERIZATION選項設為FORCED,則參考多個資料庫的分散式查詢即可使用強制參數化。 - 將
PARAMETERIZATION選項設為FORCED,會從資料庫的計畫快取中清除所有查詢計畫,但目前正在編譯、重新編譯或執行中的查詢計畫除外。 在設定變更期間編譯或執行的查詢計畫,會在下一次查詢執行時被參數化。 - 設定該
PARAMETERIZATION選項是一種線上操作,不需要資料庫層級的獨佔鎖。 - 重新附加或還原資料庫時,會保留
PARAMETERIZATION選項目前的設定。
你可以透過指定對單一查詢嘗試簡單參數化,以及其他語法等價但僅參數值差異的查詢,來覆寫強制參數化的行為。 反之,您可以指定只在一組語法相同的查詢嘗試強制參數化,即使資料庫中已停用強制參數化。 請使用 Plan Guide 來達成此目的。
注意
將 PARAMETERIZATION 選項設為 FORCED 時,錯誤訊息的報告可能會與 PARAMETERIZATION 選項設為 SIMPLE 時不同:強制參數化下可能報告了多個錯誤訊息,簡單參數化下報告的訊息則較少,而發生錯誤的行號可能未正確回報。
啟用強制參數化之後,仍會發生簡單參數化。 例如,根據強制參數化的規則,下列查詢無法參數化:
SELECT *
FROM Person.Address
WHERE AddressID = 1 + 2;
不過,可根據簡單參數化規則將它參數化。 如果強制參數化嘗試失敗,後續仍會嘗試簡單參數化。
準備 SQL 陳述式
資料庫引擎 支援在執行前準備 T-SQL 語句。 如果應用程式需要多次執行一個 T-SQL 語句,它可以利用資料庫 API 來:
- 準備一次聲明。 此步驟將 T-SQL 陳述式編譯成執行計畫。
- 每次需要執行該語句時,都執行預先編譯好的執行計畫。 此方法可避免在第一次之後的每次執行時重新編譯 T-SQL 陳述式。 準備和執行陳述式是由 API 函數和方法所控制。 SQL Server 原生客戶端 OLE DB 提供者與 SQL Server 原生客戶端 ODBC 驅動程式支援執行 T-SQL 語句的準備/執行模型。 在準備要求中,提供者或驅動程式會將準備陳述式的要求傳送到 SQL Server。 資料庫引擎 會編譯執行計畫,並將該計畫的句柄回傳給提供者或驅動程式。 當接收到執行請求時,提供者或驅動程式會向伺服器發送執行與句柄相關聯計畫的請求。
預備語句無法在 資料庫引擎 中建立臨時物件。 準備陳述式也無法參考可建立暫存物件 (如暫存資料表) 的系統預存程序。 這些程序必須直接執行。
過度使用準備/執行模型會降低效能。 如果一個語句只執行一次,直接執行只需與伺服器進行一次網路往返。 若某個 T-SQL 語句只執行一次,準備並執行它需要額外的網路往返:準備語句一次,執行語句一次。
如果使用參數標記,準備敘述會更有效。 例如,假設應用程式偶爾會被要求從 AdventureWorksLT2025 範例資料庫擷取產品資訊。 應用程式有兩種方式可以完成這項任務。
透過採用第一種方法,應用程式可對每個所要求的產品執行獨立查詢:
SELECT *
FROM Production.Product
WHERE ProductID = 63;
採用第二種方法時,應用程式執行以下操作:
準備包含參數標記(
?)的陳述式。SELECT * FROM Production.Product WHERE ProductID = ?;繫結程式變數與參數標記。
每次需要產品資訊時,將鍵值填入綁定變數中,然後執行語句。
當該語句執行超過三次時,第二種方法更有效率。
在 資料庫引擎 中,準備/執行模型相較於直接執行沒有顯著的效能優勢,因為 資料庫引擎 會重複使用執行計畫。 資料庫引擎 有高效的演算法,能將目前的 T-SQL 語句與先前執行同一 T-SQL 語句所產生的執行計畫進行匹配。 如果應用程式多次執行帶有參數標記的 T-SQL 語句,資料庫引擎 會將第一次執行的執行計畫重複用於第二次及後續執行(除非計畫從計畫快取中移出)。 但準備/執行模型仍然具有以下優點:
- 透過識別控制代碼尋找執行計畫,比起用來將 T-SQL 陳述式與現有執行計畫相符的演算法更有效率。
- 應用程式可以控制執行計畫何時建立,以及何時會被重複使用。
- 準備/執行模型可以移至其他資料庫使用,包括舊版的 SQL Server。
參數敏感度
參數敏感性,也稱為參數嗅探,是指資料庫引擎在編譯或重新編譯時嗅探目前參數值,並將其傳達給查詢優化器,以協助產生更有效率的查詢執行計畫。
在編譯或重新編譯期間會探查下列批次類型的參數值:
- 預存程序
- 透過
sp_executesql提交的查詢 - 準備查詢
欲了解更多關於參數嗅探問題的故障排除資訊,請參閱:
- 調查並解決參數敏感性問題
- 使用明確參數以重複使用方案
- 參數敏感計畫最佳化
- 針對 Azure SQL 資料庫中包含參數區分查詢執行計畫問題的查詢進行疑難排解
- 針對 Azure SQL 受控執行個體中包含參數區分查詢執行計畫問題的查詢進行疑難排解
當 資料庫引擎 的查詢使用提示OPTION (RECOMPILE)時,查詢優化器會將參數與本地變數轉換成編譯時常數,這些常數可被常數摺疊並簡化為常值。 在編譯過程中,優化器知道並能使用參數與局部變數的當前執行時值,這些值在該敘述之前立即存在。
OPTION (RECOMPILE) 提示讓優化器能根據特定值產生更優化的查詢計畫,並在執行時善用最佳底層索引。 針對參數,此程式不是指原本傳遞至批次或預存程式的值,而是重新編譯時的值。 這些值可在程序中修改,在到達包含 RECOMPILE 的陳述之前。 這種行為可以提升輸入資料高度變異或偏斜的查詢效能,但代價是每次執行時都要重新編譯查詢。 這個成本可能很高。 避免在未評估提示對整體工作量影響前就使用 RECOMPILE 提示。
局部變數與基數估計
當查詢使用區域變數時,資料庫引擎 無法在編譯時嗅探其值,因此會利用現有統計或啟發式來估計基數。 如果統計數據存在,它通常會使用統計直方 圖中的所有密度 值(也稱為 平均密度)來估計有多少數據列符合述詞。 然而,若該欄位無法提供統計數據,資料庫引擎則會退回啟發式估計,例如假設等式謂詞有10% 選擇性,不等式與範圍假設30%。 這些估算可能導致執行計畫不夠準確。 以下是使用局部變數的查詢範例。
DECLARE @ProductId AS INT = 100;

SELECT *
FROM Products
WHERE ProductId = @ProductId;
在這種情況下,資料庫引擎 並未使用值 100 來優化查詢。 它會使用一般估計值。
平行查詢處理
資料庫引擎 提供平行查詢,以優化擁有多個微處理器(CPU)電腦的查詢執行與索引操作。 由於 資料庫引擎 可以透過多個作業系統工作執行緒並行執行查詢或索引操作,因此操作能快速且有效率地完成。
在查詢優化過程中,資料庫引擎 會尋找可能受益於平行執行的查詢或索引操作。 對於這些查詢,資料庫引擎 會在查詢執行計畫中插入交換運算子,以準備查詢進行平行執行。 所謂的交換運算子,是指在查詢執行計畫中,提供流程管理、資料重新分配以及流量控制的運算子。 交換運算子包括被視為子類型的 Distribute Streams、Repartition Streams 及 Gather Streams 邏輯運算子,它們中的一個或多個可以出現在平行查詢的查詢計畫 Showplan 輸出中。
重要
某些結構會限制 資料庫引擎 對整個執行計畫或執行計畫的部分使用平行運算的能力。
妨礙平行處理的結構包括:
| 構建 | 描述 |
|---|---|
| 純量 UDF | 欲了解更多關於純量使用者定義函數的資訊,請參閱「建立使用者定義函數」。 從 SQL Server 2019(15.x)開始,SQL Server Database Engine 可以內嵌這些函式,並在查詢處理時解鎖平行運算的使用。 欲了解更多關於純量 UDF 內嵌的資訊,請參閱 SQL 資料庫中的智慧查詢處理。 |
| 遠端查詢 | 欲了解更多遠端查詢資訊,請參閱 邏輯與實體顯示計畫運算子參考資料。 |
| 動態游標 | 欲了解更多游標資訊,請參閱「宣告游標」。 |
| 遞迴查詢 | 欲了解更多有關遞迴的資訊,請參閱 定義和使用遞迴通用資料表運算式的準則 和 T-SQL 中的遞迴。 |
| 多重陳述式資料表值函數 (MSTVF) | 欲了解更多關於 MSTVFs 的資訊,請參閱建立使用者定義函數(資料庫引擎)。 |
TOP 關鍵字 |
如需詳細資訊,請參閱 TOP。 |
查詢執行計畫可能會在 QueryPlan 元素中包含 NonParallelPlanReason 屬性,用以描述未使用平行處理原則的原因。 適用於此屬性的值包括:
| NonParallelPlanReason 值 | 描述 |
|---|---|
MaxDOPSetToOne |
最大平行度度設為 1。 |
EstimatedDOPIsOne |
估計的平行度為 1。 |
NoParallelWithRemoteQuery |
平行處理原則不支援遠端查詢。 |
NoParallelDynamicCursor |
平行處理計畫不支援動態游標。 |
NoParallelFastForwardCursor |
平行計畫不支援向前快轉資料指標。 |
NoParallelCursorFetchByBookmark |
平行計畫不支援依書籤擷取的資料指標。 |
NoParallelCreateIndexInNonEnterpriseEdition |
平行索引建立不支援非 Enterprise 版本。 |
NoParallelPlansInDesktopOrExpressEdition |
不支援 Desktop 和 Express 版的平行方案。 |
NonParallelizableIntrinsicFunction |
查詢正在參考不可平行的內建函式。 |
CLRUserDefinedFunctionRequiresDataAccess |
平行處理原則不支援需要資料存取的 CLR UDF。 |
TSQLUserDefinedFunctionsNotParallelizable |
查詢正在參考不可平行的 T-SQL 使用者定義函數。 |
TableVariableTransactionsDoNotSupportParallelNestedTransaction |
資料表變數交易不支援平行巢狀交易。 |
DMLQueryReturnsOutputToClient |
DML 查詢將輸出傳回用戶端且不可平行。 |
MixedSerialAndParallelOnlineIndexBuildNotSupported |
單一線上索引構建不支援序列與平行方案的混合使用。 |
CouldNotGenerateValidParallelPlan |
驗證平行計畫失敗,正在回復至串列。 |
NoParallelForMemoryOptimizedTables |
不支援被參照的內存中 OLTP 資料表的平行處理。 |
NoParallelForDmlOnMemoryOptimizedTable |
平行處理原則不支援記憶體內部 OLTP 資料表上的 DML。 |
NoParallelForNativelyCompiledModule |
平行運算不支援參考的原生編譯模組。 |
NoRangesResumableCreate |
針對可繼續之 Create 作業的範圍產生失敗。 |
插入交換運算子之後,結果便是平行查詢執行計畫。 平行查詢執行計畫可以使用多個工作執行緒。 非平行 (序列) 查詢使用的序列執行計畫,在執行時只會使用一個工作執行緒。 平行查詢實際使用的工作執行緒數量是在查詢計畫執行初始化時決定,並取決於計畫的複雜度及平行處理程度。
平行度(DOP)指的是執行平行任務時,最多可使用的處理器數量。 DOP 並不表示查詢所使用的總工作執行緒數。 DOP 限制的設定以任務為準。 它不是每次要求或查詢的限制。 這表示在平行查詢執行期間,單一要求可能會繁衍指派至排程器的多個工作。 當不同任務同時執行時,在查詢執行期間的任何時間點,可能會同時使用超過由 MAXDOP 指定數量的處理器。 如需詳細資訊,請參閱 線程和工作架構指南。
若符合以下任一條件,查詢優化器不會對查詢使用平行執行計畫:
串列執行計畫很簡單,或者說不會超過平行處理成本閾值設定。
序列執行計畫的總估計樹狀子目錄成本,低於最佳化工具所探索的任何平行執行計畫。
此查詢包含無法平行執行的純量或關聯式運算子。 特定運算子可能造成查詢計畫的一個區段以序列模式執行,或整個計畫以序列模式執行。
注意
平行計劃的總估計子樹成本可能會低於平行化設定的成本門檻。 換句話說,序列計畫的總預估子樹成本超過其成本,因此選擇了總預估子樹成本較低的查詢計畫。
平行度 (DOP)
資料庫引擎 會自動偵測每個平行查詢執行或索引資料定義語言(DDL)操作實例的最佳平行度。 它根據以下標準決定此數值:
SQL Server 是否正在具有多個微處理器或 CPU 的電腦上執行,例如對稱式多處理的電腦 (SMP)。 具有一個以上 CPU 的電腦,才能使用平行查詢。
是否有足夠的工作執行緒。 每一個查詢或索引作業都需要某個數目的工作執行緒來執行。 執行平行計畫所需的背景工作執行緒會比執行序列計畫還多,而且所需的背景工作執行緒數目會隨著平行處理原則的程度增加。 當無法滿足平行計畫在特定平行處理原則下所需的工作執行緒需求時,SQL Server Database Engine 會自動降低平行度,或以序列方式執行平行計畫。
已執行之查詢或索引作業的類型。 建立或重建索引,或是卸除叢集索引的索引作業,以及大量使用 CPU 循環的查詢,最適合使用平行計畫。 例如,大型資料表的聯結、大型彙總及大型結果集的排序,都是不錯的候選項目。 對於交易處理應用中常見的基本查詢,平行執行查詢所需的額外協調成本往往高於潛在的效能提升。 為了區分能否從平行處理原則中獲益的查詢,SQL Server 資料庫引擎會比較執行查詢或索引作業的預估成本與平行處理原則的成本閾值。 如果經過適當測試發現不同值更適合執行工作負載,使用者可透過
5來更改 的預設值。要處理的資料列數量是否足夠。 如果查詢最佳化工具判定資料列數目太少,則不會引進交換運算子來散發資料列。 因此,運算子會循序執行。 在序列計畫中執行運算子,可以避免啟動、分配和協調的成本超過平行運算子執行所獲得收益的情況。
是否有 最新的統計數據。 如果無法達到最高的平行度,則在放棄平行計畫之前,會先考慮採用較低的平行度。 例如,當你在視圖上建立一個叢集索引時,統計數據無法被評估,因為該叢集索引尚未存在。 在此情況下,SQL Server 資料庫引擎無法為索引作業提供平行處理原則的最高程度。 然而,有些運算子 (如排序及掃描) 仍可從平行執行獲益。
注意
只有 SQL Server Enterprise、Developer 和 Evaluation 版本才可使用平行索引作業。
SQL Server 資料庫引擎會在執行期間,判斷目前系統工作負載和先前描述的組態資訊是否允許平行執行。 如果保證可以平行執行,則 SQL Server 資料庫引擎會判定最佳的背景工作執行緒數目,並將平行計畫的執行分散到那些背景工作執行緒上。 當查詢或索引作業開始在多個背景工作執行緒上執行,以進行平行執行時,則在完成作業之前,都會使用相同數目的背景工作執行緒。 每次從計畫快取擷取執行計畫時,SQL Server 資料庫引擎都會重新檢查最佳的工作執行緒數目。 例如,一個快取平行計畫的一次執行可以串行執行,同一計畫的後續執行可以使用三個工作執行緒,第三次執行則可以使用四個工作執行緒。
平行查詢執行計畫中的 Update 和 Delete 運算子都會以循序方式執行,但是 WHERE 或 UPDATE 陳述式的 DELETE 子句則能以平行方式執行。 真正的資料變更隨即會循序套用到資料庫。
從資料庫相容性等級 110 開始,該 SELECT ... INTO 語句可以平行執行。 其他形式的插入運算子運作方式與先前版本相同。
從資料庫相容性層級 130 開始,當插入堆積或叢集欄位儲存索引(CCI)且使用 INSERT ... SELECT 提示時,可以平行執行 TABLOCK 語句。 插入本地暫存資料表(以 # 前綴識別)及全域暫存資料表(以 ## 前綴標示)也可使用 TABLOCK 提示啟用平行插入。 如需詳細資訊,請參閱 INSERT。
靜態和鍵集驅動的資料指標可以透過平行執行計畫來填充。 但是,動態資料指標的行為僅能由串行執行來提供。 查詢最佳化器總是會為屬於動態資料指標的查詢產生一個序列執行計畫。
重設平行度
平行處理原則的程度設定平行計畫執行中所要使用的處理器數量。 你可以在不同層級設定此配置:
在伺服器層級,可使用最大平行處理原則(
MAXDOP)伺服器組態選項。適用於:SQL Server
SQL Server 2019(15.x)在安裝過程中引入了針對設定
MAXDOP伺服器設定選項的自動建議。 安裝程式使用者介面可讓您接受建議的設定,或輸入您自己的值。 如需詳細資訊,請參閱資料庫引擎配置 - MaxDOP 頁面。工作負載層級,透過使用
MAX_DOPResource Governor 工作負載群組設定選項。適用於:SQL Server
在資料庫層級,使用
MAXDOP資料庫範圍組態。適用於:SQL Server、Azure SQL Database 及 Azure SQL 受控執行個體
在查詢或索引陳述式層級,使用
MAXDOPquery hint 或MAXDOPindex option。 例如,你可以使用MAXDOP選項來控制,藉由增加或減少,專用於線上索引操作的處理器數量。 透過這種方式,你可以平衡索引操作所使用的資源與同時存取的使用者所使用的資源。適用於:SQL Server、Azure SQL Database 及 Azure SQL 受控執行個體
將選項max degree of parallelism設為0(預設)可讓 資料庫引擎 在平行計畫執行中使用所有可用的處理器,最多可達 64 顆處理器。 雖然 資料庫引擎 在將 0 選項設為 MAXDOP 時,會將執行階段目標設為 64 個邏輯處理器,但你也可以視需要手動設定不同的值。 將 MAXDOP 設為 0 時,資料庫引擎 可使用所有可用處理器,最多可使用 64 個處理器,以平行計畫執行的方式執行給定的查詢或索引。
MAXDOP 並不是所有平行查詢都會強制使用的值,而是所有符合平行處理條件的查詢的暫定目標。 這表示如果執行時可用的工作執行緒不足,查詢執行時的平行度可能會低於 MAXDOP 伺服器設定選項。
提示
欲了解更多資訊,請參閱 MAXDOP 建議,以了解在伺服器、資料庫、查詢或提示層級設定 MAXDOP 的指引。
平行查詢範例
以下查詢計算自 2024 年 4 月 1 日起,特定季度內下單的訂單數量,且至少有一項訂單項目在承諾日期後被客戶收到。 這個查詢會列出這類的訂單數量,並依訂單的優先順序分組,然後以遞增的優先順序排序訂單。
這個範例使用假設性的資料表和資料行名稱。
SELECT o_orderpriority,
       COUNT(*) AS Order_Count
FROM orders
WHERE o_orderdate >= '2024/04/01'
      AND o_orderdate < DATEADD(mm, 3, '2024/04/01')
      AND EXISTS (SELECT *
                  FROM lineitem
                  WHERE l_orderkey = o_orderkey
                        AND l_commitdate < l_receiptdate)
GROUP BY o_orderpriority
ORDER BY o_orderpriority;
假設下列索引定義於 lineitem 和 orders 資料表上:
CREATE INDEX l_order_dates_idx
    ON lineitem(l_orderkey, l_receiptdate, l_commitdate, l_shipdate);

CREATE UNIQUE INDEX o_datkeyopr_idx
    ON ORDERS(o_orderdate, o_orderkey, o_custkey, o_orderpriority);
這是針對之前查詢所產生的可能平行計畫:
|--Stream Aggregate(GROUP BY:([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=COUNT(*)))
    |--Parallelism(Gather Streams, ORDER BY:
                  ([ORDERS].[o_orderpriority] ASC))
         |--Stream Aggregate(GROUP BY:
                  ([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=Count(*)))
              |--Sort(ORDER BY:([ORDERS].[o_orderpriority] ASC))
                   |--Merge Join(Left Semi Join, MERGE:
                  ([ORDERS].[o_orderkey])=
                        ([LINEITEM].[l_orderkey]),
                  RESIDUAL:([ORDERS].[o_orderkey]=
                        [LINEITEM].[l_orderkey]))
                        |--Sort(ORDER BY:([ORDERS].[o_orderkey] ASC))
                        |    |--Parallelism(Repartition Streams,
                           PARTITION COLUMNS:
                           ([ORDERS].[o_orderkey]))
                        |         |--Index Seek(OBJECT:
                     ([tpcd1G].[dbo].[ORDERS].[O_DATKEYOPR_IDX]),
                     SEEK:([ORDERS].[o_orderdate] >=
                           Apr  1 2024 12:00AM AND
                           [ORDERS].[o_orderdate] <
                           Jul  1 2024 12:00AM) ORDERED)
                        |--Parallelism(Repartition Streams,
                     PARTITION COLUMNS:
                     ([LINEITEM].[l_orderkey]),
                     ORDER BY:([LINEITEM].[l_orderkey] ASC))
                             |--Filter(WHERE:
                           ([LINEITEM].[l_commitdate]<
                           [LINEITEM].[l_receiptdate]))
                                  |--Index Scan(OBJECT:
         ([tpcd1G].[dbo].[LINEITEM].[L_ORDER_DATES_IDX]), ORDERED)
下圖展示了一個查詢計畫,其平行度等於 4,且涉及兩表連接。
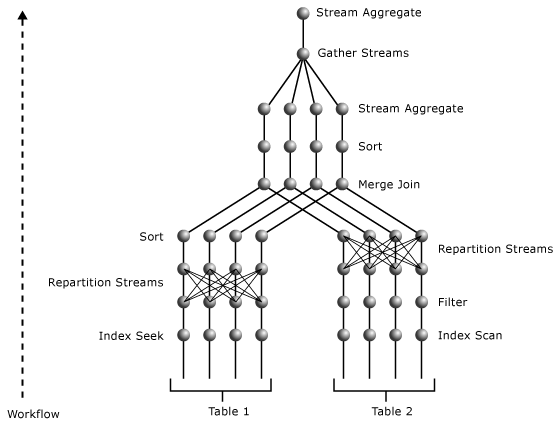
平行計畫包含三個平行處理原則運算子。
o_datkey_ptr 索引的 Index Seek 運算子和 l_order_dates_idx 索引的 Index Scan 運算子會以平行方式執行。 此過程產生數個專用串流,分別可從索引掃描與索引搜尋運算子上方最近的平行處理運算子判定。 兩個運算子都在重新分割 Exchange 的類型。 它們會在串流間重新排列資料,輸出的串流數量與輸入相同。 此資料流數量就等於平行處理原則的程度。
位於 l_order_dates_idx 索引掃描運算子上方的平行處理運算子會使用 L_ORDERKEY 的值作為鍵值,重新劃分其輸入串流。 利用這種方式,相同的 L_ORDERKEY 值也會在相同的輸出資料流中產生相同的結果。 同時,輸出資料流會維持 L_ORDERKEY 資料行的順序,以符合 Merge Join 運算子的輸入需求。
位於索引尋道運算子上方的平行運算子會利用 O_ORDERKEY 的值重新分割輸入串流。 由於輸入未依 O_ORDERKEY 欄位值排序,而該欄位是 Merge Join 運算子中的連接欄位,平行運算子與合併連接運算子之間的排序運算子確保輸入會針對連接欄位排序,以供 Merge Join 運算子使用。
Sort 運算子 (如 Merge Join 運算子) 會以平行方式執行。
最頂端的 Parallelism 運算子會將數個資料流中的結果,集合成單一資料流。 接著,Parallelism 運算子下方的 Stream Aggregate 運算子所執行的部分彙總,會在上方的 Stream Aggregate 運算子中,針對每個不同的 SUM 值,累積為單一的 O_ORDERPRIORITY 值。 由於此計畫有兩個交換段,平行度等於 4,因此使用八個工作線程。
欲了解更多關於本範例中運算子的資訊,請參閱 邏輯與實體顯示計畫運算子參考資料。
平行索引作業
用於建立或重建索引,或丟棄叢集索引的索引操作的查詢計畫,可以支援擁有多個處理器的電腦上的平行多執行緒操作。
注意
平行索引操作僅在企業版中提供。
資料庫引擎 使用與判定其他查詢時相同的演算法,來決定索引操作的平行處理原則(需執行的個別背景工作執行緒總數)。
最大平行處理原則 伺服器組態選項會設定索引作業的最大平行處理原則。 你可以透過在 max degree of parallelism、ALTER TABLE、DROP INDEX 和 ALTER INDEX 語句中設定 CREATE INDEX 索引選項,來覆蓋個別索引操作的 MAXDOP 值。
當 SQL Server Database Engine 建立索引執行計畫時,平行作業的數量會設為下列值中的最小值:
- 電腦中處理器(CPU)的數量。
- 在
max degree of parallelism伺服器設定選項中指定的數值。 - 是指 SQL Server 工作執行緒中尚未超過某個門檻工作量的 CPU 數量。
例如,在一台擁有八顆 CPU 的電腦上,其中 max degree of parallelism 設為 6,索引操作使用最多六個平行工作執行緒。 如果在建立索引執行計畫時,電腦中有五個 CPU 已經超過 SQL Server 工作的閾值,則執行計畫只會指定三個平行背景工作執行緒。
平行索引操作的主要階段包括:
- 協調的工作執行緒會快速及隨機掃描資料表,以估計索引鍵的散佈。 協調工作執行緒建立金鑰邊界,產生等於平行操作程度的金鑰範圍,每個金鑰範圍估計涵蓋相近的列數。 例如,若表格中有四百萬行且平行度為 4,協調工作執行緒會決定劃分四組資料列的鍵值,每組資料列有 100 萬行。 如果協調工作執行緒無法建立足夠的金鑰範圍來使用所有 CPU,它會相應降低平行處理程度。
- 協調背景工作執行緒會分派與平行作業程度相等數目的背景工作執行緒,並且等待這些背景工作執行緒完成它們的工作。 每個工作線程會使用篩選來掃描基底資料表,只擷取其索引鍵值在該工作線程指定範圍內的資料列。 每個工作執行緒會在其索引鍵範圍內建立資料列的索引結構。 在分割的索引中,每個工作執行緒都會建立特定數量的分區。 工作執行緒之間不會共用分區。
- 當所有平行工作執行緒完成後,協調工作執行緒會將索引子單元連接成單一索引。 此階段僅適用於離線索引作業。
個別 CREATE TABLE 或 ALTER TABLE 陳述式可能有多個限制,需要建立索引。 這幾個索引建立作業會以序列方式來執行,即使在有多個 CPU 的電腦上,每個個別索引建立作業可能是平行作業。
分散式查詢結構
資料庫引擎 支援兩種方法,用於在 T-SQL 語句中引用異質 OLE DB 資料來源:
連結伺服器名稱
使用系統儲存程序
sp_addlinkedserver和sp_addlinkedsrvlogin,為 OLE DB 資料來源指定伺服器名稱。 你可以用四部分名稱的 T-SQL 語句來參照這些連結伺服器中的物件。 例如,如果DeptSQLSrvr的連結伺服器名稱是根據 SQL Server 的另一個執行個體所定義,則下列陳述式會參考該伺服器上的資料表:SELECT JobTitle, HireDate FROM DeptSQLSrvr.AdventureWorks2025.HumanResources.Employee;你也可以在
OPENQUERY陳述式中指定連結的伺服器名稱,從 OLE DB 資料來源開啟列集。 你可以在 T-SQL 語句中像資料表一樣參考這個列集。臨時連接器名稱
對於不常參照資料來源的情況,請指定
OPENDATASOURCE或OPENROWSET函式,並提供連接至連結伺服器所需的資訊。 接著你可以像在 T-SQL 語句中引用資料表一樣,參考該列集:SELECT a.* FROM OPENROWSET ( 'Microsoft.Jet.OLEDB.4.0', 'MSOffice\Access\Samples\Northwind.mdb'; 'Admin'; '', Employees ) AS a;
資料庫引擎 使用 OLE DB 在關聯引擎與儲存引擎之間通訊。 關聯式引擎將每個 T-SQL 語句拆解成一系列對基本 OLE DB 資料列集的操作,儲存引擎從基底資料表開啟這些資料列集。 此過程意味著關聯引擎也能在任何 OLE DB 資料來源上開啟基本的 OLE DB 列集。
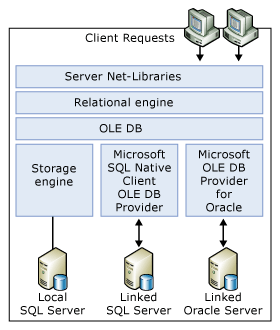
關聯式引擎使用 OLE DB 應用程式開發介面 (API) 來開啟連結伺服器上的資料列集、提取資料列、以及管理交易。
對於每個作為連結伺服器來存取的 OLE DB 資料來源,執行 SQL Server 的伺服器必須擁有 OLE DB 提供者。 你可以針對特定 OLE DB 資料來源使用的 T-SQL 操作集合,取決於 OLE DB 提供者的能力。
對於每個 SQL Server 實例,sysadmin 固定伺服器角色的成員可藉由使用 SQL Server DisallowAdhocAccess 屬性,啟用或停用 OLE DB 提供者的特定連接器名稱。 啟用臨時存取時,任何登入該實例的使用者都可以執行包含臨時連接器名稱的 T-SQL 語句,並參照 OLE DB 提供者能存取的網路上任何資料來源。 為了控制對資料來源的存取,sysadmin 固定伺服器角色的成員可以停用該 OLE DB 提供者的臨時存取權限,從而限制使用者只能使用管理員定義的連結伺服器名稱所參考的資料來源。 預設會針對 SQL Server OLE DB 提供者啟用特定存取,並針對所有其他的 OLE DB 提供者加以停用。
分散式查詢可允許使用者透過使用 SQL Server 服務執行的 Windows 帳號的安全上下文,存取其他資料來源(例如檔案、非關聯性資料來源如 Active Directory 等)。 SQL Server 會針對 Windows 登入適當地模擬該登入身分。 然而,對於 SQL Server 登入,無法進行這種冒充。 此限制可能會讓分散式查詢使用者存取其本身沒有權限存取的另一個資料來源,但執行 SQL Server 服務的帳號卻擁有權限。 使用 sp_addlinkedsrvlogin 來定義已經授權存取對應連結伺服器的特定登入。 此控制不適用於特定名稱,因此啟用 OLE DB 供應商以進行特定存取時請謹慎。
在可能的情況下,資料庫引擎 會推送關聯操作,如連接、限制、投影、排序及分組操作,到 OLE DB 資料來源。 資料庫引擎 不會預設將基底資料表掃描到 SQL Server 中,並自行執行關聯操作。 資料庫引擎 會查詢 OLE DB 提供者,以判斷其支援的 SQL 文法層級,並根據該資訊推送盡可能多的關聯操作給提供者。
資料庫引擎 規範了一種機制,讓 OLE DB 提供者能回傳統計資料,指示關鍵值在 OLE DB 資料來源中的分布方式。 此機制使 資料庫引擎 查詢優化器能更精確地根據每個 T-SQL 語句的需求分析資料來源中的資料模式,提升查詢優化器產生最佳執行計畫的能力。
分割資料表與索引上的查詢處理
資料庫引擎 支援已分割資料表與索引的分割感知查詢處理。 本節說明查詢處理器如何處理分割物件、如何解讀涉及分割的執行計畫,以及提升分割物件查詢效能的最佳實務。
注意
SQL Server Standard 版本支援分割資料表與索引,從 SQL Server 2016(13.x)服務包 1 起。
新區分辨識搜索操作
在 資料庫引擎 中,查詢處理器內部會將分割後的資料表視為以 PartitionID 為前導欄位的多欄位索引。
PartitionID 是一個用於內部計算的隱藏欄位,用來表示包含特定資料列的分割的 ID 。 例如,假設資料表 T,定義為 T(a, b, c),依欄位 a 分割,並在欄位 b 上有叢集索引。 此分割資料表被視為具有結構 T(PartitionID, a, b, c) 且在複合鍵 (PartitionID, b) 上有叢集索引的非分割資料表。 這種表示方式使查詢優化器能在任何分割的表格或索引上根據 PartitionID 執行尋道操作。
現在在此查詢作業中完成了分割區消除。
此外,查詢最佳化工具也已擴充,使得可在 PartitionID(作為邏輯前導欄位)及可能的其他索引鍵欄位上,以一個條件執行尋道或掃描操作。 查詢處理器接著對每個符合第一層尋道操作條件的不同值,對一個或多個額外欄位執行第二層尋道,條件不同。 此操作稱為 分割區跳過掃描,允許查詢最佳化工具根據一個條件執行搜尋或掃描操作以決定要存取的分割區,並在該運算子內進行二級索引搜尋操作,回傳這些分割區中符合不同條件的資料列。 例如,假設有以下的查詢。
SELECT *
FROM T
WHERE a < 10
      AND b = 2;
在此範例中,假設表 T,定義為 T(a, b, c),以欄位 a 進行分割,並在欄位 b 上有叢集索引。 以下劃分函數定義了表格 T的劃分邊界:
CREATE PARTITION FUNCTION myRangePF1(INT)
    AS RANGE LEFT
    FOR VALUES (3, 7, 10);
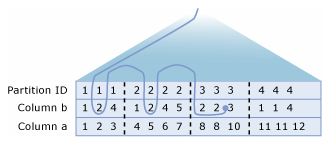
為了解決此查詢,查詢處理器會執行第一層搜尋作業,以尋找包含符合 T.a < 10條件之資料列的每一個資料分割。 此操作識別要存取的分割區。 在每個識別的分割中,處理器會對欄位的叢集索引 b 進行二層搜尋,以尋找符合條件 T.b = 2 和 T.a < 10 的列。
以下圖示是分區跳過掃描操作的邏輯表示。 顯示的是包含資料於欄 T 和 a 的表格 b。 分區以 1 到 4 進行編號,並以垂直虛線顯示分區的邊界。 對分割進行一層尋道操作(圖中未顯示)可確定分割 1、2 和 3 符合為資料表定義的分割方式,以及資料行 a 上的謂詞 (T.a < 10) 所暗示的尋道條件。 二層尋道所經過的路徑以曲線線表示。 基本上,該操作會針對符合條件 b = 2 的每一列,在這些分割區中搜尋。 該操作的總成本與三個獨立索引查找的總成本相同。
在查詢執行計畫中顯示資料分割資訊
可透過 T-SQL SET 語句 SET SHOWPLAN_XML 或 SET STATISTICS XML,或使用 SSMS 中的圖形執行計畫輸出,檢視分割資料表與索引查詢的執行計畫。 例如,你可以在 查詢編輯器 工具列中選擇「顯示預估執行計畫」來顯示編譯時執行計畫,並透過選擇「包含實際執行計畫」顯示執行時計畫。
透過使用這些工具,您可以找到以下資訊:
- 存取分割資料表或索引的操作,例如掃描、尋找、插入、更新、合併和刪除。
- 查詢存取的分區。 例如,執行時的執行計畫包含存取的分割區總數及已存取之連續分割區範圍。
- 當在 seek 或 scan 作業中使用分割區 skip scan 作業時,以從一個或多個分割區擷取資料。
分割資訊強化
資料庫引擎 提供針對編譯時和執行階段的執行計畫的強化分割資訊。 執行計畫現在會提供下列資訊:
- 一個可選
Partitioned屬性表示某操作符(如搜尋、掃描、插入、更新、合併或刪除)是在分割資料表上執行的。 - 新的
SeekPredicateNew元素搭配SeekKeys子元素,其中包含PartitionID做為前置的索引鍵資料行,以及在PartitionID上指定範圍搜尋的篩選條件。 存在兩個SeekKeys子元素表示在PartitionID上進行分割跳躍掃描。 - 提供所存取之資料分割總計數的摘要資訊。 只有在執行階段計畫中才能使用這項資訊。
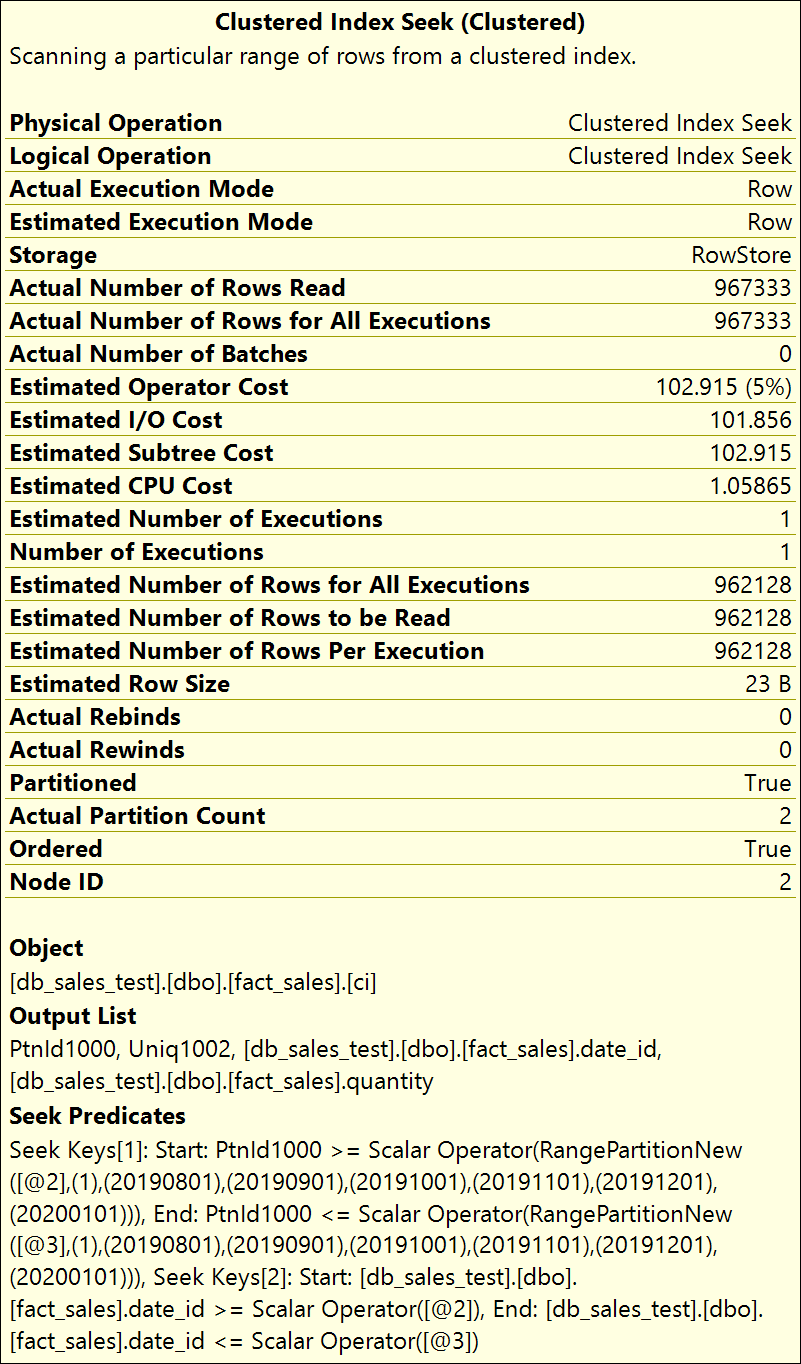
為了示範如何在圖形化執行計畫輸出和 XML Showplan 輸出中顯示這項資訊,請考慮對分割資料表fact_sales執行以下查詢。 此查詢會更新兩個分區中的資料。
UPDATE fact_sales
    SET quantity = quantity - 2
WHERE date_id BETWEEN 20190802 AND 20190902;
此插圖顯示在此查詢的執行時期執行計劃中 Clustered Index Seek 運算子的屬性。 欲查看 fact_sales 表格定義及分割定義,請參見 範例。
分區屬性
當在已分區的資料表或索引上執行像是索引搜尋的運算子時,Partitioned 屬性會出現在編譯時和執行時的計畫中,並設定為 True (1)。 當屬性設為 False (0) 時,屬性不會顯示。
Partitioned 屬性可出現在下列實體和邏輯運算子內:
- 資料表掃描
- 索引掃描
- 索引搜尋
- 插入
- 更新
- 刪除
- 合併
如前述圖示所示,此屬性出現在定義它的運算子的屬性中。 在 XML Showplan 輸出中,此屬性會在定義它的運算元之 RelOp 節點中以 Partitioned="1" 的形式出現。
新的搜尋述詞
在 XML Showplan 輸出中,元素 SeekPredicateNew 會出現在定義它的運算元中。 其中最多可包含兩個 SeekKeys 子元素。 第一個 SeekKeys 項目會在邏輯索引的資料分割識別碼層級上指定第一層搜尋作業。 也就是說,這個尋道操作決定了必須存取哪些分割區,以滿足查詢的條件。 第二 SeekKeys 項指定在第一層尋道中識別的每個分割內的第二層尋道。
分區摘要資訊
在執行階段的執行計畫中,分割區摘要資訊提供了所存取分割區的數量以及實際存取分割區的識別。 您可以使用這些資訊來確認已存取查詢中的正確資料分割,而且所有其他資料分割都已排除在考量之外。
系統會提供下列資訊: Actual Partition Count和 Partitions Accessed。
Actual Partition Count 是查詢所存取的資料分割總數。
Partitions Accessed 在 XML Showplan 輸出中,是其所定義之運算元的 RuntimePartitionSummary 節點中新出現的 RelOp 元素中所顯示的分割摘要資訊。 下列範例會顯示 RuntimePartitionSummary 元素的內容,指出總共會存取兩個分區 (分區 2 和 3)。
<RunTimePartitionSummary>
    <PartitionsAccessed PartitionCount="2" >
        <PartitionRange Start="2" End="3" />
    </PartitionsAccessed>
</RunTimePartitionSummary>
透過其他 showplan 方法顯示分割區資訊
顯示計劃方法 SHOWPLAN_ALL、SHOWPLAN_TEXT 和 STATISTICS PROFILE 不會報告本文所述的資料分割資訊,但有以下例外。 要存取的資料分割 (屬於 SEEK 述詞的一部分) 是由表示資料分割識別碼之計算資料行上的範圍述詞所識別。 下列範例會顯示 SEEK 運算子的 Clustered Index Seek 述詞。 系統會存取分區 2 和 3,且搜尋器會篩選符合 date_id BETWEEN 20190802 AND 20190902 條件的資料列。
|--Clustered Index Seek(OBJECT:([db_sales_test].[dbo].[fact_sales].[ci]),
        SEEK:([PtnId1000] >= (2) AND [PtnId1000] <= (3)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] >= (20190802)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] <= (20190902))
                ORDERED FORWARD)
解讀分區堆的執行計劃
分區的堆會被視為分區 ID 的邏輯索引。 在執行計畫中,分割堆上的分割消除以 Table Scan 一個運算子表示,並具有針對分割區識別碼的 SEEK 述詞。 下列範例會顯示所提供的執行程序表資訊:
|-- Table Scan (OBJECT: ([db].[dbo].[T]), SEEK: ([PtnId1001]=[Expr1011]) ORDERED FORWARD)
解譯共置聯結的執行計畫
當使用相同或等效的分割函數對兩個資料表進行分割,且查詢中聯結條件指定了來自聯結兩側的分割欄位時,會發生聯結對齊。 查詢最佳化工具可以產生一個計畫,好讓每一個資料表中具有相同資料分割識別碼的資料分割都會個別聯結。 共置聯結的速度快於非共置聯結,因為共置聯結所需的記憶體和處理時間比較少。 查詢最佳化工具會根據成本估計來選擇非共置計畫或共置計畫。
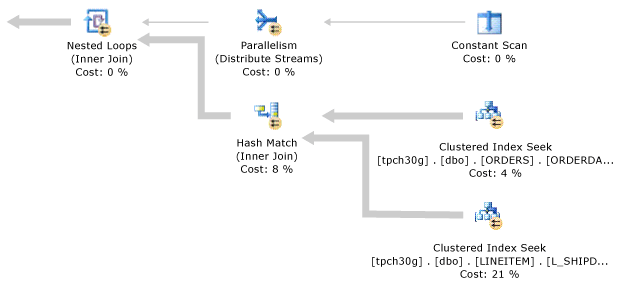
在共置計畫中,Nested Loops 連接會從內側讀取一個或多個已連接的資料表或索引分區。 在Constant Scan運算子內的數字表示分區編號。
當為分區資料表或索引生成共置聯結的平行計畫時,平行運算子會出現在 Constant Scan 與 Nested Loops 聯結運算子之間。 在此情況下,連接的外部有多個工作執行緒,這些執行緒各自讀取和處理不同的分區。
下圖將示範共置聯結的平行查詢計畫。
分區物件的平行查詢執行策略
查詢處理器會對於從分割區物件選取的查詢,使用平行處理策略。 在執行策略的一部分中,查詢處理器決定查詢所需的資料表分割區,以及分配給每一個分割區的工作執行緒比例。 在大多數情況下,查詢處理器會將相同或幾乎相同的工作線程數目配置給每一個分割區,然後以平行方式在分割區之間執行查詢。 以下段落將更詳細地說明工作執行緒的配置。
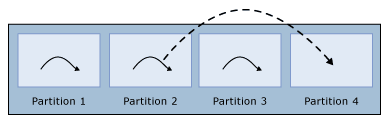
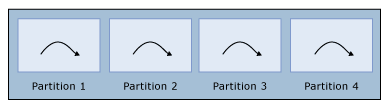
如果工作執行緒的數目小於分割數目,查詢處理器會將每個工作執行緒指派給不同的分割,最初會有一個或多個分割沒有被指派工作執行緒。 當一個工作執行緒在某分割區執行完畢後,查詢處理器會將其指派到下一個分割區,直到每個分割區都被分配到單一工作執行緒。 此指派是查詢處理器唯一會將工作執行緒重新分配到其他分割區的情況。
顯示工作執行緒在完成後被重新指派。 如果背景工作執行緒數目等於資料分割數目,則查詢處理器會將一個背景工作執行緒指派給每一個資料分割。 工作執行緒完成時,不會重新配置給另一個分區。
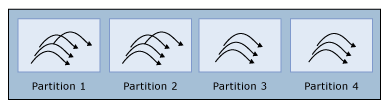
如果背景工作執行緒數目大於資料分割數目,則查詢處理器會將相同的背景工作執行緒數目指派給每一個資料分割。 如果工作執行緒的數量不是分割區數量的整數倍,查詢處理器會分配一個額外的工作執行緒給某些分割區,以使用所有可用的工作執行緒。 如果只有一個分割區,所有工作執行緒都會被分配到該分割區。 下圖中有四個分割區和 14 個工作執行緒。 每個分割區指派三個工作執行緒,另外兩個分割區有額外的工作執行緒,總共 14 個工作執行緒指派。 當工人執行緒完成時,不會將它重新指派給另一個分區。
雖然前述範例建議了一種直接分配工作執行緒的方法,但實際策略更為複雜,並考慮了查詢執行過程中發生的其他變數。 例如,若資料表已分割,且在資料行 A 上有叢集索引,而查詢具有述詞子句 WHERE A IN (13, 17, 25),則查詢處理器會將一個或多個工作執行緒分配給這三個搜尋值(A = 13、A = 17 和 A = 25),而非分配給每個資料表分割。 只需在包含這些值的分割區執行查詢,且如果所有這些 seek 謂詞都在同一個資料表分割區,所有工作執行緒都會被分配到同一個資料表分割區。
再舉一個例子,假設表格在 A 欄位上有四個分區,邊界點為(10,20,30),在 B 欄位上有一個索引,查詢有一個謂詞子句 WHERE B IN (50, 100, 150)。 由於資料表分割是以 A 的值為基礎,這些 B 值可以出現在任何資料表分割中。 因此,查詢處理器會在四個資料表分割中的每一個分割區中,尋找 B 的三個值(50、100、150)。 查詢處理器會按比例分配工作執行緒,以便能平行執行這 12 次查詢掃描中的每一個。
根據欄位的資料表分割區 A |
尋找每個資料表分割中的B欄位 |
|---|---|
表格分割區 1: A < 10 |
B = 50
B = 100
B = 150
|
表格分割區 2: A >= 10 AND A < 20 |
B = 50
B = 100
B = 150
|
資料表分割區 3:A >= 20 AND A < 30 |
B = 50
B = 100
B = 150
|
表格分割區 4: A >= 30 |
B = 50
B = 100
B = 150
|
最佳做法
為了提升從大型分割資料表和索引存取大量資料的查詢效能,請遵循以下最佳實務:
將每一個資料分割分散到多個磁碟上。 這種方法在使用旋轉式磁碟機時尤其重要。
盡可能使用具有充足主記憶體的伺服器,將經常存取的資料分割或所有資料分割納入記憶體中,以減少 I/O 成本。
如果你查詢的資料無法放入記憶體,就壓縮表格和索引以降低 I/O 成本。
請使用具有快速處理器的伺服器並盡量多使用您可以負擔的處理器核心,以充分利用平行查詢處理功能。
確定伺服器擁有足夠的 I/O 控制器頻寬。
在每一個大型分割資料表上建立叢集索引,以充分利用 B-tree 的掃描最佳化。
在大量載入資料到分割資料表時,請遵循白皮書《 資料載入效能指南》中的最佳實務建議。
範例
下列範例將建立一個測試資料庫,其中包含一個具有七個分割區的資料表。 若要同時查看編譯時與執行時計畫的分割資訊,請在本範例中執行查詢時,使用「 在查詢執行計畫中顯示分割資訊 」中所描述的工具。
注意
這個範例會將一百萬個以上的資料列插入資料表中。 執行此範例可能需要好幾分鐘的時間 (視您的硬體而定)。 在執行此範例之前,請確認有 1.5 GB 以上的磁碟空間可用。
USE master;
GO

IF DB_ID(N'db_sales_test') IS NOT NULL
    DROP DATABASE db_sales_test;
GO

CREATE DATABASE db_sales_test;
GO

USE db_sales_test;
GO

CREATE PARTITION FUNCTION pf_range_fact(INT)
    AS RANGE RIGHT
    FOR VALUES (20190801, 20190901, 20191001, 20191101, 20191201, 20200101);
GO

CREATE PARTITION SCHEME ps_fact_sales
    AS PARTITION pf_range_fact
    ALL TO ([PRIMARY]);
GO

CREATE TABLE fact_sales
(
    date_id INT,
    product_id INT,
    store_id INT,
    quantity INT,
    unit_price NUMERIC (7, 2),
    other_data CHAR (1000)
) ON ps_fact_sales (date_id);
GO

CREATE CLUSTERED INDEX ci
    ON fact_sales(date_id);
GO

PRINT 'Loading...';

SET NOCOUNT ON;

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 1000000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190800 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END
GO

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 10000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190900 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END

PRINT 'Done.';
GO

-- Two-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190802 AND 20190902
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO

-- Single-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190801 AND 20190831
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO