適用於: SQL ServerAzure SQL DatabaseAzure SQL 受控執行個體Azure Synapse AnalyticsMicrosoft Fabric 中的 SQL 分析端點Microsoft Fabric 中的倉庫Microsoft Fabric 中的 SQL 資料庫
查詢最佳化工具會使用統計資料來建立可改善查詢效能的查詢計劃。 對於大多數查詢,查詢優化器已經產生高品質查詢計畫所需的統計資料。 有時你需要建立額外的統計數據或修改查詢設計以達到最佳結果。 本文討論有效使用查詢最佳化統計資料的概念和指導方針。
元件和概念
統計資料
用於查詢最佳化的統計資料是二進位大型物件 (BLOB),其中包含資料表或索引檢視中一或多個資料行的值分佈統計資訊。 查詢最佳化工具會使用這些統計資料來估計查詢結果中的基數或資料列數目。 這些基數估計值可讓查詢最佳化工具建立高品質的查詢計劃。 例如,根據您的述詞而定,查詢最佳化工具可使用基數估計值來選擇索引搜尋運算子,而非需要更大量資源的索引掃描運算子 (如果這樣做會改善查詢效能)。
每個統計資料物件都是針對一或多個資料表資料行的清單所建立,其中包含「長條圖」以顯示第一個資料行中的值分佈狀態。 多個資料行的統計資料物件也會儲存這些資料行之間值相互關聯的相關統計資料。 這些相關統計資料,或稱 密度,源自於資料行值相異的資料列數量。
Histogram
直方圖用於顯示資料集中每個相異值的出現頻率。 查詢最佳化程式會針對統計資料物件中第一個索引鍵資料行的資料行值計算直方圖,這些資料行值是透過以統計抽樣方式選取資料列,或完整掃描資料表或檢視表中的所有資料列而取得。 如果從取樣的數據列集建立直方圖,則數據列數目和相異值數目的預存總計是估計值,而且不需要是整數。
Note
SQL Server 只為單一欄位建立直方圖——即統計物件鑰匙欄位集合的第一欄。
為了建立長條圖,查詢最佳化工具會排序資料行值、計算符合每一個相異資料行值的值數目,然後將資料行值彙總成最多 200 個連續長條圖步驟。 每一個長條圖步驟都包含某個範圍的資料行值,後面緊接著上限資料行值。 此範圍包括界限值之間的所有可能資料行值,但是不包括界限值本身。 最低的已排序資料行值就是第一個長條圖步驟的上限值。
更詳細來說,SQL Server 會以下列三個步驟,從已排序的資料行值集合來建立長條圖:
- 長條圖初始化:第一個步驟會從已排序的集合開頭處理一連串值,並收集最多 200 個 range_high_key、equal_rows、range_rows 和 distinct_range_rows 的值 (在此步驟中,range_rows 和 distinct_range_rows 一律為零)。 第一步會在所有輸入用盡或找到 200 個值時結束。
- 以分桶合併方式掃描:統計鍵前導欄位中的每個額外值,都會在第二個步驟中依排序順序處理。 每個後續的值要麼併入最後一個區間,要麼在末尾建立一個新的區間(之所以能依此順序處理,是因為輸入值已經排好序)。 若建立新範圍,該過程會將一對現有相鄰範圍合併為單一範圍。 系統會選取這一組範圍,以將資訊遺失的機率降至最低。 此方法會使用「最大差異」演算法,讓長條圖中的步驟數減至最少,同時讓界限值之間的差異最大化。 在這整個步驟期間,範圍摺疊之後的步驟數目仍然為 200。
- 直方圖匯總:在第三個步驟中,如果不會遺失大量資訊,可以合併更多區間。 直方圖的區段數可以少於相異值的數量,即使對於邊界點少於 200 個的資料行也是如此。 因此,即使資料行具有超過 200 個唯一值,長條圖仍可能只需 200 個以下的步驟。 對於僅由唯一值組成的欄位,合併直方圖至少有三個步驟。
Note
如果直方圖是用樣本而非全掃描建立, equal_rows、 range_rows、 distinct_range_rows 和 average_range_rows 的值都是估計值,因此不需要是整數。
下列圖表顯示一個包含六個步驟的直方圖。 第一個上限值左側的區域就是第一個步驟。
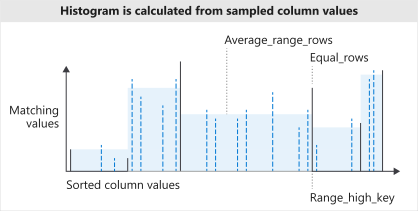
針對上一個範例中的每個直方圖步驟:
粗線代表上界值(range_high_key)及其出現次數(equal_rows)。
range_high_key 左側的實心區域代表欄位值的範圍及每個欄位值出現的平均次數(average_range_rows)。 第一個直方圖步驟的 average_range_rows 一律為 0。
虛線代表用來估計區間內不同值總數(distinct_range_rows)及區間內總數值(range_rows)的取樣值。 查詢優化器會使用 range_rows 和 distinct_range_rows 來計算 average_range_rows ,而且不會儲存取樣的值。
密度向量
密度 是指定數據行或數據行組合中重複次數的相關信息,其計算方式為 1/(相異值的數目)。 查詢最佳化工具會使用密度來增強查詢的基數預估,這些查詢會從相同的資料表或索引檢視表傳回多個資料行。 當密度降低時,值的選擇性會增加。 例如,在表示車種的資料表中,許多車種的製造商都是相同的,但每輛車都有一個唯一的汽車識別號碼。 由於 VIN 的密度比製造商低,因此 VIN 的索引會比製造商的索引更具選擇性。
Note
「頻率」是統計資料物件第一個索引鍵資料行中每一個相異值的發生次數資訊,其計算方式為 row count * density。 如果資料行具有唯一值,則其最大頻率為 1。
密度向量對統計資料物件中資料行的每個前綴各包含一個密度值。 例如,若統計物件的鍵欄位為 CustomerId、 ItemId、 和 Price,則密度會計算在後面的每個欄位前綴上。
| 欄前綴 | 計算密度的依據 |
|---|---|
(CustomerId) |
與 CustomerId 的值相符的資料列 |
(CustomerId, ItemId) |
與 CustomerId 和 ItemId 的值相符的資料列 |
(CustomerId、ItemId、Price) |
與 CustomerId、ItemId 和 Price 的值相符的資料列 |
過濾統計資料
對於從定義完善的資料子集中選取的查詢而言,篩選的統計資料可以改善查詢效能。 篩選的統計資料會使用篩選述詞來選取統計資料中所含的資料子集。 設計完善的篩選統計資料可以改善查詢執行計畫 (相較於完整資料表統計資料而言)。 關於濾波器謂詞的更多資訊,請參見 CREATE STATISTICS。 如需何時要建立篩選統計資料的詳細資訊,請參閱本文的何時建立統計資料一節。
統計資料選項
你可以設定影響系統何時以及如何建立和更新統計資料的選項。 這些選項只能在資料庫層級設定。
AUTO_CREATE_STATISTICS 選項
AUTO_CREATE_STATISTICS開啟自動建立統計選項時,查詢優化器會根據需要對查詢謂詞中的個別欄位建立統計數據,以改善查詢計畫的基數估計值。 這些單一資料行統計資料是針對在現有統計資料物件中尚未具有長條圖的資料行建立的。 這個 AUTO_CREATE_STATISTICS 選項並不決定資料庫是否會為索引建立統計資料。 此選項也不會產生篩選的統計數據。 它僅嚴格適用於整個資料表的單一資料行統計資料。
當查詢最佳化工具因使用 AUTO_CREATE_STATISTICS 選項而產生統計資料時,統計資料名稱就會以 _WA 作為開頭。 您可以使用以下查詢來判斷查詢優化器是否為查詢謂詞欄位建立了統計資料。
SELECT OBJECT_NAME(s.object_id) AS object_name,
    COL_NAME(sc.object_id, sc.column_id) AS column_name,
    s.name AS statistics_name
FROM sys.stats AS s
    INNER JOIN sys.stats_columns AS sc
        ON s.stats_id = sc.stats_id
        AND s.object_id = sc.object_id
WHERE s.name LIKE '_WA%'
ORDER BY s.name;
AUTO_UPDATE_STATISTICS 選項
AUTO_UPDATE_STATISTICS,當你開啟自動更新統計選項時,查詢優化器會判斷統計資料何時可能過時,並在查詢使用時更新統計資料。 此動作也稱為統計資料重新編譯。 當插入、更新、刪除或合併作業所做的修改變更資料表或索引檢視表中的資料分佈之後,統計資料就會變成過期。 查詢優化器會計算自上次統計更新以來的資料列修改次數,並將該數字與閾值比較,以判斷統計數據是否可能過時。 閾值是基於表格基數,也就是表格或索引視圖中的列數。
即使選項 AUTO_UPDATE_STATISTICS 為 OFF,仍會根據列修改將統計數據標記為過時。 當選項 AUTO_UPDATE_STATISTICS 為 OFF時,系統不會更新統計數據,即使它標記為過時。 計劃會繼續使用過期的統計數據物件。 設定 AUTO_UPDATE_STATISTICS 為 OFF 可能會導致查詢計畫不佳,查詢效能下降。 將選項設 AUTO_UPDATE STATISTICS 為 ON。
截至 SQL Server 2014 (12.x) 為止,資料庫引擎會使用以評估統計資料時資料表或索引檢視表中的資料列數為基礎的重新編譯臨界值。 這個閾值會根據表格是暫時還是永久而有所不同。
數據表類型 資料表基數 (n) 重新編譯閾值 (修改次數) Temporary n< 6 6 Temporary 6 <= n<= 500 500 Permanent n<= 500 500 暫時或永久 N> 500 500 + (0.20 * n) 舉例來說,如果你的資料表有 20,000 列,計算結果為
500 + (0.2 * 20,000) = 4,500,而且統計資料會每 4,500 次修改更新一次。從 SQL Server 2016(13.x)開始,且資料庫相容性等級為 130 時,資料庫引擎會使用遞減的動態統計資料重新編譯臨界值,並根據評估統計資料時的資料表基數進行調整。 透過這項變更,大型數據表上的統計數據會更頻繁地更新。 然而,若資料庫相容性等級低於 130,則適用 SQL Server 2014(12.x)的門檻。
數據表類型 資料表基數 (n) 重新編譯閾值 (修改次數) Temporary n < 66 Temporary 6 <= n <= 500500 Permanent n <= 500500 暫時或永久 n > 500MIN ( 500 + (0.20 * n), SQRT(1,000 * n) )例如,如果資料表包含 200 萬列,則計算結果為
500 + (0.20 * 2,000,000) = 400,500和SQRT(1,000 * 2,000,000) = 44,721兩者中的較小值。 這表示統計數據會每 44,721 個修改更新一次。
Important
在 SQL Server 2008 R2 (10.50.x) 到 SQL Server 2014 (12.x),或在 SQL Server 2016 (13.x) 和更新版本且在資料庫相容性層級 120 和更低版本中,啟用追蹤旗標 2371,讓 SQL Server 使用遞減的動態統計資料更新閾值。
雖然建議在所有情況下都啟用追蹤旗標 2371,但這並非必要。 但您可以使用下列指導方針,在 SQL Server 2016 (13.x) 之前版本的環境中啟用追蹤旗標 2371:
- 如果您是在 SAP 系統上,請啟用此追蹤。 如需詳細資訊,請參閱這篇有關追蹤旗標 2371 的部落格文章。
- 如果你必須依賴夜間工作來更新統計資料,因為目前的自動更新不夠頻繁,可以考慮啟用追蹤旗標 2371,將閾值調整為表格基數。
在編譯查詢及執行快取查詢計劃之前,查詢最佳化工具會檢查是否有過期的統計資料。 在編譯查詢之前,查詢優化器會使用查詢述詞中的數據行、數據表和索引檢視表來判斷哪些統計數據可能過期。 在執行快取的查詢計劃之前,資料庫引擎會驗證該查詢計劃是否參考 up-to日期統計資料。
此 AUTO_UPDATE_STATISTICS 選項適用於為索引建立的統計物件、查詢謂詞中的單欄,以及使用該 CREATE STATISTICS 語句建立的統計資料。 此外,這個選項也會套用至篩選的統計資料。
你可以用 sys.dm_db_stats_properties 精確追蹤表格中變更的列數,並決定是否要手動更新統計資料。
AUTO_UPDATE_STATISTICS 對於記憶體最佳化資料表一律為 OFF。
AUTO_UPDATE_STATISTICS_ASYNC
非同步統計資料更新選項 AUTO_UPDATE_STATISTICS_ASYNC 會決定查詢最佳化工具要使用同步或非同步統計資料更新。 預設情況下,非同步統計更新選項為 OFF,查詢優化器則同步更新統計資料。 此 AUTO_UPDATE_STATISTICS_ASYNC 選項適用於為索引建立的統計物件、查詢謂詞中的單欄,以及使用該 CREATE STATISTICS 語句建立的統計資料。
Note
若要在 SQL Server Management Studio 中設定非同步更新統計資料選項,請在 資料庫屬性 視窗的 選項 頁面中,將 自動更新統計資料 和 非同步自動更新統計資料 都設為 True。
統計資料更新可以是同步 (預設值) 或非同步。
使用同步統計資料更新時,查詢一律會依據最新的統計資料進行編譯和執行。 當統計資料過期時,查詢最佳化工具會先等待統計資料更新,再編譯並執行查詢。
使用非同步統計資料更新時,即使現有的統計資料已過期,查詢仍會依據現有的統計資料進行編譯。 如果查詢編譯時統計資料已過期,則查詢最佳化工具可能會選擇次佳的查詢計畫。 統計資料通常會在之後立即更新。 在統計數據更新之後編譯的查詢會從使用更新的統計數據中獲益。
當您執行變更資料分佈的作業時 (例如截斷資料表,或大量更新大部分的資料列),請考慮使用同步統計資料。 如果你在完成操作後沒有手動更新統計資料,使用同步統計可確保在查詢需要這些統計資料之前,統計資料已保持在最新狀態。
在下列狀況中,請考慮使用非同步統計資料來達到更可預測的查詢回應時間:
您的應用程式經常會執行相同的查詢、相似的查詢或相似的快取查詢計劃。 相較於使用同步統計資料更新,使用非同步統計資料更新可能會讓您更容易預測查詢的回應時間,因為查詢最佳化工具不需要等候最新的統計資料,就可以執行傳入的查詢。 這樣會避免延遲某些查詢,但無法避免延遲其他查詢。
您的應用程式曾因一個或多個查詢等待更新統計而產生客戶端請求逾時。 在某些情況下,等待同步統計可能導致逾時過激的應用程式失敗。
Note
本地暫存資料表的統計資料無論採用 AUTO_UPDATE_STATISTICS_ASYNC 哪種方式都會同步更新。 全域暫存資料表的統計資料會根據 AUTO_UPDATE_STATISTICS_ASYNC 使用者資料庫的選項集同步或非同步更新。
非同步統計資料更新是由背景要求執行的。 當此要求準備將更新後的統計資料寫入資料庫時,會嘗試取得統計資料中繼資料物件上的結構描述修改鎖定。 如果不同工作階段已取得相同物件的鎖定,非同步統計資料更新即會遭到封鎖,直到可取得結構描述修改鎖定為止。 同樣地,為了編譯查詢而需要在統計資料中繼資料物件上取得結構描述穩定性 (Sch-S) 鎖定的工作階段,也可能遭非同步統計資料更新背景工作階段封鎖,因為後者已持有或正在等候取得結構描述修改鎖定。 因此,針對需要經常進行查詢編譯和統計資料更新的工作負載,使用非同步統計資料會增加因鎖定封鎖而產生並行問題的可能性。
在 Azure SQL Database、Azure SQL 受控執行個體,以及從 SQL Server 2022(16.x)開始,如果你啟用ASYNC_STATS_UPDATE_WAIT_AT_LOW_PRIORITY資料庫範圍設定,可以使用非同步統計更新來避免潛在的並發問題。 啟用此設定后,背景要求會等候取得架構修改 (Sch-M) 鎖定,並將更新的統計數據保存在個別低優先順序佇列上,讓其他要求繼續編譯具有現有統計數據的查詢。 一旦沒有其他會話在統計資料元物件上持有鎖定,背景請求便會取得架構修改鎖定,進而更新統計資料。 在極少數情況下,如果背景要求在長達數分鐘的逾時期間內仍無法取得鎖定,非同步統計資料更新就會中止,而且在再次觸發自動統計資料更新之前,或在統計資料手動更新之前,統計資料都不會更新。
Note
ASYNC_STATS_UPDATE_WAIT_AT_LOW_PRIORITY資料庫範圍化的設定選項可在 Azure SQL Database、Azure SQL 受控執行個體 以及自 SQL Server 2022 (16.x) 起的 SQL Server 中取得。
AUTO_DROP 選項
適用於:Azure SQL Database、Azure SQL 受控執行個體,以及從 SQL Server 2022 (16.x) 開始
在 SQL Server 2022(16.x)之前的 SQL Server 中,如果你手動建立統計資料或使用第三方工具管理使用者資料庫,這些統計物件可能會阻擋或干擾結構變更。
從 SQL Server 2022 (16.x) 開始,預設會在所有新的和已移轉的資料庫上啟用自動卸除選項。 如果你啟用這個 AUTO_DROP 屬性,資料庫會以一種模式建立統計物件,使得後續的結構變更 不會 被統計物件阻擋,而是在必要時丟棄統計資料。 如此一來,已啟用自動卸除的手動建立統計資料,其行為就像自動建立的統計資料一樣。
在Azure SQL Database、Azure SQL 受控執行個體,以及 2022 SQL Server(16.x)及之後版本中,自動產生的統計數據總是表現得像是AUTO_DROP已啟用。
Note
嘗試在自動建立的統計資料上設定或取消設定自動卸除屬性,會引發錯誤。 自動建立的統計資訊一律會使用自動卸除功能。 還原時,某些備份的此屬性會設定不正確,直到下次統計資料物件更新 (手動或自動) 為止。 不過,自動建立的統計資料一律會以和自動卸除統計資料相同的方式運作。 從舊版還原資料庫至 SQL Server 2022 (16.x) 時,建議在資料庫上執行 sp_updatestats ,設定統計數據自動卸除功能的適當元數據。
例如,若要在 dbo.DatabaseLog 資料表上手動建立統計資料物件:
CREATE STATISTICS [mystats]
    ON [dbo].[DatabaseLog]([DatabaseLogID], [PostTime], [DatabaseUser])
    WITH AUTO_DROP = ON;
例如,若要在 dbo.DatabaseLog 資料表上更新統計資料物件自動卸除設定:
UPDATE STATISTICS [dbo].[DatabaseLog] ([mystats])
    WITH AUTO_DROP = ON;
若要評估現有統計資料的自動卸除設定,請使用 auto_drop 中的 sys.stats 資料行:
SELECT object_id,
       [name],
       auto_drop
FROM sys.stats;
如需詳細資訊,請參閱 AUTO_DROP。
INCREMENTAL
適用於:SQL Server 2014 (12.x) 和更新版本。
當你將 INCREMENTAL 的 CREATE STATISTICS 選項設為 ON 時,就會建立每個分割區的統計資料。 當你設定為 OFF時,資料庫會丟棄統計樹並重新計算統計數據。 預設值為 OFF。 此設定會覆蓋資料庫層級 INCREMENTAL 的特性。
- 欲了解更多關於建立增量統計的資訊,請參見 CREATE STATISTICS。
- 欲了解更多如何自動建立每個分割區統計的資訊,請參閱 資料庫屬性(選項頁面) 及 ALTER DATABASE SET 選項。
當你在大型資料表中新增分割區時,應該更新統計資料以包含這些新分割區。 然而,掃描整個表格(FULLSCAN 或 SAMPLE 選項)所需的時間可能會很長。 此外,由於可能只需要新分割區區的統計資料,所以不需要掃描整個資料表。 增量選項則依每個分割區建立並儲存統計資料,更新後僅刷新需要新統計資料的分割區的統計資料。
如果不支援每個分割區的統計,資料庫會忽略這個選項並產生警告。 以下統計類型不支援增量統計:
- 使用未與基底資料表的分割區對齊之索引建立的統計資料。
- 在 Always On 可讀取的次要資料庫上建立的統計資料。
- 在唯讀資料庫上建立的統計資料。
- 在篩選的索引上建立的統計資料。
- 在檢視上建立的統計資料。
- 在內部資料表上建立的統計資料。
- 使用空間索引或 XML 索引建立的統計資料。
何時建立統計資料
查詢最佳化工具已經用下列方式建立統計資料:
當你在資料表或檢視上建立索引時,查詢優化器會為索引建立統計數據。 這些統計資料是在索引的索引鍵資料行上建立的。 如果索引是篩選的索引,查詢最佳化工具就會在針對篩選索引所指定的相同資料列子集上建立篩選的統計資料。 欲了解更多有關篩選索引的資訊,請參見 建立篩選索引 及 CREATE INDEX。
Note
在 SQL Server 2014(12.x)及之後版本中,資料庫在建立或重建分割索引時,不會掃描表格中的所有列來產生統計資料。 反之,查詢最佳化工具會使用預設的取樣演算法來產生統計資料。 升級具有分割區索引的資料庫之後,可能會注意到這些索引之長條圖資料的差異。 此行為變更可能不會影響查詢效能。 若要透過掃描資料表中的所有資料列來取得分割索引的統計資料,請使用
CREATE STATISTICS或UPDATE STATISTICS搭配FULLSCAN子句。開啟 AUTO_CREATE_STATISTICS 時,查詢最佳化工具會針對查詢述詞中的單一資料行建立統計資料。
對於大多數查詢,這兩種統計產生方法確保查詢計畫品質優良。 在某些情況下,你可以透過使用 CREATE STATISTICS 陳述式建立額外的統計數據來改善查詢計畫。 這些額外的統計數據可以擷取查詢優化器在建立索引或單一數據行統計數據時不會考慮的統計相互關聯。 您的應用程式可能會在資料表資料中具有其他統計相互關聯,如果它們計算成統計資料物件,就可讓查詢最佳化工具改善查詢計劃。 例如,資料列子集的篩選統計資料或查詢述詞資料行的多重資料行統計資料可能會改善查詢計劃。
當您使用 CREATE STATISTICS 陳述式建立統計資料時,請將 AUTO_CREATE_STATISTICS 選項維持為 ON,讓查詢最佳化工具持續定期為查詢述詞資料行建立單一資料行統計資料。 如需查詢述詞的詳細資訊,請參閱 搜尋條件。
當符合以下任一條件時,請考慮使用該 CREATE STATISTICS 陳述來建立統計:
- Database Engine Tuning Advisor 建議您建立統計資料。
- 查詢謂詞包含多個在同一索引中尚未成為索引鍵的相互關聯欄。
- 查詢會從資料子集中選取。
- 查詢具有遺失的統計資料。
Note
如需記憶體內部 OLTP 相關資料表和統計資料的特定資訊,請參閱經記憶體最佳化的資料表統計資料。
查詢謂詞包含多個相關欄位
當查詢述詞包含多個具有跨資料行關聯性與相依性的資料行時,多個資料行的統計資料可能會改善查詢計劃。 多個數據行的統計數據包含單一數據行統計數據中無法使用的跨數據行相互關聯統計數據,稱為 密度。 當查詢結果相依於多個資料行之間的資料關聯性時,密度可以改善基數估計值。
如果欄位已經在同一索引中,表示多欄位統計物件已經存在,你不需要手動建立它。 如果欄位不在同一索引中,你可以透過在欄位上建立索引或使用 陳述 CREATE STATISTICS 句來建立多欄位統計。 維護索引比維護統計資料物件需要更多系統資源。 如果應用程式不需要多重數據行索引,您可以藉由建立統計數據物件而不建立索引來省去系統資源。
當您建立多重數據行統計數據時,統計數據物件定義中的數據行順序會影響建立基數估計值的密度有效性。 統計資料物件會將索引鍵資料行之每個前置詞的密度儲存在統計資料物件定義中。 欲了解更多密度資訊,請參閱本文的 密度 章節。
若要建立可用於基數估計的密度,查詢述詞中的資料行必須符合統計資料物件定義中其中一個資料行前綴。 例如,以下範例會在資料行 LastName、MiddleName 和 FirstName 上建立多欄統計物件。
Note
在 Azure SQL Database 和 Microsoft Fabric 中的 SQL 資料庫中,USE 陳述式無法使用。 相反地,直接連接到預期的資料庫,執行剩餘的程式碼範例。
USE AdventureWorks2022;
GO

IF EXISTS (SELECT name
           FROM sys.stats
           WHERE name = 'LastFirst'
                 AND object_ID = OBJECT_ID('Person.Person'))
    DROP STATISTICS Person.Person.LastFirst;
GO

CREATE STATISTICS LastFirst
    ON Person.Person(LastName, MiddleName, FirstName);
GO
在這則範例中,統計資料物件 LastFirst 具有下列資料行前置詞的密度:(LastName)、(LastName, MiddleName) 和 (LastName, MiddleName, FirstName)。 密度不適用於 (LastName, FirstName)。 如果查詢使用 LastName 且 FirstName 不使用 MiddleName,則密度不適用於基數估計值。
查詢從資料子集中選取資料
當查詢最佳化工具針對單一資料行和索引建立統計資料時,它就會針對所有資料列中的值建立統計資料。 當查詢從資料列的子集中選取,而且該資料列子集具有唯一的資料分佈時,篩選的統計資料就可以改善查詢計劃。 你可以使用含有 CREATE STATISTICS 子句的 陳述式來定義篩選述詞運算式,藉此建立篩選統計資料。
例如,使用 AdventureWorks2025 時,表格中的Production.Product每個產品都屬於表中Production.ProductCategory四個類別之一:Bikes、 ComponentsClothingAccessories和 。 各類別的重量資料分佈各不相同:自行車的重量範圍為 13.77 到 30.0,元件的重量範圍為 2.12 到 1050.00,其中有些值為 NULL,服飾的重量皆為 NULL,而配件的重量也皆為 NULL。
以 Bikes 範例為例,所有自行車重量的篩選統計數據都會為查詢優化器提供更精確的統計數據,而且相較於完整數據表統計數據或重量數據行上不存在的統計數據,可以改善查詢計劃品質。 腳踏車重量資料行很適合作為篩選統計資料,但如果重量查詢的次數相對較少,則未必適合作為篩選索引。 篩選索引為查閱所提供的效能提升程度可能不會超過將篩選索引加入至資料庫的額外維護和儲存成本。
下列語句會在 BikeWeights 的所有子類別 Bikes上建立篩選的統計數據。 篩選後的述詞表達式會使用比較 Production.ProductSubcategoryID IN (1,2,3) 列舉所有腳踏車子類別,藉此定義腳踏車。 述詞無法使用 Bikes 類別名稱,因為它儲存在數據表中 Production.ProductCategory ,而且篩選表達式中的所有數據行都必須位於相同的數據表中。
USE AdventureWorks2022;
GO
IF EXISTS ( SELECT name FROM sys.stats
    WHERE name = 'BikeWeights'
    AND object_ID = OBJECT_ID ('Production.Product'))
DROP STATISTICS Production.Product.BikeWeights;
GO
CREATE STATISTICS BikeWeights
    ON Production.Product (Weight)
WHERE ProductSubcategoryID IN (1,2,3);
GO
查詢最佳化工具可以使用 BikeWeights 篩選統計資料,來針對下列會選取所有重量超過 25 之腳踏車的查詢,改善其查詢計劃。
SELECT P.Weight AS Weight,
       S.Name AS BikeName
FROM Production.Product AS P
     INNER JOIN Production.ProductSubcategory AS S
         ON P.ProductSubcategoryID = S.ProductSubcategoryID
WHERE P.ProductSubcategoryID IN (1, 2, 3)
      AND P.Weight > 25
ORDER BY P.Weight;
GO
查詢會識別遺失的統計資料
如果有錯誤或其他事件讓查詢最佳化工具無法建立統計資料,查詢最佳化工具會在不使用統計資料的情況下建立查詢計劃。 查詢最佳化工具會將統計資料標示為遺失,並且嘗試在下一次執行查詢時重新產生統計資料。
當查詢的執行計畫是利用 SQL Server Management Studio 以圖形顯示時,系統即會以警告指出遺失的統計資料 (以紅字顯示資料表名稱)。 此外,使用 SQL Server Profiler 監視 缺少資料行統計資料 事件類別,可指出何時缺少統計資料。 如需詳細資訊,請參閱錯誤和警告事件類別目錄 (資料庫引擎)。
如果統計資料已遺失,請執行下列步驟:
- 確認 AUTO_CREATE_STATISTICS 和 AUTO_UPDATE_STATISTICS 已設為 ON。
- 確認資料庫不是唯讀的。 如果資料庫是唯讀的,就無法儲存新的統計數據物件。
- 透過使用 CREATE STATISTICS 陳述式來建立缺失的統計數據。
臨時統計
如果唯讀資料庫或唯讀快照集上的統計資料遺漏或過時,資料庫引擎會在 tempdb 中建立及維護暫時統計資料。 當資料庫引擎建立暫時統計資料時,統計資料名稱會附加後置詞 _readonly_database_statistic,以便區分暫時統計資料與永久統計資料。 後綴 _readonly_database_statistic 保留給資料庫引擎產生的統計資料。 臨時統計的腳本可以在讀寫資料庫中建立並執行。 以指令碼形式產生時,Management Studio 會將統計資料名稱的尾碼從 _readonly_database_statistic 變更為 _readonly_database_statistic_scripted。
只有資料庫引擎能建立並更新暫時統計資料。 但是,您可以使用永久統計資料所使用的相同工具來刪除暫時統計資料及監控統計資料屬性:
- 使用該 DROP STATISTICS 陳述刪除臨時統計資料。
- 使用 sys.stats 和 sys.stats_columns 目錄檢視監視統計資料。
sys.stats系統目錄檢視包含is_temporary資料行,以指示哪些統計資料為永久性及哪些統計資料為暫時性。
由於暫存統計資料儲存在 tempdb,重新啟動資料庫引擎會移除所有暫存統計資料。
就像所有統計資料一樣,建立和更新暫時性統計需要對物件進行 schema 修改 (Sch-M) 鎖定。 此鎖定可能阻擋其他查詢與程序,包括對次要副本進行系統重做程序,該程序將主要副本的交易套用。 如果這種阻擋影響到了查詢工作負載或資料傳播,你可以停用自動建立READABLE_SECONDARY_TEMPORARY_STATS_AUTO_CREATE與更新READABLE_SECONDARY_TEMPORARY_STATS_AUTO_UPDATE暫時性統計資料的功能,這些功能是使用資料庫範圍設定的。
何時更新統計資料
查詢優化器會判斷統計數據何時可能過時,並在需要時更新以符合查詢計畫。 在某些情況下,與 AUTO_UPDATE_STATISTICS 為ON時相比,更頻繁地更新統計資料可以改善查詢計畫,進而改善查詢效能。 你可以透過 陳述 UPDATE STATISTICS 句或儲存程序 sp_updatestats來更新統計資料。
更新統計資料可確保查詢使用最新的統計資料進行編譯。 透過任何流程更新統計資料,都可能使查詢計畫自動重新編譯。 不要太頻繁手動更新統計資料,因為改進查詢計畫和重新編譯查詢所需的時間之間存在效能取捨。 特定的權衡取捨完全取決於您的應用程式。
當你用 UPDATE STATISTICS 或 sp_updatestats更新統計時,請將 AUTO_UPDATE_STATISTICS 設定為 ON ,這樣查詢優化器才能定期更新統計數據。
欲了解更多如何更新欄位、索引、表格或索引檢視的統計資訊,請參見 UPDATE STATISTICS。
如需如何更新資料庫中所有使用者定義和內部數據表統計數據的相關信息,請參閱預存程式 sp_updatestats。
如需自動更新統計資料閾值的詳細資訊,請參閱 AUTO_UPDATE_STATISTICS 選項。
當你設定 AUTO_UPDATE_STATISTICS 為 OFF時,計畫重新編譯仍可能因其他原因發生,但由於統計資料過時,無法自動進行。 當你設定 AUTO_UPDATE_STATISTICS 為 OFF時,統計更新只會透過其他手動排程流程進行,例如維護計畫。 因此,設定 AUTO_UPDATE_STATISTICS 為 OFF 可能導致查詢計畫不佳,查詢效能下降。
偵測過期的統計資料
若要判斷上次更新統計資料的時間,請使用 sys.dm_db_stats_properties 或 STATS_DATE 函式。
在下列狀況中,請考慮更新統計資料:
- 查詢執行時間很慢。
- 插入作業會在遞增或遞減的索引鍵資料行上發生。
- 在維護作業之後。
關於手動更新統計的範例,請參見 UPDATE STATISTICS。
查詢執行時間很慢
如果查詢回應時間很慢或無法預測,請先確定查詢具有最新的統計資料,然後再執行其他疑難排解步驟。
插入作業發生於遞增或遞減的索引鍵資料行上
對於升降鍵欄位(如 IDENTITY 即時時間戳欄位)的統計資料,可能需要比查詢優化器更頻繁的統計更新。 插入作業會將新值加入遞增或遞減排序的資料行中。 所加入的資料列數目可能會太小,而無法觸發統計資料更新。 如果統計數據未 up-to-date,而且從最近新增的數據列選取查詢,則目前的統計數據沒有這些新值的基數估計值。 此條件可能導致基數估計不準確及查詢效能緩慢。
例如,若查詢從最近的銷售訂單日期中選擇,若統計數據未更新以包含最近銷售訂單日期的基數估計,則基數估計不準確。
維護作業後
在執行變更資料分佈的維護程序 (例如截斷資料表或針對大部分的資料列執行大量插入) 之後,請考慮更新統計資料。 主動更新統計資料可避免日後查詢在等待自動更新統計資料時,於查詢處理方面發生延遲。
重建、重組或重新組織索引等作業不會變更數據的分佈。 因此,執行 REBUILD、ALTER INDEXDBCC INDEXDEFRAG 或 REORGANIZE 操作後ALTER INDEX,你不需要更新統計資料。 當您使用 ALTER INDEX REBUILD 或 DBCC DBREINDEX 來重建資料表或檢視表的索引時,查詢最佳化工具就會更新統計資料。不過,這種統計資料更新是重新建立索引的副產品。 查詢優化器不會在DBCC INDEXDEFRAG或ALTER INDEX REORGANIZE 作業之後更新統計數據。
Tip
從 SQL Server 2016(13.x)SP1 CU4 開始,請使用 PERSIST_SAMPLE_PERCENT 選項CREATE STATISTICSUPDATE STATISTICS,設定並保留特定的抽樣百分比,以便後續統計更新時不明確指定抽樣百分比。
自動索引與統計資料管理
利用自適性索引子磁碟重組等智慧解決方案,為一或多個資料庫自動管理索引重組以及統計資料更新。 此程序會自動選擇是否根據索引的碎片程度等參數重建或重組,並以線性閾值更新統計數據。
確定查詢優化器使用了哪些統計數據
你可以透過檢視估計值或實際 執行計畫,找到查詢優化器編譯查詢時所使用的統計物件。 當您檢查執行計畫時,OptimizerStatsUage 元素會包含 StatisticsInfo 元素,而這些元素含有查詢最佳化工具在編譯期間載入之統計資料物件的相關資訊。 這些 StatisticsInfo 元素包含統計物件名稱、其所屬的資料庫、架構與資料表、編譯時的修改次數、取樣百分比,以及最後更新的時間。
請使用以下任一技術來檢查執行計畫:
- 在 SQL Server Management Studio 中,執行查詢前選擇「包含實際執行計畫」(Ctrl+M)。 在顯示結果的 執行計畫 標籤中,你可以:
- 在圖形化計畫內點右鍵,選擇 「顯示執行計畫 XML」。 尋找
OptimizerStatsUsage元素及其每個子StatisticsInfo元素。 - 選擇最後一個(最左邊)的操作符。 (查詢
SELECT時,此運算元為SELECT節點。)在 屬性 視窗中,展開 OptimizerStatsUsage 節點,查看查詢中使用的統計物件資訊。
- 在圖形化計畫內點右鍵,選擇 「顯示執行計畫 XML」。 尋找
- 在查詢前執行 SETSET STATISTICS XML ON 。 選擇結果中出現的超連結以查看執行計畫的 XML。
- 查詢 sys.dm_exec_query_plan 或 sys.dm_exec_query_statistics_xml 查詢近期查詢。
- 使用sys.query_store_plan閱讀先前從查詢存放區捕捉的計畫。
每個 StatisticsInfo 元素看起來像是範例資料庫查詢 AdventureWorks2022 中的以下 XML 片段:
<StatisticsInfo
    Database="[AdventureWorks2022]"
    Schema="[Sales]"
    Table="[SalesOrderDetail]"
    Statistics="[IX_SalesOrderDetail_ProductID]"
    ModificationCount="0"
    SamplingPercent="100"
    LastUpdate="2025-09-07T15:32:16.89" />
| Attribute | Meaning |
|---|---|
Database、Schema、Table |
統計量所屬的物件。 |
Statistics |
資料庫中統計物件的名稱。 使用這個名稱與 DBCC SHOW_STATISTICS 或 sys.stats 一起檢查直方圖和密度向量。 |
ModificationCount |
自統計數據最後更新以來,計畫編制時的資料修改次數。 相對於表格大小的值過大表示統計量在編譯過程中已過時。 |
SamplingPercent |
取樣行的百分比以建立統計量。 較低的數值會導致偏斜資料的直方圖準確度降低。 |
LastUpdate |
最後統計更新的時間戳記。 若資料庫啟用 AUTO_UPDATE_STATISTICS 選項,資料庫會在需要時自動更新統計資料。 |
Note
StatisticsInfo 反映計畫編制過程中可用並考慮的統計數據。 如果 StatisticsInfo 查詢篩選的欄位缺少某個項目,查詢優化器沒有找出相關的統計數據,這可能是效能不佳的來源。
要檢查統計物件的當前新鮮度與修改次數,請使用 sys.dm_db_stats_properties。 例如,下列查詢會顯示資料表 IX_SalesOrderDetail_ProductID 上名為 Sales.SalesOrderDetail 的統計物件目前的指標:
SELECT
    OBJECT_SCHEMA_NAME(s.object_id) AS schema_name,
    OBJECT_NAME(s.object_id)        AS table_name,
    s.name                          AS statistics_name,
    sp.last_updated,
    sp.rows,
    sp.rows_sampled,
    sp.modification_counter
FROM sys.stats AS s
OUTER APPLY sys.dm_db_stats_properties(s.object_id, s.stats_id) AS sp
WHERE s.object_id = OBJECT_ID(N'Sales.SalesOrderDetail')
  AND s.name = N'IX_SalesOrderDetail_ProductID';
要判斷目前資料庫的 自動統計建立與更新選項 是否啟用,請使用:
SELECT [name],
    is_auto_create_stats_on,
    is_auto_update_stats_on,
    is_auto_update_stats_async_on
FROM sys.databases
WHERE [name] = DB_NAME();
有效運用統計資訊的查詢
某些查詢實作 (例如查詢述詞中的區域變數和複雜運算式) 可能會導致次佳的查詢計劃。 為避免這些問題,請遵循查詢設計指引以有效運用統計數據。 如需查詢述詞的詳細資訊,請參閱 搜尋條件。
您可以套用有效使用統計資料的查詢設計指導方針來改善查詢述詞中使用之運算式、變數和函數的「基數估計值」,藉以改善查詢計劃。 當查詢優化器不知道表達式、變數或函式的值時,它不知道在直方圖中查閱哪個值,因此無法從直方圖擷取最佳基數估計值。 此時,查詢最佳化工具會改為以長條圖中所有取樣資料列之每個相異值的平均資料列數目做為基數估計值的基礎。 這種情況會導致基數估計值不理想,並可能影響查詢效能。 欲了解更多直方圖資訊,請參閱本文或sys.dm_db_stats_histogram的直方圖章節。
下列指導方針描述的是如何撰寫查詢,以便透過改善基數估計值,改善查詢計劃。
改善運算式的基數估算
若要改善運算式的基數估計值,請遵循下列指導方針:
- 盡可能簡化包含常數的表達式。 查詢優化器不會在決定基數估計前評估所有包含常數的函數和表達式。 例如,請將運算式
ABS(-100)簡化為100。 - 如果運算式使用多個變數,請考慮建立運算式的計算資料行,然後再針對計算資料行建立統計資料或索引。 例如,如果您為運算式
WHERE PRICE + Tax > 100建立計算資料行,查詢述詞Price + Tax可能會有較佳的基數估計。
改善變數和函式的基數估計值
為了提升變數與函數的基數估計,請遵循以下指引:
如果查詢述詞使用區域變數,請考慮將查詢重新撰寫成使用參數而非區域變數。 查詢優化器在建立查詢執行計畫時,並不知道本地變數的值。 當查詢使用參數時,查詢優化器會使用儲存程序接收到的第一個實際參數值的基數估計值。
考慮使用標準表格或暫存表格來存放多語句表值函式的結果。 查詢優化器不會為多語式的表值函式建立統計資料。 透過此方法,查詢優化器能在資料表欄位建立統計數據,並用以制定更完善的查詢計畫。
請考慮使用標準資料表或暫存資料表當做資料表變數的取代項目。 查詢優化器不會建立數據表變數的統計數據。 透過此方法,查詢優化器能在資料表欄位建立統計數據,並用以制定更完善的查詢計畫。 在決定使用暫存表格還是表格變數之間存在取捨。 儲存程序中使用的資料表變數比暫存資料表更少需要重新編譯儲存程序。 根據應用程式而定,使用暫存資料表來取代資料表變數可能不會改善效能。
如果預存程序包含使用傳入參數的查詢,請避免在查詢中使用之前,變更預存程序中的參數值。 查詢的基數估計值是以傳入參數而非更新的值為基礎。 若要避免變更參數值,您可以將查詢重新撰寫成使用兩個預存程序。
例如,下列預存程序
Sales.GetRecentSales會在@date為@date時變更NULL參數的值。Note
在 Azure SQL Database 和 Microsoft Fabric 中的 SQL 資料庫中,
USE陳述式都無法使用。 相反地,直接連接到目標資料庫,執行剩餘的程式碼範例。USE AdventureWorks2022; GO IF OBJECT_ID('Sales.GetRecentSales', 'P') IS NOT NULL DROP PROCEDURE Sales.GetRecentSales; GO CREATE PROCEDURE Sales.GetRecentSales @date DATETIME AS BEGIN IF @date IS NULL SET @date = DATEADD(MONTH, -3, (SELECT MAX(ORDERDATE) FROM Sales.SalesOrderHeader)); SELECT * FROM Sales.SalesOrderHeader AS h, Sales.SalesOrderDetail AS d WHERE h.SalesOrderID = d.SalesOrderID AND h.OrderDate > @date; END GO如果第一次呼叫預存程序
Sales.GetRecentSales時,NULL參數傳遞了@date,則查詢優化器會使用@date = NULL的基數估算來編譯預存程序,即使查詢述詞未使用@date = NULL呼叫。 這個基數估計值可能與實際查詢結果中的列數有顯著差異。 因此,查詢最佳化器可能會選擇次佳的查詢計畫。 為了避免此問題,您可以將儲存程序重寫為以下兩個程序:USE AdventureWorks2022; GO IF OBJECT_ID('Sales.GetNullRecentSales', 'P') IS NOT NULL DROP PROCEDURE Sales.GetNullRecentSales; GO CREATE PROCEDURE Sales.GetNullRecentSales @date DATETIME AS BEGIN IF @date IS NULL SET @date = DATEADD(MONTH, -3, (SELECT MAX(ORDERDATE) FROM Sales.SalesOrderHeader)); EXECUTE Sales.GetNonNullRecentSales @date; END GO IF OBJECT_ID('Sales.GetNonNullRecentSales', 'P') IS NOT NULL DROP PROCEDURE Sales.GetNonNullRecentSales; GO CREATE PROCEDURE Sales.GetNonNullRecentSales @date DATETIME AS BEGIN SELECT * FROM Sales.SalesOrderHeader AS h, Sales.SalesOrderDetail AS d WHERE h.SalesOrderID = d.SalesOrderID AND h.OrderDate > @date; END GO
使用查詢提示來改善基數估計值
若要改善區域變數的基數估計,請搭配 OPTIMIZE FOR <value> 使用 OPTIMIZE FOR UNKNOWN 或 RECOMPILE 查詢提示。 如需詳細資訊,請參閱 查詢提示。
對於某些應用程式而言,每次執行查詢都重新編譯查詢可能會花費太多時間。 即使您沒有使用 OPTIMIZE FOR 選項,RECOMPILE 查詢提示仍然有所幫助。 例如,您可以將 OPTIMIZE FOR 選項加入預存程序 Sales.GetRecentSales,以指定特定日期。 下列範例會將 OPTIMIZE FOR 選項加入 Sales.GetRecentSales 程序。
USE AdventureWorks2022;
GO

IF OBJECT_ID('Sales.GetRecentSales', 'P') IS NOT NULL
    DROP PROCEDURE Sales.GetRecentSales;
GO

CREATE PROCEDURE Sales.GetRecentSales
@date DATETIME
AS
BEGIN
    IF @date IS NULL
        SET @date = DATEADD(MONTH, -3,
            (SELECT MAX(ORDERDATE)
            FROM Sales.SalesOrderHeader));
    SELECT *
    FROM Sales.SalesOrderHeader AS h, Sales.SalesOrderDetail AS d
    WHERE h.SalesOrderID = d.SalesOrderID AND h.OrderDate > @date
    OPTION (OPTIMIZE FOR (@date = '2004-05-01 00:00:00.000'));
END
GO
使用計畫指南改善基數估算
對於某些應用程式,查詢設計指導方針可能不適用,因為您無法變更查詢,或 RECOMPILE 查詢提示可能會導致太多重新編譯。 利用計畫指南指定其他提示,例如 USE PLAN,以控制查詢的行為,同時與應用程式供應商調查應用程式變更。 如需有關計畫指南的詳細資訊,請參閱 計畫指南。
在 SQL Server 2022 及更新版本中,Azure SQL Database、Azure SQL 受控執行個體 以及 Fabric 中的 SQL 資料庫,建議使用 查詢存放區 提示來強制執行計畫,而非只用計畫指南。 如需詳細資訊,請參閱查詢存放區提示。
平台支援
在 Fabric Data Warehouse 和 SQL 分析端點中,只能手動建立或修改單欄直方圖統計數據。 在 Fabric Data Warehouse 與 SQL 分析端點中,只有單欄直方圖統計資料可使用 UPDATE STATISTICS 手動更新。 Fabric Data Warehouse 或 SQL 分析端點都不支援這個sp_updatestats儲存程序。 如需詳細資訊,請參閱 Fabric Data Warehouse 中的統計資料。
相關內容
- 記憶體最佳化資料表的統計資料
- CREATE STATISTICS (Transact-SQL)
- UPDATE UPDATE STATISTICS (Transact-SQL)
- sys.sp_updatestats(Transact-SQL)
- DBCC SHOW_STATISTICS (Transact-SQL)
- ALTER DATABASE SET 選項(Transact-SQL)
- DROP STATISTICS (Transact-SQL)
- CREATE INDEX (Transact-SQL)
- ALTER INDEX (Transact-SQL)
- 建立篩選的索引
- STATS_DATE (Transact-SQL)
- sys.dm_db_stats_properties (Transact-SQL)
- sys.dm_db_stats_histogram (Transact-SQL)
- sys.stats (Transact-SQL)
- sys.stats_columns (Transact-SQL)
- 自適性索引重組