選擇資料表格式
資料工程師在每個資料管線早期都面臨一個關鍵決策:應該用哪種表格格式來儲存你的資料? 此選擇影響查詢效能、交易可靠性、與其他平台的互通性,以及湖屋架構的長期維護。
Azure Databricks 支援多種儲存格式,每種格式都針對不同情境設計。 了解它們的差異,有助於你選擇最適合你需求的格式。
了解檔案格式與表格格式的差別
在比較選項前,區分檔案格式與表格格式非常重要。 像 Parquet、CSV 或 JSON 這 類檔案格式 定義了資料如何實體儲存在磁碟上。 像 Delta Lake 或 Apache Iceberg 這類 表格 格式,是在檔案格式之上加入一個追蹤交易、結構變更及資料檔案位置的元資料層。
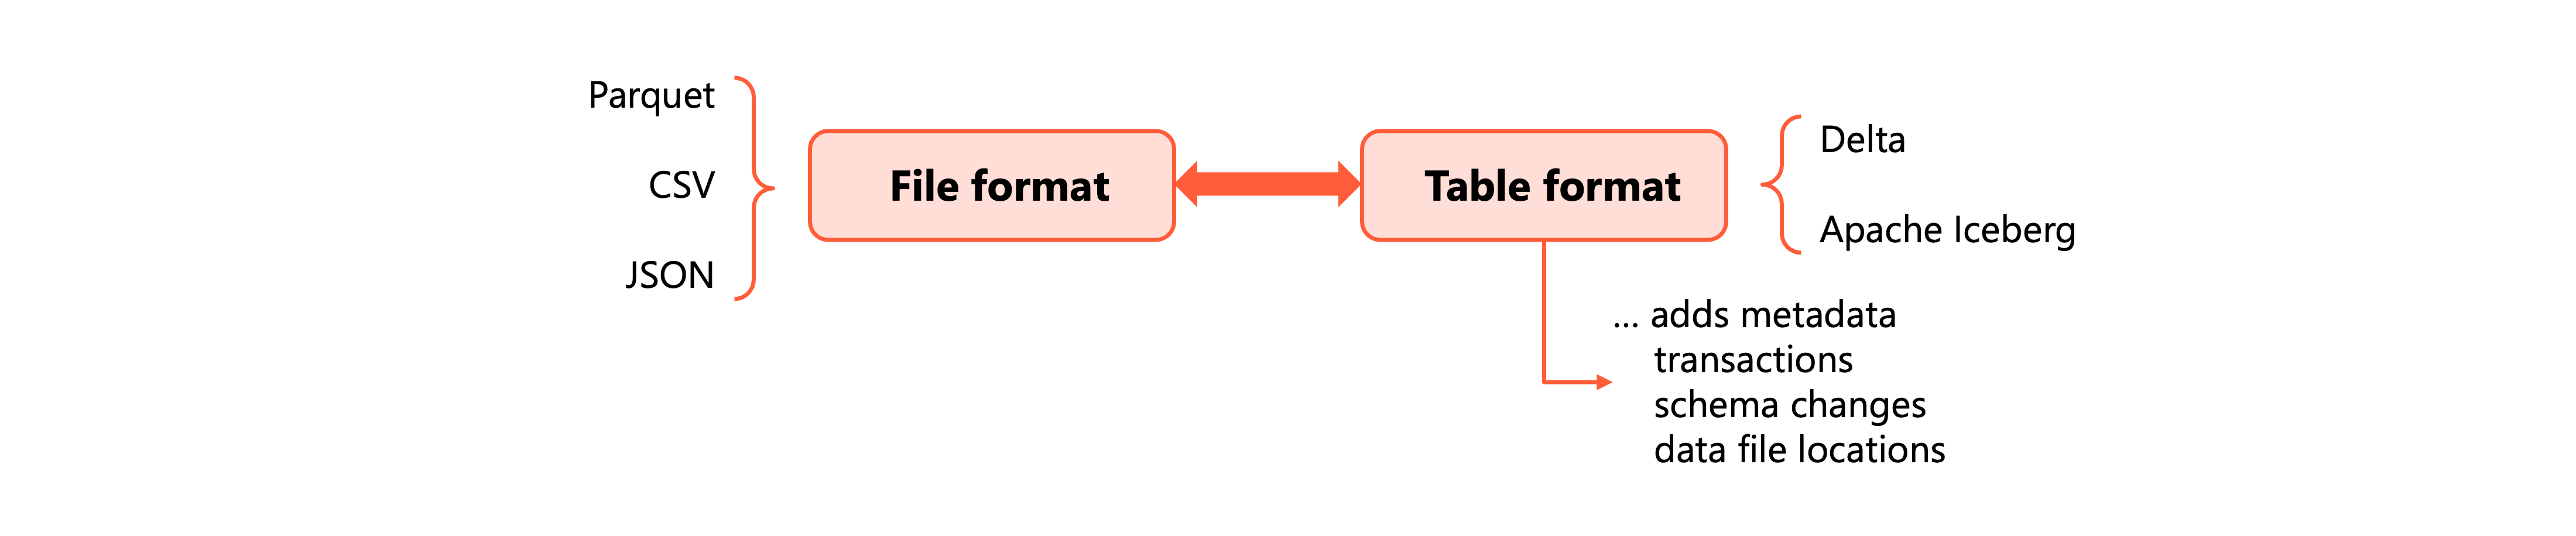
Delta Lake 和 Apache Iceberg 都使用 Parquet 作為底層檔案格式。 關鍵差異在於其元資料層,該層能實現像 ACID 交易、時間旅行和結構演化等先進功能。
Parquet 如何以不同的方式儲存資料
Parquet 採用 欄位式儲存 ,而非列式儲存。 這種根本差異對分析查詢的效能有顯著影響。
在像 CSV 這類以列為基礎的格式中,資料是依記錄組織的。 讀取單一欄位需要掃描檔案中的每一列。 在像Parquet這類欄式格式中,每欄的資料會一起儲存。 當查詢只需要特定欄位時,Parquet 只讀取這些欄位,其他欄位則完全跳過。
Parquet 將資料組織成列群組,每個群組包含欄位區塊。 每一欄區塊都儲存該資料區段的統計資料,包括最小值與最大值。 當你執行帶有篩選條件的查詢時,查詢引擎會先檢查這些統計數據。 如果濾波器值落在某行群組的最小/最大範圍之外,引擎就會跳過整個該區段。
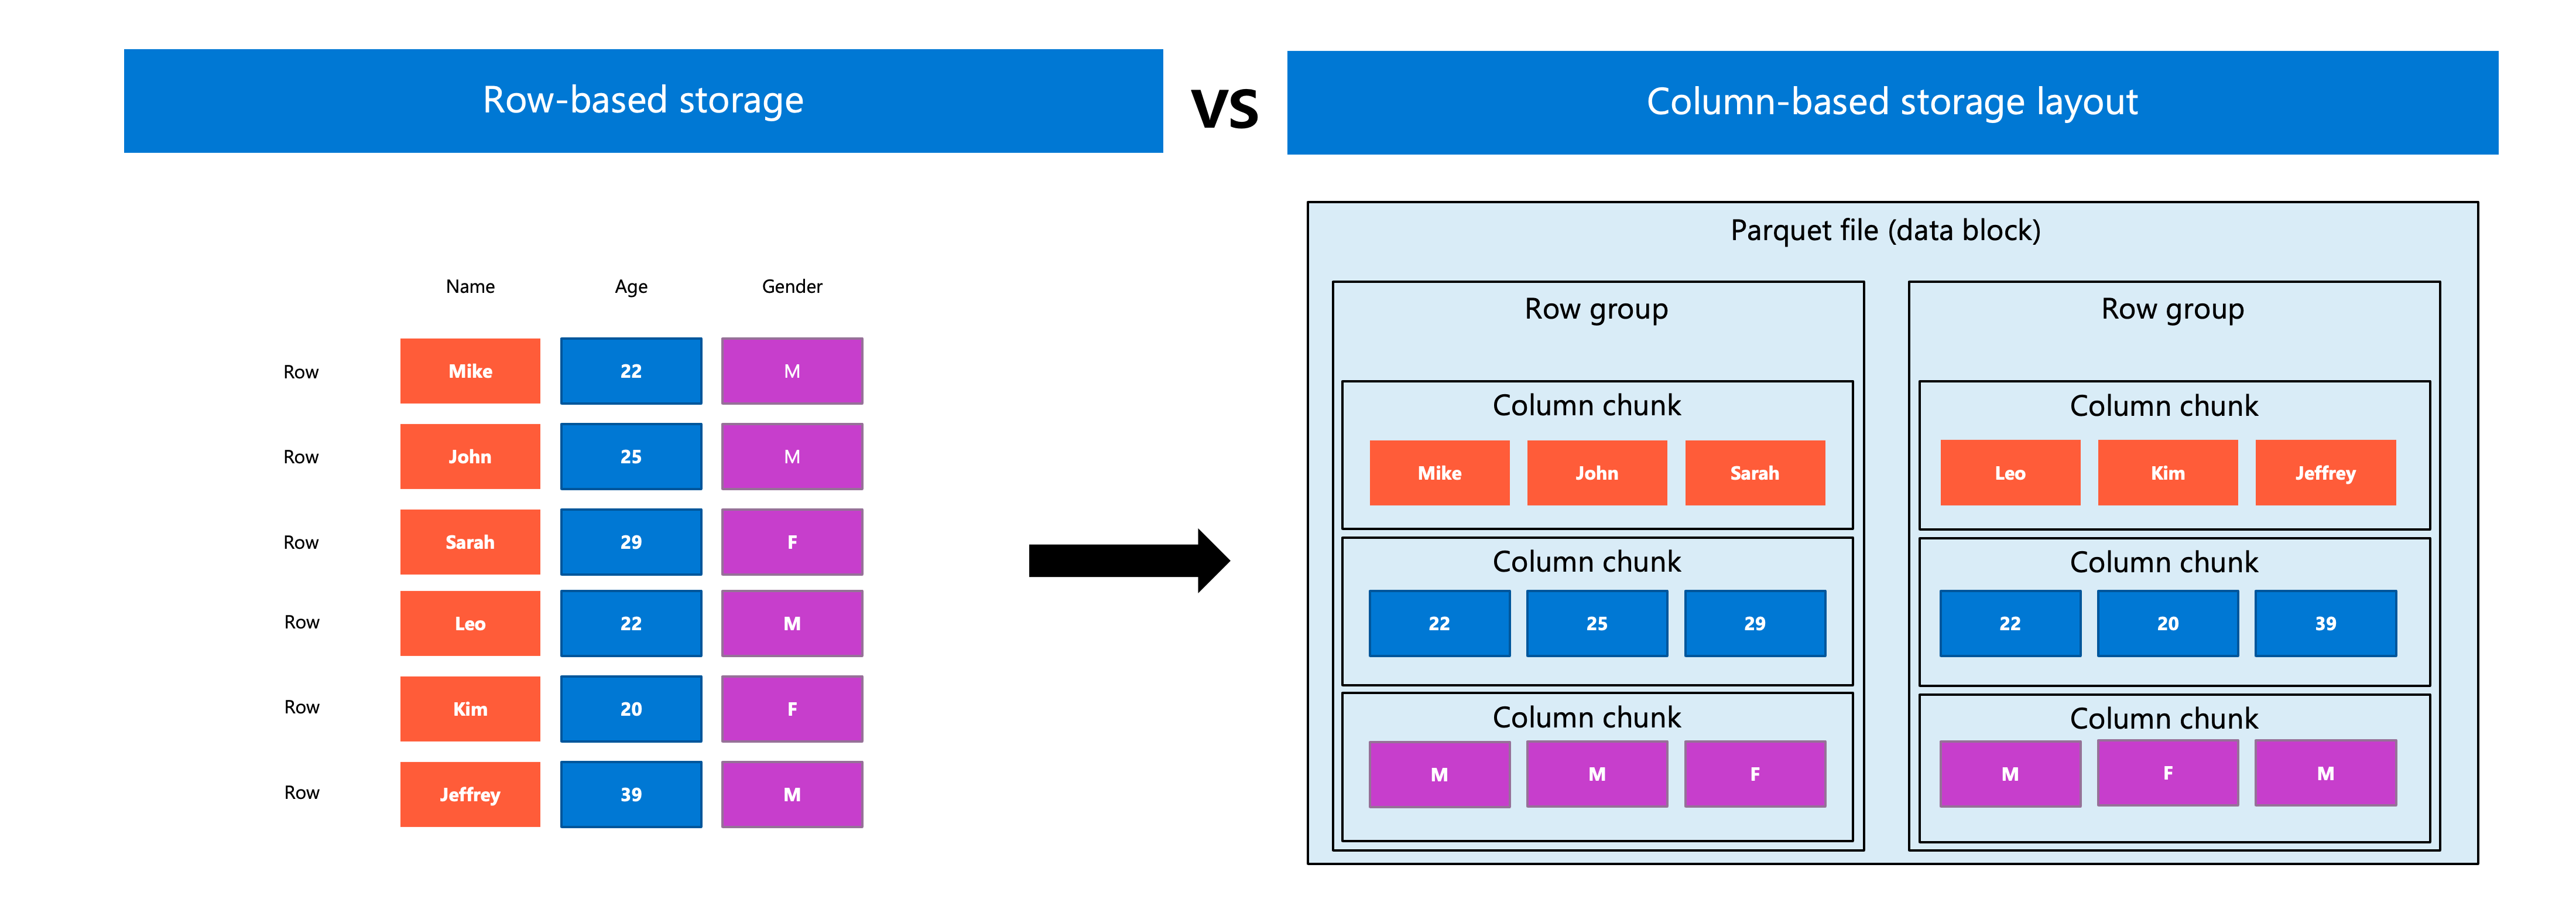
這種列式方法提供了兩種優化技術,能大幅提升分析效能:
- 欄位裁剪:引擎只讀取查詢所參考的欄位,大幅減少 I/O。
- 謂詞下推:在讀取資料之前,會先根據資料行統計資料評估篩選條件,完全略過不相關的資料列群組。
對於通常跨多列存取部分欄位的分析工作負載,Parquet 明顯優於基於資料列的格式。
Delta Lake 作為預設格式
Delta Lake 是 Azure Databricks 中所有資料表的預設儲存格式。 當你建立未指定格式的資料表時,Azure Databricks 會自動使用 Delta Lake。
Delta Lake 透過交易記錄擴充 Parquet 檔案,記錄對資料表所做的每一項變更。 此日誌能實現 Parquet 單獨無法提供的多項功能:
ACID 交易:多個同時的讀寫者可存取同一資料表而不造成資料損壞。 每筆交易要麼全部完成,要麼不產生影響。
時間旅行:使用時間戳記或版本號查詢表格的舊版本。 必要時復原變更。
架構強制執行與演進:該表格會依照其定義的架構驗證輸入資料,防止損壞或不相容的資料進入你的湖屋。 當需求變動時,你可以新增欄位、修改資料型態或重新命名欄位,而無需重寫現有資料。
統一批次與串流:同時使用同一張資料表作為批次來源與串流來源或匯入。
Delta Lake 深度整合於 Azure Databricks 平台。 如 液體叢集 與 預測優化 等功能,在 Unity Catalog 中可用於 Delta Lake 及受管理的 Apache Iceberg 表格。 然而,變更資料摘要為 Delta Lake 特有,且依賴其交易記錄。
在 Azure Databricks 的大多數情境中,Delta Lake 是推薦的選擇。 它提供 Parquet 的效能優勢,並提供生產資料系統所需的交易保證。
Apache Iceberg 用於跨平台情境
Apache Iceberg 是一種替代的開放表格格式,Azure Databricks 支援用於受管理及外部資料表。 與 Delta Lake 類似,Iceberg 提供基於 Parquet 檔案的 ACID 交易、結構演化及時間旅行功能。
Iceberg 的階層式且明確的邏輯結構使其高度靈活,支援可擴展性與進階優化。 它支援清單修剪、檔案層級統計、隱藏分割區及分割區演進。
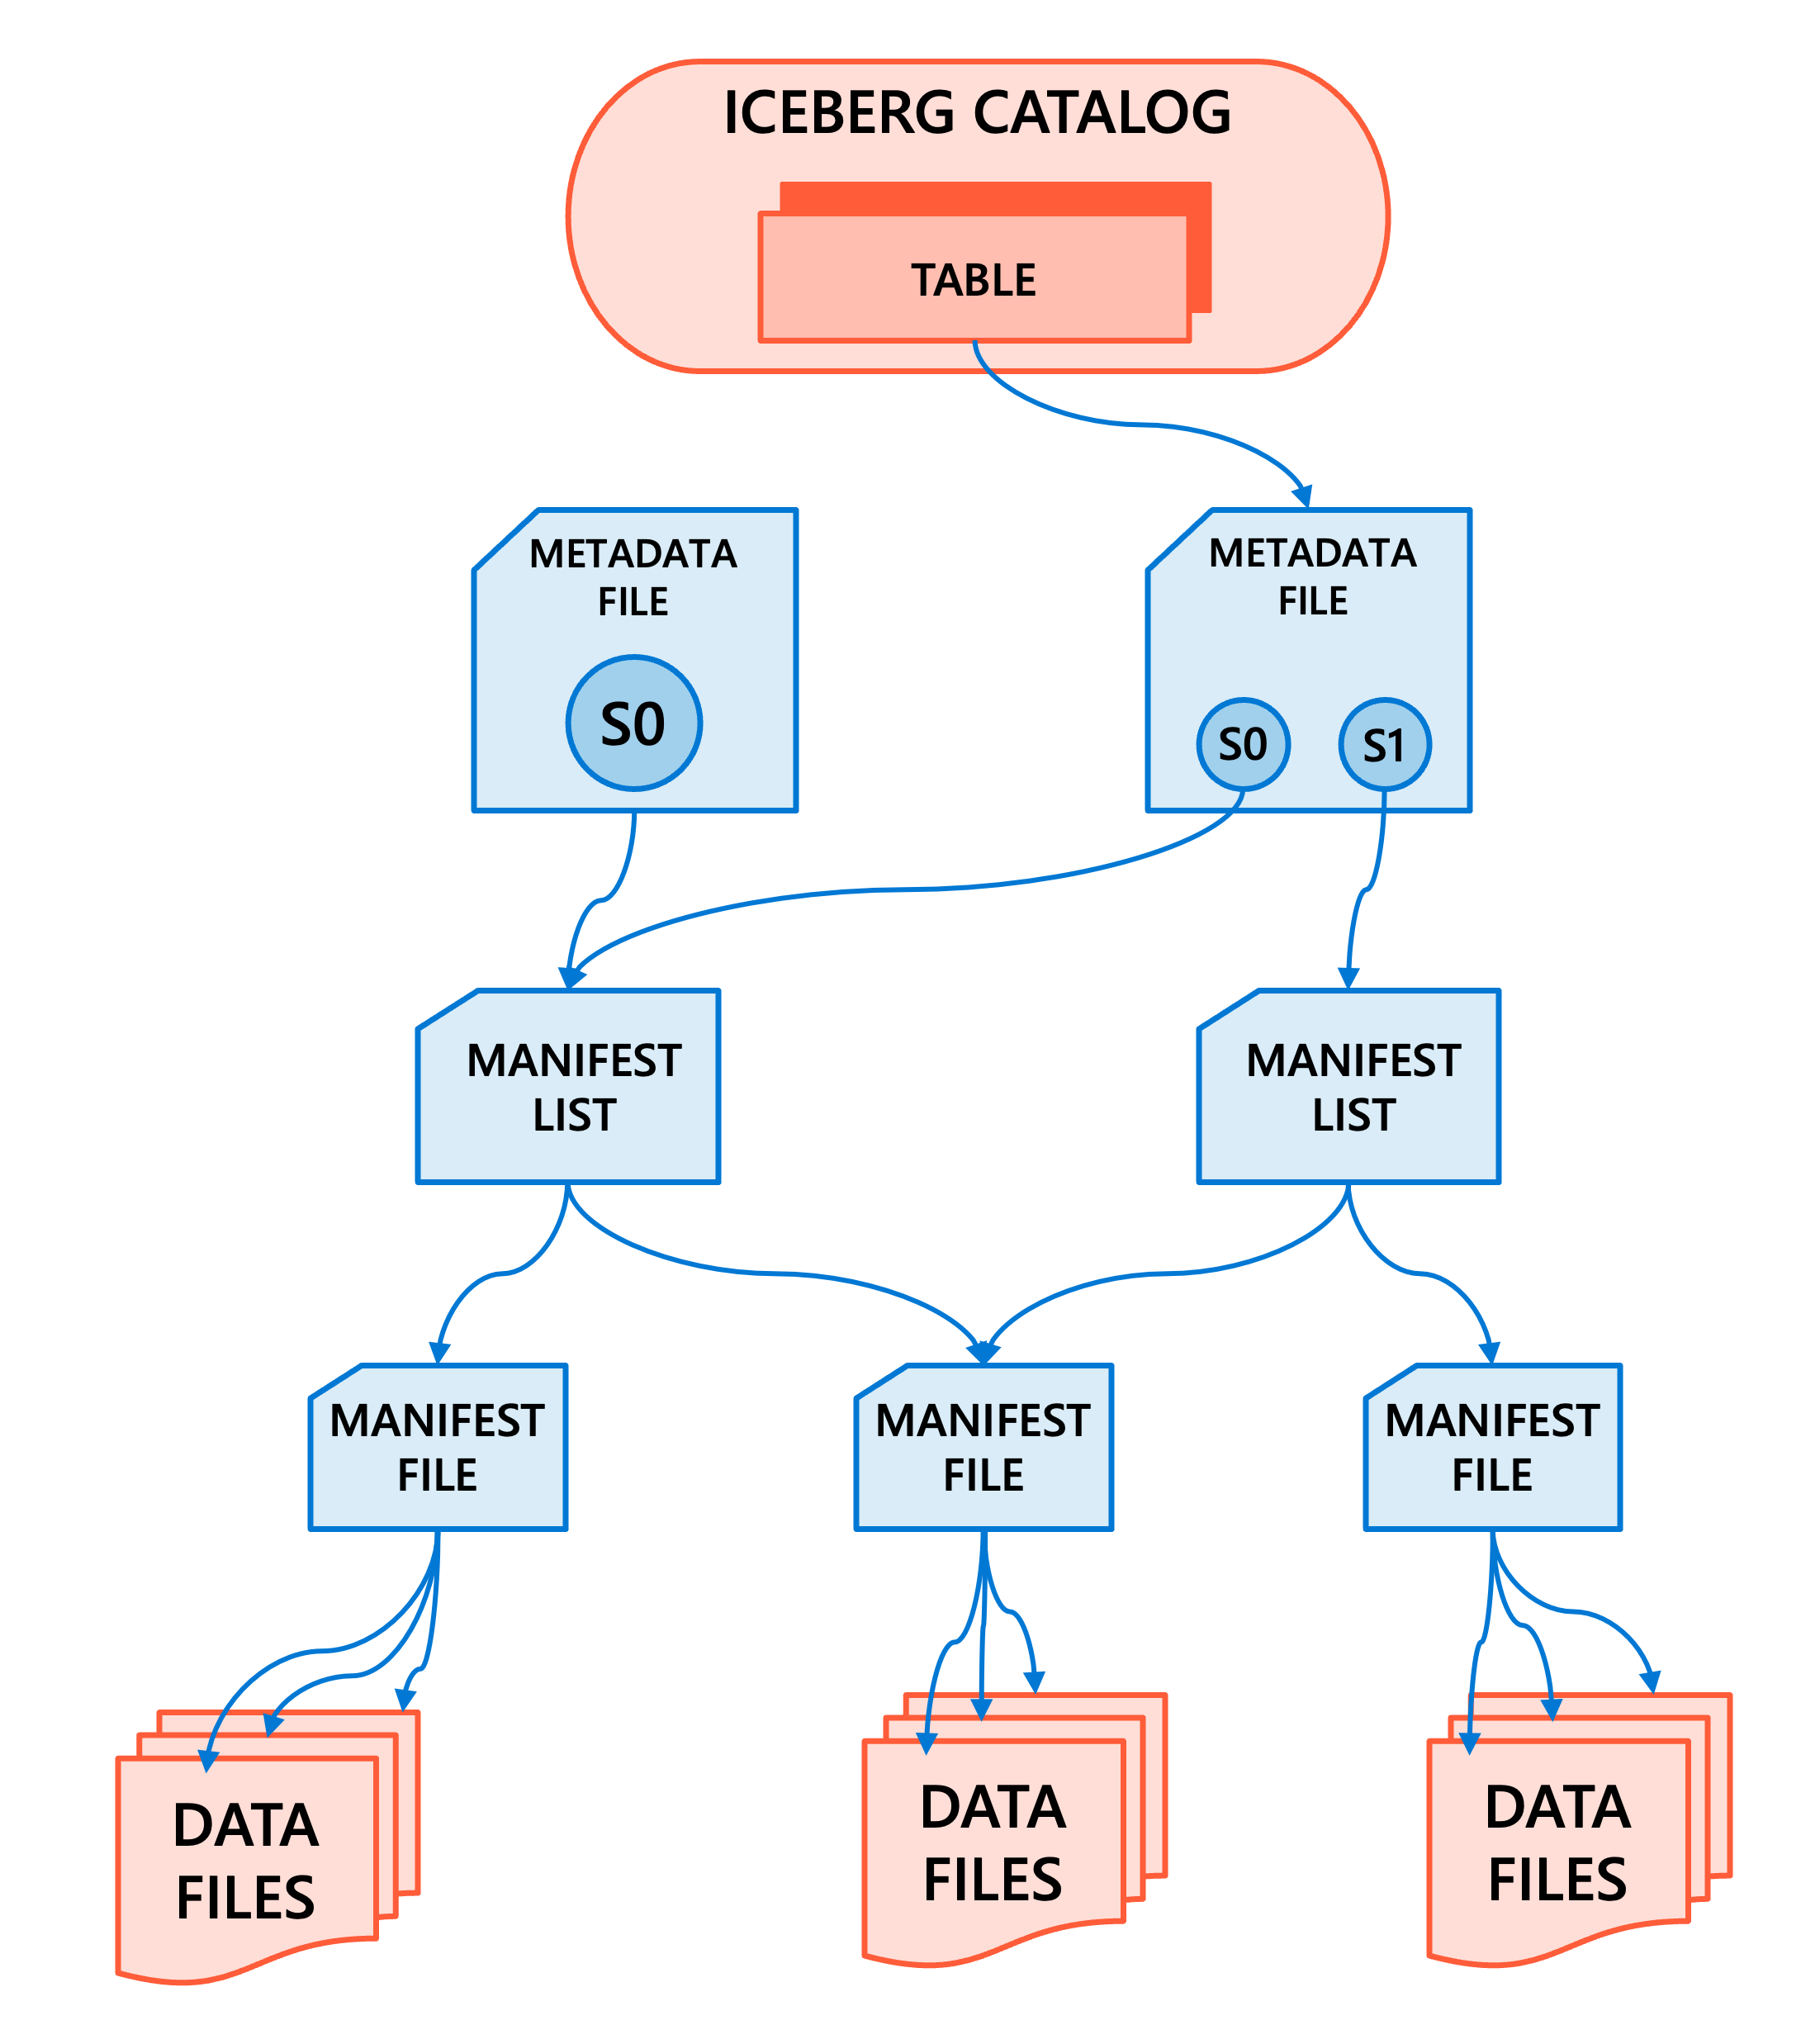
選擇 Iceberg 的主要原因是 互操作性。 Iceberg 在整個資料生態系統中被廣泛採用,包括 Snowflake、Amazon Athena、Trino、Apache Spark 和 Apache Flink 等平台。 如果您的組織在多個平台上運行工作負載,且需要讀寫相同的資料表,Iceberg 提供一個所有平台都能理解的通用格式。
Unity Catalog 可直接管理 Iceberg 資料表,讓 Azure Databricks 能作為外部引擎的 Iceberg 目錄。 你也可以透過外部資料表連線讀取由其他目錄管理的 Iceberg 表格,例如 AWS Glue 或 Snowflake Horizon Catalog。
考慮在以下情況下使用 Iceberg:
- 您的資料需要由多個處理引擎存取,而這些引擎位於 Azure Databricks 平台之外。
- 你們組織已標準化使用 Iceberg 進行跨平台資料共享。
- 你正在整合不支援 Delta Lake 的系統。
對於主要在 Azure Databricks 內運行的工作負載,Delta Lake 仍因其更深入的平台整合與優化功能而被推薦。
當資料列格式適用時
CSV 和 JSON 在特定情境下仍是有效的選擇,儘管它們在大規模分析中效率較低。
以下情況下可使用 CSV 或 JSON
- 你從外部系統以這些格式接收資料作為初始落地區域。
- 你需要人類可讀的資料來進行除錯或快速檢查。
- 你正在整合只支援文字格式的系統。
- 資料量足夠小,效能差異幾乎可以忽略不計。
為了永久儲存分析資料,在擷取時將接收的 CSV 或 JSON 檔案轉換成 Delta Lake 表格 。 此轉換同時涵蓋欄位儲存的效率提升,並加入交易保證。
套用決策標準
選擇表格格式取決於你的具體需求。 先以三角洲湖作為預設選擇,只有在特定限制需要時才評估替代方案。
| 考量事項 | 三角洲湖 | 阿帕契冰山 | CSV/JSON |
|---|---|---|---|
| 分析績效 | 非常好 | 非常好 | 差 |
| ACID 交易 | Yes | Yes | 否 |
| 時間移動 | Yes | Yes | 否 |
| Azure Databricks 整合 | 深層 | 支援 | 基本 |
| 跨平臺相容性 | 成長 | 寬 | 環球 |
| 建議用於生產環境 | Yes | 是的(當需要互通性時) | 沒有(僅限降落區) |
你的選擇也取決於組織標準。 如果你的架構團隊已經建立了表格格式的慣例,請依照這些決策,以維持整個資料平台的一致性。