Nota
L'accés a aquesta pàgina requereix autorització. Podeu provar d'iniciar la sessió o de canviar els directoris.
L'accés a aquesta pàgina requereix autorització. Podeu provar de canviar els directoris.
Limite los recursos que puede consumir una instancia de aplicación, un inquilino individual o un servicio completo. Esto permite que el sistema funcione y cumpla sus objetivos de nivel de servicio (SLO) bajo una carga repentina o sostenida.
Contexto y problema
La carga en una aplicación en la nube varía con el tiempo en función de los usuarios activos y su actividad. Más usuarios inician sesión durante el horario comercial y el sistema ejecuta análisis computacionalmente costosos al final de cada mes. También se producen ráfagas repentinas. Si la demanda de procesamiento supera la capacidad disponible, el sistema ralentiza o produce un error. Cuando el sistema tiene un nivel de servicio acordado, ese fallo incumple el SLO.
Varias estrategias controlan la carga variable, en función de los objetivos empresariales de la aplicación. Una estrategia es el escalado automático, que coincide con los recursos aprovisionados a la demanda actual y controla el costo. Pero el aprovisionamiento de nuevos recursos tarda tiempo y agrega costos. La demanda que supera el crecimiento de la capacidad o el presupuesto crea un déficit de recursos.
Solución
Una alternativa al escalado automático es limitar el uso de recursos y limitar las solicitudes cuando el uso supera ese límite. La carga de trabajo supervisa su propio uso de recursos y limita las solicitudes de uno o varios usuarios cuando el uso supera el umbral. El sistema sigue funcionando y cumpliendo sus SLO.
La limitación de ancho de banda es un bucle de control, no una simple decisión de admisión. El sistema necesita señales de baja latencia en tres niveles: utilización de la infraestructura, estado de la aplicación y contadores por principal. Mide continuamente la saturación, aplica límites en límites bien definidos y adapta esos límites a medida que cambian los patrones de tráfico. La sobrecarga es un modo de funcionamiento normal del que un sistema maduro detecta y recupera. La limitación de ancho de banda proporciona capacidades de autoprotección en su carga de trabajo.
El sistema puede implementar varias estrategias de limitación de ancho de banda o relacionadas:
Límites de tasa por principal: Rechaza las solicitudes de un usuario que ya haya superado la tasa configurada dentro de un intervalo definido. Esta estrategia requiere que el sistema atribuya cada solicitud a un principal y contabilice el uso de recursos con respecto a ese principal. Para cargas de trabajo multiinquilino, consulte Medición del consumo de cada inquilino.
Degradación de características con gracia: Desactive o degrada las características no esenciales para que las características esenciales tengan suficientes recursos. Esta estrategia sacrifica la exhaustividad de la respuesta en favor de la disponibilidad. Por ejemplo, una aplicación de transmisión de vídeo puede pasar a una resolución más baja.
Nivelación de carga: Suaviza el volumen de actividad mediante el uso de una cola. En un entorno con varios inquilinos, la nivelación reduce el rendimiento de todos los inquilinos. Cuando los clientes tienen distintos acuerdos de nivel de servicio (SLA), procese de inmediato las tareas de los clientes de alto valor y posponga las tareas de menor prioridad hasta que disminuya la acumulación de trabajo. Implemente este enfoque usando el patrón de cola de prioridad o exponiendo endpoints independientes para cada nivel de prioridad.
Aplazamiento basado en prioridades: Aplazar operaciones en nombre de aplicaciones o inquilinos de prioridad inferior. Suspende o limite las operaciones y devuelva una excepción que indique al inquilino que vuelva a intentarlo más adelante.
Límites de velocidad de salida: Limite sus propias llamadas salientes cuando se produce un error en una dependencia externa o devuelve errores. Reduce el recuento de solicitudes en curso para evitar la saturación de los registros y los costes de reintentos frente a una dependencia defectuosa. Restaurar el flujo normal de solicitudes después de que la dependencia se recupere. Por ejemplo, NServiceBus implementa esta funcionalidad.
En el gráfico siguiente se muestra el uso de recursos (una combinación de memoria, CPU, ancho de banda y otros factores) con el tiempo para una aplicación que usa tres características, etiquetadas A, B y C. Una característica es un área específica de funcionalidad, como un componente que realiza un conjunto específico de tareas, un fragmento de código que realiza un cálculo complejo o un elemento que proporciona un servicio como una caché en memoria.
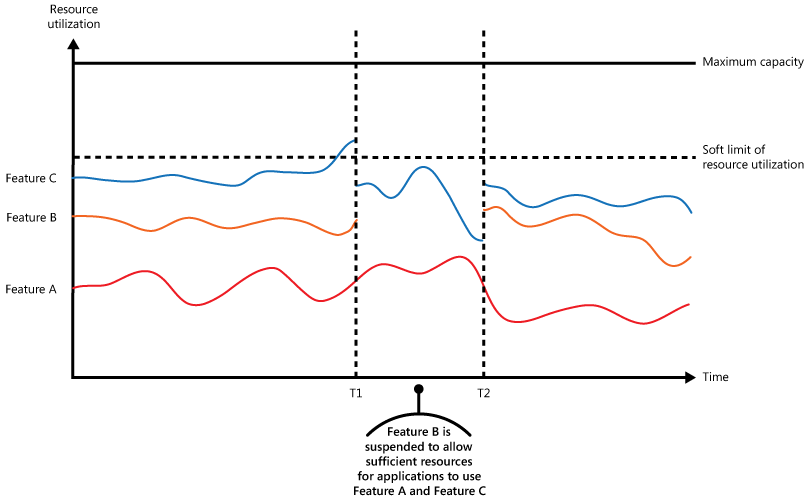
El gráfico es un gráfico de áreas apiladas. El área situada debajo de la línea de la función A muestra los recursos que consume la función A, el área entre las líneas de las funciones A y B muestra los recursos que consume la función B, y el área entre las líneas de las funciones B y C muestra los recursos que consume la función C. La línea de la característica C se encuentra en la parte superior de la pila, por lo que también muestra el uso total de recursos del sistema a lo largo del tiempo.
El gráfico muestra una degradación gradual de las funcionalidades. Justo antes del instante T1, el uso total de recursos se acerca al umbral y corre el riesgo de agotar la capacidad disponible. La característica B es menos crítica que la característica A o la característica C, por lo que el sistema desactiva la característica B y libera sus recursos. Entre las veces T1 y T2, la característica A y la característica C continúan normalmente. A la hora T2, el uso total de recursos disminuye lo suficiente para volver a activar la característica B.
Puede combinar el escalado automático, la degradación gradual y la limitación de velocidad para mantener la capacidad de respuesta de las aplicaciones y cumplir los SLA. Cuando se prevé que la demanda se mantenga alta, la limitación de rendimiento mantiene la estabilidad mientras el sistema se amplía horizontalmente. Una vez completada la ampliación, el sistema recupera toda su funcionalidad.
El siguiente gráfico muestra el uso total de los recursos a lo largo del tiempo y cómo la limitación de velocidad se combina con el escalado automático y otros controles compensatorios.
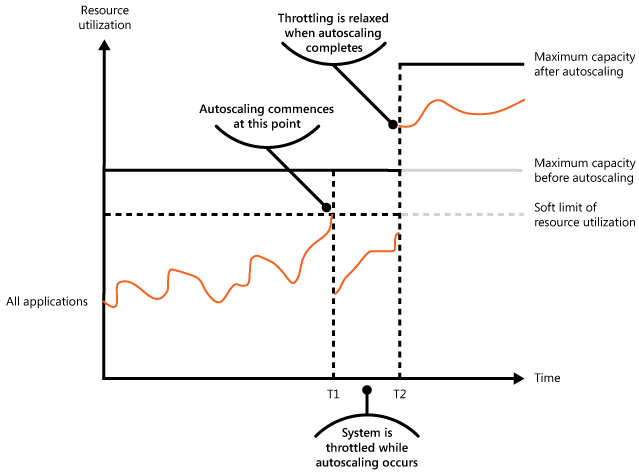
Un gráfico de líneas traza el uso de recursos para todas las aplicaciones del eje Y con el tiempo en el eje X. Dos líneas de referencia horizontales marcan el límite flexible de uso de recursos y la capacidad máxima antes del escalado automático. Una línea horizontal superior, que comienza en el momento T2, marca la capacidad máxima después del escalado automático. La línea de utilización asciende y fluctúa con el tiempo. Cruza el límite suave en el momento T1, que es el punto donde comienza el escalado automático. Entre T1 y T2, el sistema se ve limitado mientras se realiza el escalado automático, y la utilización se mantiene por debajo de la capacidad máxima previa al escalado automático. En el momento T2, se completa el autoescalado, se relaja la limitación de rendimiento y la línea de utilización se dispara y continúa fluctuando por debajo de la nueva capacidad máxima, ahora más elevada.
En el momento T1, el sistema alcanza el límite flexible y comienza a escalar horizontalmente. Si los nuevos recursos no llegan a tiempo, la demanda puede agotar los recursos existentes y el sistema puede producir un error. La limitación de tráfico rechaza las solicitudes excesivas durante la ampliación horizontal para mantener el uso de recursos por debajo del límite máximo, y luego elimina esas restricciones una vez que la nueva capacidad entra en funcionamiento.
Tip
Los controles de borde y el patrón de limitación abordan problemas diferentes. Los controles perimetrales, como Azure DDoS Protection y reglas de límite de velocidad del firewall de aplicaciones web (WAF), se ejecutan en el límite de red y quitan el tráfico volumétrico o malintencionado antes de llegar a la aplicación. El patrón de limitación se ejecuta dentro de la aplicación y regula el tráfico legítimo conforme a los límites definidos por la aplicación. Use ambas capas juntas. La protección contra DDoS no impide que un usuario legítimo sobrecargue el servicio y la limitación de aplicaciones no absorbe un ataque volumétrico.
Problemas y consideraciones
Tenga en cuenta los siguientes puntos a medida que decida cómo implementar este patrón:
Tome las decisiones de limitación de velocidad desde el principio. La limitación es una decisión arquitectónica que afecta a todo el sistema. Adaptarlo más tarde resulta caro.
Adapta los límites de limitación al componente que se satura primero.
La tasa de solicitudes es la dimensión más habitual que se limita, pero el verdadero cuello de botella suele ser el número de solicitudes simultáneas en curso, la profundidad de la cola, la utilización de la CPU o la memoria, o los propios límites de una dependencia posterior. Un límite de solicitudes por segundo no protege a un sistema cuyo cuello de botella sea la concurrencia en un punto de fan-out.
En cada límite de aplicación de la limitación, como la pasarela, el servicio, una partición o una dependencia posterior, identifica qué se satura primero y establece el límite en esa dimensión. Para una protección limitada por la concurrencia en puntos de fan-out, consulta el patrón Bulkhead, que complementa la limitación.
Elija un algoritmo de limitación intencionadamente. Ajústalo a la tolerancia del componente que estás protegiendo.
Algoritmo Comportamiento y ajuste óptimo Cubo de tokens Admite ráfagas de hasta un tamaño configurado y exige una velocidad de recarga estable. Úsalo para puertas de enlace que necesiten absorber picos breves. cubo con fugas Emite a una velocidad constante. Úsalo para back-ends que necesiten una tasa de entrada constante. Ventana fija Fácil de implementar, pero permite ráfagas consecutivas en los límites de la ventana. Ventana deslizante Suaviza el problema de los límites de ventana fijos a costa de un mayor estado. Decida a quién afecta el límite. La limitación en un límite amplio, como una puerta de enlace regional, puede afectar a muchos usuarios no relacionados cuando solo unos pocos de ellos generan la carga.
Decida dónde reside el contador cuando un límite abarca varios nodos. Los contadores locales son rápidos, pero subestiman el recuento cuando el mismo solicitante accede a varias réplicas. Un contador centralizado en un almacén compartido, como Redis, ve todas las solicitudes, pero agrega latencia a cada decisión. Para aproximar una tasa global, divida el límite entre réplicas y concilie periódicamente.
Toma decisiones de limitación rápidamente. El sistema debe detectar el aumento de la carga, reaccionar y volver a la normalidad cuando la carga disminuya. Este proceso requiere instrumentación de rendimiento continuo.
Elimina la carga de forma proactiva, no cuando estés al borde del colapso. Un mecanismo de limitación que solo rechaza solicitudes una vez que un componente se satura provoca picos de latencia antes de que los solicitantes perciban ninguna contrapresión.
A medida que el uso se aproxima al límite máximo, empiece a rechazar una fracción creciente de solicitudes. El rechazo temprano indica a los solicitantes que deben reducir el ritmo y evita el colapso de la latencia que suelen provocar los límites bruscos. Usa la latencia p99 con respecto a tu SLO como disparador principal. La utilización media puede parecer saludable, mientras que p99 ya ha superado el umbral.
Cuando pueda distinguir el valor de cada solicitud, descarte primero el trabajo de menor valor o con más probabilidades de reintento. Para obtener más información, consulte el patrón de cola de prioridad.
Devuelve un código de estado que informe al cliente de cuándo un rechazo temporal es resultado de la limitación de velocidad:
- HTTP 429 (demasiadas solicitudes): El autor de la llamada supera una tasa de solicitudes configurada en una ventana definida.
- HTTP 503 (servicio no disponible): El servicio no puede controlar la solicitud en este momento, a menudo debido a un pico de carga inesperado.
Incluya un
Retry-Afterencabezado HTTP para que el cliente pueda elegir una estrategia de reintento. Devuelva suficiente contexto para que quien llama pueda volver a intentarlo de forma deliberada en lugar de adivinar. Por ejemplo, indique qué límite supera quien realiza la llamada, especifique el ámbito afectado o sugiera una frecuencia que sí tendría éxito. Los rechazos inexplicados no ayudan a las personas que llaman a adaptarse.Propaga las señales de sobrecarga procedentes de tus dependencias en lugar de absorberlas. Un servicio que limita a sus solicitantes también debe respetar las respuestas de limitación que recibe de sus propias dependencias posteriores. Si tu servicio oculta una respuesta 429 o 503 de las capas posteriores reintentando de forma silenciosa o devolviendo una respuesta HTTP 500 genérica (error interno del servidor), los solicitantes no pueden reducir la velocidad, los reintentos se amplifican y la sobrecarga se propaga en cascada hacia las capas anteriores. El antipatrón Retry Storm describe este modo de fallo. Muestra la contrapresión a los solicitantes de nivel superior para que toda la cadena de llamadas reduzca la carga de forma conjunta.
Haga que el rechazo sea más barato que el trabajo que impide. Si la denegación de una solicitud requiere autenticación intensiva, análisis profundo o evaluación de directivas complejas, una inundación de solicitudes rechazadas todavía puede saturar el sistema. Rechace la solicitud lo antes posible en el flujo de procesamiento de solicitudes y someta a pruebas de carga la propia ruta de rechazo.
Prepárate para los casos en los que la limitación no pueda ganar tiempo suficiente para el autoescalado. Si la demanda crece más rápido de lo que entra en funcionamiento la nueva capacidad, incluso un sistema con rendimiento limitado puede fallar. Cuando ese resultado es inaceptable, mantenga reservas de capacidad más grandes y configure el escalado automático más agresivo.
No utilice el almacenamiento en caché como sustituto de la limitación de velocidad. Una caché reduce la carga media en el origen, pero no enlaza la carga máxima. Cada fallo de caché se transmite al origen y, cuando una clave muy solicitada caduca en condiciones de tráfico intenso, muchos solicitantes pueden competir por rellenarla. Utilice el almacenamiento en caché para reducir la presión normal y la limitación de tráfico para contener el peor de los casos. Para obtener más información, consulte el patrón Cache-Aside.
Normalice los costos de recursos para distintas operaciones, ya que normalmente no conllevan costos de ejecución iguales. Por ejemplo, los límites de limitación de velocidad pueden ser más altos para las operaciones de lectura y más bajos para las operaciones de escritura. Omitir el costo por operación puede agotar la capacidad y crear un vector de ataque.
Permita cambiar la configuración de limitación de velocidad en tiempo de ejecución. Cuando se produce una carga anómala, hay que ajustar los límites sin necesidad de realizar un despliegue. Las implementaciones son lentas y arriesgadas durante un incidente. El patrón de almacén de configuración externa externaliza la configuración para poder cambiarla en tiempo de ejecución.
Considere los límites adaptables en lugar de los límites estáticos. Algunos SDK de limitación de tráfico reaccionan a señales de latencia o de profundidad de cola, de modo que el límite se adapta a las condiciones reales de los componentes. Empareja siempre un limitador adaptable con un máximo establecido.
Revise sus límites conforme evolucione la carga de trabajo. Los limitadores adaptables no pueden realizar un seguimiento de cada tipo de desfase, como los cambios de SLO, los cambios en la capacidad de dependencia o los cambios en el costo por operación. Programe una revisión periódica por parte del operador en función de esas entradas.
Cuándo usar este patrón
Use este patrón:
Para mantener un sistema dentro de sus SLO.
Para evitar que un solo inquilino monopolíe los recursos de la aplicación.
Para controlar las ráfagas de actividad.
Para limitar el nivel máximo de recursos que necesita un sistema.
Para reducir la carga de cómputo de bajo valor durante períodos de alta intensidad de carbono de la red eléctrica.
Diseño de cargas de trabajo
Evalúa cómo utilizar el patrón de limitación de tráfico en el diseño de una carga de trabajo para cumplir los objetivos y principios recogidos en los pilares del Marco de Arquitectura Optimizada de Azure. En la tabla siguiente se proporciona una guía sobre cómo este patrón apoya los objetivos de cada pilar.
| Fundamento | Cómo apoya este patrón los objetivos de los pilares |
|---|---|
| Las decisiones de diseño de fiabilidad ayudan a que su carga de trabajo sea resiliente a fallos y garantizan que se recupere a un estado de pleno funcionamiento después de que se produzca un fallo. | Usted diseña los límites para ayudar a prevenir el agotamiento de los recursos que podría provocar un mal funcionamiento. Este patrón también puede utilizarse como un mecanismo de control en un plan de degradación elegante. - RE:07 Autopreservación |
| Las decisiones de diseño de seguridad ayudan a garantizar la confidencialidad, integridad y disponibilidad de los datos y sistemas de su carga de trabajo. | Puede diseñar los límites para ayudar a evitar el agotamiento de recursos que podrían provocar un abuso automatizado del sistema. - SE:06 Controles de red - SE:08 Endurecimiento de recursos |
| La optimización de costos se centra en mantener y mejorar la rentabilidad de la carga de trabajo en la inversión. | Los límites aplicados pueden informar al modelado de costos y pueden estar directamente vinculados al modelo de negocio de la aplicación. También establecen límites máximos claros de utilización, que pueden tenerse en cuenta en el dimensionamiento de los recursos. - CO:02 Modelo de costo - CO:12 Costos de escalado |
| Eficiencia del rendimiento ayuda a su carga de trabajo a satisfacer eficientemente las demandas mediante optimizaciones en el escalado, los datos y el código. | Cuando el sistema está con una alta demanda, este patrón ayuda a mitigar la congestión que puede provocar cuellos de botella en el rendimiento. También puede usarlo para evitar escenarios de entorno ruidosos de forma proactiva. - PE:02 Planeamiento de capacidad - PE:05 Escalado y particionamiento |
Si este patrón introduce concesiones dentro de un pilar, considérelas en relación con los objetivos de los otros pilares.
Example
El siguiente diagrama muestra la limitación de tráfico en un sistema multitenant.
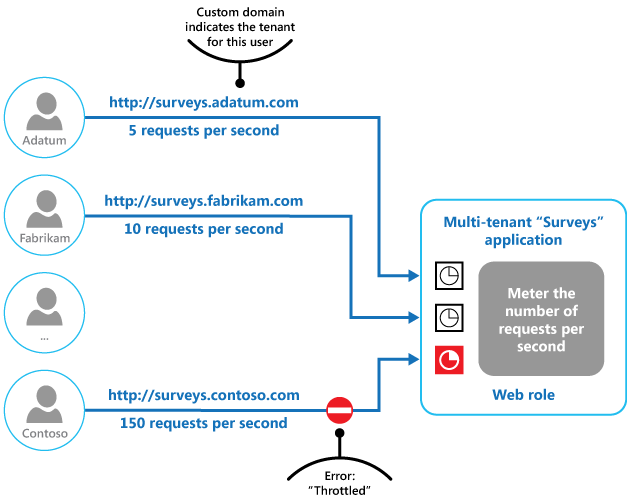
Los tres usuarios etiquetados a la izquierda representan a los inquilinos de una aplicación Surveys multinquilino: Adatum, Fabrikam y Contoso. Cada usuario envía solicitudes a través de un dominio personalizado específico del inquilino, que la aplicación usa para identificar el inquilino. Adatum envía 5 solicitudes por segundo a surveys.adatum.com, Fabrikam envía 10 solicitudes por segundo a través de surveys.fabrikam.com y Contoso envía 150 solicitudes por segundo a surveys.contoso.com. A la derecha, la función web de la aplicación Surveys mide la tasa de solicitudes por segundo de cada inquilino. Los flujos de solicitudes de Adatum y Fabrikam llegan a la aplicación. El flujo de solicitudes de Contoso está bloqueado por un error: Respuesta limitada, ya que la tasa supera el límite por inquilino.
Los usuarios de varias organizaciones de inquilinos acceden a una aplicación hospedada en la nube para rellenar y enviar encuestas. La aplicación contiene instrumentación que supervisa la velocidad a la que los usuarios de cada inquilino envían solicitudes.
Para evitar que los usuarios de un inquilino degradan la capacidad de respuesta y la disponibilidad de los usuarios de otros inquilinos, la aplicación limita la tasa de solicitudes por segundo que cualquier inquilino único puede enviar. La aplicación bloquea las solicitudes que superen este límite.
Paso siguiente
Recursos relacionados
- Medir el consumo de cada inquilino
- Autoscaling en Azure
- patrón de nivelación de cargaQueue-Based
- Patrón de cola de prioridad
- Patrón de almacén de configuración externo