Nota
L'accés a aquesta pàgina requereix autorització. Podeu provar d'iniciar la sessió o de canviar els directoris.
L'accés a aquesta pàgina requereix autorització. Podeu provar de canviar els directoris.
El procesamiento flexible (versión preliminar) proporciona inferencia con un descuento de 50% en comparación con el procesamiento estándar para cargas de trabajo que pueden tolerar tiempos de respuesta más lentos y una falta de disponibilidad ocasional de los recursos. Seleccione el procesamiento Flex para una solicitud individual de la API Responses o de la API Chat Completions estableciendo service_tier en flex.
Use el procesamiento Flex para trabajos que no sean de menor prioridad y no interactivos, como evaluaciones de modelos, enriquecimiento de datos, análisis de documentos y flujos de trabajo de aplicaciones asincrónicas. En el caso de las cargas de trabajo sensibles a la latencia o de la capacidad, use el procesamiento estándar, el procesamiento prioritario o el rendimiento aprovisionado en su lugar.
Importante
Con la introducción del procesamiento Flex, las solicitudes que establecen service_tier en flex solo se procesan si el modelo seleccionado admite el procesamiento Flex. Un modelo no admitido devuelve un HTTP 400 invalid_request_error y no vuelve al procesamiento estándar. El procesamiento flexible no tiene SLA de latencia ni SLA de servicio.
Prerequisites
Una suscripción a Azure. Crear uno gratis.
Un recurso de Azure OpenAI con un modelo compatible implementado mediante el tipo de implementación Global Standard.
El punto de conexión del recurso y una clave de API o las credenciales de Microsoft Entra ID. En los ejemplos de este artículo se usa una clave de API almacenada en la
AZURE_OPENAI_API_KEYvariable de entorno.Una carga de trabajo que puede tolerar una latencia variable y respuestas transitorias de indisponibilidad de recursos.
Python 3.10 o posterior y el paquete de Python openAI para los ejemplos de Python:
pip install --upgrade openai
Envío de una solicitud Flex
Establezca flex en service_tier en cada solicitud que deba usar el procesamiento Flex. El valor model es el nombre de la implementación de modelo de Azure.
Python
En el ejemplo siguiente se envía una solicitud Flex mediante la API de respuestas:
import os

from openai import OpenAI

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

# Send a request for Flex processing.
response = openai.responses.create(
    model="YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    input="Analyze these records and summarize the recurring themes.",
    service_tier="flex",
)

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: flex
La respuesta contiene el análisis generado y el nivel de servicio que procesa la solicitud.
Reference:Responses API
REST
En el ejemplo siguiente se envía la misma solicitud directamente a la API de respuestas:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "flex"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
Para comprobar qué nivel procesa la solicitud, compruebe el service_tier campo en una respuesta correcta.
Referencia:Referencia de la API Responses REST
Elección de una opción de procesamiento
Flex, Standard y Priority processing son opciones de nivel de servicio para las solicitudes de API en línea. El rendimiento por lotes y el rendimiento aprovisionado son opciones independientes de implementación y compra.
| Option | Cómo seleccionarlo | Latencia y disponibilidad | Modelo de costo | Más adecuado para |
|---|---|---|---|---|
| Procesamiento flexible | Establezca el nivel service_tier de solicitud en flex. |
Latencia variable. Las solicitudes pueden devolver HTTP 429 cuando la capacidad flex no está disponible. | 50% descuento en comparación con las tarifas de token estándar. También se aplican descuentos de tokens en caché. | Evaluaciones, enriquecimiento, análisis sin conexión y tareas en segundo plano que toleran demoras. |
| Procesamiento estándar | Establezca el nivel de la solicitud en service_tier a default, o use el nivel Estándar configurado para la implementación. |
Procesamiento en línea de mejor esfuerzo para cargas de trabajo generales. | Tarifa estándar de pago por token. | Cargas de trabajo de desarrollo, pruebas y producción con tráfico variable. |
| Procesamiento prioritario | Configure la prioridad en la implementación o establezca service_tier en priority a nivel de solicitud. |
Latencia más baja y coherente, con un destino definido para los modelos admitidos. | Tarifa de pago por token de prioridad. | Aplicaciones en línea sensibles a la latencia sin un compromiso de capacidad reservada. |
| Batch | Envíe un trabajo por lotes asincrónico a una implementación de Batch. | El plazo objetivo de entrega de resultados es de 24 horas. No existe ningún objetivo de latencia en tiempo real. | Tasa de lotes con descuento. | Tareas de gran tamaño en modo sin conexión que no requieren una respuesta inmediata. |
| Rendimiento aprovisionado | Cree una implementación aprovisionada y compre o reserve unidades de rendimiento aprovisionadas (PTU). | Capacidad reservada con rendimiento predecible y latencia. | Facturación horaria de PTU o una reserva de Azure. | Cargas de trabajo de producción de alto volumen y de misión crítica. |
Elija Procesamiento flexible cuando se apliquen todas las condiciones siguientes:
- La carga de trabajo puede tolerar tiempos de procesamiento más largos y variables.
- Prefiere un coste más bajo a una latencia predecible.
- La aplicación puede reintentar errores transitorios o enrutar una solicitud con error al procesamiento estándar.
- Se admite el modelo seleccionado y el contexto de solicitud.
No use el procesamiento flex cuando se aplique alguna de las condiciones siguientes:
- Un usuario está esperando una respuesta interactiva.
- La solicitud debe completarse cumpliendo un objetivo estricto de latencia.
- La aplicación no puede tolerar ni reintentar respuestas HTTP 429 transitorias.
- Necesita capacidad de procesamiento reservada o rendimiento predecible.
El procesamiento flexible tiene las siguientes características:
-
Selección a nivel de solicitud: Configure
flexcomoservice_tieren cada solicitud que deba usar el procesamiento Flex. - Ninguna implementación independiente: Envíe solicitudes Estándar y Flex a la misma implementación estándar global y seleccione el nivel por solicitud.
- API compatibles: Utilice la Responses API o la Chat Completions API.
- Respuesta sincrónica: La llamada API permanece sincrónica, aunque la carga de trabajo puede tardar más tiempo en completarse. El procesamiento flexible no es lo mismo que la API por lotes.
- Disponibilidad dependiente de la capacidad: Una solicitud puede devolver HTTP 429 cuando la capacidad flex no está disponible.
-
Sin alternativa automática a Standard: La aplicación debe reintentar explícitamente con
defaultestablecido enservice_tiersi el procesamiento Standard es aceptable. - Cuota compartida: Las solicitudes Flex y Standard usan la cuota asignada a la implementación estándar global.
- Misma calidad de salida del modelo: Flex usa el mismo modelo subyacente que Standard. El nivel de procesamiento cambia la latencia, la disponibilidad y el precio, no la calidad del modelo.
Note
Los tokens de entrada y salida flexibles reciben un descuento de 50% en comparación con las tarifas de token estándar correspondientes. Los tokens de entrada almacenados en caché que cumplan los requisitos también reciben el descuento aplicable a los tokens en caché. Para conocer las tarifas actuales, consulte Precios de Azure OpenAI.
Revisión de los modelos admitidos
El procesamiento Flex tiene una disponibilidad limitada de modelos en el lanzamiento.
gpt-5.6-sol es el primer modelo admitido. En la tabla siguiente se enumeran los modelos admitidos. Microsoft agrega más modelos a medida que la compatibilidad esté disponible.
| Modelo | Version | Tipo de implementación | Disponibilidad en regiones |
|---|---|---|---|
gpt-5.6-sol |
2026-07-09 |
Estándar global | Todas las regiones de Azure donde Global Standard está disponible |
Compruebe esta tabla antes de enviar una solicitud Flex. No suponga que un modelo o una nueva versión de modelo admiten el procesamiento Flex porque admite el procesamiento Estándar o Prioritario. Un modelo no admitido devuelve HTTP 400. Para evitar interrumpir el funcionamiento de la aplicación, implemente un mecanismo de respaldo a nivel de aplicación para usar el procesamiento Estándar cuando el precio y el rendimiento del nivel Estándar sean aceptables.
Revertir al procesamiento estándar
El procesamiento Flex no redirige automáticamente una solicitud al modo Standard cuando la capacidad Flex no está disponible. Si completar la solicitud es más importante que mantener los precios de Flex, reintente la solicitud con default establecido en service_tier.
El siguiente ejemplo usa una directiva de prioridad a la finalización. Primero intenta el procesamiento flex y vuelve a intentarlo una vez con el procesamiento estándar después de cualquier respuesta HTTP 429:
import os

from openai import OpenAI, RateLimitError

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

request = {
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
}

# Try Flex processing, and fall back to Standard after an HTTP 429 response.
try:
    response = openai.responses.create(**request, service_tier="flex")
except RateLimitError:
    response = openai.responses.create(**request, service_tier="default")

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: <flex-or-default>
Volver a Standard cambia las características de precio y rendimiento de la solicitud. Use este patrón solo cuando la carga de trabajo pueda aceptar precios estándar.
Una respuesta HTTP 429 puede indicar una capacidad flexible no disponible o un límite de cuota. Como el procesamiento Flex y Standard comparten cuota, la solicitud Standard también podría fallar si la respuesta original se debió a la cuota. Aplique límites de reintento y controle un segundo RateLimitError en la aplicación. Cuando el servicio devuelva el identificador de error específico para Flex, úselo para limitar la alternativa a las respuestas relacionadas con la capacidad.
Para las cargas de trabajo que priorizan el menor coste, vuelva a intentar el procesamiento Flex aplicando una estrategia de espera exponencial antes de recurrir a una alternativa de respaldo. Para las cargas de trabajo que priorizan el tiempo de finalización, recurra a Standard después del primer error de capacidad de Flex.
Referencia:RateLimitError
Control de errores de Flex
Distinguir los errores de solicitud permanentes de los errores de capacidad transitorios.
| Estado HTTP | Error | Causa | Manejo recomendado |
|---|---|---|---|
| 400 | invalid_request_error |
El modelo seleccionado, la versión del modelo, la longitud del contexto, la API o la configuración de la solicitud no admite el procesamiento flex. | No vuelva a intentar la misma solicitud sin cambios. Seleccione un modelo o una longitud de contexto admitidos, o vuelva a intentarlo explícitamente con default establecido en service_tier. |
| 408 | Tiempo de espera de solicitud | La solicitud no se completa dentro del tiempo de espera de cliente o servicio configurado. Las solicitudes flex pueden tardar más que las solicitudes estándar. | Use un tiempo de espera de cliente más largo. Vuelva a intentarlo con retroceso exponencial delimitado. Si el tiempo de finalización es más importante que los precios de Flex, vuelva a intentarlo con Standard. |
| 429 | Recurso no disponible o tasa limitada | La capacidad Flex no está disponible temporalmente, o la solicitud superó un límite de tasa aplicable. La capacidad flex es preemptible, por lo que es más probable que no haya disponibilidad temporal durante las horas punta. | Si la solicitud superó un límite de velocidad, aumente el límite de velocidad de la implementación de Global Standard mediante la asignación de más cuota. Flex y Standard comparten esta cuota. Si la suscripción no tiene suficiente cuota para una carga de trabajo de gran rendimiento, solicite un aumento de la cuota. Si la capacidad Flex no está disponible temporalmente, vuelva a intentarlo con retroceso exponencial y aleatorización, distribuya el trabajo tolerante a retrasos a periodos de menor actividad, como las noches entre semana o los fines de semana, o vuelva a intentarlo con default establecido en service_tier. Respetar Retry-After cuando esté presente. |
| 500, 502, 503 o 504 | Error de servicio transitorio | Un problema temporal de servicio o puerta de enlace impedía la finalización. | Vuelva a intentarlo con retroceso exponencial delimitado. No envíe un número ilimitado de reintentos. |
| 401 o 403 | Error de autenticación o autorización | Falta la credencial, no es válida, ha expirado o no tiene acceso al recurso. | Corrija la asignación de credenciales o roles. No vuelva a intentarlo hasta que cambie la configuración. |
| 404 | No se encontró la implementación | El nombre de implementación o el punto de conexión son incorrectos. | Compruebe que model coincida con el nombre de implementación y que la dirección URL base apunte al recurso de OpenAI correcto Azure. |
Note
Una solicitud de Flex que se rechaza porque no hay capacidad de procesamiento disponible no se factura. Sin embargo, es posible que observe menos capacidad de límite de velocidad disponible porque las solicitudes Flex y Standard comparten la cuota asignada a la implementación de Global Standard.
Use retroceso exponencial con vibración aleatoria para las respuestas HTTP 408, 429 y 5xx transitorias. Establezca un número máximo de reintentos y un retraso máximo para que una solicitud con error no permanezca en un bucle de reintento sin enlazar.
- Respeta
Retry-Aftercuando la respuesta lo incluya. - De lo contrario, espere un retraso exponencialmente creciente con vibración aleatoria.
- Reintente Flex solo mientras la demora sea aceptable para la carga de trabajo.
- Vuelva a Estándar si se agota el presupuesto de reintento y la aplicación permite el mayor costo estándar.
- Devuelve un fallo explícito si ni el procesamiento de Flex diferido ni la alternativa de reserva Standard cumplen los requisitos de la aplicación.
No vuelva a intentar repetidamente la misma solicitud Flex no admitida. Un reintento solo se realiza correctamente después de cambiar el modelo, la longitud del contexto, la configuración de API o el nivel de servicio.
Supervisión de uso y costos
Use las métricas de Azure Monitor para comparar el tráfico de Flex y Standard en el mismo despliegue. Supervise el volumen de solicitudes, el consumo de tokens, la latencia, los errores y la velocidad a la que las solicitudes Flex se revierten al estándar en la aplicación.
Inicie sesión en Azure Portal.
Vaya al recurso Azure OpenAI y seleccione Métricas.
Agregue la métrica Solicitudes de Azure OpenAI. También puede agregar latencia de Azure OpenAI, uso de Azure OpenAI y las métricas de error.
Agregue un filtro donde ServiceTierRequest sea igual a
flex.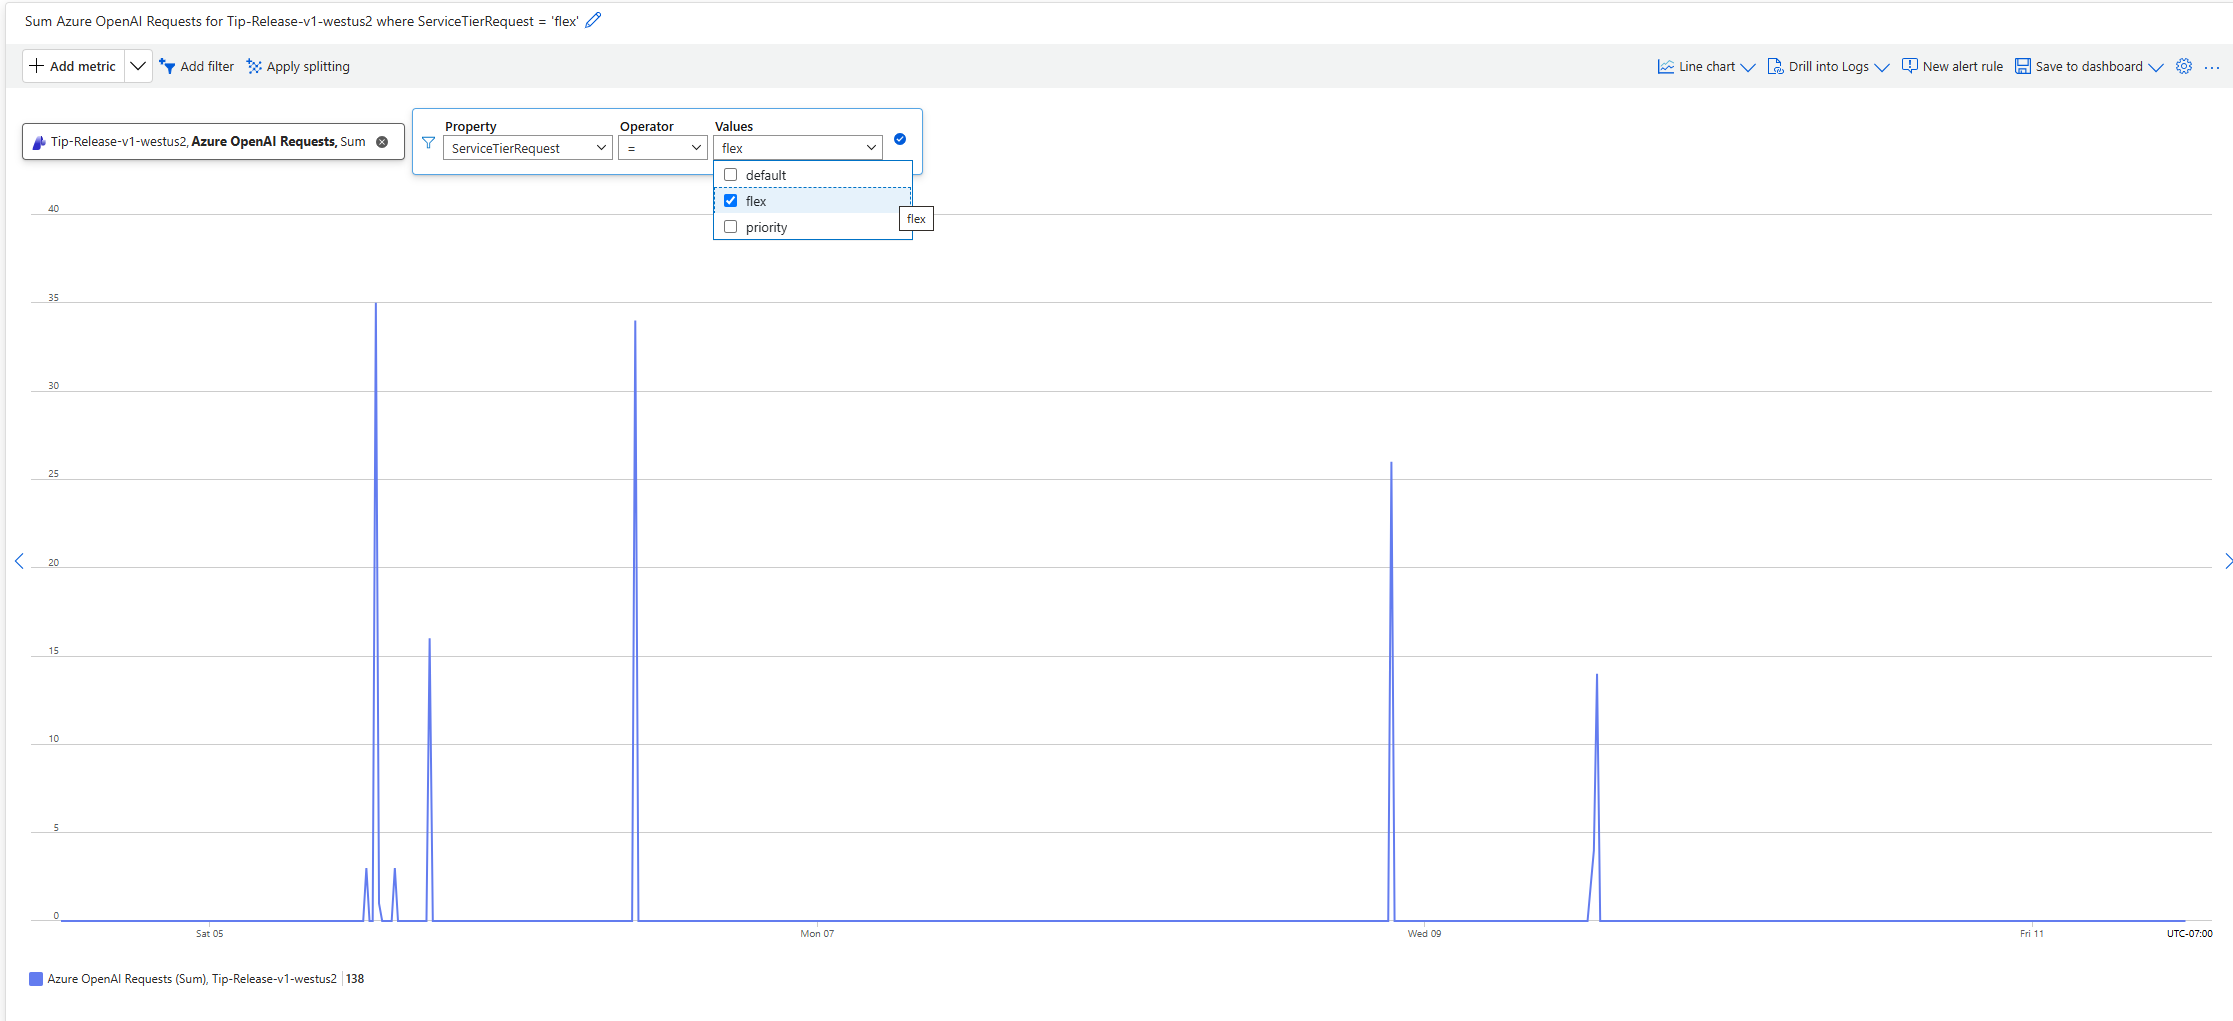
Crea alertas para respuestas HTTP 429 persistentes, un aumento de las tasas de error y una latencia que supere el presupuesto de reintento de tu carga de trabajo.
Realice un seguimiento de las siguientes señales para cada carga de trabajo:
| Señal | ¿Por qué es importante? |
|---|---|
| Recuento de solicitudes flexibles | Muestra la adopción y el tráfico redirigido para un procesamiento de menor coste. |
| Tasa de solicitudes de Flex exitosas | Muestra la frecuencia con la que flex capacity acepta y completa las solicitudes. |
| Velocidad HTTP 429 | Muestra períodos en los que se restringe la capacidad flexible o la cuota de implementación. |
| Recuento y tasa de respaldo estándar | Muestra el beneficio en fiabilidad y el coste adicional del mecanismo de respaldo controlado por la aplicación. |
| Entrada, entrada almacenada en caché y tokens de salida | Admite la atribución de costos y comprueba el efecto del almacenamiento en caché de mensajes. |
| Latencia de un extremo a otro | Ayuda a determinar si una carga de trabajo sigue siendo adecuada para Flex. |
Recuento de HTTP 400 invalid_request_error |
Identifica modelos no admitidos, versiones de modelo, longitudes de contexto o configuraciones de solicitud. |
Para obtener más información sobre la supervisión de implementaciones de modelos, consulte Supervisión de Azure OpenAI.
El uso de Flex se factura en medidores Flex dedicados para que pueda distinguirlo del uso estándar. Use Análisis de costes para revisar los costes del token Flex por recurso y despliegue.
- En el portal de Azure, abra Administración de costos + Facturación>Análisis de costos.
- Filtra por la suscripción, el grupo de recursos o el recurso de Azure OpenAI que contiene la implementación.
- Agrupe o filtre por Medidor para separar el uso de Flex del uso estándar.
- Agregue un filtro de etiqueta de facturación, seleccione implementación y elija el nombre de la implementación.
- Compare el ahorro de costos de Flex con los costos de reserva estándar y los requisitos de finalización de la carga de trabajo.
Los tokens de entrada y salida flexibles tienen un precio de 50% de las tarifas estándar correspondientes. El almacenamiento en caché de prompts puede reducir aún más el coste de los tokens de entrada almacenados en caché que pueden acogerse a ello. Una solicitud de Flex que se rechaza porque no hay capacidad de procesamiento disponible no se factura.
Aplicación de procedimientos recomendados de producción
- Establezca un tiempo de espera más largo. Las solicitudes flex pueden tardar más que las solicitudes estándar. Comience con un tiempo de espera del cliente adecuado para su carga de trabajo, como 15 minutos, y pruebe con instrucciones representativas.
- Utiliza reintentos limitados. Limite los intentos de reintento y el tiempo total transcurrido.
- Agregue vibración. Aleatorice los retrasos de retroceso para evitar picos de reintento sincronizados.
- Haga explícito el respaldo. Configure
defaultcomoservice_tieren lugar de confiar en el comportamiento implícito. - Realice un seguimiento del nivel procesado. Registre el valor de respuesta
service_tiercon datos de latencia, estado, uso de tokens y costo. - Separe el tráfico interactivo y en segundo plano. Mantenga las solicitudes orientadas al usuario en el rendimiento estándar, prioritario o aprovisionado, a menos que sea aceptable la latencia flexible variable.
- Evita la duplicación del trabajo. Asegúrese de que la aplicación no envíe la misma tarea lógica varias veces después de que se agote el tiempo de espera del cliente.
- Pruebe las rutas de error. Valide la gestión de las respuestas HTTP 400, 408, 429 y 5xx transitorias antes de usar el procesamiento de Flex en flujos de trabajo de producción.
- Revise la compatibilidad del modelo antes de las actualizaciones. Un modelo de reemplazo o una versión del modelo no hereda automáticamente la compatibilidad con Flex.
Anular el nivel de servicio mediante una cabecera de solicitud
Use el x-ms-service-tier encabezado de solicitud cuando una puerta de enlace, un proxy o una capa de enrutamiento centralizada necesite seleccionar el nivel de servicio sin inspeccionar ni modificar el cuerpo de la solicitud. El encabezado también puede reducir los cambios de migración para las aplicaciones que ya seleccionan un nivel de servicio openAI a través de un encabezado de solicitud.
El encabezado acepta los siguientes valores:
| Valor de encabezado | Nivel de procesamiento solicitado |
|---|---|
flex |
Flex |
priority |
Priority |
default |
Standard |
auto |
Priority |
Cuando el encabezado está presente y válido, tiene prioridad sobre el service_tier valor en el cuerpo de la solicitud.
| Entrada de encabezado | Contenido del cuerpo de la solicitud | Comportamiento y salida |
|---|---|---|
| Encabezado omitido | Valor válido service_tier |
El cuerpo de la solicitud selecciona el nivel. Una respuesta correcta identifica el nivel procesado en service_tier. |
| Valor de encabezado válido | Cualquier valor o se omite | El encabezado selecciona el nivel solicitado. Una respuesta correcta identifica el nivel procesado en service_tier. |
| Valor de encabezado no admitido | Cualquier valor o se omite | La solicitud devuelve HTTP 400. El servicio no recurre al valor del cuerpo de la solicitud. |
En este ejemplo se solicita el procesamiento de Flex a través de la cabecera. El encabezado sobrescribe el valor default en el cuerpo de la solicitud:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -H "x-ms-service-tier: flex" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "default"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
El encabezado de anulación no proporciona una alternativa automática. Un valor de encabezado no válido o un nivel que la implementación seleccionada no admite devuelve HTTP 400.