Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Platí pro: SQL Server na Linuxu
Tento článek vysvětluje, jak provozovat instanci failover clusteru (FCI) SQL Server na Linuxu. Informace o vytvoření instance clusteru s podporou převzetí služeb při selhání SQL Serveru v systému Linux najdete v článku Konfigurace instance clusteru s podporou převzetí služeb při selhání v systému Linux (RHEL).
Popis architektury
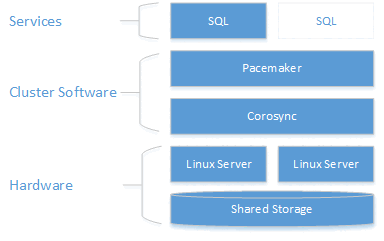
Vrstva clusteringu je založena na rozšíření HA pro Red Hat Enterprise Linux (RHEL), který je postaven na Pacemakeru. Corosync a Pacemaker koordinuje komunikaci clusteru a správu prostředků. Instance SQL Server je aktivní na jednom uzlu najednou.
Následující diagram znázorňuje komponenty v clusteru s Linuxem s SQL Serverem.
Pro více informací o konfiguraci clusteru, možnostech agentů zdrojů a správě navštivte referenční dokumentaci RHEL.
Failover
Převzetí služeb při selhání pro FCI je podobné clusteru převzetí služeb při selhání Windows Serveru (WSFC). Pokud dojde k nějakému selhání uzlu clusteru, který hostí FCI, měla by se FCI automaticky přesunout na jiný uzel. Na rozdíl od WSFC neexistuje způsob, jak nastavit upřednostňované vlastníky, takže Pacemaker vybere uzel, který bude novým hostitelem pro FCI.
Někdy možná budete chtít ručně přepnout FCI na jiný uzel. Tento proces není stejný jako u FCI ve WSFC. Ve WSFC přepínáte prostředky na úrovni role. V Pacemakeru si vyberete zdroj, který přesunete, a pokud jsou všechna omezení správná, přesune se i vše ostatní.
Způsob přepnutí při selhání závisí na distribuci Linuxu. Postupujte podle návodu pro vaši linuxovou distribuci.
Manuální failover (RHEL nebo Ubuntu)
Pro provedení ručního převzetí služeb na serverech Red Hat Enterprise Linux (RHEL) nebo Ubuntu proveďte následující kroky.
Použijte následující příkaz:
sudo pcs resource move <FCIResourceName> <NewHostNode><FCIResourceName>je název zdroje Pacemaker pro SQL Server FCI a<NewHostNode>je to název uzlu clusteru, který chcete hostovat FCI.Během ručního převzetí služeb při selhání vytvoří Pacemaker omezení umístění pro prostředek, který byl vybrán k přesunu ručně. Chcete-li zobrazit toto omezení, spusťte
sudo pcs constraint.Po dokončení failoveru odstraňte omezení:
sudo pcs resource clear <FCIResourceName>
Ruční přepnutí při selhání (SLES)
Note
Od verze SQL Server 2025 (17.x) se nepodporuje SUSE Linux Enterprise Server (SLES). Pro SQL Server 2022 (16.x) a starší verze je podporován pouze SLES 15.
V systému SUSE Linux Enterprise Server (SLES) použijte příkaz migrate pro ruční přepnutí SQL Serveru FCI. Příklad:
crm resource migrate <FCIResourceName> <NewHostNode>
<FCIResourceName> je název zdroje pro instanci failover clusteru a <NewHostNode> je název nového cílového hostitele.
Monitorování failover clusteru
Zobrazení aktuálního stavu clusteru:
sudo pcs status
Zobrazit aktuální stav clusteru a zdrojů:
sudo crm_mon
Zobrazit záznamy agentů zdrojů na ./var/log/cluster/corosync.log
Přidání uzlu do clusteru
Zkontrolujte IP adresu pro každý uzel. Následující skript ukazuje IP adresu vašeho aktuálního uzlu.
ip addr showNový uzel potřebuje unikátní jméno, které má 15 znaků nebo méně. Nastavte název počítače tak, že ho přidáte do
/etc/hosts. Následující skript umožňuje upravovat/etc/hostspomocívi.sudo vi /etc/hostsNásledující příklad ukazuje
/etc/hostss přidáním pro tři uzly s názvemsqlfcivm1,sqlfcivm2asqlfcivm3.127.0.0.1 localhost localhost4 localhost4.localdomain4 ::1 localhost localhost6 localhost6.localdomain6 10.128.18.128 sqlfcivm1 10.128.16.77 sqlfcivm2 10.128.14.26 sqlfcivm3Soubor by měl být stejný na každém uzlu.
Zastavte službu SQL Serveru na novém uzlu.
Postupujte podle pokynů k připojení adresáře databázových souborů na sdílené místo.
Ze serveru NFS nainstalujte
nfs-utils:sudo yum -y install nfs-utilsOtevřete firewall na klientských počítačích a serveru NFS.
sudo firewall-cmd --permanent --add-service=nfs
sudo firewall-cmd --permanent --add-service=mountd
sudo firewall-cmd --permanent --add-service=rpc-bind
sudo firewall-cmd --reload
Upravte soubor
/etc/fstabtak, aby zahrnoval příkaz mount:<IP OF NFS SERVER>:<shared_storage_path> <database_files_directory_path> nfs timeo=14,intrSpusťte
mount -a, aby se změny projevily.Na novém uzlu vytvořte soubor pro uložení uživatelského jména a hesla SQL Serveru pro přihlášení Pacemaker. Následující příkaz vytvoří a naplní tento soubor:
sudo touch /var/opt/mssql/secrets/passwd
echo "<loginName>" | sudo tee -a /var/opt/mssql/secrets/passwd
echo "<password>" | sudo tee -a /var/opt/mssql/secrets/passwd
sudo chown root:root /var/opt/mssql/secrets/passwd
sudo chmod 600 /var/opt/mssql/secrets/passwd
Caution
Vaše heslo by mělo splňovat výchozí zásady hesla pro SQL Server. Ve výchozím nastavení musí heslo obsahovat alespoň osm znaků a musí obsahovat znaky ze tří z následujících čtyř sad: velká písmena, malá písmena, číslice se základem 10 a symboly. Hesla můžou mít délku až 128 znaků. Používejte hesla, která jsou co nejdéle a složitá.
Na novém uzlu otevřete porty firewallu Pacemaker. Pokud chcete tyto porty otevřít pomocí
firewalld, spusťte následující příkaz:sudo firewall-cmd --permanent --add-service=high-availability sudo firewall-cmd --reloadPokud používáte jiný firewall, který nemá vestavěnou konfiguraci vysoké dostupnosti, otevřete následující porty, aby Pacemaker mohl komunikovat s ostatními uzly v clusteru:
- TCP: porty 2224, 3121, 21064
- UDP: port 5405
Nainstalujte balíčky Pacemaker na nový uzel.
sudo yum install pacemaker pcs fence-agents-all resource-agentsNastavte heslo pro výchozího uživatele, který se vytvoří při instalaci balíčků Pacemaker a Corosync. Použijte stejné heslo jako existující uzly.
sudo passwd haclusterPovolte a spusťte službu
pcsda Pacemaker. Nový uzel se může po restartu znovu připojit ke clusteru. Na novém uzlu spusťte následující příkaz.sudo systemctl enable pcsd sudo systemctl start pcsd sudo systemctl enable pacemaker sudo systemctl start pacemakerNainstalujte zdrojového agenta FCI pro SQL Server. Na novém uzlu spusťte následující příkaz.
sudo yum install mssql-server-haNa existujícím uzlu v clusteru autentizujte nový uzel a přidejte ho do clusteru:
sudo pcs cluster auth <nodeName3> -u hacluster
sudo pcs cluster node add <nodeName3>
Odebrání uzlů z clusteru
Pokud chcete odebrat uzel z clusteru, spusťte následující příkaz:
sudo pcs cluster node remove <nodeName>
Změňte frekvenci monitorování zdrojů
sudo pcs resource op monitor interval=<interval>s <sqlResourceName>
Následující příklad nastavuje interval monitorování zdroje na 2 sekundy mssqlha :
sudo pcs resource op monitor interval=2s mssqlha
Troubleshoot
Při řešení potíží s clusterem vám pomůže pochopit, jak tři démony spolupracují na správě prostředků clusteru.
| Daemon | Description |
|---|---|
| Corosync | Poskytuje členství v kvoru a zasílání zpráv mezi uzly clusteru. |
| Kardiostimulátor | Nachází se nad Corosync a poskytuje stavové stroje pro prostředky. |
| PCSD | Spravuje pacemaker i Corosync prostřednictvím nástrojů pcs. |
PCSD musí být spuštěné, aby bylo možné používat nástroje pcs.
Aktuální stav clusteru
sudo pcs status vrátí základní informace o clusteru, kvoru, uzlech, prostředcích a stavu služby pro každý uzel.
Následující příklad ukazuje výstup quorum nástroje Pacemaker, který je v pořádku:
Cluster name: MyAppSQL
Last updated: Thu Oct 31 12:00:00 2024  Last change: Thu Oct 31 11:00:00 2024 by root via crm_resource on sqlvmnode1
Stack: corosync
Current DC: sqlvmnode1  (version 1.1.13-10.el7_2.4-44eb2dd) - partition with quorum
3 nodes and 1 resource configured

Online: [ sqlvmnode1 sqlvmnode2 sqlvmnode3 ]

Full list of resources:

mssqlha (ocf::sql:fci): Started sqlvmnode1

PCSD Status:
sqlvmnode1: Online
sqlvmnode2: Online
sqlvmnode3: Online

Daemon Status:
corosync: active/disabled
pacemaker: active/enabled
V tomto příkladu partition with quorum znamená, že většinové kvorum uzlů je online. Pokud cluster ztratí kvórum většiny uzlů, pcs status vrátí partition WITHOUT quorum a všechny prostředky se zastaví.
Online: [sqlvmnode1 sqlvmnode2 sqlvmnode3] vrátí název všech uzlů, které se aktuálně účastní clusteru. Pokud se některé uzly nezúčastní, pcs status vrátí OFFLINE: [<nodename>].
PCSD Status zobrazuje stav clusteru pro každý uzel.
Důvody, proč může být uzel offline
Pokud je uzel offline, zkontrolujte následující položky.
Firewall
Otevřete následující porty na všech uzlech, aby Pacemaker mohl komunikovat:
- TCP: porty 2224, 3121, 21064
- UDP: port 5405
Služby Pacemaker nebo Corosync, na kterých běží
komunikace Node
mapování názvů uzlů